

AttackGen é uma ferramenta de teste de resposta a incidentes de cibersegurança que aproveita o poder dos grandes modelos de linguagem e o abrangente framework MITRE ATT&CK. A ferramenta gera cenários de resposta a incidentes personalizados com base em grupos de agentes de ameaça selecionados pelo usuário e nos detalhes da sua organização.
# AttackGen
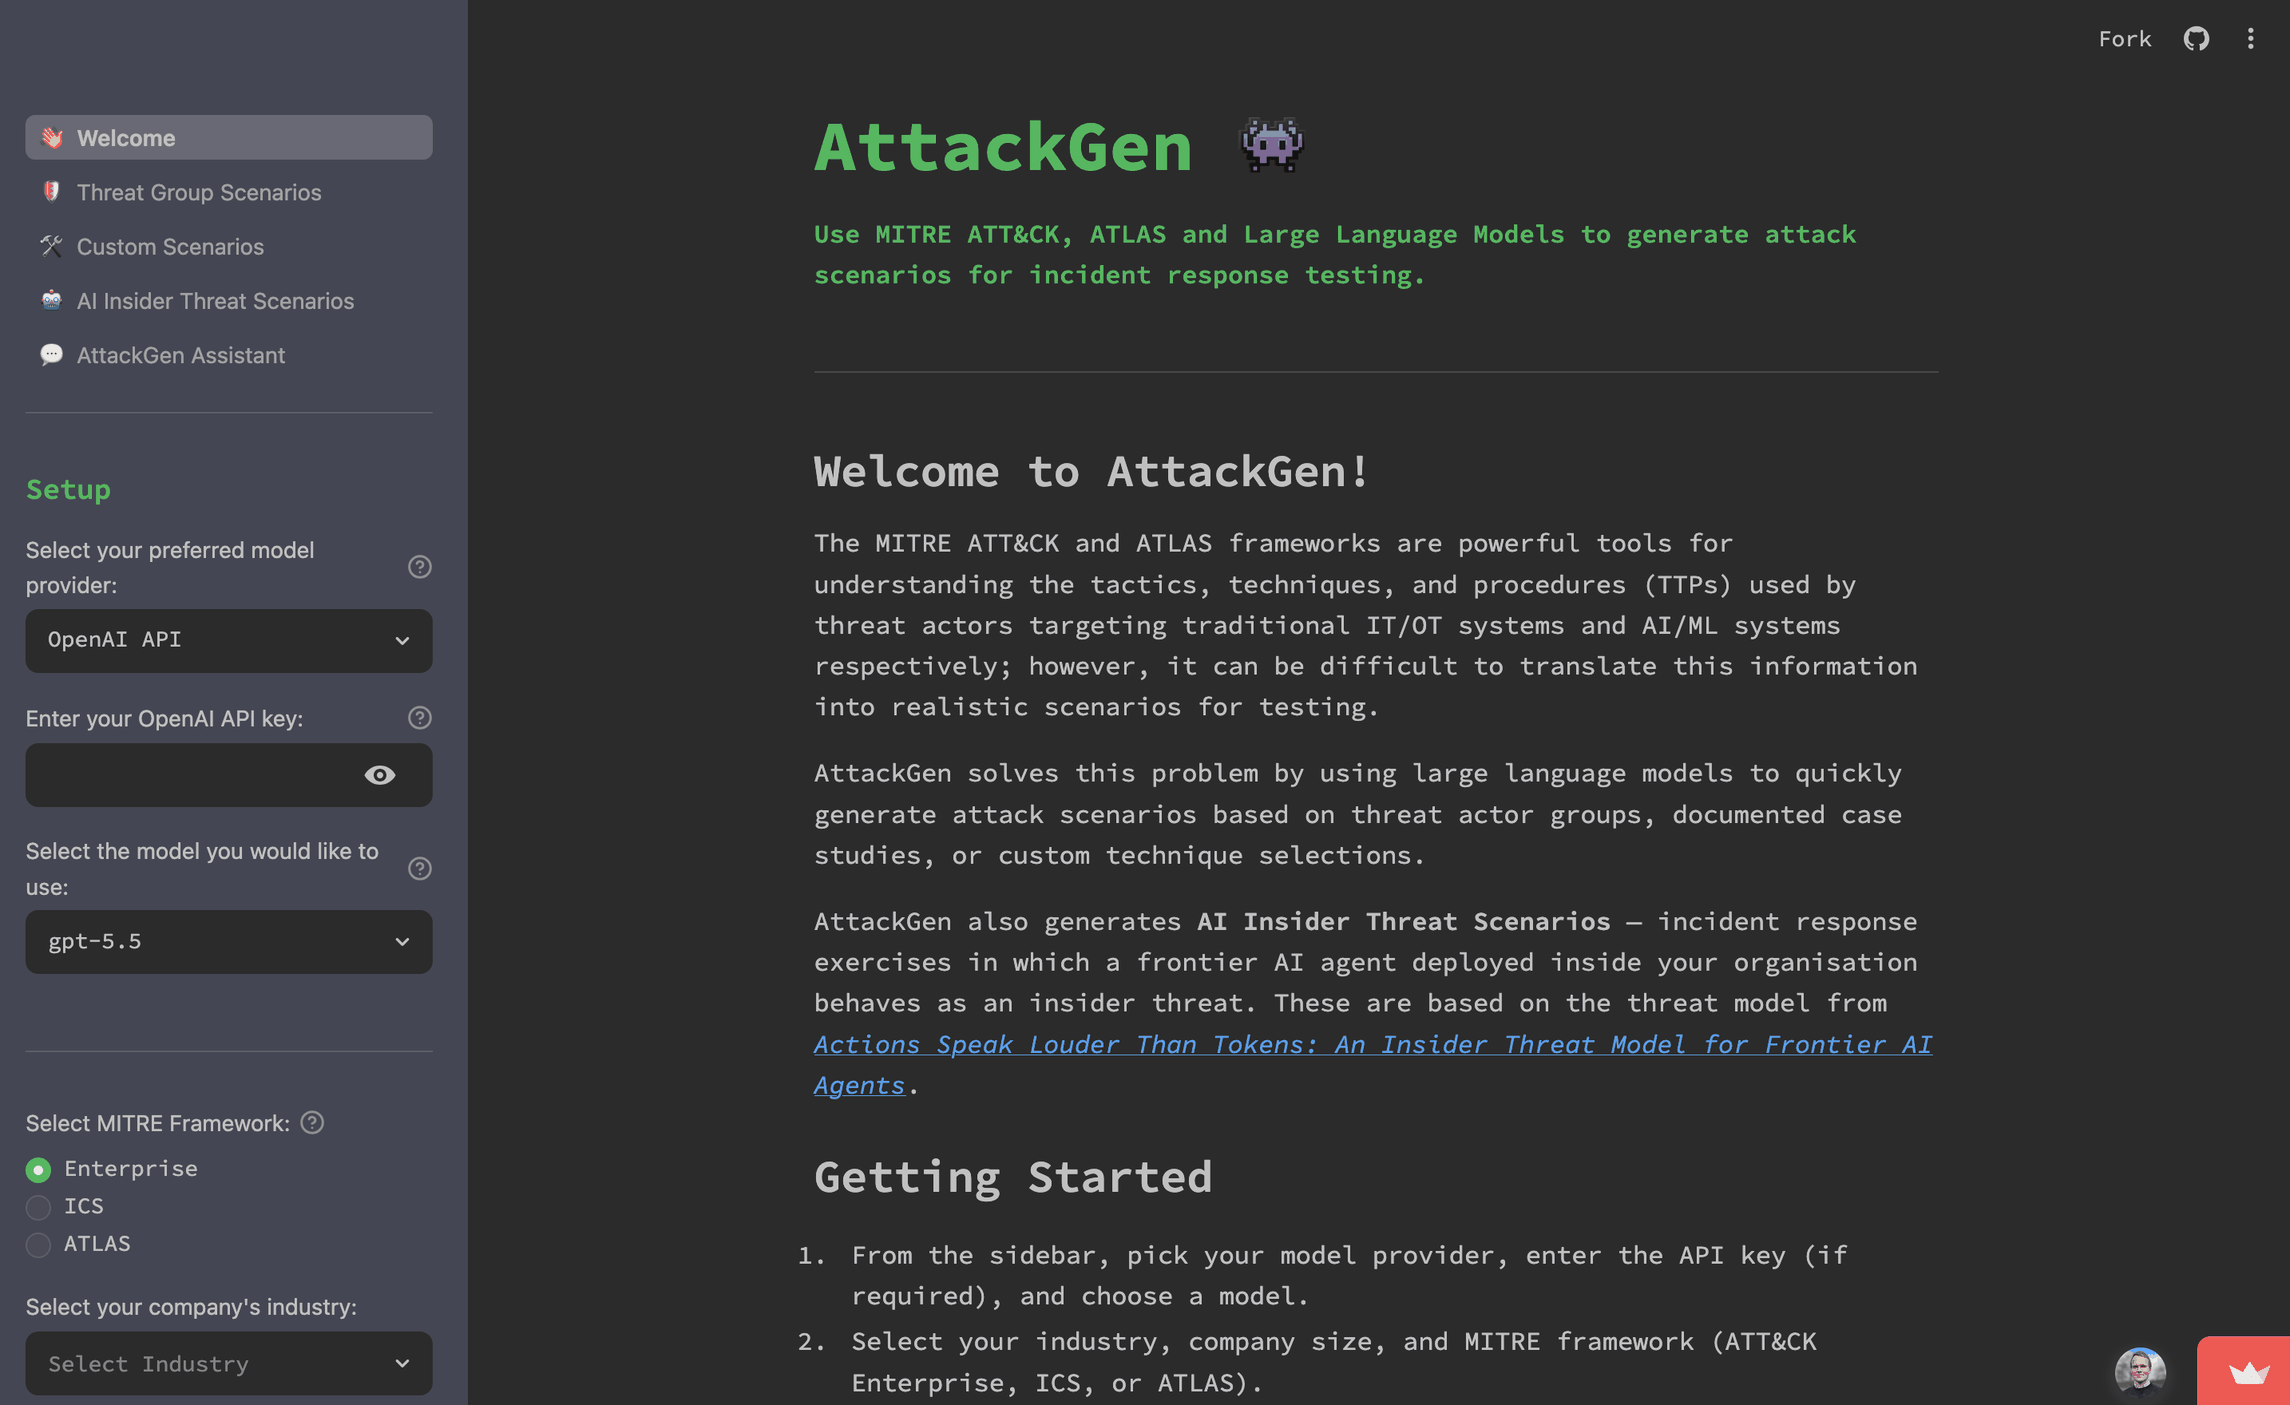
O AttackGen é uma ferramenta de teste de resposta a incidentes de cibersegurança que aproveita o poder dos grandes modelos de linguagem e os abrangentes frameworks MITRE ATT&CK e ATLAS. A ferramenta gera cenários de resposta a incidentes personalizados com base em grupos de atores de ameaça selecionados pelo utilizador, estudos de caso de ataques de IA e nos detalhes da sua organização.
## Índice
- [Dar uma estrela ao repositório](#star-the-repo)
- [Funcionalidades](#features)
- [Lançamentos](#releases)
- [Requisitos](#requirements)
- [Instalação](#installation)
- [Configuração do LangSmith](#langsmith-setup)
- [Configuração dos dados](#data-setup)
- [Executar o AttackGen](#running-attackgen)
- [Servidor MCP](#mcp-server)
- [Competências do agente](#agent-skills)
- [Utilização](#usage)
- [Boas práticas de segurança](#security-best-practices)
- [Contribuir](#contributing)
- [Licença](#licence)
## Dar uma estrela ao repositório
Se considerar o AttackGen útil, considere dar uma estrela ao repositório no GitHub. Isto ajuda mais pessoas a descobrir a ferramenta. O seu apoio é muito apreciado! ⭐
## Funcionalidades
- Gera cenários únicos de resposta a incidentes com base nos grupos de atores de ameaça ou estudos de caso ATLAS escolhidos.
- Permite especificar o tamanho e o setor da sua organização para um cenário personalizado.
- Suporta os frameworks MITRE ATT&CK Enterprise, ICS (Industrial Control Systems) e ATLAS (Adversarial Threat Landscape for AI Systems).
- Exibe uma lista detalhada das técnicas utilizadas pelo grupo de atores de ameaça ou estudo de caso selecionado.
- Crie cenários personalizados com base numa seleção de técnicas ATT&CK ou ATLAS.
- Utilize modelos de cenário para gerar rapidamente cenários personalizados com base em tipos comuns de incidentes cibernéticos, incluindo padrões de ataque específicos de IA/ML.
- Gere **Cenários de Ameaça Interna de IA** - exercícios de resposta a incidentes nos quais um agente de IA de fronteira implementado dentro da sua organização se comporta como uma ameaça interna, com base no modelo de ameaça de [*Actions Speak Louder Than Tokens: An Insider Threat Model for Frontier AI Agents*](https://ai-insider-threat.matt-adams.co.uk). Os cenários são moldados pelo arquétipo de implementação do agente (nível de autonomia), categoria de ameaça, ameaças STRIDE e uma semente de cenário opcional em texto livre.
- AttackGen Assistant - uma interface de chat para atualizar e/ou fazer perguntas sobre cenários gerados, com um caminho direto de volta à página de onde o cenário veio.
- Configuração guiada: cada página mostra a mesma barra lateral **Setup**, lista todos os requisitos pendentes num único resumo de prontidão e mantém **Generate** desativado até que o fluxo de trabalho esteja pronto.
- Os resultados persistem durante a sessão: cada página de cenário mantém o seu próprio resultado mais recente, as entradas capturadas e os downloads entre reexecuções e navegação, e apenas um **Regenerate** ou **Clear result** explícito o substitui ou remove.
- Cenários longos vêm com um resumo compacto e navegação por secções, incluindo atalhos para os injetos, critérios de sucesso, métricas, artefactos e regras de envolvimento a partir dos quais um facilitador conduz o exercício.
- Recolha feedback dos utilizadores sobre a qualidade dos cenários gerados.
- Companheiro de Deteção e Resposta: para as técnicas do cenário, o AttackGen lista as estratégias de deteção, análises, fontes de log e mitigações ATT&CK correspondentes, transferíveis como um ficheiro `_detection.md` separado.
- Download da camada ATT&CK Navigator para cenários de Threat Group e Custom, para que possa ver as técnicas do cenário no [ATT&CK Navigator](https://mitre-attack.github.io/attack-navigator/).
- Alternâncias opcionais nas páginas Threat Group e Custom: **AI-enhanced adversary** reformula a mesma kill chain como acelerada por IA, e **Purple-team narrative** acrescenta uma análise passo a passo do defensor, construída a partir das deteções e mitigações fornecidas.
- Cenários transferíveis em formato Markdown, além do relatório de deteção e da camada Navigator.
- Servidor MCP (`attackgen-mcp`) que expõe kill chains, relatórios de deteção, camadas Navigator e geração de cenários a clientes agênticos, além da Agent Skill `attackgen-tabletop` para transformar esse resultado num exercício de tabletop pronto para facilitadores.
- Utilize a API OpenAI, a API Anthropic (modelos Claude), a API Google AI, a API Mistral, a API Groq ou qualquer endpoint personalizado compatível com OpenAI (Ollama, LM Studio, Azure OpenAI, OpenRouter, etc.) para gerar cenários de resposta a incidentes. Todos os fornecedores são encaminhados através do [LiteLLM](https://github.com/BerriAI/litellm) por trás de um único wrapper interno, pelo que adicionar um novo modelo é uma alteração de uma linha.
- Disponível como imagem de contentor Docker para fácil implementação.
- Integração opcional com [LangSmith](https://docs.smith.langchain.com/) para depuração, testes e monitorização poderosos do desempenho do modelo.
- Gestão segura de credenciais usando ficheiro .env para chaves de API e segredos.
## Releases
### v0.17
| O que há de novo? | Por que é útil? |
| ----------- | ----------------- |
| Aplicar Refinamentos do Assistente aos Downloads | - As Alterações Chegam aos Arquivos: O chat do Assistente antes servia apenas para refinar uma conversa, então os downloads de cenário e de Detecção & Resposta nunca mudavam. Um novo botão **Apply changes to downloads** os reescreve a partir da conversa, em uma chamada de modelo dedicada que retorna o documento revisado completo. No modo **Scenario + Detection & Response**, ele revisa ambos, fornecendo a cada um o texto atual do outro para que permaneçam alinhados.<br><br>- A Seção de Referência Permanece Exata: Uma aplicação de Detecção & Resposta reescreve apenas a narrativa. A referência determinística de detecção e mitigação extraída dos dados do ATT&CK é transportada byte a byte. A camada do Navigator não é regenerada e é legendada como refletindo as técnicas do cenário original.<br><br>- Seguro para Experimentar: Uma resposta vazia do modelo é recusada sem que nenhuma alteração seja feita. A página do cenário e o Assistente legendam um resultado refinado com o horário da última aplicação, e **Revert to original** restaura o cenário e a narrativa juntos.<br><br>- Baixe Onde Você Edita: O Assistente agora oferece os mesmos botões **Download Scenario** e **Download Detection & Response** que a página do cenário.<br><br>- Uma Conversa por Cenário: Cada chat pertence ao cenário sobre o qual trata, então um cenário recém-gerado inicia uma conversa nova, e todo o histórico permanece visível após uma aplicação. |
| Fluxo de Trabalho de Cenário Guiado e Resiliente | - Prontidão Antes do Clique: Cada página agora lista o que ainda falta — primeiro a seleção da própria página, depois qualquer campo de Setup incompleto — e mantém **Generate** desabilitado até que nada esteja pendente, para que um clique nunca seja gasto descobrindo um erro de validação.<br><br>- Opções Antes da Ação: Os toggles de adversário aprimorado por IA e de purple-team ficam acima de **Generate**, com a opção de purple-team indicando que ela faz uma segunda chamada de modelo.<br><br>- Confirme Antes de Gastar: Um resumo de uma linha do framework, perfil da organização, seleção e modificadores é exibido antes do início da geração.<br><br>- Resultados Que Sobrevivem à Navegação: Cada página mantém seu próprio resultado mais recente, as entradas que o produziram e seus nomes de download durante a sessão — abra o Assistente e volte, e o cenário, sua camada do Navigator e seu relatório de Detecção & Resposta ainda estarão lá. Editar o formulário deixa o resultado no lugar com uma nota de que suas seleções mudaram; **Regenerate** e **Clear result** são ações explícitas.<br><br>- Oriente-se em um Cenário Longo: Um resumo compacto e um índice de seções ficam acima do Markdown completo, com atalhos para injects, perguntas de discussão, critérios de sucesso, métricas, artefatos e regras de engajamento.<br><br>- Estados Vazios Úteis: Sem cenário, o Assistente vincula às três formas de criar um; com um, ele nomeia o cenário que está discutindo e vincula de volta à página que o gerou. |
| Recupere-se de uma Narrativa Falha ou Lenta | - Mantenha o Que Funcionou: Se a narrativa opcional de purple-team falhar ou for interrompida, o cenário base, seus downloads, a camada do Navigator e a referência determinística de Detecção & Resposta permanecem totalmente utilizáveis, com uma mensagem dizendo o que falhou.<br><br>- Repita Apenas o Que Falhou: **Retry purple-team narrative** executa novamente apenas a narrativa, sem uma segunda chamada do cenário base, e a mescla na visualização e no download de Detecção & Resposta. Um cenário base que falhou oferece sua própria nova tentativa usando as entradas capturadas em **Generate**.<br><br>- Um Cronômetro Que Continua Avançando: O tempo decorrido agora avança enquanto se aguarda o primeiro token de um modelo, então uma longa espera não parece mais um travamento. |
| Falhas Mais Claras Quando as Técnicas Não Carregam | - Falhas Relatadas como Falhas: Um grupo de ameaças cuja consulta de técnicas falha não é mais exibido como um grupo sem técnicas, e Custom Scenarios não oculta mais seu seletor de técnicas nem pede que você selecione técnicas quando a lista falhou ao carregar.<br><br>- Um Próximo Passo, Não um Beco Sem Saída: Ambos os bloqueios agora dizem o que você pode fazer sobre a falha. |
| Acessibilidade e Texto Mais Enxuto | - Compatível com Teclado e Leitores de Tela: Os controles apenas com ícone têm nomes acessíveis significativos, os rótulos dos formulários são únicos e a ordem do teclado e o foco são visíveis e lógicos. O layout já não transborda horizontalmente na largura de telemóvel, e os avisos vazios da consola sobre a cor do tema desapareceram.<br><br>- Verificado em CI: Testes de fumo em navegador real para higiene da consola e acessibilidade passam agora em cada pull request e condicionam a imagem de lançamento.<br><br>- Menos para Ler: As páginas de cenário já não repetem o resumo de pré-verificação num segundo expansor nem explicam a sua própria gestão de estado. |
| Atualização do Registo de Modelos | - Modelos Mais Recentes: A lista de modelos é atualizada de acordo com a documentação atual de cada fornecedor — **GPT-6 Astra** lidera a lista da OpenAI, **Claude Opus 5.5**, **Claude Opus 5** e **Claude Fable 5.1** juntam-se à da Anthropic, e a Google ganha **Gemini 3.8 Flash** ao lado de **Gemini 3.5 Flash Lite**, mantendo-se uma geração anterior em cada caso por continuidade. A lista da Anthropic agora lidera com **Claude Opus 5.5** — a predefinição da barra lateral quando ainda não escolheu um — em vez do mais caro Fable 5.1.<br><br>- Entradas Descontinuadas Removidas: Removidos ids que os fornecedores substituíram ou encerraram — Claude Opus 4.7 e 4.8 (mais de uma geração Opus atrás assim que o Opus 5.5 chega) e `llama-3.3-70b-versatile` e `llama-3.1-8b-instant` da Groq (ambos encerrados a 16 de agosto de 2026) — para que a barra lateral não possa oferecer um modelo que só dá erro quando prime **Generate**. O nível de raciocínio de pesos abertos da Groq é agora `qwen/qwen3.8-27b`.<br><br>- Regra de Temperatura Mantida Honesta: `supports_temperature` é definido a partir do comportamento real de amostragem de cada modelo Anthropic — todos os Claude a partir do 4.7 rejeitam uma temperatura personalizada, e o Haiku 4.5 continua a ser o único modelo listado que aceita uma. O teste que protege isto agora falha quando uma nova entrada Anthropic omite o flag, em vez de apenas quando alguém o define manualmente. |
| Manutenção de Plataforma e Segurança | - Python 3.11 Mínimo: O Python 3.10 já não é suportado. O LiteLLM 1.98.0 e posteriores importam uma funcionalidade de tipagem que só existe a partir do 3.11.<br><br>- Imagem Base Corrigida: A imagem Docker é reconstruída sobre um `python:3.14-slim` atual, eliminando as CVEs da imagem base Debian sinalizadas pelo Trivy, incluindo três críticas em `perl-base`.<br><br>- Erros Reais de Chamadas Falhadas: O `tenacity` é agora declarado, pelo que uma chamada de modelo falhada reporta o erro real do fornecedor (por exemplo, uma chave de API inválida) em vez de uma instrução para instalar o `tenacity`.<br><br>- O Feedback Fica com o Seu Cenário: Uma avaliação é registada em relação à execução que produziu o cenário no ecrã, nunca em relação à execução mais recente de outra página. |
<details>
<summary>Versões anteriores (v0.16 e mais antigas)</summary>
### v0.16
| O que há de novo? | Por que é útil? |
| ----------- | ----------------- |
| Geração com o Cenário Base Primeiro | - Cenário Antes da Espera: A geração agora ocorre em fases — o cenário base é renderizado primeiro, com seus botões **Download Scenario** e **Download ATT&CK Navigator Layer** já ativos, e a narrativa opcional de purple-team é transmitida em seguida. Se essa segunda etapa for lenta, ou se você não precisar dela, o cenário fica utilizável imediatamente, em vez de ficar retido até que tudo termine.<br><br>- Entradas Congeladas no Momento de Gerar: Cada execução parte de um snapshot tirado no momento em que você pressiona **Generate**, de modo que alterar a barra lateral durante a execução não pode reescrever parcialmente o cenário que está sendo produzido.<br><br>- Progresso Honesto: Um rótulo de tempo decorrido em execução e fases nomeadas — preparando entradas, gerando o cenário base, construindo as exportações determinísticas, gerando a narrativa de purple-team — mostram em que ponto uma execução longa realmente chegou. |
| Seletores Neutros e Sem Becos Sem Saída | - Apenas Opções Que Funcionam: Os seletores de grupo de ameaças e de estudo de caso agora oferecem apenas as escolhas que realmente produzem um cenário, de modo que uma seleção não pode mais levar a um beco sem saída.<br><br>- Ordenação Natural: Os grupos são ordenados em ordem numérica natural, de modo que APT3 vem antes de APT28 e APT30, em vez de ser ordenado como texto e ficar entre eles. |
| Barra Lateral de Configuração Compartilhada em Todas as Páginas | - Configure Uma Vez: Provedor, modelo, framework, setor e porte da empresa agora ficam em uma única barra lateral **Setup** compartilhada em todas as páginas de cenário — Threat Group, Custom e AI Insider Threat — em vez de serem reinseridos em cada uma.<br><br>- Persiste na Navegação: As seleções não secretas persistem à medida que você navega entre as páginas e são espelhadas na URL, enquanto as chaves de API são deliberadamente mantidas fora da query string. |
| Manutenção de Plataforma e Segurança | - MCP no SDK 2.x: O servidor MCP passou para o SDK `mcp` 2.x.<br><br>- Imagem Base Mais Recente: A imagem Docker agora é construída sobre `python:3.14-slim`.<br><br>- CI Bloqueia em Vez de Avisar: As varreduras de segurança agora fazem o build falhar diante de achados, em vez de apenas reportá-los — pip-audit e Bandit bloqueiam, o Trivy não conta mais erroneamente o SBOM vendorizado do pip como pacotes instalados, e as CVEs acionáveis da imagem foram eliminadas. O GitHub Actions saiu do runtime Node 20 e o Dependabot agora acompanha as próprias ações de workflow. |
### v0.15
| O que há de novo? | Por que é útil? |
| ----------- | ----------------- |
| Predefinição de Fuga do Ambiente de Avaliação e Semente de Cenário | - Ensaiar um Incidente Específico: Um novo modelo de ameaça interna por IA ensaia um agente de avaliação alcançando sistemas reais a partir de um ambiente supostamente isolado — forçando contenção, rotação de credenciais, notificação a terceiros e preservação de evidências. Abrange as divulgações de julho de 2026 sobre agentes de avaliação escapando de suas sandboxes, onde a fronteira de isolamento era *presumida* em vez de imposta.<br><br>- Modelos Agora Alcançam o Prompt: Os modelos de início rápido anteriormente apenas preenchiam os widgets da página e nunca influenciavam o cenário gerado. Agora eles carregam um `brief` narrativo e os `required_decisions` que as Perguntas de Discussão devem forçar, ambos inseridos no prompt — de modo que um modelo produz um tabletop cronometrado utilizável em vez de um amontoado de perguntas. Isso os divide em duas classes: os seis modelos originais de **arquétipo** definem apenas decisões, então o modelo inventa a premissa e executar novamente um deles gera um exercício novo para o mesmo perfil de ameaça; os modelos de **incidente** também definem um brief, fixando a situação.<br><br>- Semente de Cenário em Texto Livre: Uma caixa de semente opcional na página de Ameaça Interna por IA direciona a narrativa em qualquer cenário. Selecionar um modelo a preenche, e você pode editá-la ou escrever a sua própria do zero.<br><br>- Taxonomia Estendida para 27 Ameaças / 6 Categorias: Adiciona uma sexta categoria de ameaça (**Contenção e Impacto de Terceiros**) e quatro ameaças STRIDE nas quais o exercício se baseia — `S5` replay de credencial de workload reutilizável, `R4` supressão de telemetria do lado do agente, `I5` comprometimento de terceiros e downstream, e `E5` falha de garantia da fronteira de contenção. O AttackGen agora *estende* o modelo de ameaças publicado em vez de espelhá-lo.<br><br>- Modelos Utilizáveis via MCP: `get_ai_insider_prompt` e `generate_ai_insider_scenario` aceitam `template=` e `scenario_seed=`, e `list_ai_insider_options` retorna cada modelo com as seleções e o brief que ele aplica — de modo que um cliente pode escolher uma predefinição por mérito e chamar apenas com um modelo, setor e tamanho da empresa. Anteriormente os nomes dos modelos eram listados, mas nenhuma ferramenta aceitava um. |
| Skill attackgen-tabletop: Caminho de Ameaça Interna por IA | - Um Segundo Caminho de Exercício: A [Agent Skill](https://github.com/mrwadams/attackgen/blob/main/skills) agora constrói um tabletop a partir do modelo de ameaça interna por IA, bem como a partir de uma kill chain do MITRE. Escolha um modelo de início rápido (ou um arquétipo de implantação e categorias de ameaça) e ela transforma o payload de `get_ai_insider_prompt` em um MSEL.<br><br>- Mesma Forma, Espinha Diferente: O exercício mantém as mesmas seis seções, mas a tabela de kill chain torna-se um perfil de agente e escopo de ameaças STRIDE, o placar de detecção é avaliado em relação à postura de detecção do arquétipo de implantação — de modo que as linhas que *não* disparariam tornam-se o achado — e as decisões exigidas pelo modelo tornam-se perguntas de discussão obrigatórias.<br><br>- Caminho Escolhido para Você: A descrição da skill agora é acionada por frases sobre agentes desonestos, de modo que pedir um "tabletop de ameaça interna por IA" chega ao caminho certo. Um ator externo com tradecraft acelerado por IA permanece no caminho do MITRE.<br><br>- Resposta, Não Exploração: Ambos os caminhos são explicitamente limitados a ensaiar as decisões que uma equipe de resposta deve tomar — sem código de exploração, payloads ou vulnerabilidades reais não corrigidas — e o caminho de IA atribui o comportamento do agente à configuração, acesso e objetivo, em vez de motivação humana. |
| Correção: Prompts do MCP AI-Insider descartavam as capacidades do agente | - Mesmo template, mesmo prompt: o bloco de capacidades de agente de fronteira — as linhas fundamentadas em benchmarks que tornam um cenário de insider de IA crível — era omitido em todas as chamadas a `get_ai_insider_prompt` / `generate_ai_insider_scenario` que não nomeavam `capabilities` explicitamente. Nenhum template as fornece, então o argumento caía para vazio e o prompt substituía por uma linha genérica "assume a capable frontier coding agent", enquanto a página 3 enviava todas as quatro para o mesmo template.<br><br>- Os padrões agora correspondem ao aplicativo: omitir `capabilities` aplica o conjunto completo, como faz o multiselect da página. Passar `[]` ainda as deixa não especificadas, então a exclusão deliberada permanece inalterada. |
| Correção: geração de cenários do Anthropic Claude 4.7+ | - Todos os modelos Claude voltam a funcionar: Claude 4.7 e posteriores rejeitam qualquer `temperature` de amostragem, retornando `BadRequestError: 'temperature' is deprecated for this model`. Quatro dos cinco modelos Anthropic listados — Fable 5, Opus 4.8, Sonnet 5 e Opus 4.7 — não conseguiam gerar um cenário em nenhuma página; apenas o Haiku 4.5 funcionava.<br><br>- Restrito por modelo, não por provedor: a regra de temperature era anteriormente roteada a partir do provedor, o que não consegue expressar um provedor cujos modelos divergem. `ModelInfo.supports_temperature` agora marca os modelos que rejeitam uma, então o Haiku 4.5 mantém sua temperature configurada enquanto seus irmãos a omitem. A OpenAI permanece uma regra em nível de provedor (todo modelo de chat atual é um modelo de raciocínio), e modelos não registrados — endpoints locais Ollama / LM Studio — ainda recebem uma temperature. |
### v0.14
| O que há de novo? | Por que é útil? |
| ----------- | ----------------- |
| Servidor MCP para Clientes Agênticos | - Geração de Cenários como Ferramentas: Um novo servidor FastMCP (`mcp_server.py`, SDK oficial `mcp`) expõe o AttackGen a clientes agênticos via stdio, para que um assistente como o Claude Code ou o Claude Desktop possa obter dados do MITRE e gerar cenários sem a interface do Streamlit.<br><br>- Dois Níveis: As **ferramentas de dados** (`list_threat_groups`, `list_case_studies`, `get_kill_chain`, `get_detection_report`, `get_navigator_layer`, `list_ai_insider_options`, `get_ai_insider_prompt`) não fazem chamadas ao LLM e não exigem chave de API — elas retornam dados estruturados do MITRE e, quando útil, um prompt pronto para execução, de modo que é seguro hospedá-las via HTTP. As **ferramentas de geração** (`generate_threat_group_scenario`, `generate_custom_scenario`, `generate_ai_insider_scenario`) recebem uma configuração de traga-sua-própria-chave e retornam Markdown finalizado — mantenha estas em stdio local.<br><br>- Implementação Compartilhada: O servidor reutiliza os mesmos construtores headless de `core/prompts.py` e os carregadores de `core/attack_data.py` que as páginas do Streamlit usam, de modo que os cenários correspondem ao aplicativo em vez de divergirem. Inicie com `python -m mcp_server` ou com o script de console `attackgen-mcp`. |
| Agent Skill attackgen-tabletop | - Tabletops Prontos para o Facilitador: Uma nova [Agent Skill](https://github.com/mrwadams/attackgen/blob/main/skills) baseia-se nas ferramentas de dados do MCP para transformar um grupo de ameaças ou estudo de caso do MITRE ATT&CK/ATLAS em um tabletop completo de resposta a incidentes (IR) / MSEL — narrativa do cenário, kill chain mapeada por fases, injeções com carimbo de data/hora, perguntas de discussão do NIST SP 800-61 e um quadro de pontuação de cobertura de detecção.<br><br>- Executa no Modelo do Chamador: A skill fornece a elaboração do exercício enquanto o servidor MCP fornece os dados, de modo que ela executa no modelo do próprio cliente sem chave de API adicional.<br><br>- Dois Formatos de Saída: Entregue como Markdown (padrão) ou como um relatório HTML autocontido e otimizado para impressão. |
| O Assistente Refina a Saída de Detecção e Resposta | - Edição Purple-Team: O Assistente do AttackGen agora pode refinar a narrativa de **Detecção e Resposta**, não apenas o cenário. Quando um cenário é gerado com o botão de narrativa 🟣 Purple-team (páginas Threat Group / Custom), um seletor **Editing:** aparece na página do Assistente para que o chat possa direcionar-se ao cenário ou à explicação do defensor — anteriormente o Assistente tinha apenas o texto do cenário.<br><br>- Modo de Edição Combinado: Um terceiro alvo **Scenario + Detection & Response** refina ambos em conjunto, de modo que uma mudança transversal — um setor, ator de ameaça, técnica ou linha do tempo diferente — seja aplicada de forma consistente tanto no cenário do atacante quanto na narrativa do defensor, em vez de ser feita duas vezes e divergir.<br><br>- Fatos Determinísticos Intocados: Apenas a narrativa do LLM é alvo de refinamento; a junção local de detecção STIX nunca é editada pelo LLM. Cada modo de edição mantém seu próprio histórico de chat, e a passagem combinada é marcada como `purple_team_narrative` no LangSmith. |
| Registro de Modelos Mais Simples | - Uma Coisa a Menos por Modelo: O kwarg `max_completion_tokens` e a regra de temperatura para modelos de raciocínio agora são roteados a partir do **provedor** em vez de uma flag por modelo `uses_max_completion_tokens` — todo modelo de chat atual da OpenAI os utiliza, então a flag duplicava um fato que a chave do provedor já capturava. Adicionar um novo modelo da OpenAI continua sendo uma edição de uma entrada em `MODELS`, sem nenhuma flag extra para lembrar.<br><br>- Sem Mudança de Comportamento: Apenas uma simplificação interna — o wrapper constrói kwargs idênticos do LiteLLM para todo modelo atual. |
### v0.13.1
| O que há de novo? | Por que é útil? |
| ----------- | ----------------- |
| Correção: geração de cenários do OpenAI GPT-5.x | - Tratamento correto de modelos de raciocínio: os modelos de raciocínio GPT-5.x da OpenAI rejeitam qualquer `temperature` de amostragem diferente do padrão, então toda geração com GPT-5.x falhava com `BadRequestError: 'temperature' does not support 0.7 with this model`. O AttackGen não envia mais uma temperatura personalizada para esses modelos, enquanto outros provedores mantêm o valor configurado. |
| Atualização do registro de modelos | - Modelos mais recentes: a lista de modelos foi atualizada conforme a documentação atual de cada provedor — **OpenAI GPT-5.6** (níveis Sol / Terra / Luna), **Claude Fable 5** e **Claude Sonnet 5**, mantendo uma geração anterior por provedor para continuidade.<br><br>- Entradas obsoletas removidas: modelos que os provedores substituíram ou estão descontinuando foram removidos — notavelmente o `qwen3-32b` da Groq (desativado em 17 de julho de 2026) e o Magistral Medium da Mistral — para que a barra lateral não ofereça um modelo que gere erro ao ser selecionado.<br><br>- Adicionado um nível rápido/barato da Groq (`llama-3.1-8b-instant`). |
### v0.13
| O que há de novo? | Por que é útil? |
| ----------- | ----------------- |
| Modo Purple-Team: Detecção e Resposta | - Companheiro Defensivo: Todo Grupo de Ameaça e cenário Personalizado agora exibe uma seção de **Detecção e Resposta** que vincula cada uma das técnicas do cenário às estratégias de detecção, análises, fontes de log e mitigações do MITRE ATT&CK já presentes nos dados incluídos — transformando uma narrativa puramente ofensiva em um exercício de purple-team ("aqui está o ataque, e aqui está exatamente o que o seu SOC deveria ter visto").<br><br>- Sem Chamada ao LLM para os Fatos: A seção de detecção é uma **junção de dados local**, não uma chamada ao modelo — portanto, as análises, fontes de log e mitigações que ela lista são o conteúdo real e atual do MITRE, e não suposições do modelo. Ela é oferecida como um download próprio `..._detection.md`, junto com o cenário e a camada.<br><br>- Fontes de Log a Habilitar: Um resumo por cenário lista as fontes de log distintas que as detecções leem (por exemplo, `WinEventLog:Security (EventCode=4624)`), para que um SOC possa ver rapidamente qual telemetria o exercício pressupõe.<br><br>- Narrativa Purple-Team Opcional: Um botão **🟣 Narrativa purple-team** por página adiciona uma segunda passagem do modelo que percorre o cenário etapa por etapa do ponto de vista do defensor — o que deveria disparar, o que o analista vê, como responder — fundamentado estritamente nas detecções e mitigações acima (sem detecções inventadas).<br><br>- Compatível com ATLAS: Cenários ATLAS listam mitigações (o ATLAS ainda não possui estratégias de detecção) e informam isso, em vez de não exibir nada. |
| MITRE ATT&CK v19.1 e Dados ATLAS Mais Recentes | - Frameworks Atualizados: Os dados do MITRE ATT&CK Enterprise e ICS foram atualizados da v18.1 para a **v19.1**, e o MITRE ATLAS foi atualizado para a versão mais recente, de modo que os cenários gerados refletem as táticas, técnicas e estudos de caso atuais.<br><br>- Listas de Grupos Atualizadas: Os menus suspensos de grupos de ameaça são regenerados a partir dos pacotes da v19.1 (174 grupos Enterprise e 14 grupos ICS ativos). Grupos que o MITRE revogou ou mesclou upstream (por exemplo, APT34 → OilRig, UNC2452 → APT29) não aparecem mais, enquanto grupos recém-rastreados, como MirrorFace, aparecem.<br><br>- Mais Estudos de Caso ATLAS: A biblioteca de estudos de caso ATLAS cresceu para 57 (17 incidentes, 40 exercícios).<br><br>- Atualização Repetível: Um novo `scripts/generate_groups.py` regenera os mapeamentos de grupos a partir dos pacotes STIX incluídos, complementando o script existente de estudos de caso ATLAS — assim, a próxima atualização é uma etapa automatizada por script, em vez de curadoria manual. |
| Exportação de Camada do ATT&CK Navigator | - Camada para Download: Todo cenário gerado nas páginas de Grupo de Ameaça e Cenário Personalizado agora oferece uma camada do ATT&CK Navigator (`.json`) junto com o download em Markdown, para que as técnicas de um cenário possam ser visualizadas, anotadas e compartilhadas no ATT&CK Navigator. Para visualizá-la, baixe a camada e abra-a via **Open Existing Layer → Upload from local** no Navigator.<br><br>- Todas as Três Matrizes: O domínio correto do Navigator é definido automaticamente por matriz — carregue camadas Enterprise e ICS no [MITRE ATT&CK Navigator](https://mitre-attack.github.io/attack-navigator/), e camadas ATLAS no fork do [ATLAS Navigator](https://mitre-atlas.github.io/atlas-navigator/). (Uma camada ATLAS não carregará no ATT&CK Navigator, nem vice-versa, pois cada um reconhece apenas seu próprio domínio.)<br><br>- Técnicas Permanecem Visíveis: Sub-técnicas pontuadas expandem automaticamente seu item pai, e os IDs das técnicas são exibidos no layout, de modo que as técnicas destacadas do cenário ficam imediatamente aparentes, em vez de ocultas em linhas recolhidas.<br><br>- Sem Chamada Extra ao LLM: A camada é uma serialização local das técnicas já selecionadas para o cenário — sem chamada adicional ao modelo ou consulta externa.<br><br>- Nomes de Arquivo Descritivos para Download: Os downloads de cenário e camada agora são nomeados com base no ator de ameaça / cenário personalizado e na matriz, com um carimbo de data/hora de geração (por exemplo, `AttackGen_APT29_Enterprise_20260714-153045.md`), para que os arquivos salvos sejam significativos e não colidam entre cenários. |
### v0.12
| O que há de novo? | Por que é útil? |
| ----------- | ----------------- |
---
[Read more](https://github.com/mrwadams/attackgen)

