
 js-lee-ai/refusal-relocates
Segurança de LLMs: analise como o fine-tuning altera o comportamento de recusa e avalie defesas de congelamento de camadas e de baixo rank.





Página do Projeto · Início rápido · Uso · CLI · Resultados · Reproduzir · FAQ · Citação
Algumas dezenas de exemplos prejudiciais podem remover a recusa de um modelo alinhado a pedidos prejudiciais. Trabalhos anteriores localizam a segurança em camadas e direções específicas, o que sugere proteger o local encontrado. Este repositório testa essa premissa da forma como um atacante adaptativo faria. Ele encontra onde a recusa pode ser recuperada, congela essa região e ataca novamente, e repara a atualização de pesos e então deixa o atacante espalhá-la.
O estudo baseia-se em três medições.
Este repositório é a medição e ambas as defesas como uma pequena biblioteca, além dos registros de execução e scripts que reconstroem as tabelas do artigo.
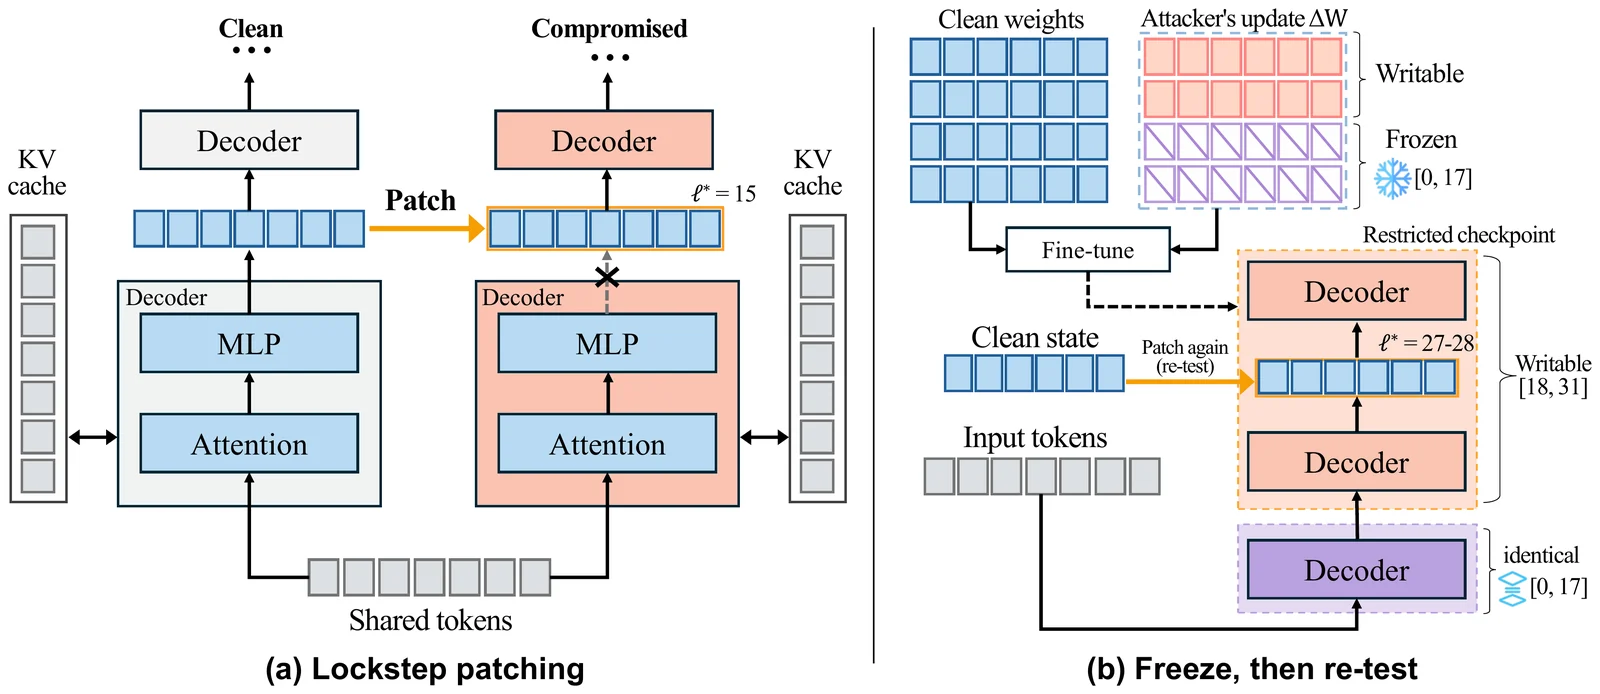
(a) O patch de ativação em lockstep sobrescreve a saída da camada do modelo comprometido com o estado limpo no prefill e em cada etapa de decodificação. (b) No ataque pareado ao Llama, congelar as camadas 0–17 desloca a transição de meio-teto de 15 para 27–28.
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git"
import numpy as np
import refusal

rng = np.random.default_rng(0)
A = rng.standard_normal((16, 512)) / 512 ** 0.5    # LoRA factors of one module, rank 16
B = rng.standard_normal((512, 16)) / 16 ** 0.5
for name, decay in [("ordinary", 0.5), ("spread", 1.0)]:
    b = B * decay ** np.arange(16)                  # energy in a few directions, or spread flat
    before, after = refusal.update_stats(A, b), refusal.update_stats(*refusal.remove_top_k(A, b, k=2))
    print(f"{name:8s}  PR/r {before['pr_over_r']:.2f}  top-2 energy {before['top2_energy_fraction']:.2f}"
          f"  norm left after top-2 removal {after['unscaled_norm'] / before['unscaled_norm']:.2f}")
# ordinary  PR/r 0.10  top-2 energy 0.94  norm left after top-2 removal 0.24
# spread    PR/r 0.94  top-2 energy 0.18  norm left after top-2 removal 0.90
Um fine-tune comum coloca a maior parte da sua atualização em algumas direções singulares, então a remoção das duas principais elimina a maior parte dela. Uma atualização dispersa tem um espectro plano, então a mesma remoção deixa a maior parte dela no lugar. PR/r, a razão de participação sobre o rank do LoRA, é também a pontuação do detector espectral do artigo.
Isto executa numa CPU em cerca de um segundo e não descarrega nada. O mesmo código está em examples/quickstart.py, e o CI executa-o em cada push.
Para treinar, aplicar patches e avaliar checkpoints reais, instale o extra models.
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git"
| instalação | adiciona | suficiente para |
|---|---|---|
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git" | numpy | o núcleo espectral, remoção top-k, o detector, o scorer de recusa, o comando refusal |
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git" | torch, transformers, peft, accelerate, safetensors, scikit-learn, datasets | treino, lockstep patching, probes e avaliação num modelo |
git clone e depois pip install -e ".[models,test]" | pytest | experiments/, records/ e tests/ |
Testado com Python 3.11.5, PyTorch 2.10.0, Transformers 4.57.3 e PEFT 0.18.0. Os modelos carregam em bfloat16 num dispositivo CUDA.
import refusal

data = refusal.load_data("data/prompt_sets.json")        # built by `refusal prepare`, see below
prompts = data["advbench"][:40]
clean, tokenizer = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct")
attacked, _ = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct", adapter="runs/attack/adapter")

for layer in [6, 9, 12, 15, 18]:
    responses = refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer=layer)
    print(layer, sum(refusal.is_refusal(r) for r in responses) / len(prompts))
Ambos os modelos leem os mesmos tokens e, na camada escolhida, a saída do modelo comprometido é substituída pela do modelo limpo. O refusal patch executa a medição completa com o seu piso, teto e dois controlos, pontua a recusa coerente com o filtro de perplexidade e o Llama-Guard, e reporta a profundidade de transição.
import refusal

stats = refusal.update_stats(A, B)                 # one module, A is rank x in and B is out x rank
A2, B2 = refusal.remove_top_k(A, B, k=2)           # the top-two repair, as new LoRA factors
result = refusal.calibrate_detector(benign_scores, attack_scores, budget=0.05)

