 jaewonalive/camodocs
Implementação de pesquisa de um ataque de envenenamento contra modelos de linguagem aumentados por recuperação, utilizando documentos camuflados para evadir defesas de filtragem e induzir respostas incorretas.

Repositório oficial do artigo da EMNLP 2026 CamoDocs: A Poisoning Attack Against Retrieval-Augmented Language Models Using Camouflaged Documents.
CamoDocs é um ataque de envenenamento de base de conhecimento contra Geração Aumentada por Recuperação (RAG) que não requer inclusão de consulta. Cada subdocumento adversário é camuflado ao ser concatenado com um subdocumento benigno otimizado, de modo que os documentos envenenados resultantes evitam os artefatos de sobreposição de consulta nos quais as defesas de filtragem se baseiam.
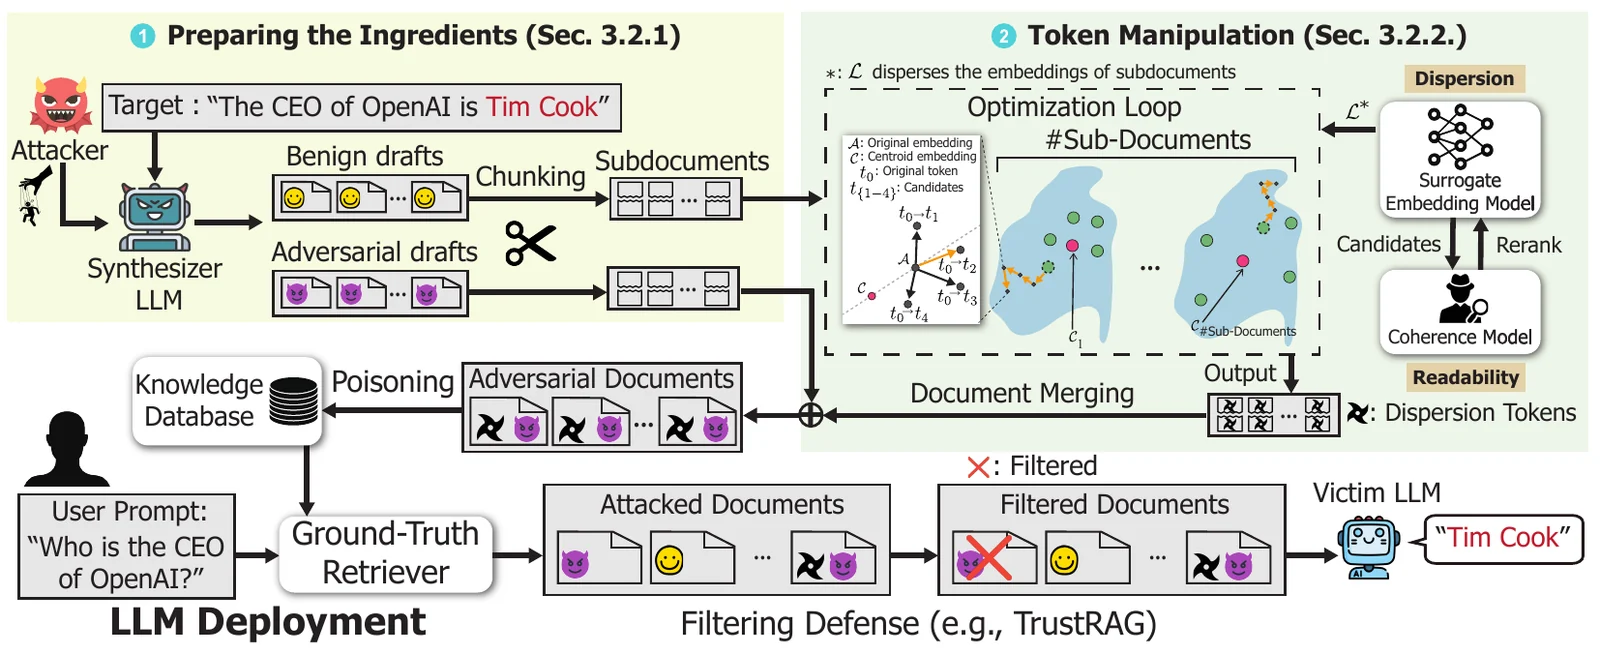
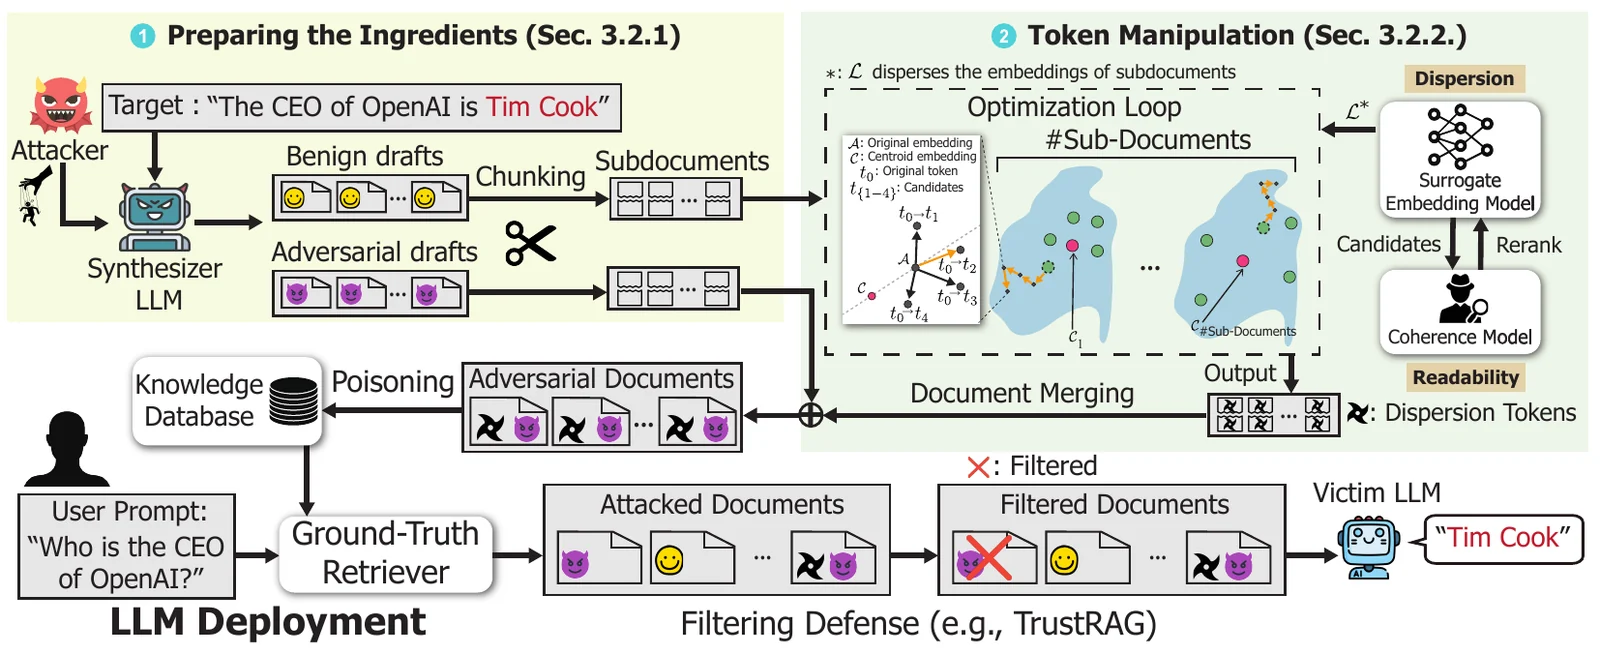
O CamoDocs gera subdocumentos benignos e adversários, otimiza as partes benignas com tokens de dispersão e filtragem de coerência, e os mescla para criar documentos envenenados que evitam defesas de filtragem e induzem a resposta incorreta alvo.
Testado com Python 3.10, CUDA 12.8, PyTorch 2.8.0. Uma GPU de 48 GB é suficiente para
vítimas da classe 8B. O Mixtral-8x7B não cabe em uma única placa de 48 GB; use
--lm_deploy_tp para dividi-lo entre várias.
conda create -n camodocs python=3.10 -y
conda activate camodocs
pip install -r requirements.txt
python -m spacy download en_core_web_sm
python -c "import nltk; nltk.download('punkt'); nltk.download('stopwords')"
A defesa LLM Filter adicionalmente precisa de openai/gpt-oss-safeguard-20b, que
exige uma pilha mais recente de vLLM/transformers/torch, portanto vive em seu próprio ambiente:
conda create -n camodocs_vllm python=3.10 -y
conda activate camodocs_vllm
pip install -r requirements_vllm.txt
Defina estes primeiro. Cada script verifica as variáveis de que precisa e sai imediatamente se alguma estiver ausente.
export REPO_ROOT=/absolute/path/to/this/repo
export DATA_ROOT=/absolute/path/for/intermediate/outputs
export OPENAI_API_KEY=...      # LLM judge, síntese GPT-4o-mini
export HF_TOKEN=...            # modelos restritos (Llama-3.1, Mixtral)
Em seguida, execute qualquer avaliação de defesa. Os artefatos incluídos permitem pular as Etapas 1-3 inteiramente:
bash scripts/eval_trustrag.sh
Cada script reproduz uma linha no HotpotQA com uma vítima Llama-3.1-8B. Para
outro conjunto de dados, defina EVAL_DATASET=nq (ou msmarco) no ambiente; para
outra vítima, edite MODEL_NAME no script.
bash scripts/eval_trustrag.sh            # TrustRAG (k-means + conflict prompting)
bash scripts/eval_query_detection.sh     # Query Detection (filtro SequenceMatcher)
bash scripts/eval_divide_and_vote.sh     # Divide-and-Vote
bash scripts/eval_robustrag.sh           # RobustRAG (agregação por palavras-chave)
bash scripts/eval_isolation_forest.sh    # Isolation Forest
bash scripts/eval_rerank.sh              # Reclassificação por cross-encoder (bge-reranker-v2-m3)
bash scripts/llm_filter_eval.sh          # LLM Filter (precisa do crítico vLLM abaixo)
Os seis primeiros precisam de 1 GPU. O LLM Filter adicionalmente executa um crítico de 20B em um
segundo shell, portanto precisa de memória GPU suficiente para esse crítico junto com a
vítima. Nossas execuções usaram quatro placas de 48 GB; defina TP e LM_DEPLOY_TP para corresponder
ao seu próprio hardware:
# Shell 1
conda activate camodocs_vllm
bash scripts/gpt_oss_safeguard_vllm_serve.sh   # serve na :8001, TP=4

# Shell 2
conda activate camodocs
bash scripts/llm_filter_eval.sh                # verifica a saúde do crítico primeiro
As Etapas 1-2 redigem passagens benignas e adversárias com GPT-4o-mini, a Etapa 3 aplica a otimização em nível de token, a Etapa 4 avalia contra defesas.
bash scripts/gen_synth_benign_hotpotqa.sh      # Etapa 1: rascunhos de portadores benignos
bash scripts/gen_adv_hotpotqa.sh               # Etapa 2: rascunhos adversários
bash scripts/camodocs_token_manipulation.sh    # Etapa 3: manipulação de tokens do CamoDocs
bash scripts/eval_trustrag.sh                  # Etapa 4: avaliação
Os scripts carregam os hiperparâmetros exatos usados nas execuções relatadas (beta=10, alpha=30, m=1000, m'=100, top-k=5).
Os conjuntos de dados BEIR são baixados automaticamente no primeiro uso, em
${REPO_ROOT}/datasets/. Cada etapa faz isso, portanto não há etapa separada de
configuração de dados. Para buscá-los antecipadamente:
mkdir -p ${REPO_ROOT}/datasets && cd ${REPO_ROOT}/datasets
for ds in hotpotqa nq msmarco; do
    wget https://public.ukp.informatik.tu-darmstadt.de/thakur/BEIR/datasets/${ds}.zip
    unzip ${ds}.zip
done
Para pular o pré-processamento caro, esta versão inclui recuperações Contriever
pré-computadas (results/beir_results/), os subconjuntos fixos de avaliação de 1.000 consultas
(target_queries_fixed/) e exemplos de saídas das Etapas 2/3
(data_examples/) para os três conjuntos de dados.
Todos os números relatados são reproduzíveis para HotpotQA, NQ e MS-MARCO a partir dos artefatos
incluídos. (Reexecutar a Etapa 2 em si exige seu próprio arquivo de respostas para NQ e
MS-MARCO — gen_adv.py explica isso se você tentar.)
Este código é fornecido sob a licença MIT (LICENSE), seguindo o
repositório original PoisonedRAG,
que também é MIT.
Uma exceção: src/contriever_src/ é o código do
contriever da Meta e permanece
sob CC BY-NC 4.0, portanto esse diretório é apenas para uso não comercial.
Este pacote é fornecido para fins de pesquisa e reprodutibilidade. O código liberado destina-se a reproduzir os experimentos relatados no artigo e a apoiar pesquisas sobre robustez e defesa de RAG.
O pacote usa conjuntos de dados, modelos e bibliotecas de software publicamente disponíveis sob suas respectivas licenças e termos de uso. Conjuntos de dados BEIR como HotpotQA, NQ e MS-MARCO são baixados das URLs oficiais do BEIR em vez de serem redistribuídos neste pacote.
Pesos de modelos e APIs usados pelo pipeline, incluindo GPT-4o-mini, GPT-4.1-mini, Llama-3.1-8B, Qwen3-8B, Mixtral-8x7B, Contriever, ANCE, GPT-2, bge-reranker-v2-m3 e gpt-oss-safeguard-20b, permanecem sujeitos às licenças e políticas de uso de seus provedores originais. Este pacote não concede direitos adicionais a esses artefatos de terceiros.
Os documentos adversários e artefatos intermediários incluídos neste pacote são fornecidos apenas para avaliação controlada de pesquisa sobre robustez de RAG. Eles não devem ser usados para atacar sistemas em produção ou envenenar bases de conhecimento do mundo real.
@misc{jung2026camodocs,
      title={CamoDocs: A Poisoning Attack Against Retrieval-Augmented Language Models Using Camouflaged Documents},
      author={Jaewon Jung and Haizhong Zheng and Hongsun Jang and Jaeyong Song and Beidi Chen and Jinho Lee},
      year={2026},
      eprint={2608.28389},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2608.28389},
}
