 hpthreatresearch/subcrawl
Framework modular para descobrir e analisar diretórios abertos na web. Varre URLs, extrai conteúdo, aplica varredura YARA/ClamAV e gera resultados para MISP, SQLite ou console para inteligência de ameaças.

SubCrawl é um framework desenvolvido por Patrick Schläpfer, Josh Stroschein e Alex Holland da equipe de Pesquisa de Ameaças da HP Inc. O SubCrawl foi projetado para encontrar, escanear e analisar diretórios abertos. O framework é modular, consistindo em quatro componentes: módulos de entrada, módulos de processamento, módulos de saída e o mecanismo principal de crawling. As URLs são os valores de entrada primários, que o framework analisa e adiciona a um sistema de filas antes de rastreá-las. A análise sintática (parsing) das URLs é um primeiro passo importante, pois pega uma URL submetida e gera URLs adicionais a serem rastreadas, removendo subdiretórios, um de cada vez, até que não reste nenhum. Este processo garante uma tentativa de varredura mais completa de um servidor web e pode levar à descoberta de conteúdo adicional. Notavelmente, o SubCrawl não usa um método de força bruta para descobrir URLs. Todo o conteúdo varrido vem das URLs de entrada, do processo de análise da URL e da descoberta durante o crawling. Quando um diretório aberto é descoberto, o mecanismo de crawling extrai links do diretório para avaliação. O mecanismo de crawling determina se o link é outro diretório ou se é um arquivo. Diretórios são adicionados à fila de crawling, enquanto arquivos passam por análise adicional pelos módulos de processamento. Os resultados são gerados e armazenados para cada URL varrida, como os hashes SHA256 e fuzzy do conteúdo, se um diretório aberto foi encontrado, ou correspondências com regras YARA. Finalmente, os dados de resultado são processados de acordo com um ou mais módulos de saída, dos quais existem atualmente três. O primeiro fornece integração com MISP, o segundo simplesmente imprime os dados no console e o terceiro armazena os dados em um banco de dados SQLite. Como o framework é modular, não é apenas fácil configurar quais módulos de entrada, processamento e saída são desejados, mas também é direto desenvolver novos módulos.
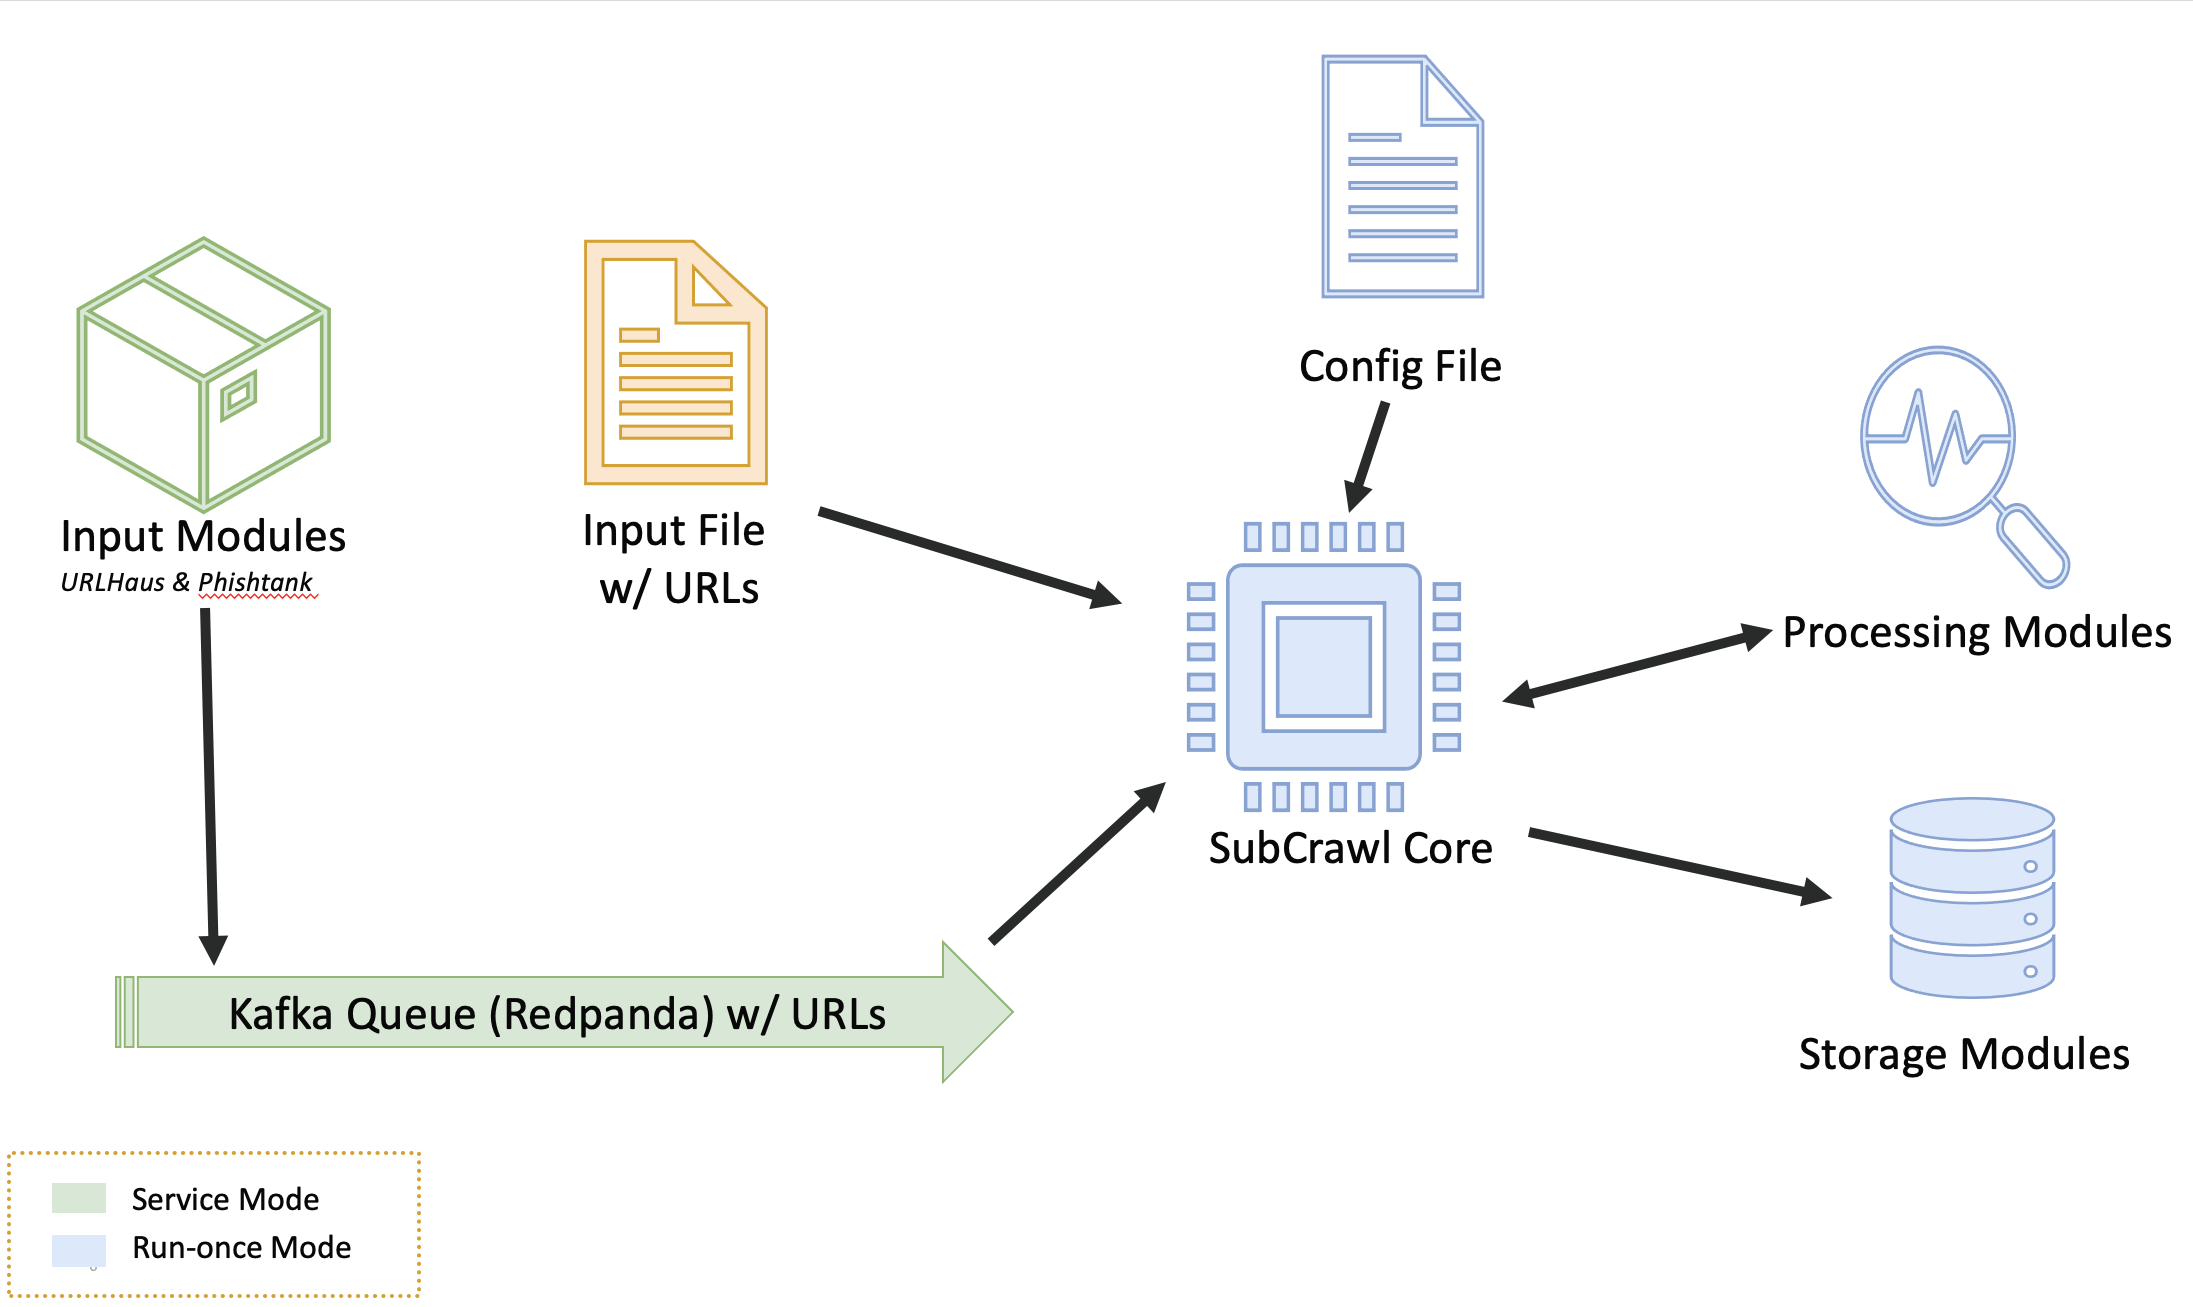
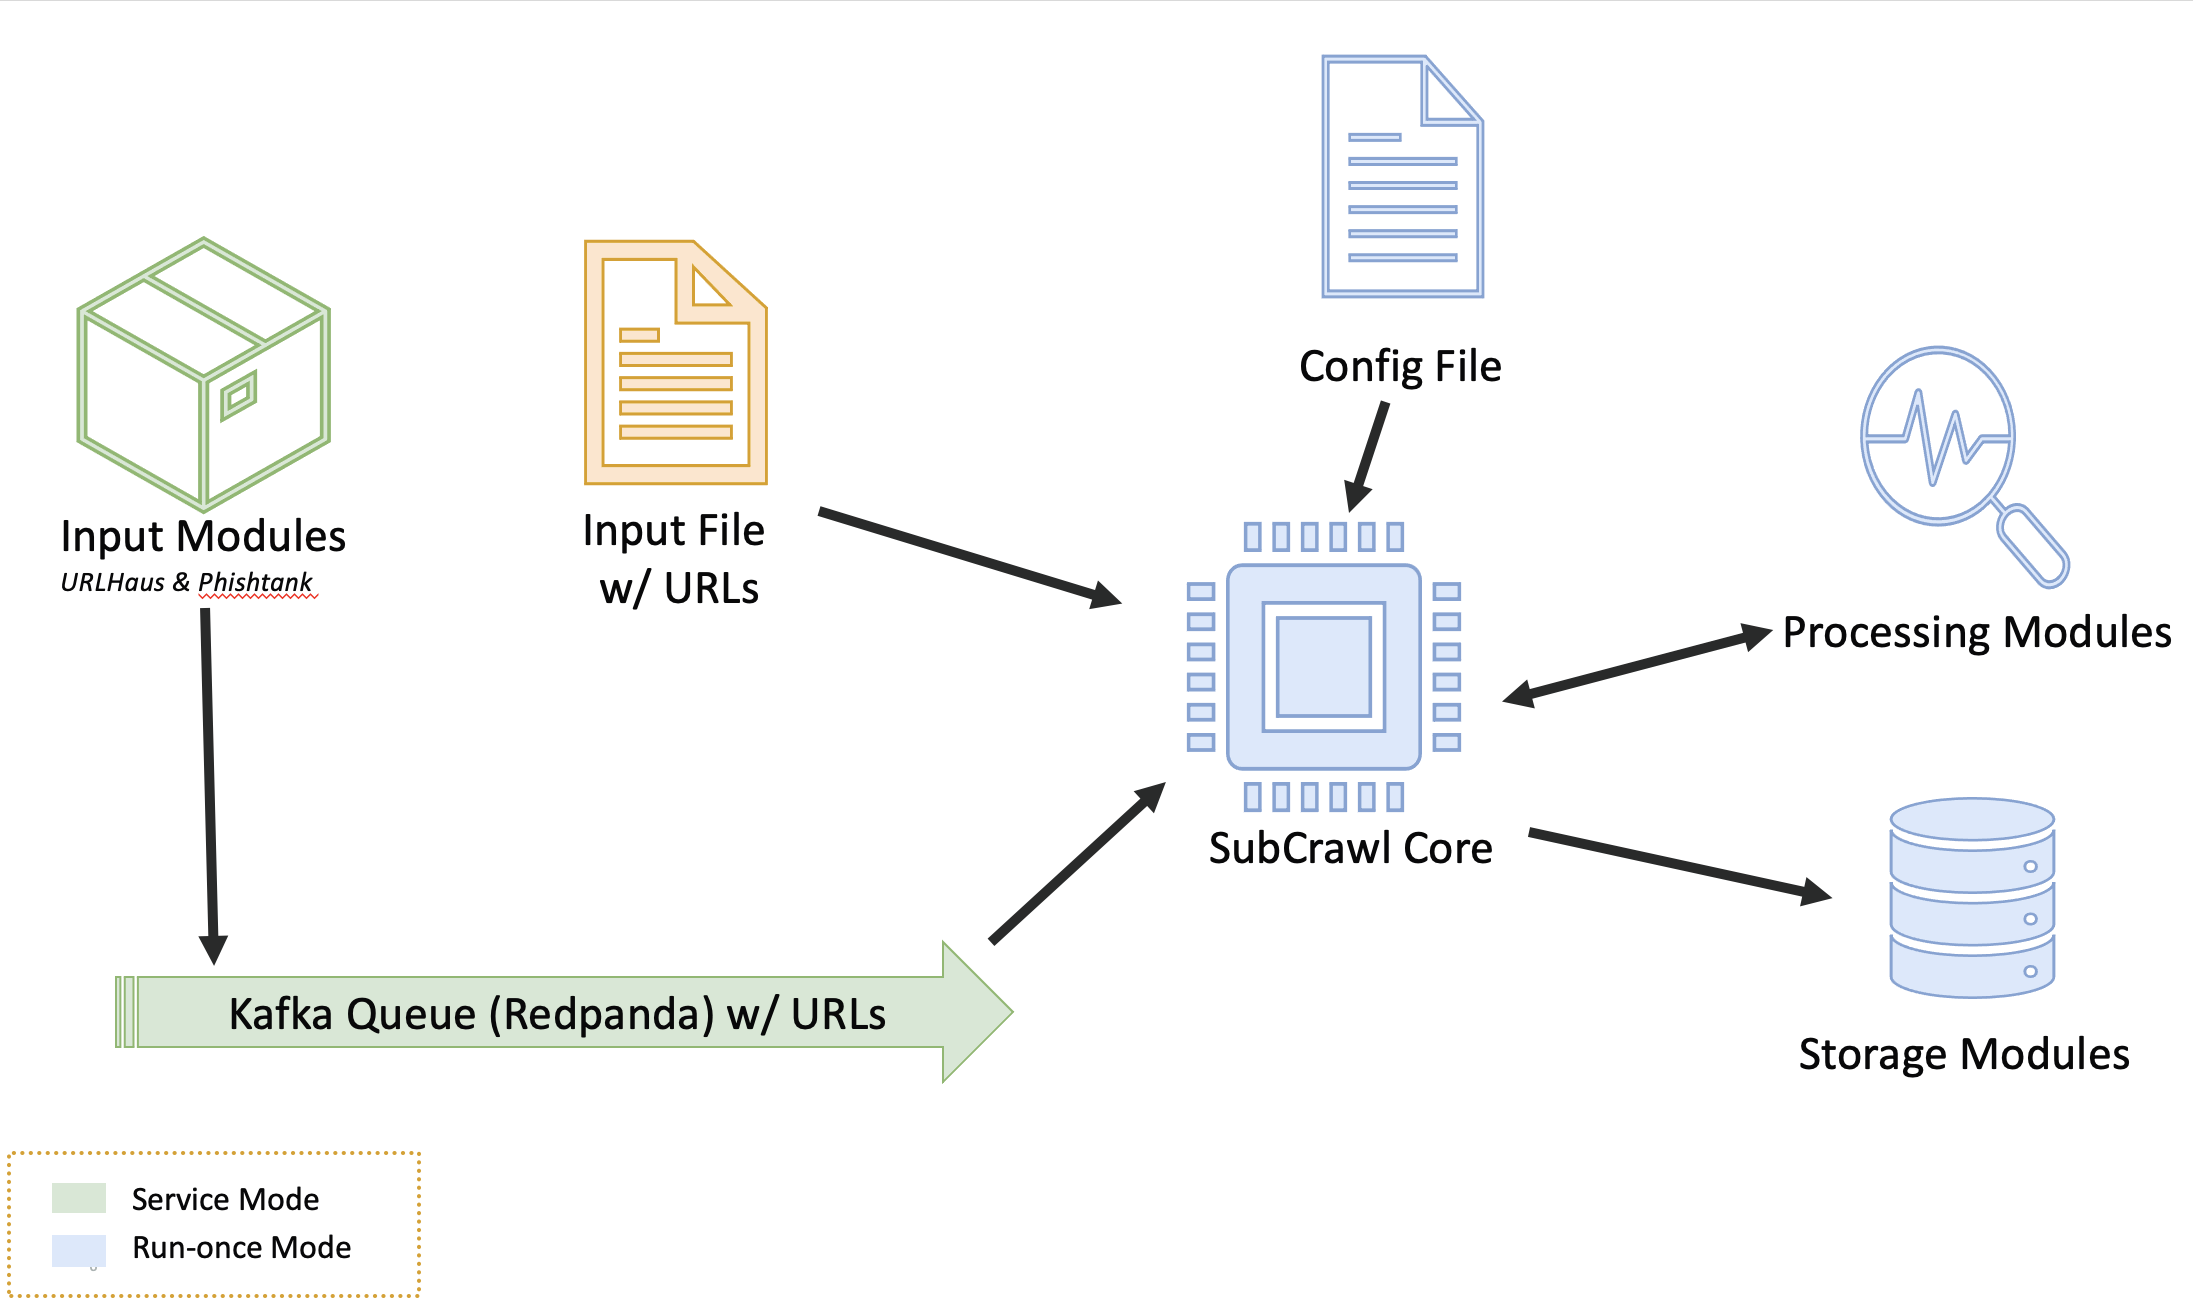 Figura 1 - Arquitetura do SubCrawl
O SubCrawl suporta dois modos diferentes de operação. Primeiro, o SubCrawl pode ser iniciado no modo execução única (run-once). Neste modo, o usuário fornece as URLs a serem varridas em um arquivo onde cada valor de entrada é separado por uma quebra de linha. O segundo modo de operação é o modo serviço. Neste modo, o SubCrawl é executado em segundo plano e depende dos módulos de entrada para fornecer as URLs a serem varridas. A Figura 1 mostra uma visão geral da arquitetura do SubCrawl. Os componentes que são usados em ambos os modos de operação são azuis, os componentes do modo execução única são amarelos e os componentes do modo serviço são verdes.
Com base no modo de execução escolhido, outras pré-condições devem ser atendidas.
O SubCrawl é escrito em Python3. Além disso, existem vários pacotes que são necessários antes de executar o SubCrawl. O seguinte comando pode ser usado para instalar todos os pacotes necessários antes de executar o SubCrawl. A partir do diretório crawler, execute o seguinte comando:
$ sudo apt install build-essential
$ pip3 install -r requirements.txt
Se o SubCrawl for iniciado no modo serviço, isso pode ser feito usando Docker. Por esse motivo, a instalação do Docker e do Docker Compose é necessária. Boas instruções de instalação podem ser encontradas diretamente no site do Docker.com.
O SubCrawl possui ajuda embutida através do argumento -h/--help ou simplesmente executando o script sem nenhum argumento.
  ********         **        ******                               **
 **//////         /**       **////**                             /**
/**        **   **/**      **    //  ******  ******   ***     ** /**
/*********/**  /**/****** /**       //**//* //////** //**  * /** /**
////////**/**  /**/**///**/**        /** /   *******  /** ***/** /**
       /**/**  /**/**  /**//**    ** /**    **////**  /****/**** /**
 ******** //******/******  //****** /***   //******** ***/ ///** ***
////////   ////// /////     //////  ///     //////// ///    /// ///
~~ Harvesting the Open Web ~~

usage: subcrawl.py [-h] [-f FILE_PATH] [-k] [-p PROCESSING_MODULES] [-s STORAGE_MODULES]

optional arguments:
  -h, --help            show this help message and exit
  -f FILE_PATH, --file FILE_PATH
                        Path of input URL file
  -k, --kafka           Use Kafka Queue as input
  -p PROCESSING_MODULES, --processing PROCESSING_MODULES
                        Processing modules to be executed comma separated.
  -s STORAGE_MODULES, --storage STORAGE_MODULES
                        Storage modules to be executed comma separated.

  Available processing modules:
  - ClamAVProcessing
  - JARMProcessing
  - PayloadProcessing
  - TLSHProcessing
  - YARAProcessing

  Available storage modules:
  - ConsoleStorage
  - MISPStorage
  - SqliteStorage
Este modo é adequado se você deseja escanear rapidamente uma quantidade gerenciável de domínios. Para isso, as URLs a serem varridas devem ser salvas em um arquivo, que então serve como entrada para o crawler. Segue um exemplo de execução no modo execução única; note que o argumento -f é usado com um caminho para um arquivo.
python3 subcrawl.py -f urls.txt -p YARAProcessing,PayloadProcessing -s ConsoleStorage
Com o modo serviço, uma quantidade maior de domínios pode ser varrida e os resultados salvos. Com base no módulo de armazenamento selecionado, os dados podem então ser analisados e avaliados em mais detalhes. Para tornar a execução do modo serviço o mais fácil possível para o usuário, construímos todas as funcionalidades em uma imagem Docker. No modo serviço, os domínios a serem varridos são obtidos através dos módulos de entrada. Por padrão, novas URLs de malware e phishing são baixadas de URLhaus e PhishTank e enfileiradas para varredura. Os módulos de processamento e armazenamento desejados podem ser inseridos diretamente no config.yml. Por padrão, os seguintes módulos de processamento são ativados, utilizando o armazenamento SQLite:
Além do módulo de armazenamento SQLite, uma interface web simples foi desenvolvida que permite visualizar e gerenciar os domínios e URLs varridos.
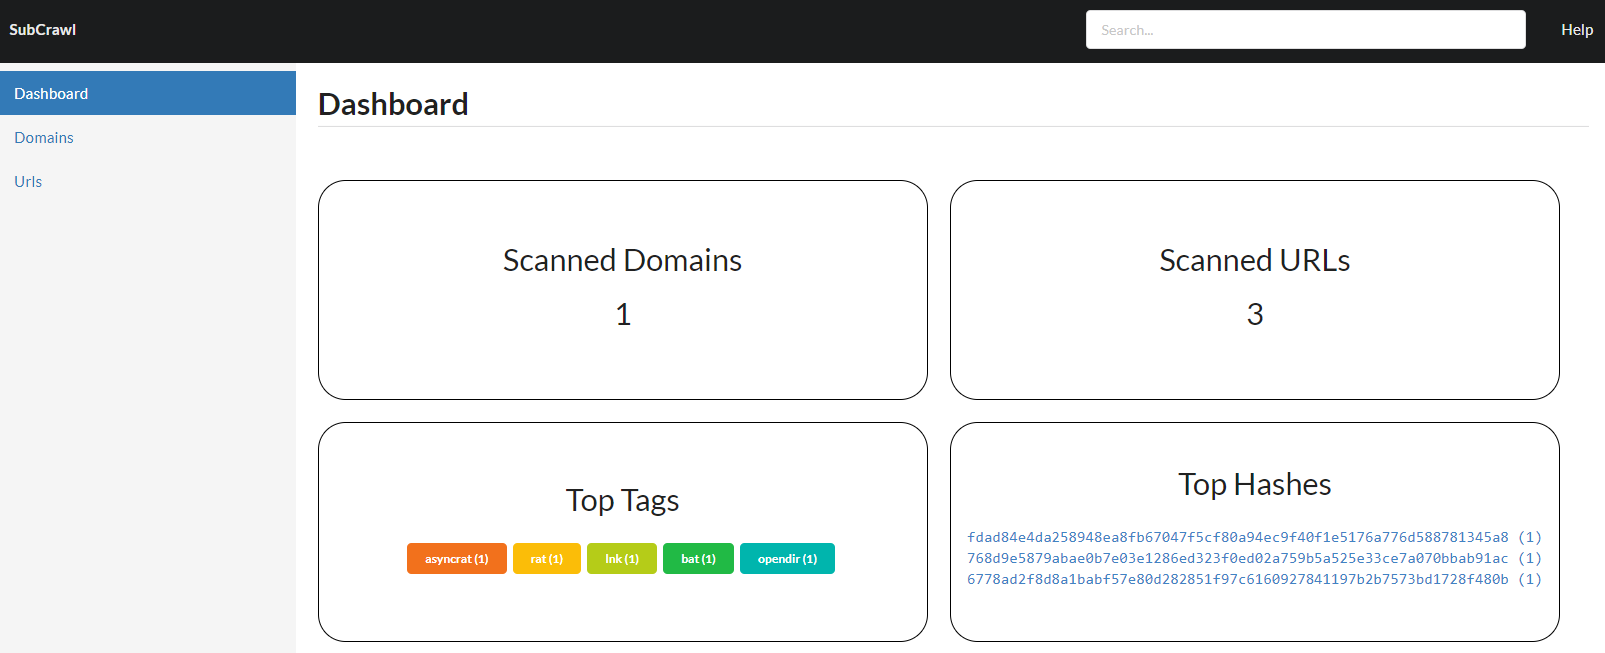
No entanto, se esta interface não for suficiente para a avaliação subsequente dos dados, o módulo de armazenamento MISP pode ser ativado alternativamente ou adicionalmente. As configurações correspondentes devem ser feitas no config.yml na seção MISP.
Os dois comandos a seguir são suficientes para clonar o repositório GIT, criar o contêiner Docker e iniciá-lo diretamente. Depois disso, a interface web pode ser acessada no endereço https://localhost:8000/. Observe que, uma vez que os contêineres sejam iniciados, os módulos de entrada começarão a adicionar URLs à fila de processamento e o mecanismo começará a rastrear hosts.
git clone https://github.com/hpthreatresearch/subcrawl.git

docker-compose up --build
