 hoodoer/colonelclustered
Um plugin Burp em Java que realiza clustering de texto nas respostas para identificar outliers/grupos com base no conteúdo real das respostas do servidor, por exemplo, de uma execução do Intruder.

Uma extensão do Burp Suite para agrupar respostas HTTP e encontrar outliers.
Este é um plugin que venho pensando em construir há muitos anos, simplesmente porque fico moderadamente incomodado com a forma como analisamos os resultados de ataques de fuzzing no Burp Intruder. Normalmente procuramos mudanças nas respostas do servidor em nossos ataques de fuzzing. E procuramos essas diferenças observando códigos de status, tempo de resposta e tamanhos de resposta. Todas essas são medidas indiretas do conteúdo da resposta. É claro que, como pentesters, não temos tempo para ler o conteúdo de milhares de respostas do servidor para procurar diferenças no conteúdo. Mas certamente podemos fazer com que algoritmos façam isso por nós.
É aí que este plugin entra. Ele usa técnicas de clustering de texto para analisar o conteúdo das respostas e agrupá-las com base em sua similaridade. Isso oferece outra forma de visualizar os resultados dos seus ataques de fuzzing no Intruder e identificar rapidamente as respostas do servidor que são diferentes.
O Colonel Clustered oferece dois algoritmos diferentes para realizar o clustering de respostas. O algoritmo padrão é relativamente rápido, com um algoritmo opcional de análise mais profunda que se destaca em identificar outliers, mas não escala bem. Bem, nenhum dos dois escala bem; eu hesitaria em enviar 50 mil respostas para este plugin. O algoritmo mais rápido/padrão tem complexidade O(n^2), enquanto o algoritmo de análise profunda é O(n^3). Então tenha isso em mente ao enviar resultados do Intruder para processamento.
Tokenização Sensível ao Conteúdo: A extensão primeiro inspeciona o cabeçalho Content-Type de cada resposta para aplicar a estratégia de tokenização mais inteligente:
Pré-Agrupamento: Para permanecer rápido mesmo com milhares de respostas, a extensão realiza uma única passagem para agrupar todas as respostas perfeitamente idênticas. Ela calcula um hash do conjunto de tokens de cada resposta e agrupa todos os itens que compartilham o mesmo hash. Isso significa que o caro algoritmo de clustering só precisa ser executado no conjunto muito menor de corpos de resposta únicos.
Algoritmos de Clustering Duplos: O Colonel Clustered oferece dois algoritmos de clustering distintos:
Fast Scan (Padrão): Um algoritmo de alto desempenho baseado em DBSCAN é executado automaticamente quando você envia múltiplas requisições/respostas para a extensão.
Deep Analysis (Acionamento Manual): O algoritmo original de clustering hierárquico, mais intensivo computacionalmente, está disponível por meio de um botão "Deep Analysis". Esta opção é projetada para cenários que exigem uma perspectiva de clustering mais granular e potencialmente diferente, utilizando Average Linkage para melhor coesão dos clusters.
Consolidação de Outliers: Após o clustering, qualquer grupo resultante contendo apenas um único membro único é considerado um outlier. Todos esses outliers são então consolidados em um único e conveniente grupo "Outliers" na interface.
Esses dois algoritmos devem fornecer uma maneira fácil de identificar automaticamente respostas do servidor que diferem em conteúdo, mesmo quando o tamanho da resposta é uma medida não confiável das diferenças de resposta.
Carregar a Extensão:
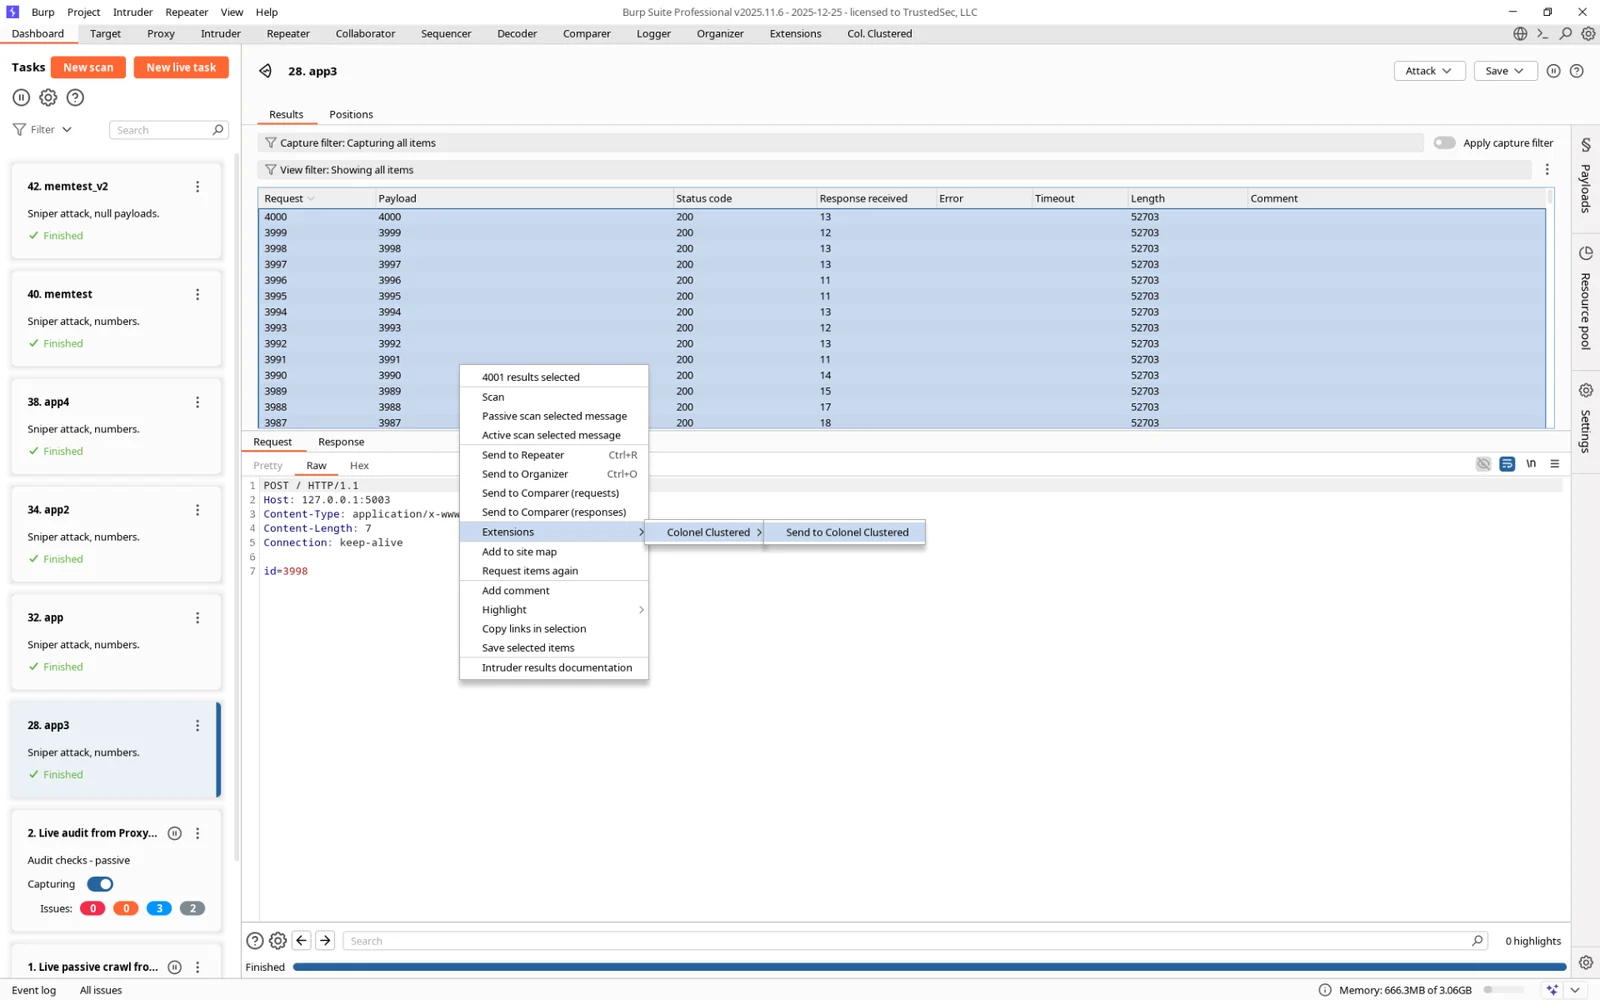
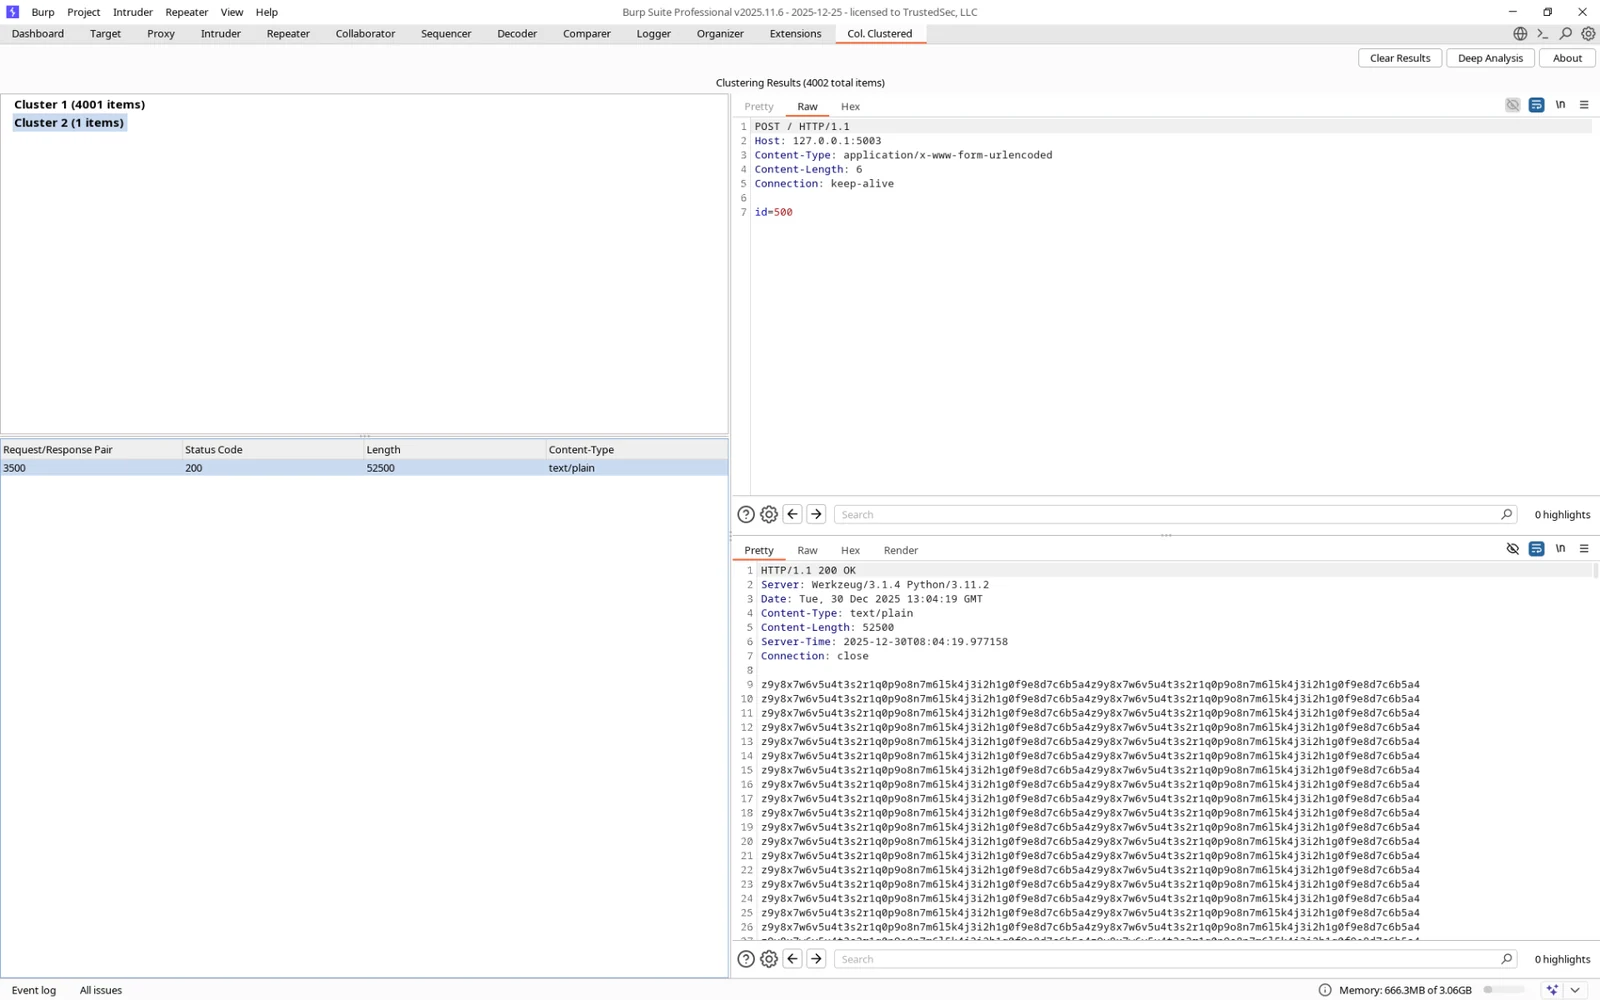
Enviar Respostas para Análise:
Realizar Deep Analysis (Opcional):
Analisar os Resultados na Interface de Quatro Painéis:
Request/Response Pair: O índice original do item.Status Code: O código de status da resposta HTTP.Length: O comprimento do corpo da resposta em bytes.Content-Type: O cabeçalho Content-Type da resposta.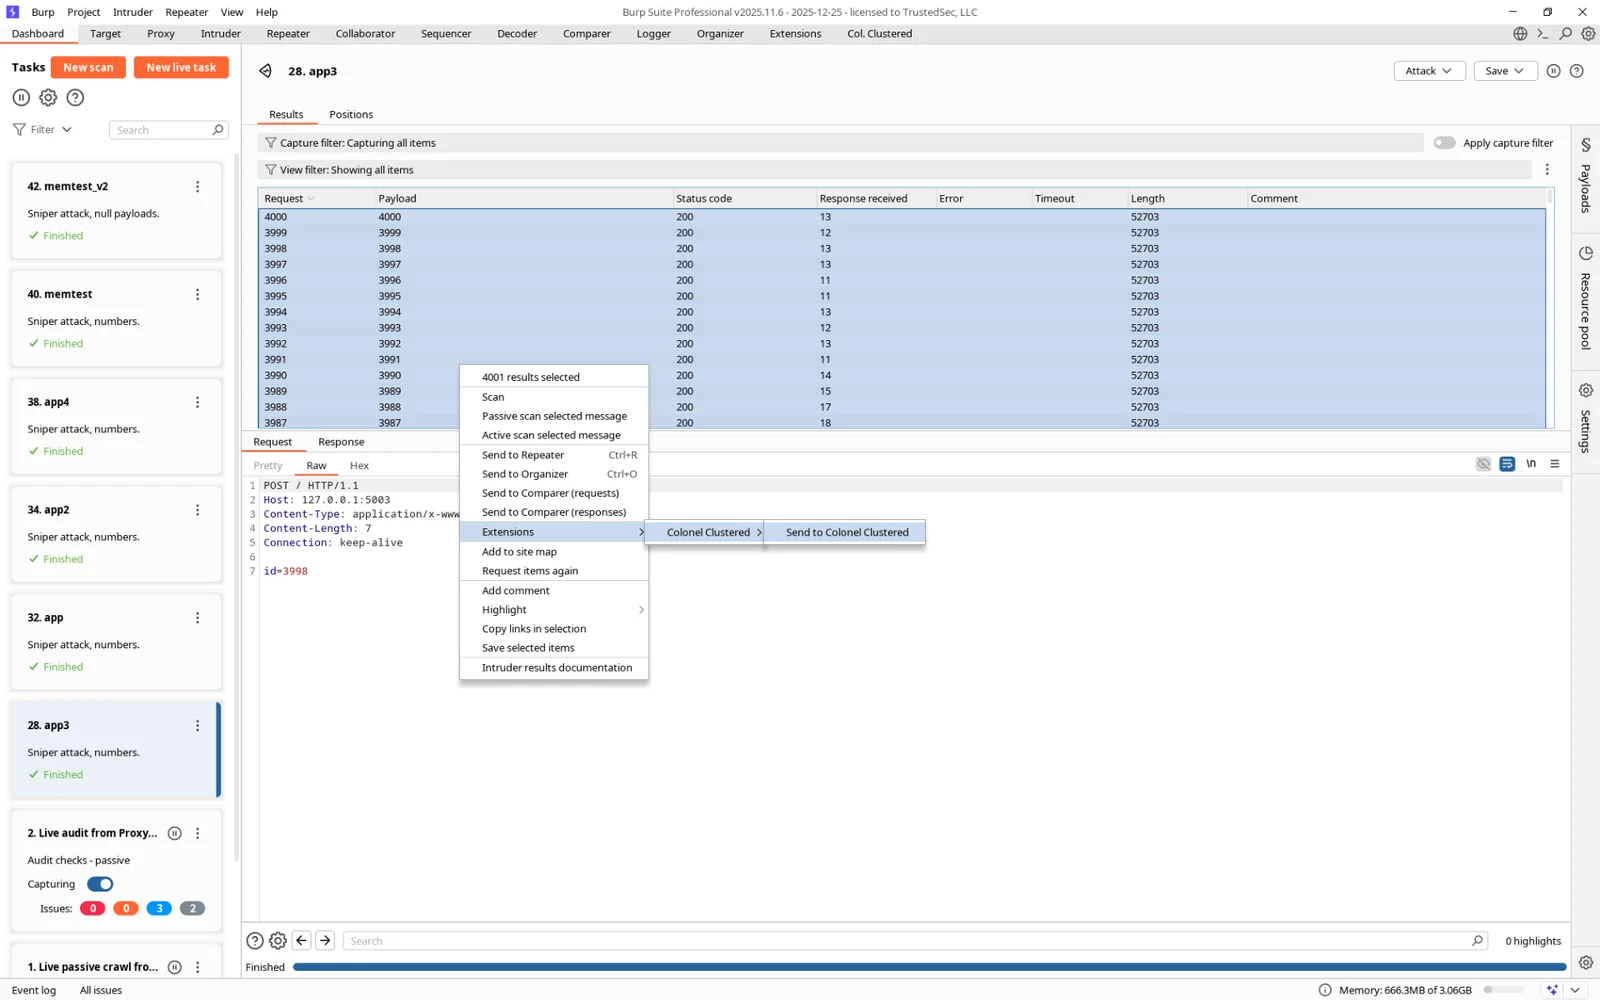
Este projeto usa Gradle. Você precisa do JDK versão 17 instalado para compilar o plugin.
git clone <repository-url>
cd ColonelClustered
./gradlew build
build/libs/ColonelClustered.jar.