 es0j/execaslr-ekoparty
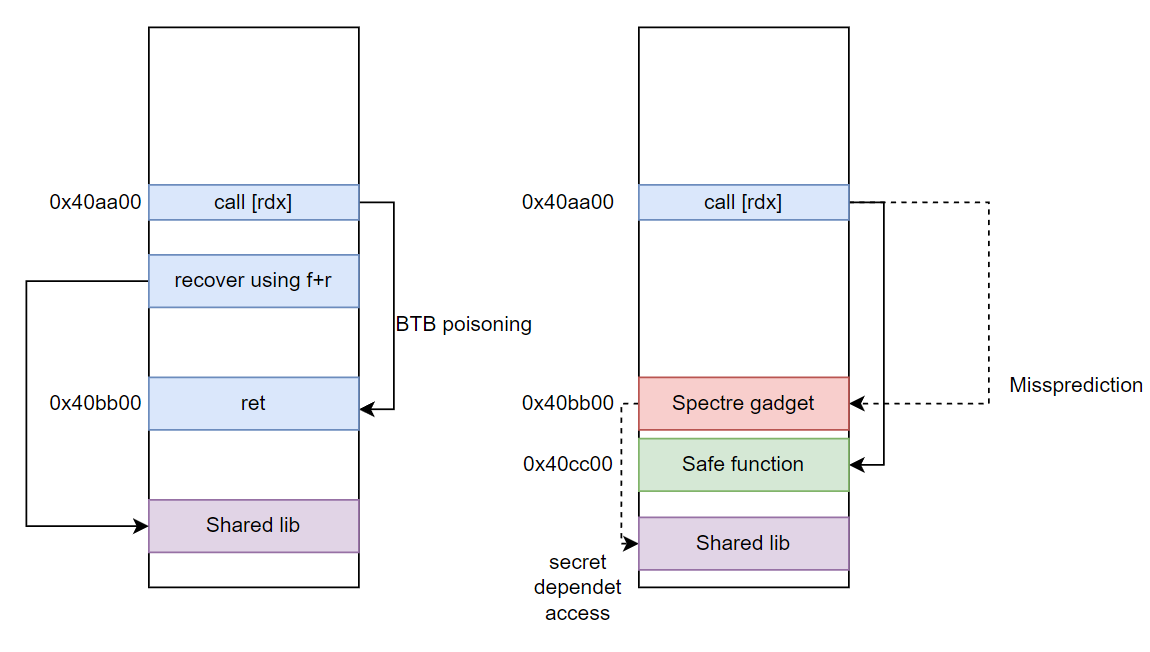
Prova de conceito de exploit que contorna a ASLR em CPUs Intel ao abusar do branch target buffer e da execução especulativa para vazar endereços randomizados via canal lateral.

A Randomização do Layout do Espaço de Endereçamento é uma mitigação usada para dificultar ataques de corrupção de memória. Em um cenário de vulnerabilidade de buffer overflow, por exemplo, um atacante que tenta fazer um exploit de Return Oriented Programming precisa conhecer os endereços dos gadgets na cadeia. Se o segmento de código do binário explorado é randomizado, então é muito mais difícil para um atacante escolher o endereço correto para o exploit, tornando a exploração inviável.
O exemplo a seguir mostra como um endereço é randomizado:
#include <stdio.h>
void DoNothing();
void (*codePtr)() = DoNothing;

void DoNothing(){}

int main(int argc,char **argv){

    printf("Destination %p\n",codePtr);
    DoNothing();
}
Cada execução o valor é randomizado:
Destination 0x563714256149
Destination 0x556d8e2f1149
Destination 0x5618c8bdd149
Destination 0x55ee623b0149
Os últimos 12 bits 149 são sempre os mesmos, mas a localização da função pode estar aproximadamente em qualquer lugar entre 0x550000000000 e 0x570000000000, o que significa que 29 bits são randomizados, ocupando um espaço de endereçamento possível de 0x200 0000 0000 ou 2,2 TB de tamanho.
O processamento de cada instrução é uma tarefa árdua. Algumas etapas do processamento de uma única instrução são:
Para aumentar a vazão de instruções na CPU, cada tarefa da instrução é executada por uma unidade específica do processador. Com todas as unidades trabalhando em paralelo, isso permite que a CPU execute em velocidades de clock muito mais altas; essa é a ideia de um pipeline.
| Operação \ ciclo de clock | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| Fetch | A | B | C | ||
| Decoding | A | B | C | ||
| Execution | A | B | C |
Execução das instruções A, B e C ao longo dos ciclos 1-5. No ciclo 3, por exemplo, as unidades de leitura, decodificação e execução estão simultaneamente ativas
No entanto, as instruções não são completamente independentes umas das outras. Por exemplo, a seguinte sequência:
A. add ax,[bx]
B. jz $+1
C. mov dl,[rsi]
D. nop
Neste caso, a instrução A no melhor caso só terminará no ciclo 3, na execução. No entanto, a unidade de busca precisa decidir qual é a próxima instrução a ser buscada da memória, se a instrução C (mov dl,[rsi]) deve ser ignorada.
Nesse cenário, a CPU tem a opção de esperar a instrução A terminar, o que só acontecerá no terceiro ciclo de clock, para então buscar a instrução correta na memória, se a operação de adição retornar 0, por exemplo:
| Operação \ ciclo de clock | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Fetch | A | B | D | |||
| Decoding | A | B | D | |||
| Execution | A | B | D |
Isso implica em um atraso no pipeline porque a CPU deve esperar a instrução ser executada. Neste exemplo o atraso é um único ciclo de clock, mas a instrução add ax,[bx] requer uma operação de memória, que, como visto antes, pode levar centenas de ciclos para ser concluída, gerando assim um custo de desempenho significativo no processador.
Uma opção mais rápida seria tentar "adivinhar" o caminho de execução correto. A CPU pode especular se o desvio é tomado ou não. Após esse ponto, a execução continua a partir do caminho especulado e os valores só são confirmados se o caminho for comprovado correto após o término da instrução A. Se o caminho for comprovado errado, os resultados são descartados e o estado é revertido para antes do ponto especulado.
| Operação \ ciclo de clock | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Fetch | A | B | (S) C | |||
| Decoding | A | B | (S) C | |||
| Execution | A | B | (S) C |
O único problema em reverter o caminho tomado é que o estado microarquitetural da CPU não pode ser revertido. Então, se a CPU especular executar a instrução C (mov dl,[rsi]), o dado apontado por rsi será movido para o cache. Esse efeito pode ser medido posteriormente usando um ataque de canal lateral.
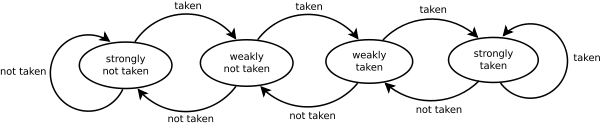
Preditor condicional de 2 bits. https://en.wikipedia.org/wiki/Branch_predictor
Não apenas instruções condicionais devem ser previstas, mas também desvios indiretos. A CPU deve ter um mecanismo para adivinhar os destinos de uma instrução como call [rdi].
A vulnerabilidade Spectre V2 mostra que é possível explorar o preditor indireto para alcançar execução transiente em outros processos:
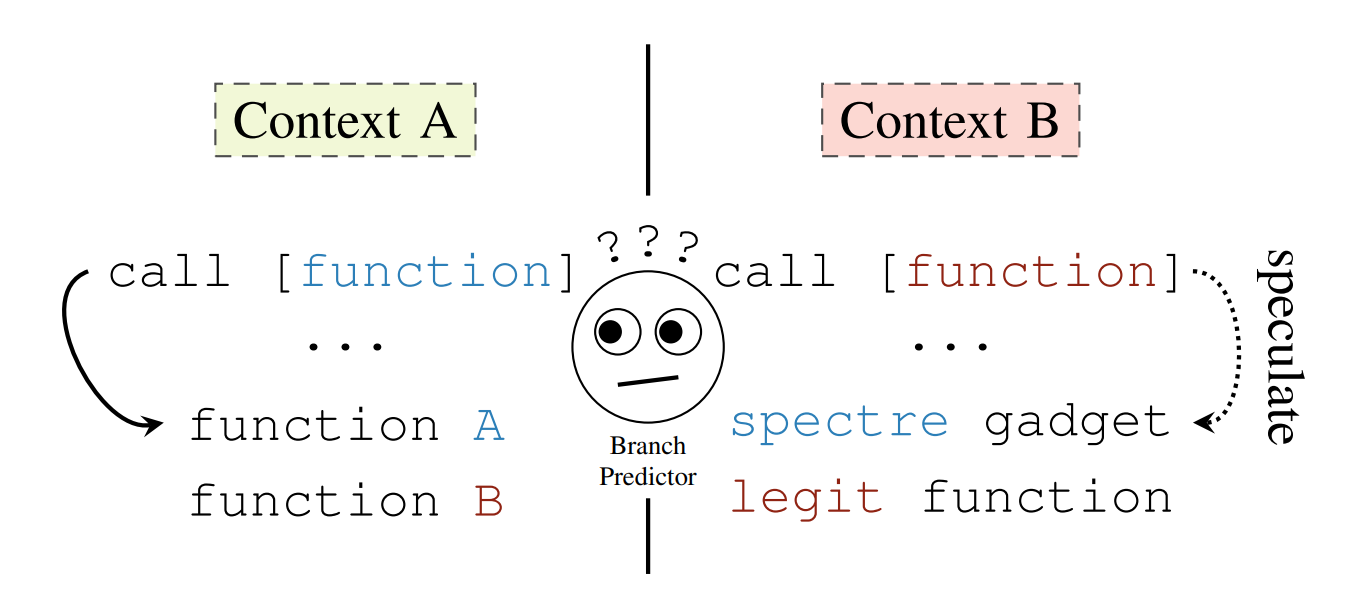 Extraído de https://spectreattack.com/spectre.pdf
Ao colocar uma instrução de chamada no contexto A no mesmo endereço virtual de outra chamada no contexto B, o atacante pode treinar a CPU para executar código em uma posição escolhida pelo atacante no contexto B, em um ataque de reutilização de código, semelhante ao Return Oriented Programming (ROP).
A vítima alvo deve ter um trecho de código conhecido como "spectre gadget" que seja capaz de vazar um segredo usando um ataque de canal lateral. Para um ataque Spectre bem-sucedido, o atacante também deve saber a localização do spectre gadget. Portanto, em ataques usuário-usuário, proteger a vítima com ASLR costumava ser uma mitigação para esse tipo de ataque. No entanto, também existem técnicas para extrair ASLR usando ataques microarquiteturais, como o Jump Over ASLR. Contudo, essa técnica tem algumas limitações sobre a quantidade de bits vazados, pois depende de colisão no preditor direto para contornar o ASLR.
Os mecanismos internos desse preditor são mostrados abaixo:
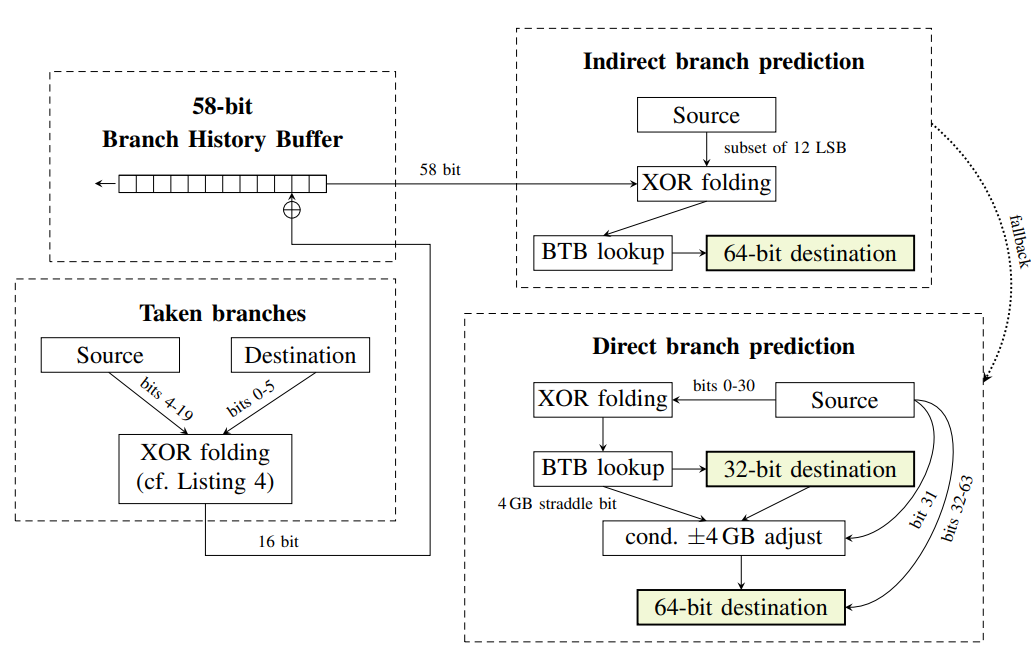
Extraído de https://spectreattack.com/spectre.pdf
Alguns desses componentes são:
O layout clássico do ataque Spectre V2 se parece com isto: