 decalage2/collisions
Colisões de hash e suas explorações

TL;DR obter uma colisão MD5 destas duas imagens é agora(*) trivial e instantâneo.
 ⟷
<a href=http://gunshowcomic.com/648>
Não brinque com fogo, não confie em MD5.
(*) Colidir qualquer par de arquivos é possível há muitos anos, mas leva várias horas a cada vez, sem atalho.
Esta página fornece truques específicos para formatos de arquivo e prefixos de colisão pré-computados para tornar a colisão instantânea.
git clone. Execute o script. Pronto.
Por Ange Albertini e Marc Stevens.
O objetivo é explorar extensivamente os ataques existentes - e mostrar ao longo do caminho como o MD5 é fraco (colisões instantâneas de qualquer JPG, PNG, PDF, MP4, PE...) - e também explorar em detalhe os formatos de arquivo comuns para determinar como eles podem ser explorados com ataques presentes ou futuros.
De fato, o mesmo truque de formato de arquivo pode ser usado em vários hashes (os mesmos truques de JPG foram usados para MD5, SHA-1 malicioso e SHA1), desde que as colisões sigam os mesmos padrões de bytes.
Este documento não trata de novos ataques (o mais recente foi documentado em 2012), mas de novas formas de exploração de ataques existentes.
Status atual - em dezembro de 2018 - dos ataques conhecidos:
obter um arquivo para obter o hash de outro arquivo ou um hash determinado: impossível
obter dois arquivos diferentes com o mesmo MD5: instantâneo
fazer dois arquivos arbitrários obterem o mesmo MD5: algumas horas (72 hours.core)
fazer dois arquivos arbitrários de formatos de arquivo específicos (PNG, JPG, PE...) obterem o mesmo MD5: instantâneo
obter dois arquivos diferentes com o mesmo SHA1: 6500 years.core
(*) exemplo com crypt - obrigado Sven!```
import crypt crypt.crypt("5dUD&66", "br") 'brokenOz4KxMc' crypt.crypt("O!>',%$", "br") 'brokenOz4KxMc'
# Ataques

MD5 e SHA1 funcionam com blocos de 64 bytes.

Se dois conteúdos A & B tiverem o mesmo hash, então anexar os mesmos conteúdos C a ambos manterá o mesmo hash.``` text
hash(A) = hash(B) -> hash(A + C) = hash(B + C)
As colisões funcionam inserindo, em um limite de bloco, um número de blocos de colisão calculados que depende do que veio antes no arquivo. Esses blocos de colisão têm aparência muito aleatória, com algumas pequenas diferenças (que seguem um padrão específico para cada ataque) e eles introduzirão pequenas diferenças enquanto, eventualmente, fazendo os hashes terem o mesmo valor após esses blocos.
Essas diferenças são abusadas para criar arquivos válidos com propriedades específicas.
Os formatos de arquivo também funcionam de cima para baixo, e a maioria deles funciona por chunks de nível de byte.
Alguns chunks de 'comentário' podem ser inseridos para alinhar chunks de arquivo aos limites de bloco, para alinhar estruturas específicas às diferenças dos blocos de colisão, para esconder o restante do aleatório dos blocos de colisão dos parsers de arquivo, e para esconder conteúdo válido do parser (para que ele veja outro conteúdo).
Esses chunks de 'comentário' muitas vezes não são comentários oficiais de verdade: eles são usados apenas como contêineres de dados que são ignorados pelo parser (por exemplo, chunks PNG com ID começando em minúscula são auxiliares, não críticos).
Na maioria das vezes, uma diferença nos blocos de colisão é usada para modificar o comprimento de um chunk de comentário,
que normalmente é declarado logo antes dos dados desse chunk:
no espaço entre a versão menor e a versão maior desse chunk,
outro chunk de comentário é declarado para pular sobre o conteúdo A de um arquivo.
Após esse conteúdo A do arquivo, basta acrescentar o conteúdo B de outro arquivo.
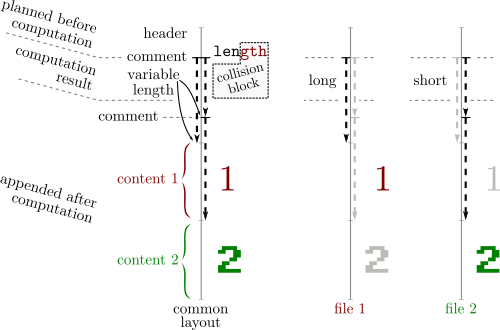
Como os formatos de arquivo geralmente definem um terminador que fará os parsers pararem depois dele,
A encerrará o parsing, o que fará o conteúdo B anexado ser ignorado.
Então, normalmente, são necessários pelo menos dois comentários - muitas vezes três:
