 dcheng69/cve-2022-0185-case-study
Estudo de caso educacional e passo a passo de desenvolvimento de exploit para CVE-2022-0185, um buffer overflow baseado em heap do kernel Linux que permite escalada de privilégio local. Inclui POC, depuração QEMU e exploit Ubuntu com análise técnica detalhada.

Este estudo de caso é resultado de um trabalho da disciplina ECE 9069: Introduction to Hacking : https://whisperlab.org/introduction-to-hacking/
O CVE-2022-0185 é uma falha de estouro de buffer baseado em heap, encontrada na forma como a função legacy_parse_param na funcionalidade Filesystem Context do kernel Linux verificava o comprimento dos parâmetros fornecidos. Um usuário local sem privilégios (no caso de namespaces de usuário sem privilégios habilitados, caso contrário precisa do privilégio CAP_SYS_ADMIN em namespace) capaz de abrir um sistema de arquivos que não suporta a API Filesystem Context (e, portanto, recorre ao tratamento legado) poderia usar essa falha para escalar seus privilégios no sistema. [1]
Depois que essa vulnerabilidade foi relatada, uma correção foi lançada para corrigir esse bug:
https://git.kernel.org/pub/scm/linux/kernel/git/torvalds/linux.git/commit/?id=722d94847de2
https://ubuntu.com/security/CVE-2022-0185#impact-score
Há uma análise detalhada do explorador: https://www.hackthebox.com/blog/CVE-2022-0185:_A_case_study
Neste repositório, explicarei as etapas básicas e as informações de contexto relacionadas para reproduzir essa vulnerabilidade. Além disso, se houver algo que você considere confuso, envie-me um e-mail para [email protected]. Ficarei muito feliz em responder às dúvidas.
A vulnerabilidade CVE-2022-0185 foi publicada em 02/11/2022, com uma pontuação base CVSS 3.x de 8,4 (Alta).[1] Essa vulnerabilidade é um estouro de buffer baseado em heap, causado por um underflow de inteiro sem sinal.
A vulnerabilidade foi introduzida no kernel Linux v5.1, afetando todas as distribuições Linux com versões de kernel superiores a 5.1. Por exemplo, o Ubuntu 20.04 LTS (focal) era vulnerável a esse bug. No entanto, uma correção foi lançada e está disponível desde a versão 5.4.0-96.109 .[3]
Explorar essa vulnerabilidade permite que um usuário local sem privilégios escale seus privilégios no sistema, potencialmente comprometendo todo o sistema.[1] [2] Aqui está uma análise detalhada da pontuação CVSS: Pontuação Base: 8,4, indicando um risco de segurança significativo que exige atenção imediata. Pontuação de Impacto: 5,9, sugerindo danos potenciais substanciais se explorado. Os altos valores de confidencialidade, integridade e disponibilidade contribuem para essa pontuação. Pontuação de Exploração: 2,5, sugerindo exploração relativamente alta. O vetor de ataque local, a alta integridade , e a alta disponibilidade contribuem para essa pontuação.
A Tabela 1.1 e a Tabela 1.2 fornecem mais informações sobre essas pontuações e seus componentes.
| Gravidade CVSS v3.1 | Valor |
|---|---|
| Pontuação Base | 8.4 ALTA |
| Pontuação de Impacto | 5.9 |
| Pontuação de Exploração | 2.5 |
Tabela 1.1 Pontuações de Gravidade CVSS[1]
| Métricas CVSS v3.1 | Valor |
|---|---|
| Vetor de Ataque (AV) | Local |
| Privilégios Necessários (PR) | Nenhum |
| Interação do Usuário (UI) | Nenhum |
| Confidencialidade (C) | Alta |
| Integridade (I) | Alta |
| Disponibilidade (A) | Alta |
Tabela 1.2 Vetor CVSS[1]
Existem dois tipos de inteiros em computadores modernos, com sinal e sem sinal. A representação de números com sinal geralmente envolve uma operação chamada complemento de dois.[4] “O complemento de dois usa o dígito binário com o maior valor posicional como sinal para indicar se o número binário é positivo ou negativo”[4]
A introdução do complemento de dois converte o cálculo da subtração em adição, simplificando assim o projeto e a implementação da CPU. A geração do complemento de dois de um inteiro envolve três etapas:[4]
A Fig 2.1.1.1 mostra o processo de conversão em um diagrama com um exemplo real de conversão de “-6” para o formato de complemento de dois.
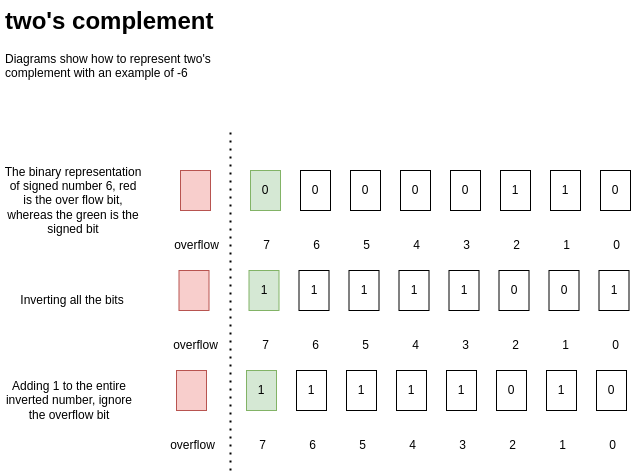
Fig 2.1.1.2 Adição Usando o Complemento de Dois
A Figura 2.1.1.2 mostra o processo de adicionar o complemento de dois de '-6' a '+6'. Isso demonstra como o uso do complemento de dois permite que a adição seja usada como substituto da subtração.
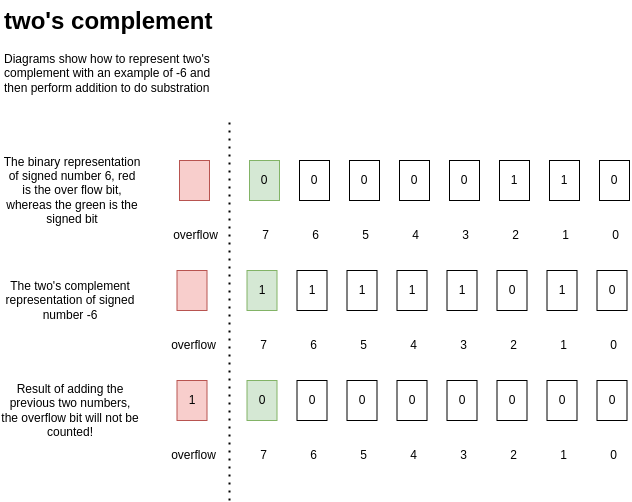
Fig 2.1.1.2 Adição Usando o Complemento de Dois
Da Seção 2.1.1, já entendemos o que é o complemento de dois. Agora, vamos examinar o cenário de underflow de número sem sinal em computadores. Em computadores modernos, ao usar números sem sinal, o bit mais significativo não é tratado como um bit de sinal; em vez disso, ele faz parte do próprio número sem sinal. Essa situação significa que, ao realizar subtração com um número sem sinal, devemos ter cautela, pois isso pode levar a uma condição conhecida como underflow de número sem sinal.[5]
A Fig 2.1.2.1 ilustra a situação de subtrair 6 de 5 em um número sem sinal de 8 bits. O resultado final é 255, pois o número sem sinal dá a volta (wrap-around). Quando esse underflow ocorre em uma instrução condicional, ele tem o potencial de interromper a funcionalidade da instrução.
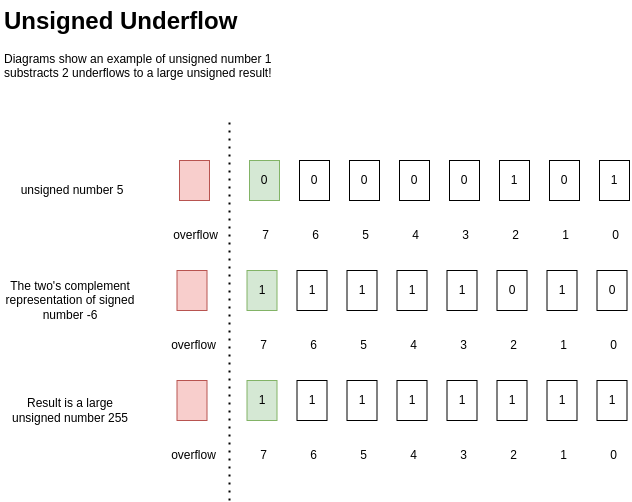
Fig 2.1.2.1 Underflow de Número sem Sinal
No kernel Linux, o Alocador Slab é um mecanismo de gerenciamento de memória usado para alocação e desalocação eficientes de pequenos blocos de memória. Ele proporciona desempenho mantendo vários caches de Slabs, cada um contendo blocos de memória de tamanho fixo. Normalmente, o kmalloc-32 aloca 32 bytes de memória, sendo um slab kmalloc-32, enquanto o kmalloc-4k aloca 4096 bytes de memória, sendo um slab kmalloc-4k.[6]
Além disso, a alocação de slabs no kernel Linux normalmente envolve alocar memória de um espaço de endereço contíguo dentro da região de memória heap do kernel. Esse endereço contíguo é gerenciado pelo kernel e é usado para alocar memória para vários objetos e estruturas de dados do kernel. A Fig 2.2.1.1 mostra o layout dos slabs na memória do kernel LInux.
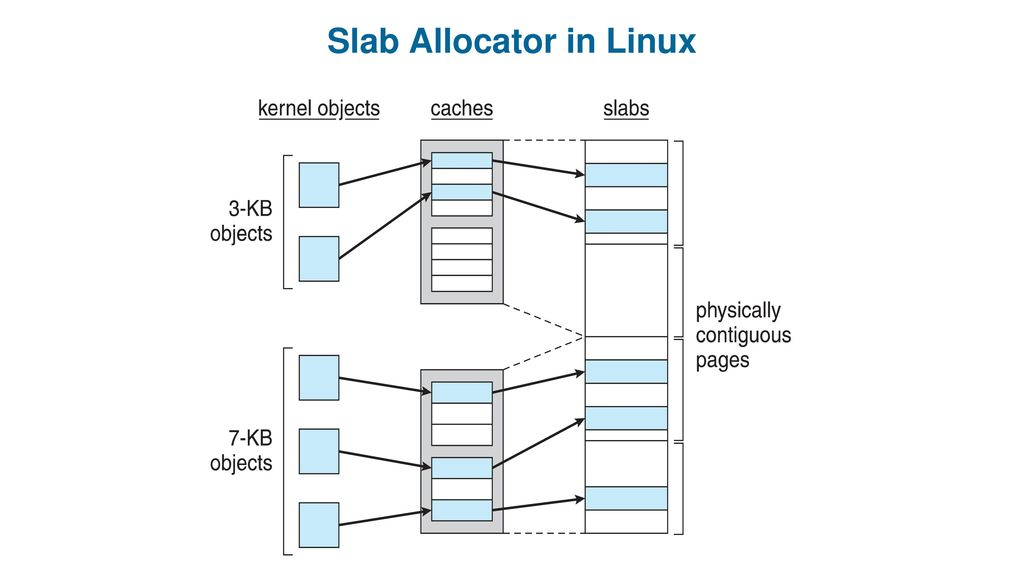
Fig 2.2.1.1 Alocador Slab no Linux [7] (O autor desta figura é https://leviathan.vip/)
Se você quiser reproduzir o processo com um kernel linux compilado por conta própria, leia os seguintes arquivos markdown para obter as informações de contexto:
Nota:
Todos os arquivos markdown, bem como o código e os scripts, estão em diferentes pastas deste repositório; cada pasta vem com seu próprio arquivo markdown. Leia-o antes de tentar fazer qualquer coisa!
