 davidcoles/vc5
Um balanceador de carga de camada 4 com Direct Server Return, horizontalmente escalável, para Linux usando XDP/eBPF

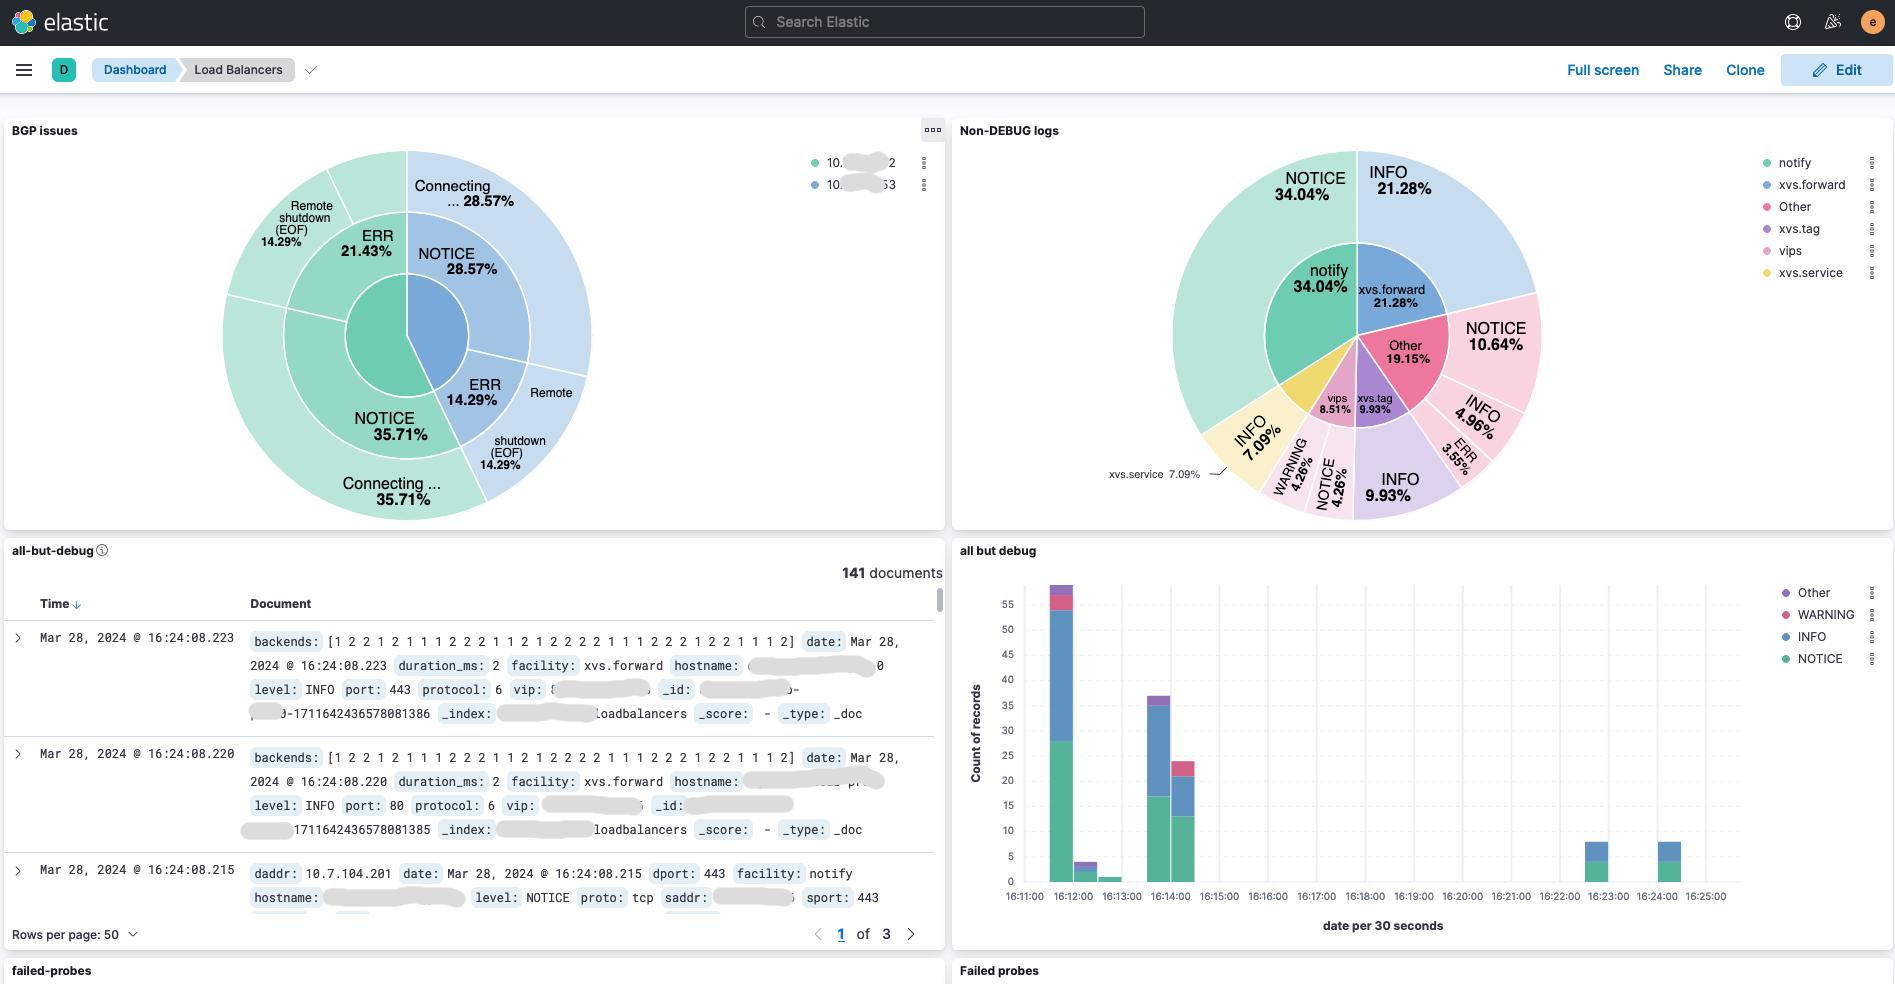
# VC5 <picture> <img src="https://assets.kitploit.com/production/public/readmes/9322/203eb45ff2205aa56eaf10f0d0ea7be21a35972366b34252c91fc6e78a40818c.png" width="25%"> </picture> **Este README está atualmente a ser atualizado para refletir alterações recentes - algumas informações podem não refletir o código atual. Esta iteração do código ainda não está pronta para batalha - utilize uma versão v0.2 para produção** Um balanceador de carga de camada 4 (L4LB) Direct Server Return ([DSR](https://www.loadbalancer.org/blog/direct-server-return-is-simply-awesome-and-heres-why/)) horizontalmente escalável para Linux usando [XDP/eBPF](https://www.datadoghq.com/blog/xdp-intro/). Se acha que isto pode ser útil ou tiver alguma questão/sugestão, sinta-se à vontade para contactar-me em [email protected] ou abra um issue no GitHub. **Agora suporta IPv6 e distribuição na camada 3 (também conhecida como tunnelling)**! A biblioteca XVS foi atualizada para incluir estas funcionalidades, eliminando também a necessidade de executar health checks a partir de um network namespace, simplificando consideravelmente o código. Isto porá fim ao requisito de que todos os backends partilhem uma VLAN com o balanceador de carga. As restrições atuais do código significam que ativar tunnelling numa base por serviço não é suportado. Usar a opção `-tunnel` permite que o tunnelling de camada 3 seja ativado globalmente usando um único esquema (IP-in-IP, GRE, FOU ou GUE). No futuro, o código será atualizado para permitir que o tunnelling seja configurado ao nível do serviço. O balanceamento de carga na camada 2 continuará a ser suportado - a principal razão para iniciar o projeto foi a falta de suporte para a camada 2 suporte pelo [Katran do Facebook](https://github.com/facebookincubator/katran) balanceador de carga. É incluído um [ficheiro de configuração de exemplo IPv6/L3](https://github.com/davidcoles/vc5/blob/main/doc/ipv6-l3.yaml) - documentação mais completa seguirá. ## Sobre O VC5 é um balanceador de carga de rede concebido para funcionar como substituto de appliances de hardware legados. Permite que serviços com endereços IP virtuais (VIPs) sejam distribuídos por conjuntos de servidores backend ("reais"). Os servidores reais podem executar os próprios serviços ou atuar como proxies para outra camada de servidores (ex.: HAProxy a servir como roteador de camada 7 HTTP/offload SSL quando decisões ao nível da aplicação precisam de ser tomadas). O único requisito é que os VIPs precisam de ser configurados num dispositivo loopback em cada servidor real, ex.: `ip addr add 192.168.101.1/32 dev lo` Os serviços e servidores reais são especificados num ficheiro de configuração, juntamente com definições de health checks. Quando os servidores backend passam nos checks e há disponibilidade suficiente para fornecer um serviço, os endereços IP virtuais são anunciados aos routers via BGP. A distribuição de tráfego nas camadas 2 e 3 é agora suportada. A distribuição na camada 2 requer que os servidores reais partilhem uma VLAN com o balanceador de carga; ao receber um pacote a ser distribuído, o balanceador de carga atualiza os endereços de hardware ethernet no pacote para usar o endereço MAC do servidor real como destino e o seu próprio endereço MAC como origem, e encaminha o pacote através da interface apropriada, atualizando o ID da VLAN 802.1Q se os pacotes tiverem tags VLAN. A distribuição na camada 3 requer que os pacotes sejam encapsulados num protocolo de tunneling endereçado ao IP do servidor real e encaminhados através de um router (a menos que o servidor e o balanceador de carga partilhem uma VLAN). Se, quando encapsulado, um pacote exceder o tamanho máximo de transmissão da rede então uma mensagem ICMP é enviada à origem com indicação do MTU apropriado a utilizar. Os servidores backend apenas precisam de desencapsular pacotes - tunneling bidirecional com balanceadores de carga não é necessário. Um servidor com uma interface de rede de 10Gbit/s deverá ser capaz de suportar um serviço HTTP com largura de banda de saída superior a 100Gbit/s devido à natureza assimétrica da maior parte do tráfego de Internet. Para serviços mais pequenos, uma ou duas máquinas virtuais modestas provavelmente suportarão um serviço que gera vários gigabits/s de tráfego de saída. Se uma instância não for suficiente, então podem ser adicionados mais servidores para escalar horizontalmente a capacidade (e fornecer redundância) usando a funcionalidade ECMP do seu router. Interfaces bonded 802.3ad e VLAN trunking 802.1Q são suportados (ver diretório [examples/](https://github.com/davidcoles/vc5/blob/main/examples)). Não são necessários módulos de kernel ou configurações complexas, embora para o melhor desempenho seja recomendado um driver de placa de rede com suporte para modo nativo XDP (ex.: mlx4, mlx5, i40e, ixgbe, ixgbevf, nfp, bnxt, thunder, dpaa2, qede). Uma lista completa está disponível na [página de suporte de drivers do Projeto XDP](https://github.com/xdp-project/xdp-project/blob/master/areas/drivers/README.org). ## Objetivos/estado * ✅ Implementação simples com um único binário * ✅ Seleção estável de backend com o algoritmo de hashing Maglev * ✅ Injeção de rotas de saúde tratada automaticamente; não é necessário executar outro software como ExaBGP * ✅ Minimamente invasivo; não requer qualquer modificação das regras de iptables no balanceador * ✅ Sem modificação dos servidores backend para além de adicionar o VIP a um dispositivo loopback/terminação de túnel com distribuição L3 * ✅ Os health checks são executados contra o VIP nos servidores backend, não contra os seus endereços reais * ✅ Health checks HTTP/HTTPS, sonda SYN half-open e DNS UDP/TCP incorporados * ✅ Comutação de pacotes no kernel com eBPF/XDP; drivers em modo nativo evitam a alocação de sk_buff * ✅ Suporte para múltiplas VLANs * ✅ Suporte para múltiplas NICs para aplicações de menor largura de banda/desenvolvimento * ✅ Dispositivos de rede com tags/bonding para suportar alta disponibilidade/alta largura de banda * ✅ Observabilidade via consola web, registo Elasticsearch (em desenvolvimento) e métricas Prometheus * ✅ Suporte IPv6 e capacidade de misturar backends IPv4 e IPv6 com qualquer tipo de VIP. * ✅ Distribuição de tráfego na camada 3 com suporte IP-in-IP, GRE, FOU e GUE. ## Início rápido Para melhores resultados, deve desativar/desinstalar o irqbalance. Terá de selecionar um IP principal para passar ao balanceador. Este é usado para o BGP router ID. Um exemplo simples num servidor com uma única interface ethernet sem tags: * `apt-get install git make libelf-dev golang-1.20 libyaml-perl libjson-perl ethtool` (ou o equivalente da sua distribuição) * `ln -s /usr/lib/go-1.20/bin/go /usr/local/bin/go` (garanta que o binário Go está no seu PATH) * `git clone https://github.com/davidcoles/vc5.git` * `cd vc5/cmd` * `cp config.sample.yaml config.yaml` (edite config.yaml de acordo com os seus requisitos) * `make` (descarrega a biblioteca [libbpf](https://github.com/libbpf/libbpf), compila o binário e o ficheiro de configuração JSON) * `./vc5 10.1.10.100 config.json eth0` (ajuste para usar o endereço IP e a interface ethernet do seu servidor) * Uma consola web estará na porta 80 do seu servidor balanceador de carga por predefinição * Adicione o seu VIP ao dispositivo loopback nos seus servidores backend (ex.: `ip addr add 192.168.101.1/32 dev lo`) * Configure a sua rede/cliente para enviar tráfego para o seu VIP ao balanceador de carga, seja via BGP (ver ficheiro de configuração) ou roteamento estático É quase de certeza mais fácil usar o binário da mais recente release do Github (compilado para x86-64). Este terá sido testado em produção, pelo que deverá ser fiável. Garanta que a sua configuração é compatível com esta versão usando o script config.pl da release etiquetada (ou, claro, pode construir o seu próprio ficheiro de configuração JSON como preferir). Se atualizar o ficheiro de configuração YAML e regenerar o JSON (`make config.json`), pode recarregar a nova configuração enviando um SIGINT (Ctrl-C) ou SIGUSR2 ao processo. SIGQUIT (Ctrl-\\) ou SIGTERM farão com que o processo encerre graciosamente as ligações BGP e termine. Um exemplo mais complexo com um dispositivo ethernet bonded LACP constituído por duas interfaces (Intel X520 10Gbps no meu servidor de teste), com modo de driver XDP nativo ativado e VLANs com tags: Entrada `vlans` do `config.yaml`: ``` vlans: 10: 10.1.10.0/24 20: 10.1.20.0/24 30: 10.1.30.0/24 ``` Linha de comandos: `./vc5 -n 10.1.10.100 config.json enp130s0f0 enp130s0f1` O binário detetará as suas interfaces VLAN procurando dispositivos com endereços IP contidos nos prefixos VLAN no ficheiro de configuração. Se usar interfaces físicas separadas sem tags, isto deverá agora funcionar de forma transparente sem qualquer configuração extra, basta listar todas as interfaces na linha de comandos para que o código eBPF seja carregado em cada uma delas. Como o estado das ligações é monitorizado por núcleo (BPF_MAP_TYPE_LRU_PERCPU_HASH), deve garantir que o RSS ([Receive Side Scaling](https://www.kernel.org/doc/Documentation/networking/scaling.txt)) encaminhará consistentemente os pacotes de um fluxo para o mesmo núcleo de CPU no caso de o seu switch selecionar uma interface diferente quando a topologia LACP mudar. Desative o irqbalance, garanta que as definições de canais são as mesmas em cada interface (ethtool -l/-L) e que a indireção do hash de fluxo RSS corresponde (ethtool -x/-X). A configuração pode ser testada iniciando uma ligação de longa duração (ex.: usando iperf com a opção -t) para um conjunto de servidores backend e depois [desativando o backend escolhido com um asterisco após o endereço IP no ficheiro de configuração](https://github.com/davidcoles/vc5/blob/main/doc/servers.md), determinando qual a interface que está a receber o fluxo no balanceador de carga (ex., `watch -d 'cat /proc/interrupts | grep enp130s0f'` e procure o contador de IRQ a aumentar rapidamente) e depois retirando esta interface do LACP (`ifenslave -d bond0 enp130s0f0`). Deverá ver o fluxo mover-se para a outra interface de rede mas continuar a chegar ao mesmo núcleo. Ao usar backends em múltiplas sub-redes, para o melhor desempenho deve garantir que todas as VLANs têm tags numa única interface de trunk (bonded LACP se tiver mais do que uma interface física) com os mapeamentos sub-rede/ID VLAN especificados na secção `vlans` do ficheiro de configuração. Se isto não for possível (por exemplo, criar interfaces trunk no vSphere não é simples), então pode atribuir cada sub-rede a uma interface diferente sem tags: `./vc5 10.1.10.100 config.json eth0 eth1 eth2` ## Antecedentes/mais informação Um bom resumo dos conceitos utilizados é discutido na [palestra de Patrick Shuff, "Building a Billion User Load Balancer" palestra](https://www.youtube.com/watch?v=bxhYNfFeVF4&t=1060s) e na [palestra de Nitika Shirokov, Katran](https://www.youtube.com/watch?v=da9Qw7v5qLM) Estão incluídos uma consola web básica e um servidor de métricas Prometheus: 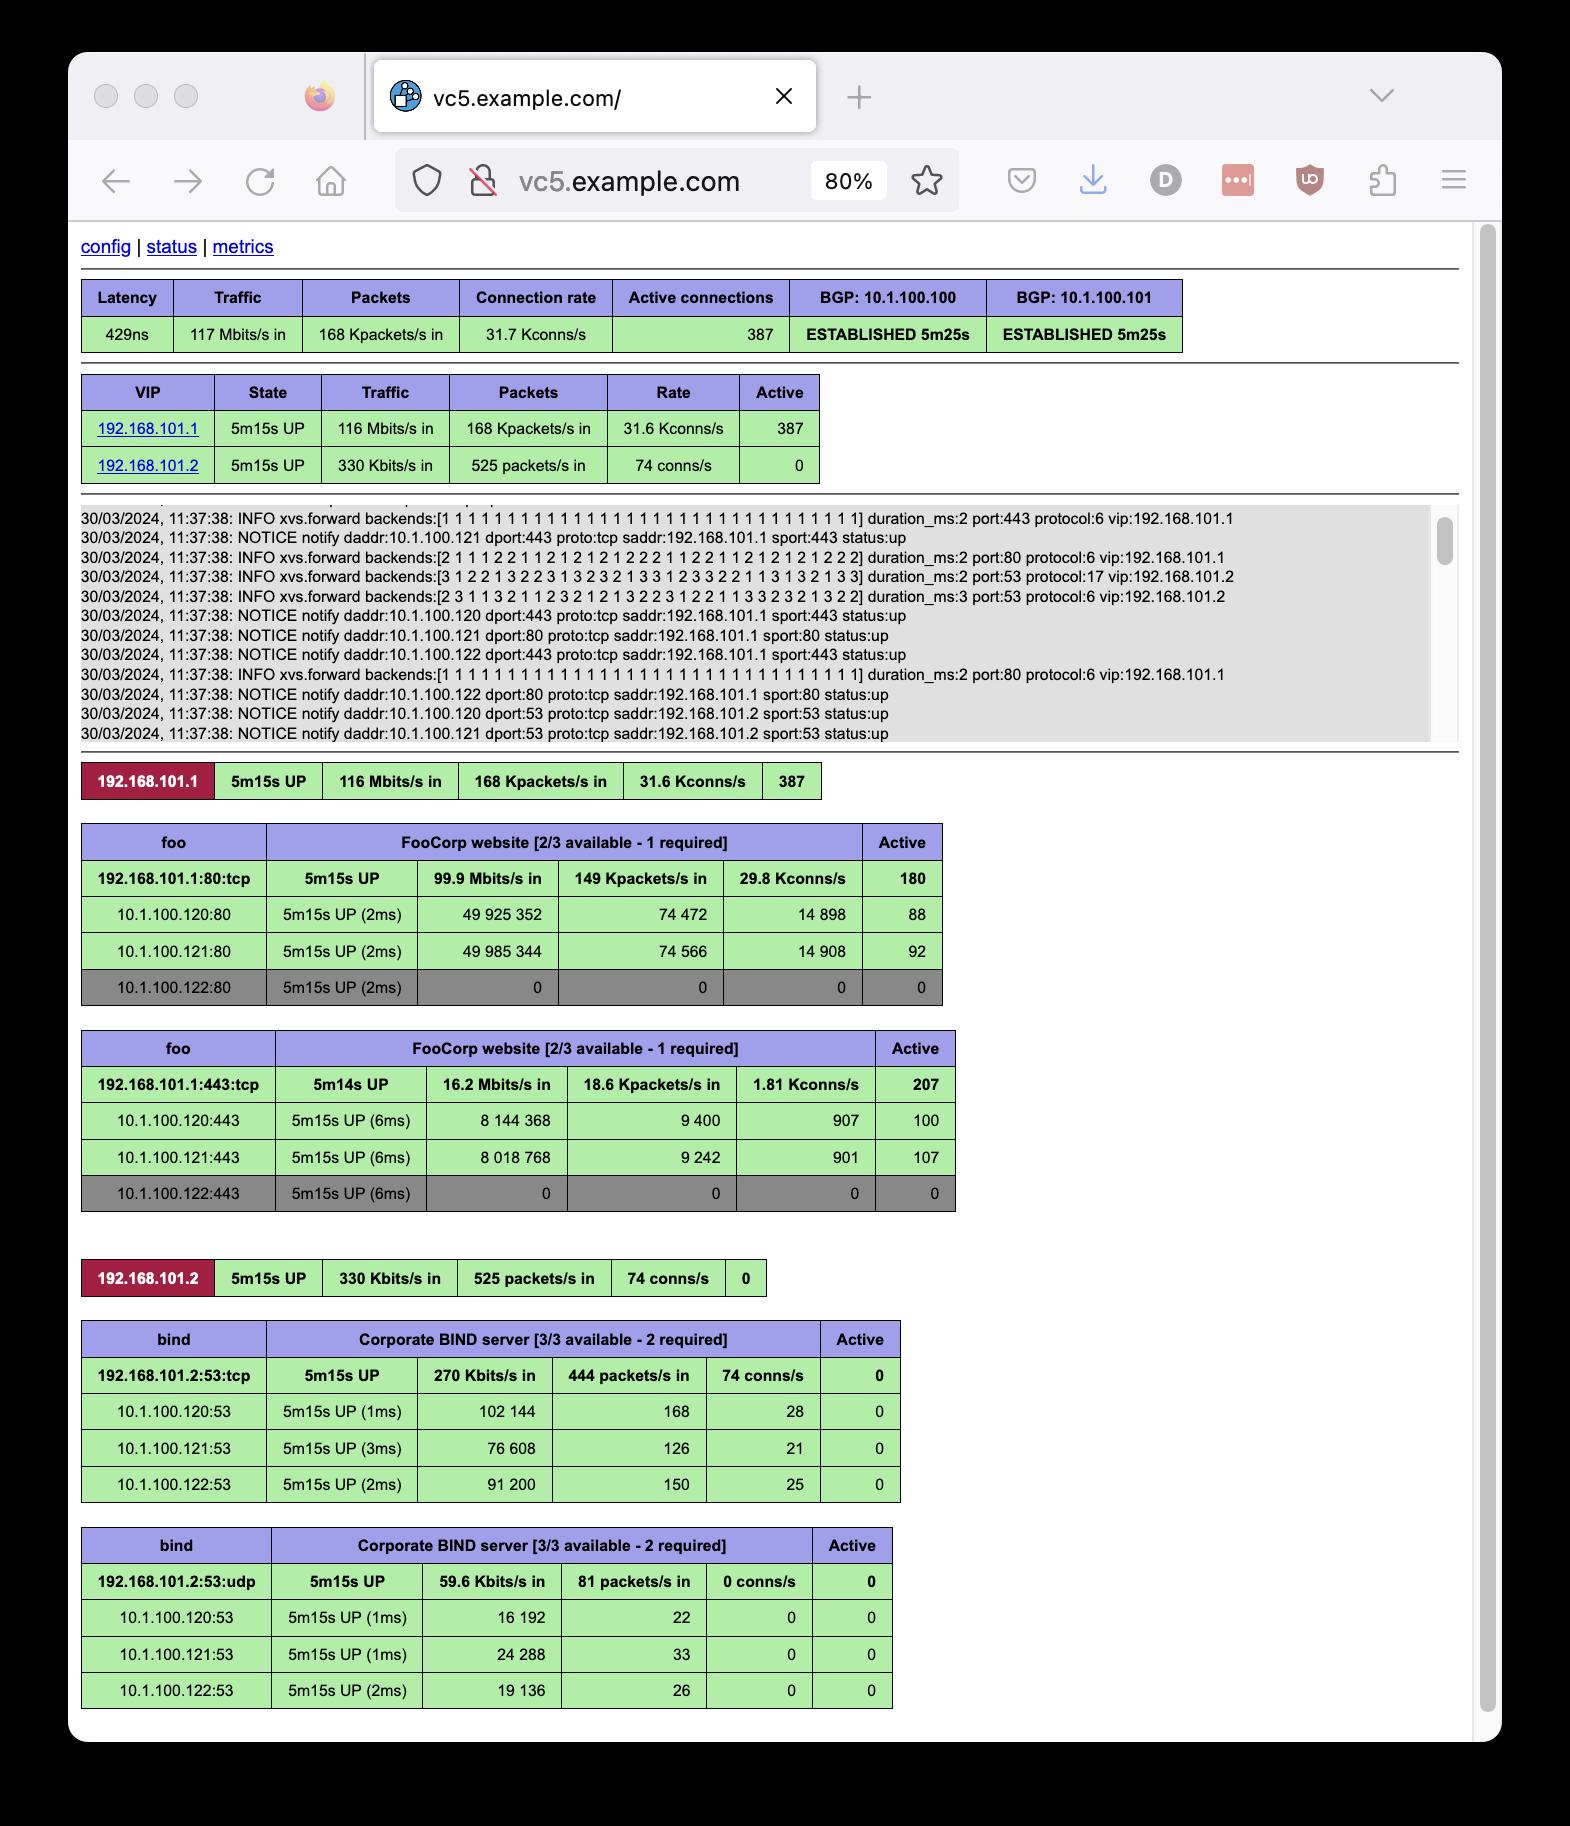 O suporte experimental Elasticsearch para registo (diretamente para o seu cluster, sem necessidade de extrair logs do sistema) está agora incluído. Cada sonda aos servidores backend é registada, por isso se um cair pode ver exatamente qual o erro devolvido, bem como todos os outros tipos de condições. Isto exigirá muita refinação e nomes mais sensatos para os parâmetros de registo, etc. (se tiver alguma perceção, entre em contacto), mas deverá permitir obter boas perceções sobre o que se passa com o sistema - a minha primeira tentativa muito inábil de criar um dashboard Kibana como exemplo: 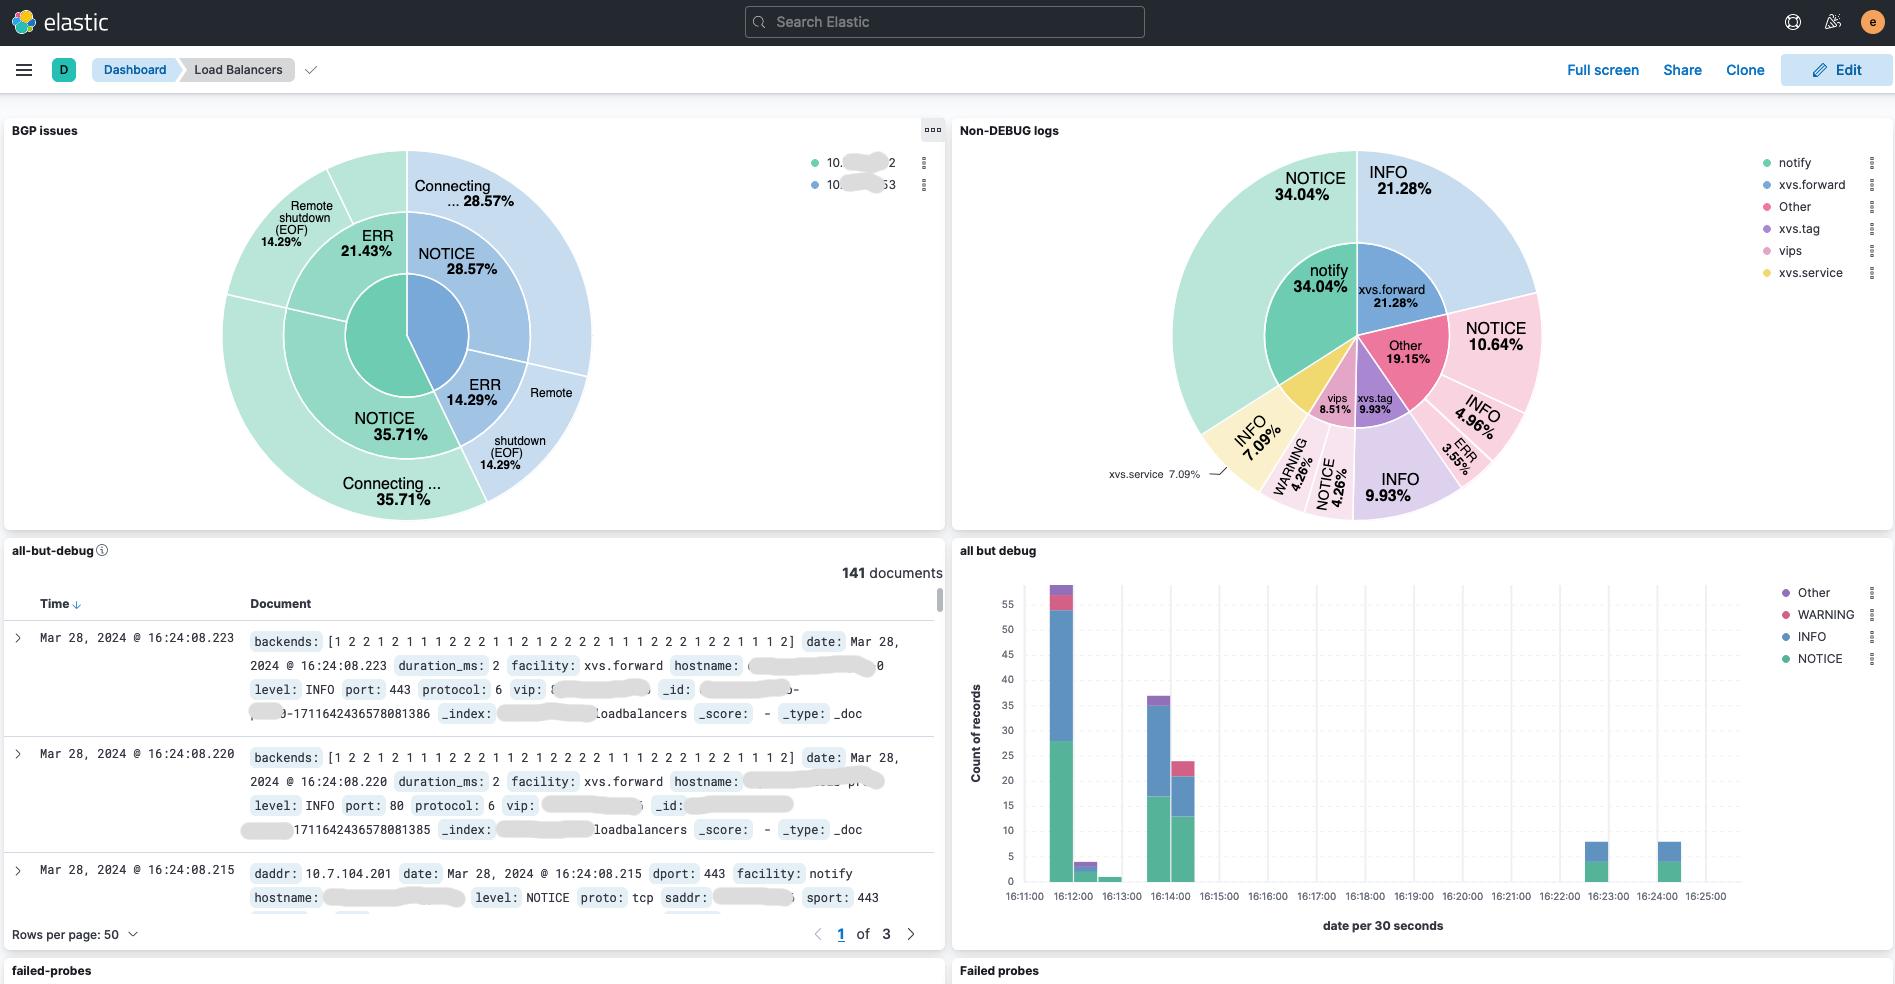 ## Desempenho Isto foi maioritariamente testado com servidores backend Icecast com clientes a receber uma mistura de streams de baixo e alto bitrate (48kbps - 192kbps). Parece que uma instância convidada VMWare (4 núcleos, 8GB) usando o driver XDP genérico suportará 100K clientes concorrentes, 380Mbps/700Kpps através do balanceador de carga e 8Gbps de tráfego dos backends diretamente para os clientes. Num único CPU Intel Xeon Gold 6314U (2.30GHz, 32 núcleos físicos, com hyperthreading ativado para 64 núcleos lógicos) e uma placa de rede Intel 10G 4P X710-T4L-t, consegui executar 700K streams a 2Gbps/3.8Mpps de tráfego de entrada e 46.5Gbps de saída. O servidor estava mais de 90% idle. Infelizmente não tinha os recursos disponíveis para criar mais clientes/servidores. ## Operação Existem três modos de operação: simples, VLAN e multi-NIC. No modo simples, todos os anfitriões devem estar na mesma sub-rede que o endereço principal do balanceador de carga. No modo VLAN (ativado ao declarar entradas na secção "vlans" do ficheiro de configuração YAML/JSON), as entradas de servidor devem corresponder a uma entrada de sub-rede VLAN/CIDR. As interfaces com tags VLAN precisam de ser criadas no SO e ter um endereço IP atribuído dentro da sub-rede. No modo multi-NIC, as sub-redes recebem IDs da mesma forma que as VLANs, mas bpf_redirect() é usado para enviar tráfego através da interface configurada apropriadamente (em vez de alterar o ID da VLAN e usar XDP_TX). No modo VLAN, todo o tráfego para o balanceador de carga precisa de estar numa VLAN com tags (não é feito push ou pop de 802.1Q - ainda).
