 comerc/cve-2025-68664
Divulgação detalhada do CVE-2025-68664, uma vulnerabilidade crítica de desserialização no LangChain core permitindo exfiltração de segredos e potencial RCE por meio de prompts elaborados e fluxos de serialização.

Autor: Yarden Porat
Pesquisa da Cyata: Vulnerabilidade LangGrinch no LangChain
Publicado em: https://cyata.ai/blog/langgrinch-langchain-core-cve-2025-68664/
Ontem o LangChain publicou um alerta crítico sobre uma vulnerabilidade que descobri no langchain-core: CVE-2025-68664 / GHSA-c67j-w6g6-q2cm.
No início deste ano, minha pesquisa foi focada em invadir gerenciadores de segredos no nosso trabalho "Vault Fault" – sistemas projetados especificamente como uma fronteira de segurança em torno das suas credenciais mais sensíveis. Uma conclusão se repetiu várias vezes: quando a plataforma trata acidentalmente dados moldados por um atacante como estrutura confiável, essa fronteira desmorona rapidamente. Desta vez, o sistema que "quebra" não é o seu gerenciador de segredos. É a estrutura de agentes que pode usá-los.
Por que essa vulnerabilidade merece atenção especial:
Está no núcleo. Não é um erro de uma ferramenta específica, nem um caso extremo de integração, nem "algum pacote da comunidade fez algo estranho." As APIs vulneráveis (dumps() / dumpd()) estão no próprio langchain-core.
O raio de impacto é enorme. Pelo volume de downloads, langchain é um dos componentes de estruturas de IA mais amplamente implantados no mundo hoje. No final de dezembro de 2025, a telemetria pública de pacotes mostra centenas de milhões de instalações, com o pepy.tech relatando ~847 milhões de downloads totais e o pypistats mostrando ~98 milhões de downloads no último mês.
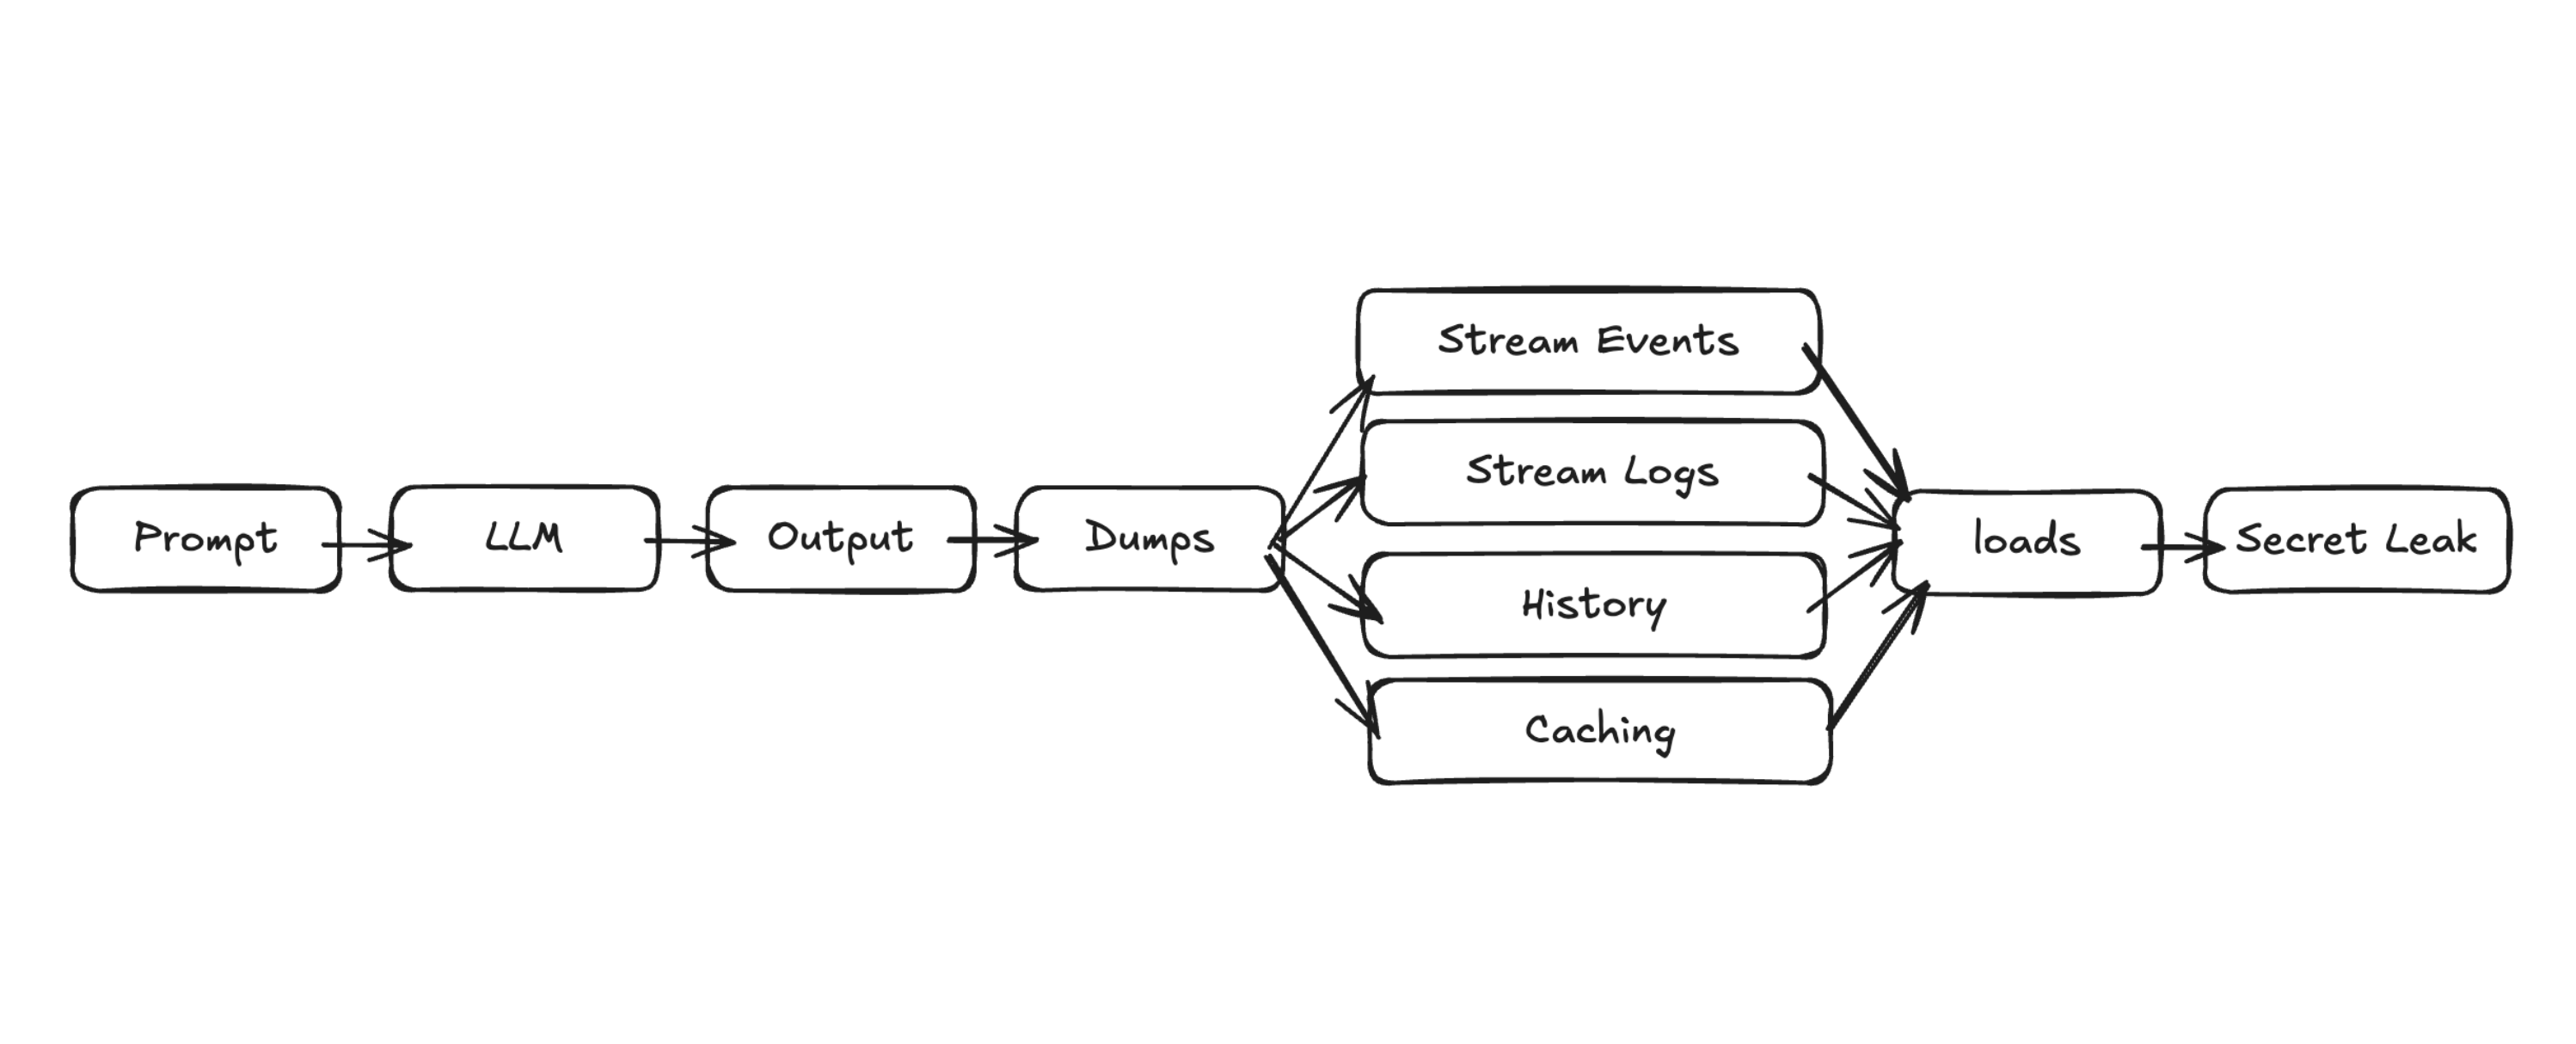
Um único prompt pode disparar muitos mecanismos. O caminho real mais comum aqui não é "o atacante envia um blob serializado e você chama load()." É mais sutil: as saídas do LLM podem influenciar campos como additional_kwargs ou response_metadata, e esses campos podem ser serializados e depois desserializados por meio de funções comuns da estrutura, como streaming de logs/eventos. Em palavras simples, isso significa que o exploit pode ser acionado por um único prompt de texto, que cascateia em um pipeline interno surpreendentemente complexo.
Antes de continuar lendo: os patches já foram lançados nas versões 1.2.5 e 0.3.81. Se você usa LangChain em produção, isso é mais complicado do que parece; atualize o quanto antes.
O LangChain usa um formato de serialização interno especial, onde dicionários contendo o marcador 'lc' representam objetos LangChain. A vulnerabilidade era que dumps() e dumpd() não escapavam corretamente dicionários controlados pelo usuário que acidentalmente incluíam a chave reservada 'lc'.
Assim, assim que um atacante consegue fazer o loop de orquestração do LangChain serializar e posteriormente desserializar conteúdo incluindo a chave 'lc', ele consegue instanciar um objeto arbitrário inseguro, potencialmente acionando vários caminhos favoráveis ao atacante.
O alerta lista 12 fluxos vulneráveis diferentes, extremamente comuns em casos de uso reais, como streaming padrão de eventos, logging, histórico de mensagens/memória ou cache:
As consequências mais devastadoras incluem:
Extração de segredos de variáveis de ambiente. O alerta observa que isso ocorre na desserialização com secrets_from_env=True. Notavelmente, isso era o padrão até ontem. 🙂
Instanciação de objetos em namespaces pré-aprovados (incluindo langchain_core, langchain_openai, langchain_aws, langchain_anthropic…), potencialmente causando efeitos colaterais nos construtores (chamadas de rede, operações com arquivos etc.).
Sob certas condições, a instanciação de objetos LangChain pode levar à execução arbitrária de código.
Isso é classificado sob CWE-502: Desserialização de dados não confiáveis, com pontuação CVSS CNA de 9.3 (Crítica).
Na véspera de Natal, eu estava fazendo o trabalho mais antifestivo possível: olhando para o código de serialização e me perguntando "espera… por que isso é considerado confiável?"
Pesquisas de segurança muitas vezes parecem dramáticas por fora. Na realidade, isso geralmente é leitura cuidadosa, pequenas hipóteses e o acúmulo lento de momentos de "isso é estranho".
Isso começou como muitas coisas na Cyata: com uma pergunta simples que fazemos constantemente ao avaliar stacks de IA quanto a risco real:
Onde estão as fronteiras de confiança em aplicações de IA, e os desenvolvedores realmente sabem onde essas fronteiras estão?
LangChain é uma estrutura poderosa e, como a maioria das estruturas modernas, ela precisa movimentar dados estruturados complexos: mensagens, chamadas de ferramentas, eventos de streaming, traces, caches e "runnables".
Revisando pesquisas anteriores, já havia um estudo extenso sobre ferramentas e integrações do LangChain, mas muito poucas descobertas na biblioteca principal.
Comecei a pesquisa trabalhando de trás para frente. Encontrar lugares interessantes (sinks) e depois descobrir como um atacante poderia alcançá-los. A desserialização era um alvo óbvio.
Levei bastante tempo para encontrar algo significativo. Mas depois de um tempo, descobri que, assumindo um primitivo de desserialização controlado pelo atacante, eu poderia disparar um SSRF cego que poderia ser usado para exfiltrar variáveis de ambiente (detalhes em breve). Como o resultado era limitado à exfiltração de segredos, e não ao meu objetivo principal de RCE, continuei auditando a desserialização e fui com calma.
O bug não era um pedaço de código ruim; era a ausência de código. dumps() simplesmente não escapava dicionários controlados pelo usuário contendo chaves 'lc'. Escape ausente no caminho de serialização, não na desserialização.
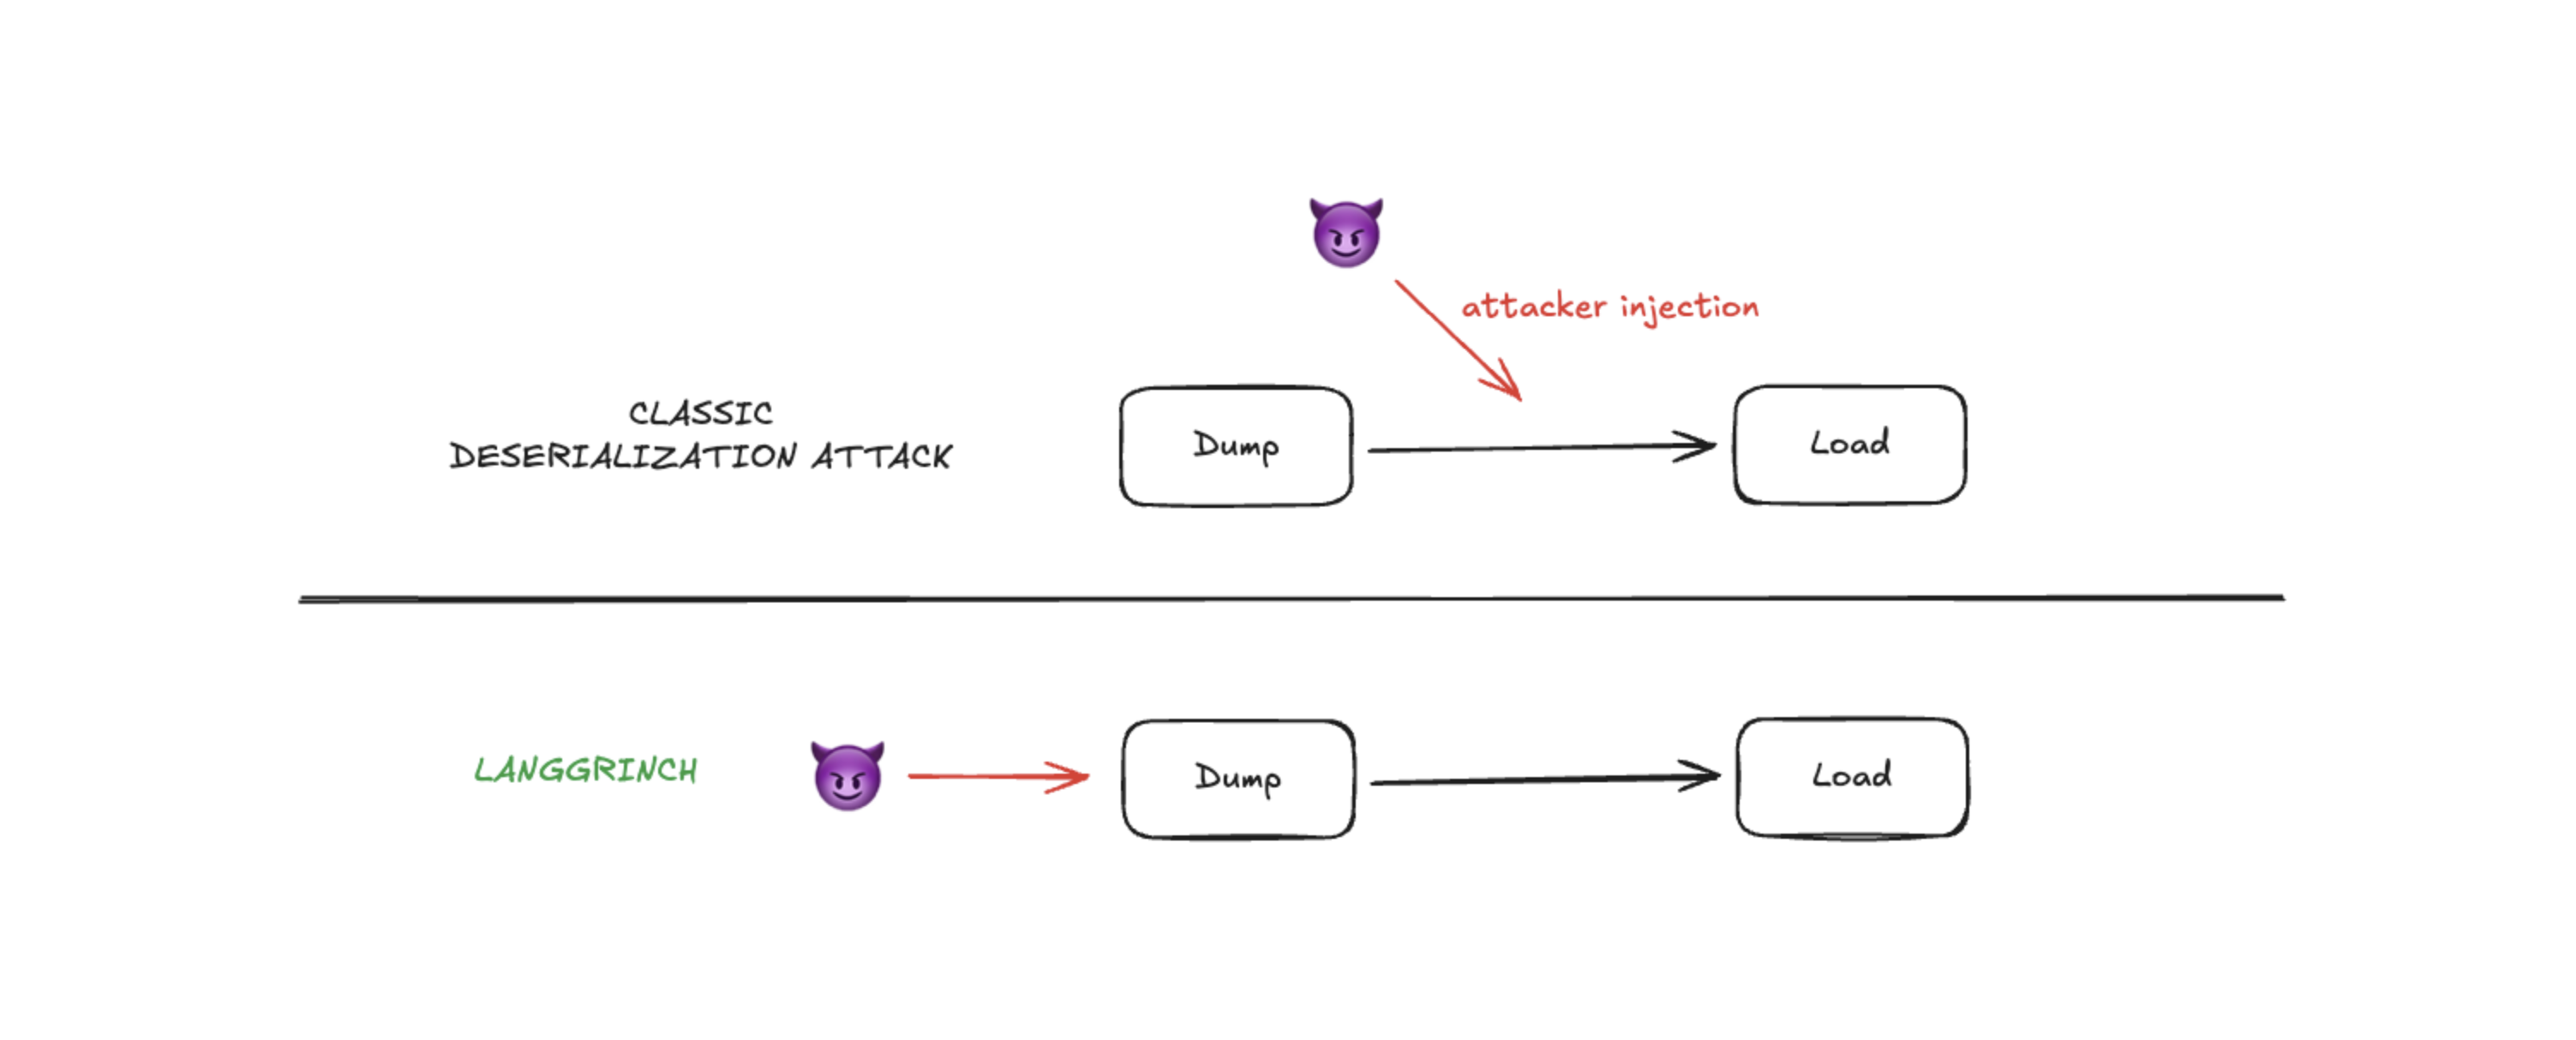
É muito mais fácil notar algo errado do que notar a ausência de algo, especialmente quando você audita load(), e não dumps(). Em uma das estruturas de IA mais rigorosamente revisadas. Por dois anos e meio.
A partir daí, a pesquisa se tornou um exercício estruturado:
Identificar onde conteúdo não confiável (principalmente dicionários arbitrários) entra na serialização (saídas de LLM, injeção de prompt, entrada do usuário, ferramentas externas, documentos extraídos).
Identificar quando esses dados serializados são desserializados.
Identificar o que um atacante pode alcançar com a instanciação arbitrária de objetos.
Naquele momento, a descoberta principal era suficientemente clara e acionável para um relatório responsável: havia uma lacuna de escape em dumps() / dumpd() em torno de dicionários com a chave 'lc'.
O alerta capturou posteriormente o que vemos frequentemente na prática: campos como additional_kwargs e response_metadata podem ser influenciados pela saída do LLM e por injeção de prompt, e esses campos podem ser serializados e desserializados em muitos fluxos.
Em crédito à equipe do LangChain: a resposta e as ações subsequentes foram decisivas, não apenas corrigindo o bug, mas também endurecendo padrões que eram permissivos demais para o mundo em que vivemos agora.
O projeto LangChain decidiu conceder uma recompensa de $4.000 USD por essa descoberta. De acordo com o huntr, a plataforma onde o LangChain conduzia seu programa de recompensas, esse seria o maior valor já concedido no projeto, com recompensas até então de até $125.
