 chenaotian/cve-2022-0492
Análise técnica detalhada e exploit funcional para CVE-2022-0492, escape de contêiner do kernel Linux via cgroup release_agent, com configuração de laboratório passo a passo e orientações de mitigação.

[toc]
ID da vulnerabilidade: CVE-2022-0492
Produto afetado: linux kernel - cgroup
Versões afetadas: ~linux kernel 5.17-rc3
Impacto: quando o contêiner não possui medidas de segurança adicionais ativadas, obter a permissão de root dentro do contêiner é suficiente para escapar para o host.
Basta usar o docker em um linux com kernel na versão vulnerável.
#关闭所有安全防护启动docker
docker run --rm -it -h cve --name cve --security-opt="seccomp=unconfined" --security-opt="apparmor=unconfined" ubuntu:20.04 /bin/bash
Neste artigo, o docker é usado como ambiente de teste.
O método de exploração desta vulnerabilidade já é um velho conhecido; no entanto, o ponto da vulnerabilidade está na falta de verificação de permissão ao modificar o release_agent do cgroup, o que reduz ainda mais a barreira para a exploração de escape (antes era necessária a capability CAP_SYS_ADMIN; com esta vulnerabilidade, não é necessário CAP_SYS_ADMIN). Veja abaixo, em "Condições de exploração", a diferença nos pré-requisitos.
Analisando o patch, a função cgroup_release_agent_write foi corrigida, adicionando autenticação. Ou seja, o release_agent do cgroup não pode mais ser modificado por usuários sem privilégios:
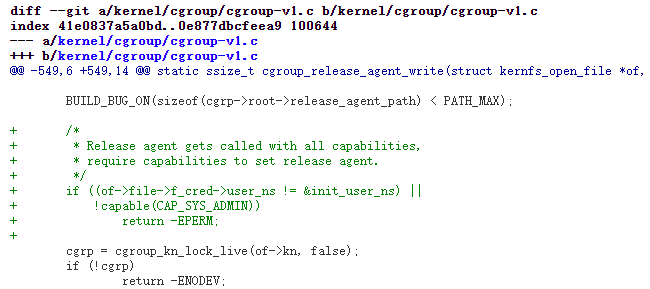
Portanto, confirma-se que esta vulnerabilidade é um controle de acesso quebrado.
O cgroup, ou Linux Control Group, é um recurso do kernel Linux usado para limitar, controlar e isolar recursos de um grupo de processos (como CPU, memória, entrada/saída de disco etc.).
O cgroup possui os seguintes subsistemas:
devices permissões de dispositivos no escopo do processocpuset aloca o número de CPUs e nós de memória que os processos podem usarcpu controla a ocupação da CPUcpuacct estatísticas de uso da CPU, como tempo de execução e tempo throttledfreezer pausa processos no Cgroupnet_cls usado com tc (traffic controller) para limitar a largura de banda de redenet_prio define a prioridade de tráfego de rede dos processoshuge_tlb limita o uso de HugeTLBperf_event permite que a ferramenta Perf faça medição de desempenho com base em grupos CgroupNo host, os cgroups estão todos em /sys/fs/cgroup; é possível ver os vários subsistemas de cgroup:

O subsistema de cgroup correspondente dentro do docker é um nó filho desse cgroup no host. Veja o memory cgroup dentro do docker:

O nó com o nome do contêiner no diretório docker do host é exatamente igual:

O cgroup é utilizado na forma de um sistema de arquivos. O cgroup é montado em um diretório com mount; ele interage conosco por meio do sistema de arquivos virtual VFS. As interfaces do cgroup são apresentadas como arquivos; basta operar os arquivos para definir parâmetros do cgroup.
mount -t cgroup -o memory cgroup /tmp/testcgroup

Um nó filho de cgroup pode ser criado criando um subdiretório no diretório: mkdir /tmp/testcgroup/x.
Cada subsistema do cgroup tem o parâmetro notify_on_release, do tipo Boolean, com valor 1 ou 0. Ele pode, respectivamente, ativar ou desativar o comando do agente de liberação. Se notify_on_release estiver habilitado (valor 1), quando o cgroup não contiver mais nenhuma tarefa (ou seja, quando o último processo do cgroup sair e o PID no arquivo tasks do cgroup estiver vazio), o kernel executará o conteúdo do arquivo especificado pelo parâmetro release_agent. O valor de notify_on_release é alterado modificando o arquivo notify_on_release.
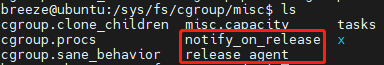
A vulnerabilidade está na modificação do release_agent. Originalmente, bastava poder operar o cgroup para modificar o release_agent, mas era necessário CAP_SYS_ADMIN para usar o cgroup. Mas depois os pesquisadores descobriram que criar um novo namespace com o comando unshare concede todas as capabilities; assim, a restrição do CAP_SYS_ADMIN deixa de existir, e a barreira para exploração caiu drasticamente.
O comando unshare tem a função de desfazer o compartilhamento dos namespaces especificados do processo pai compartilhado e, em seguida, executar o programa especificado no namespace recém-criado. O que é relevante para a nossa exploração é que o namespace recém-criado pelo unshare possui todas as capabilities, incluindo CAP_SYS_ADMIN.
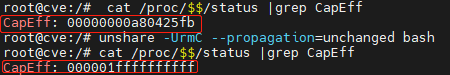
Esta exploração é a mesma do método tradicional de escape via CAP_SYS_ADMIN + cgroup release_agent, mas as condições de exploração diferem.
As condições de exploração diferem do escape tradicional via release_agent da seguinte forma:
release_agent tradicional: o contêiner precisa ter CAP_SYS_ADMIN e não ter apparmor e selinux ativados.
cve-2022-0492: contêiner sem proteções adicionais (mais especificamente, seccomp não desabilitando unshare, apparmor não ativando cgroup somente leitura e selinux desativado), com permissão de root dentro do contêiner. Não é necessário obter CAP_SYS_ADMIN.
Vale ressaltar que o apparmor do docker ativa cgroup somente leitura por padrão, e o seccomp do docker desabilita unshare sem a capability CAP_SYS_ADMIN por padrão. Já o k8s normalmente usa contêineres sem proteções por padrão. De qualquer forma, como a exploração é relativamente fácil, vale tentar no cenário específico.
Após a correção: de acordo com o código do patch:
Para modificar o arquivo release_agent, duas condições são necessárias:
Portanto, após a correção, a capability CAP_SYS_ADMIN obtida via unshare não pode mais modificar o release_agent, pois o novo namespace criado por unshare não é o namespace raiz. Mas se o contêiner já tiver CAP_SYS_ADMIN, ainda é possível continuar usando essa técnica para escapar.
Se o docker for iniciado com o parâmetro --cap-add=SYS_ADMIN ou --privileged (contêiner privilegiado), ele terá a capability CAP_SYS_ADMIN, sem precisarmos obtê-la; por exemplo, com o seguinte comando de inicialização:
#带有sys_admin 启动docker, 关闭apparmor(否则无法mount)
docker run --rm -it --cap-add=SYS_ADMIN --security-opt="apparmor=unconfined" ubuntu:20.04 /bin/bash
Docker com CAP_SYS_ADMIN pode ir direto para o próximo passo, "modificar o release_agent". O comando para iniciar um docker sem CAP_SYS_ADMIN e reproduzir a vulnerabilidade é:
