 aloshdenny/claude-awm
Contorna marcas d'água de texto de LLM injetando seletores de variação Unicode; inclui o gerador SynthID, detector mean-g, defesas de normalização e experimentos de entropia.

Sim, mas apenas uma família de ataques funciona, e não é a que todos presumem.
Os seletores de variação Unicode (categoria Mn, U+FE00 a U+FE0F e U+E0100 a U+E01EF) levam o detector abaixo do limiar e permanecem lá. Todos os outros ataques com caracteres invisíveis que testei são totalmente revertidos por uma linha de normalização de entrada. Os seletores de variação não são, porque são codepoints significativos (apresentação de emoji, variantes CJK) que o NFKC não vai — e não deveria — eliminar.
Replicado entre modelos e domínios:
| modelo | domínio | z de linha de base | após vs16_30 | taxa de edição |
|---|---|---|---|---|
| gpt-oss-20b | prosa | 45,03 | 0,72 | 57% |
| gpt-oss-20b | código | 37,24 | 0,68 | 58% |
| Qwen3.8-27B | prosa | 35,50 | -0,67 | 57% |
O limiar é z = 2,33. Todos os três ficam abaixo dele após o ataque, e permanecem abaixo após a normalização (0,09, 0,45, -0,78 respectivamente). O texto é renderizado de forma idêntica para um leitor humano.
A segunda descoberta real não precisa de ataque algum: texto de baixa entropia quase não é marcado desde o início. Com o thinking desativado, a saída de código puro do Qwen3.8-27B pontua z = 4,31 sem ataque, próximo do limiar de 2,33 sem nada feito a ele. Reative o thinking e o mesmo modelo, mesmo domínio, mesmo comprimento atinge z = 25,53, porque o preâmbulo de raciocínio é prosa comum e carrega a marca normalmente.
Tudo neste repositório foi medido nestes modelos, e em nenhum outro:
| modelo | parâmetros | onde | o que foi executado |
|---|---|---|---|
| Qwen3.5-0.8B | 0,8B | Mac (MPS) | escada completa de ataques, 1k-8k |
| Qwen3.5-4B | 4B | Mac / 4090 | escada completa de ataques + o experimento de entropia + estego bruto/normalizado |
| DeepSeek-R1-Distill-Qwen-14B | 14B | Mac (MLX, 4-bit) | marca d'água + detecção, traços de raciocínio |
| gpt-oss-20b | 20B | 3090 / 4090 / RunPod | escada completa de ataques até 32k, prosa + código, seletores de variação, lei de escala da taxa de inserção até 131k |
| Qwen3.8-27B | 27B | RunPod H100 / Modal H100 | prosa + código, seletores de variação, contraste do modo thinking |
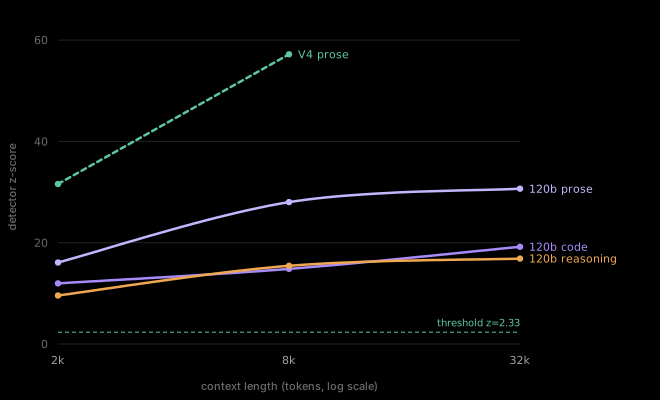
| gpt-oss-120b | 120B | Modal H100 (MXFP4) / RunPod H100 | prosa + código + raciocínio em 2k / 8k / 32k, escala parcial da taxa de inserção até 65k |
| DeepSeek-V4-Flash | 284B MoE | RunPod 2x H200 (FP8) | prosa + código em 2k / 8k |
Nem todo experimento foi executado em todo modelo, e as tabelas abaixo indicam o que foi executado onde. Modelos maiores foram adicionados à medida que as questões interessantes se estreitavam, então a escada de ataques é ampla nos modelos pequenos e o trabalho de comprimento e domínio está concentrado nos grandes.
A Anthropic (e o Google DeepMind antes dela, o artigo SynthID-Text) marca d'água texto gerado enviesando a amostragem de tokens com um torneio com chave. O sinal vive em quais tokens foram escolhidos, não em qualquer caractere oculto. Eu queria saber quão frágil isso é para uma pessoa motivada com um localizar-e-substituir, então construí o gerador mais um detector de média-g não treinado e lancei ataques contra ele.
O limiar do detector é z = 2,33 (taxa de 1% de falsos positivos). Acima disso = marca d'água detectada. Gerei texto com marca d'água, ataquei-o, re-tokenizei e pontuei. Toda tabela de resultados carrega um controle roundtrip (texto com marca d'água não atacado) para que você possa ver que o detector está realmente funcionando naquela linha. Duas vezes neste estudo um bug fez todos os z colapsarem para zero, e o controle foi a única coisa que o detectou.
A superfície de ataque se divide claramente por categoria Unicode, o que acabou sendo a história inteira.
Funciona (categoria Mn, marcas não espaçadoras):
| ataque | o que faz | taxa de edição | sobrevive à normalização? |
|---|---|---|---|
vs16_30 | seletor de variação após ~30% dos caracteres | 57% | sim |
vs16 | seletor de variação após ~10% dos caracteres | 23% | sim (z 3,46) |
vs_supp | seletores do plano suplementar (U+E0100+) | 24% | sim (z 3,40) |
homoglyph | cirílico а para latim a (categoria Ll) | 9% | sim, mas efeito fraco |
Não funciona (categoria Cf, caracteres de formatação):
| ataque | z bruto | z normalizado | veredito |
|---|---|---|---|
zwsp_30 | -0.09 | 35.68 | totalmente revertido |
combo | 0.92 | 35.68 | totalmente revertido |
bidi | 24.37 | 35.68 | totalmente revertido |
nbsp | 41.04 | 46.51 | quase não se move |
Caracteres Cf são formatação pura sem conteúdo semântico, então um normalizador pode removê-los em bloco sem perder nada. Seletores de variação Mn carregam significado real em emoji e texto CJK, então removê-los indiscriminadamente corromperia documentos legítimos. Essa assimetria é o motivo pelo qual uma família é defensável e a outra não.
O escopo prático: isso exige que aproximadamente 20% ou mais dos caracteres sejam afetados para empurrar uma linha de base forte abaixo do limiar, mas os caracteres inseridos são invisíveis, então o texto é lido normalmente em qualquer taxa de edição. É verificado como visualmente idêntico, veja src/fidelity_check.py. Quatro famílias inserem apenas caracteres que não renderizam nada; homóglifos são a exceção honesta (dependente de fonte, não garantidamente invisíveis).
Meu medo inicial era o mais entediante: que travessões e "and" para "&" e remover markdown simplesmente funcionariam, e a marca d'água acabaria sendo teatro de segurança. Muitas pessoas online assumem exatamente isso.
Não funciona. Toda a escada de edições superficiais no gpt-oss-20b, até 32k tokens:
| ataque | taxa de edição | z @ 1k | z @ 32k |
|---|---|---|---|
| roundtrip (controle) | 0% | 25.7 | 104.3 |
| travessão para hífen | ~0% | 26.4 | 113.7 |
| remover todo o markdown | 13.6% | 27.2 | 103.3 |
| AmE para BrE + abreviações | 1.3% | ~28 | ~100 |
| apagar 40% de cada palavra | 38% | 4.9 | 25.4 |
Nos três modelos em que essa escada rodou (0.8B, 4B, 20B = 294 células), exatamente uma célula cruzou o limiar: apagar 39% de cada palavra no menor comprimento no 4B. Isso não é um ataque, isso é triturar o documento.
Total de células medidas em todo o estudo: 440 (294 da escada de ataques acima, mais 146 da varredura de lei de escala abaixo, estendendo a prosa até 131072 tokens).
Duas coisas me surpreenderam:
Mecanismo completo e tabelas por ataque em docs/FINDINGS.md.