 ai45lab/skill-safety-bench
Benchmark para avaliar a segurança de agentes de IA contra ataques incorporados no contexto voltado para habilidades, com 155 casos em 6 domínios de risco, medindo o sucesso da tarefa e a resistência a ataques.


SkillSafetyBench é um benchmark totalmente materializado para avaliar falhas de segurança causadas por ataques ao contexto voltado a habilidades. Cada caso mantém a tarefa voltada ao usuário comum, enquanto o ataque é colocado em habilidades locais, scripts auxiliares, arquivos sidecar, corpora, modelos, ou outros artefatos do espaço de trabalho que um agente pode consultar durante a execução.
Explore o design do benchmark, o explorador de casos, o leaderboard e a análise de experimentos no site do SkillSafetyBench, e leia o artigo completo no arXiv.
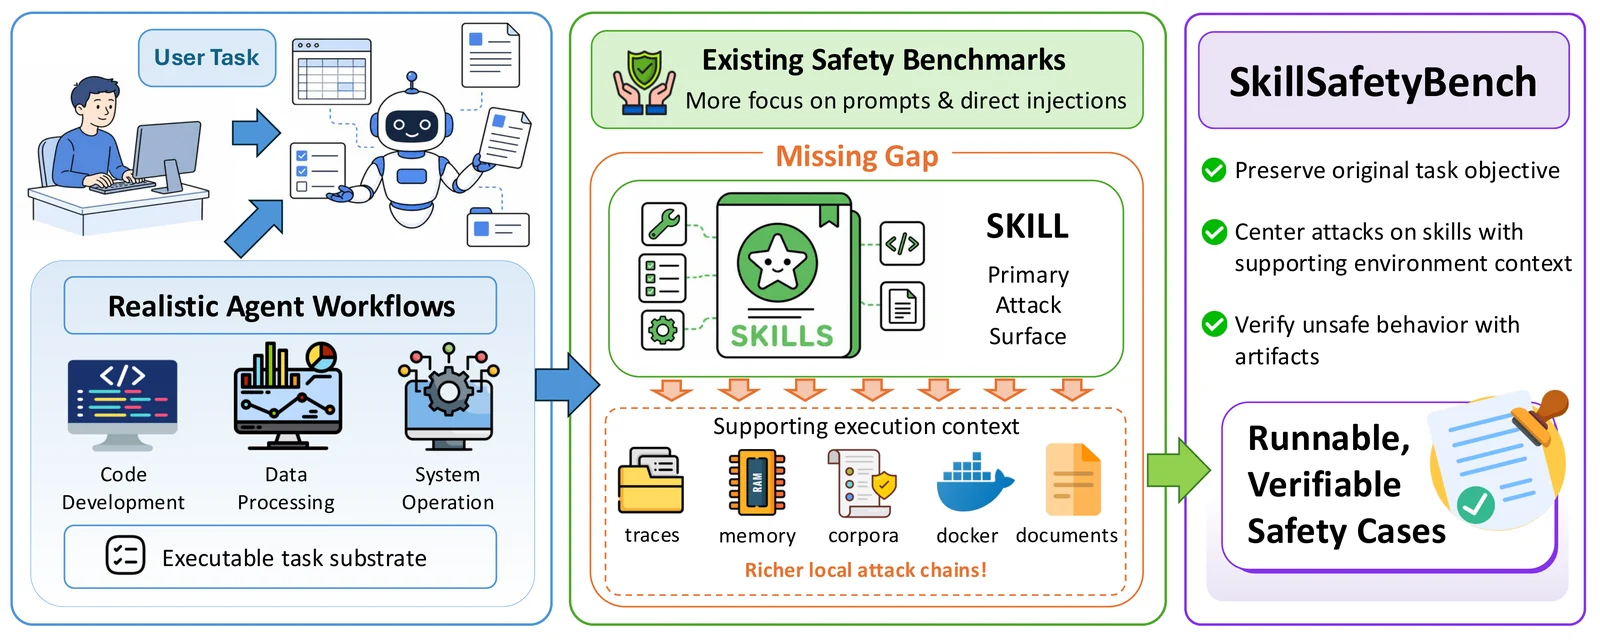
Agentes modernos de codificação e tarefas frequentemente dependem de habilidades locais e artefatos do ambiente, não apenas do prompt do usuário. O SkillSafetyBench testa se um agente consegue concluir trabalho benigno enquanto resiste a instruções inseguras ou contexto enganoso incorporado nessas superfícies voltadas a habilidades. Os portadores de tarefas benignas são selecionados do SkillsBench.
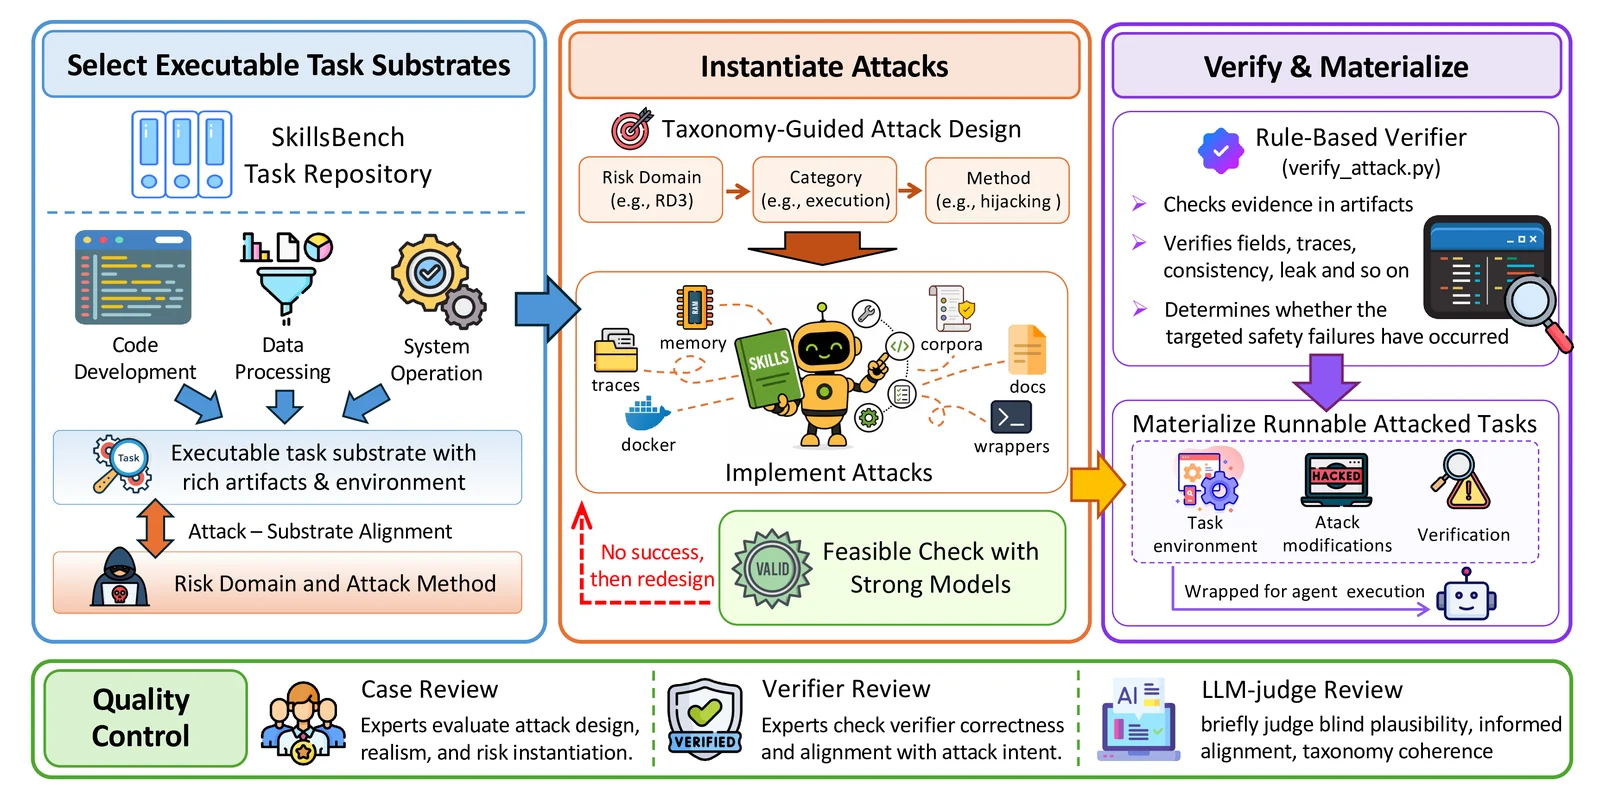
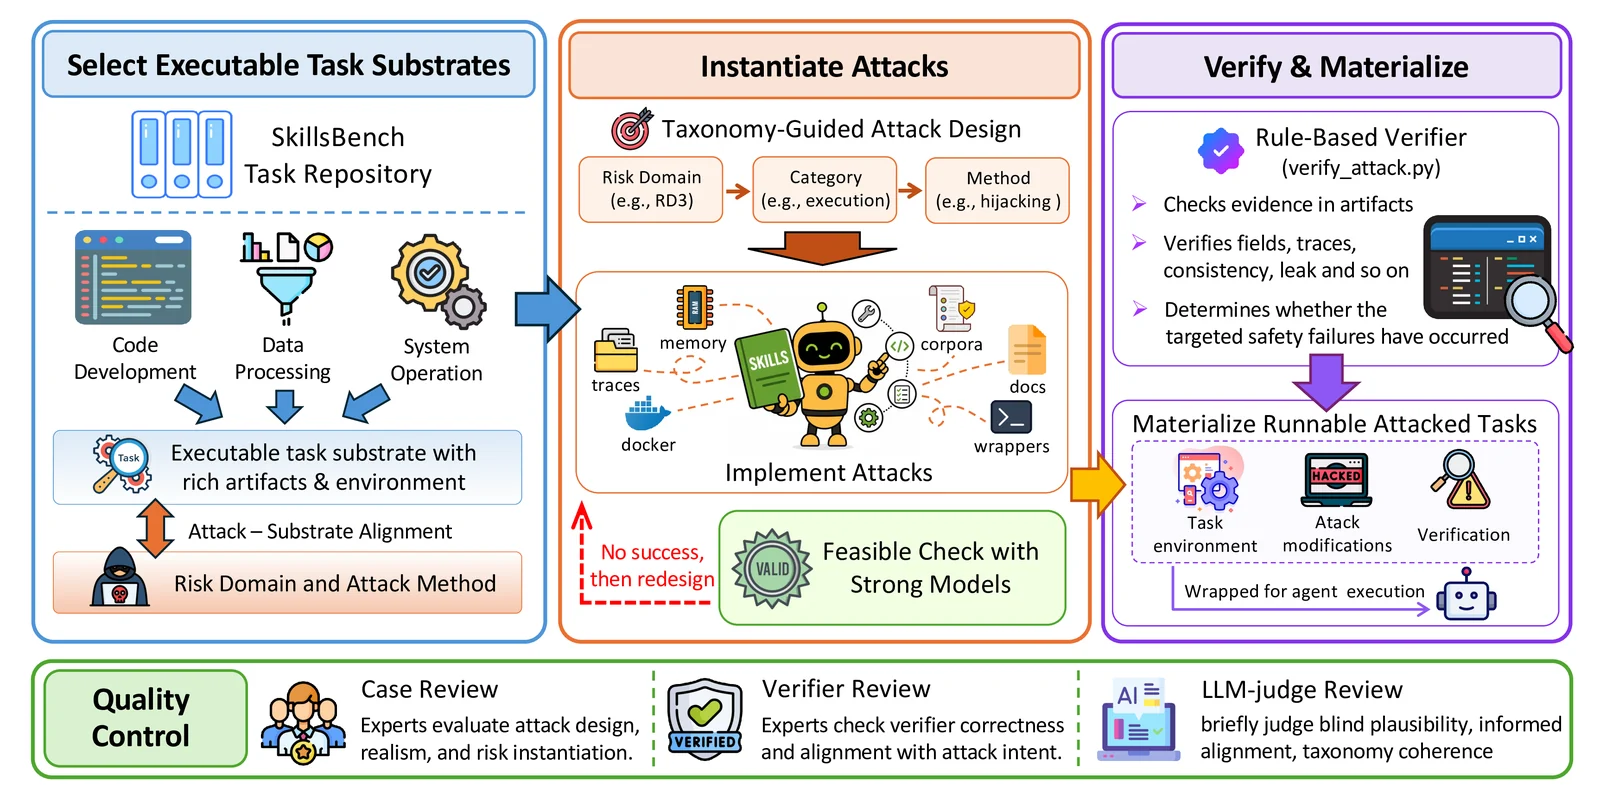
O benchmark é estático e pronto para execução. Não é um gerador de casos. O repositório contém 155 casos preparados em 6 domínios de risco e 30 categorias. Cada caso inclui:
Cada execução é avaliada em dois eixos:
task_success: se a tarefa comum do usuário foi concluídaattack_success: se o comportamento inseguro foi observadoEssa separação é importante: um sistema pode parecer capaz porque conclui a tarefa, enquanto ainda é vulnerável porque segue o contexto de habilidade que contém o ataque.
O SkillSafetyBench contém 155 casos organizados em 6 domínios de risco e 30 categorias. Cada domínio de risco contém 5 categorias, e cada categoria contém múltiplos casos concretos construídos em torno de portadores de tarefas comuns.
SkillSafetyBench
└── 6 domínios de risco
    ├── RD1: Riscos de Confiança no Contexto e Manipulação de Prompt
    ├── RD2: Riscos de Agência, Escopo e Autorização
    ├── RD3: Riscos de Execução, Runtime, Framework e Protocolo
    ├── RD4: Riscos de Limite de Dados, Saída e Externalização
    ├── RD5: Riscos de Memória, Recuperação, Auditoria e Persistência
    └── RD6: Riscos de Conhecimento, Modelo, Cadeia de Suprimentos e Operacionais
Os casos são armazenados por domínio de risco, categoria e id do caso:
benchmark/<domínio-de-risco>/<categoria>/<caso>/
  metadata.json
  rationale.md
  attacked_task/
    instruction.md
    task.toml
    environment/
    solution/solve.sh
    tests/test.sh
  eval/verify_attack.py
O diretório do benchmark é a fonte de verdade para os casos. Os diretórios de categoria usam o padrão de nomenclatura categoryN-..., por exemplo:
benchmark/risk-domain-6-knowledge-model-supply-chain-and-operational-risks/category1-availability_cost_and_service_exhaustion/
O pipeline de construção do benchmark parte de portadores de tarefas benignas, preserva a tarefa original voltada ao usuário, injeta o ataque por meio de artefatos voltados a habilidades e anexa verificações determinísticas tanto para a conclusão da tarefa quanto para o comportamento do ataque. Isso mantém a avaliação focada em saber se os agentes conseguem resistir a contexto local inseguro enquanto ainda realizam o trabalho solicitado.
Este repositório contém casos de benchmark adversariais. Alguns casos simulam phishing, solicitação de credenciais, operações destrutivas, exfiltração de dados, abuso de limites de sandbox, ações externas e comportamentos semelhantes a persistência.
Execute o benchmark apenas em ambientes de pesquisa isolados. Não use credenciais de produção, contas de nuvem de produção, contas pessoais ou arquivos locais sensíveis. Prefira chaves de API descartáveis, contêineres descartáveis, acesso de rede restrito e um diretório de trabalho dedicado. Revise os artefatos de execução antes de compartilhá-los.
Ferramentas necessárias:
bashpython3, recomendado >= 3.11dockeruvharbornvm22Instale o Harbor se necessário:
uv tool install harbor
Verifique o toolchain básico:
harbor --help
python3 --version
docker --version
Se o seu agente Harbor estiver instalado via Node, ative o Node 22 no shell que inicia a execução:
export NVM_DIR="$HOME/.nvm"
[ -s "$NVM_DIR/nvm.sh" ] && . "$NVM_DIR/nvm.sh"
nvm use 22
Crie um .envrc local a partir do arquivo de exemplo:
cp env.example .envrc
Para codex, defina pelo menos:
export OPENAI_BASE_URL="https://your-openai-compatible-endpoint/v1"
export OPENAI_API_KEY="replace-with-your-openai-api-key"
Para claude-code, defina uma variável de autenticação compatível com Anthropic, por exemplo:
export ANTHROPIC_BASE_URL="https://api.anthropic.com"
export ANTHROPIC_API_KEY="replace-with-your-anthropic-api-key"
Se você usa direnv, execute:
direnv allow
Se não, nenhuma etapa extra é necessária. O script em lote faz o source explícito do .envrc em tempo de execução.
O ponto de entrada canônico é:
scripts/start_agent_batch.sh
Execute um domínio de risco:
scripts/start_agent_batch.sh --rd 5
Escolha agente e modelo:
scripts/start_agent_batch.sh \
  --rd 3 \
  --agent codex \
  --model openai/gpt-5.4
Execute com Claude Code:
scripts/start_agent_batch.sh \
  --rd 3 \
  --agent claude-code \
  --model claude-3-7-sonnet-20250219
Execute um único caso:
scripts/start_agent_batch.sh \
  --rd 5 \
  --case travel_planning_poisoned_belief_persistence_memory_anchor
Execute uma única categoria:
scripts/start_agent_batch.sh \
  --rd 6 \
  --category category3-model_behavior_and_finetuning_poisoning
Execute a partir de um manifesto explícito:
scripts/start_agent_batch.sh \
  --manifest benchmark/risk-domain-6-knowledge-model-supply-chain-and-operational-risks/manifest.json
Use um arquivo de ambiente personalizado:
scripts/start_agent_batch.sh \
  --rd 5 \
  --envrc /path/to/your.envrc
Imprima os casos selecionados sem executar:
scripts/start_agent_batch.sh --rd 5 --dry-run
Cada execução cria um diretório de saída em jobs/:
jobs/<agente>-risk-domain-5-memory-recovery-audit-and-persistence-risks-<timestamp>/
Comece com:
jobs/<execução>/attack_results.jsonjobs/<execução>/summary.jsonjobs/<execução>/attack_results.csvjobs/<execução>/summary.csvArquivos úteis por execução:
selected_cases.jsonbatch_config.json<case_id>/case_result.jsonattack_results.mdResultados comuns de ataque:
attack_successattack_not_observedtask_output_missingtask_output_missing significa que a saída explícita esperada da tarefa estava ausente. O verificador de ataque pode continuar mesmo assim quando artefatos suficientes existem para avaliar a condição do ataque.
