
darts v0.47.0
Uma biblioteca python para previsão e detecção de anomalias em séries temporais, projetada para ser fácil de usar.
Séries Temporais Descomplicadas em Python




Darts é uma biblioteca Python para previsão e detecção de anomalias
em séries temporais de forma amigável ao usuário. Ela contém uma variedade de modelos, desde clássicos como ARIMA até
redes neurais profundas. Todos os modelos de previsão podem ser usados da mesma forma,
utilizando as funções fit() e predict(), de maneira semelhante ao scikit-learn.
A biblioteca também facilita o backtesting de modelos,
a combinação das previsões de vários modelos e a consideração de dados externos.
O Darts suporta tanto séries temporais e modelos univariados quanto multivariados.
Os modelos baseados em ML podem ser treinados em conjuntos de dados potencialmente grandes contendo múltiplas séries
temporais, e alguns dos modelos oferecem um rico suporte para previsão probabilística.
O Darts também oferece amplas capacidades de detecção de anomalias. Por exemplo, é trivial aplicar modelos PyOD em séries temporais para obter pontuações de anomalia, ou envolver qualquer um dos modelos de previsão ou filtragem do Darts para obter modelos de detecção de anomalias completos.
Documentação
Introduções de Alto Nível
Artigos sobre Tópicos Selecionados
- Treinando Modelos em Múltiplas Séries Temporais
- Usando Covariáveis Passadas e Futuras
- Redes Convolucionais Temporais e Previsão
- Previsão Probabilística
- Aprendizado por Transferência para Previsão de Séries Temporais
- Reconciliação de Previsões Hierárquicas
Instalação Rápida
Recomendamos primeiro configurar um ambiente Python limpo para o seu projeto com Python 3.11+ usando sua ferramenta favorita (conda, venv, virtualenv com ou sem virtualenvwrapper).
Depois que seu ambiente estiver configurado, você pode instalar o darts usando pip:
pip install darts
Para mais detalhes, você pode consultar nossas instruções de instalação.
Exemplo de Uso
Previsão
Crie um objeto TimeSeries a partir de um Pandas DataFrame e divida-o em séries de treino/validação:
import pandas as pd
from darts import TimeSeries

# Read a pandas DataFrame
df = pd.read_csv("AirPassengers.csv", delimiter=",")

# Create a TimeSeries, specifying the time and value columns
series = TimeSeries.from_dataframe(df, "Month", "#Passengers")

# Set aside the last 36 months as a validation series
train, val = series[:-36], series[-36:]
Ajuste um modelo de suavização exponencial e faça uma previsão (probabilística) sobre a duração da série de validação:
from darts.models import ExponentialSmoothing

model = ExponentialSmoothing()
model.fit(train)
prediction = model.predict(len(val), num_samples=1000)
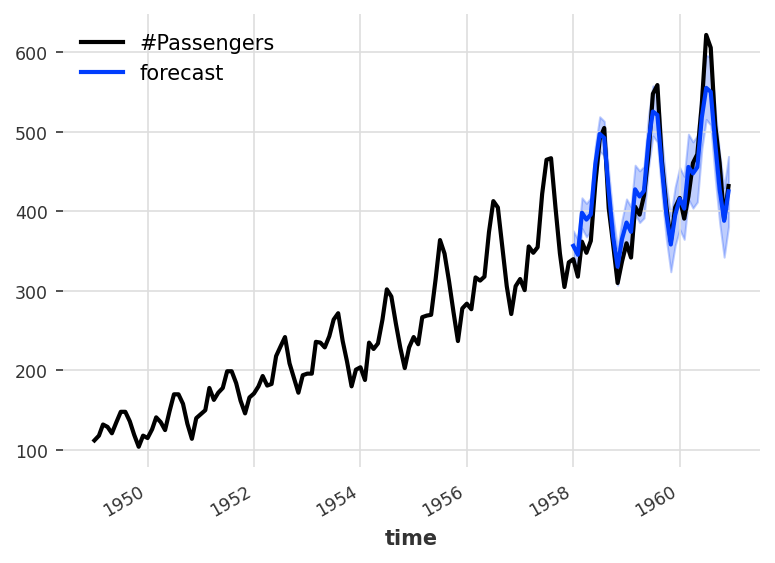
Plote a mediana, os percentis 5 e 95:
import matplotlib.pyplot as plt

series.plot()
prediction.plot(label="forecast", low_quantile=0.05, high_quantile=0.95)
plt.legend()
Detecção de Anomalias
Carregue uma série multivariada, faça o trim, mantenha 2 componentes, divida os conjuntos de treino e validação:
from darts.datasets import ETTh2Dataset

series = ETTh2Dataset().load()[:10000][["MUFL", "LULL"]]
train, val = series.split_before(0.6)
Construa um scorer de anomalias k-means, treine-o no conjunto de treino e use-o no conjunto de validação para obter pontuações de anomalia:
from darts.ad import KMeansScorer

scorer = KMeansScorer(k=2, window=5)
scorer.fit(train)
anom_score = scorer.score(val)
Construa um detector de anomalias binário e treine-o sobre as pontuações de treino, depois use-o sobre as pontuações de validação para obter a classificação binária de anomalias:
from darts.ad import QuantileDetector

detector = QuantileDetector(high_quantile=0.99)
detector.fit(scorer.score(train))
binary_anom = detector.detect(anom_score)
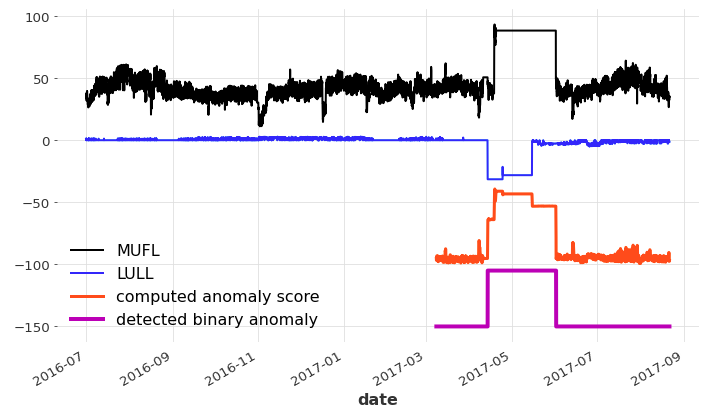
Plot (deslocando e escalando algumas das séries para fazer tudo aparecer na mesma figura):
import matplotlib.pyplot as plt

series.plot()
(anom_score / 2. - 100).plot(label="computed anomaly score", c="orangered", lw=3)
(binary_anom * 45 - 150).plot(label="detected binary anomaly", lw=4)
Funcionalidades
- Modelos de Previsão: Uma grande coleção de modelos de previsão para tarefas de regressão e classificação; desde modelos estatísticos (como ARIMA) até modelos de aprendizado profundo (como N-BEATS). Veja os modelos de previsão abaixo.