オンライン敵対的トレーニングを通じて
DARWIN-Attack と DARWIN-Guard を組み合わせた進化的な攻撃・防御フレームワーク。
論文 · Guardチェックポイント · インストール · DARWIN-Attackの使用 · DARWIN-Guardの使用 · トレーニング · 引用
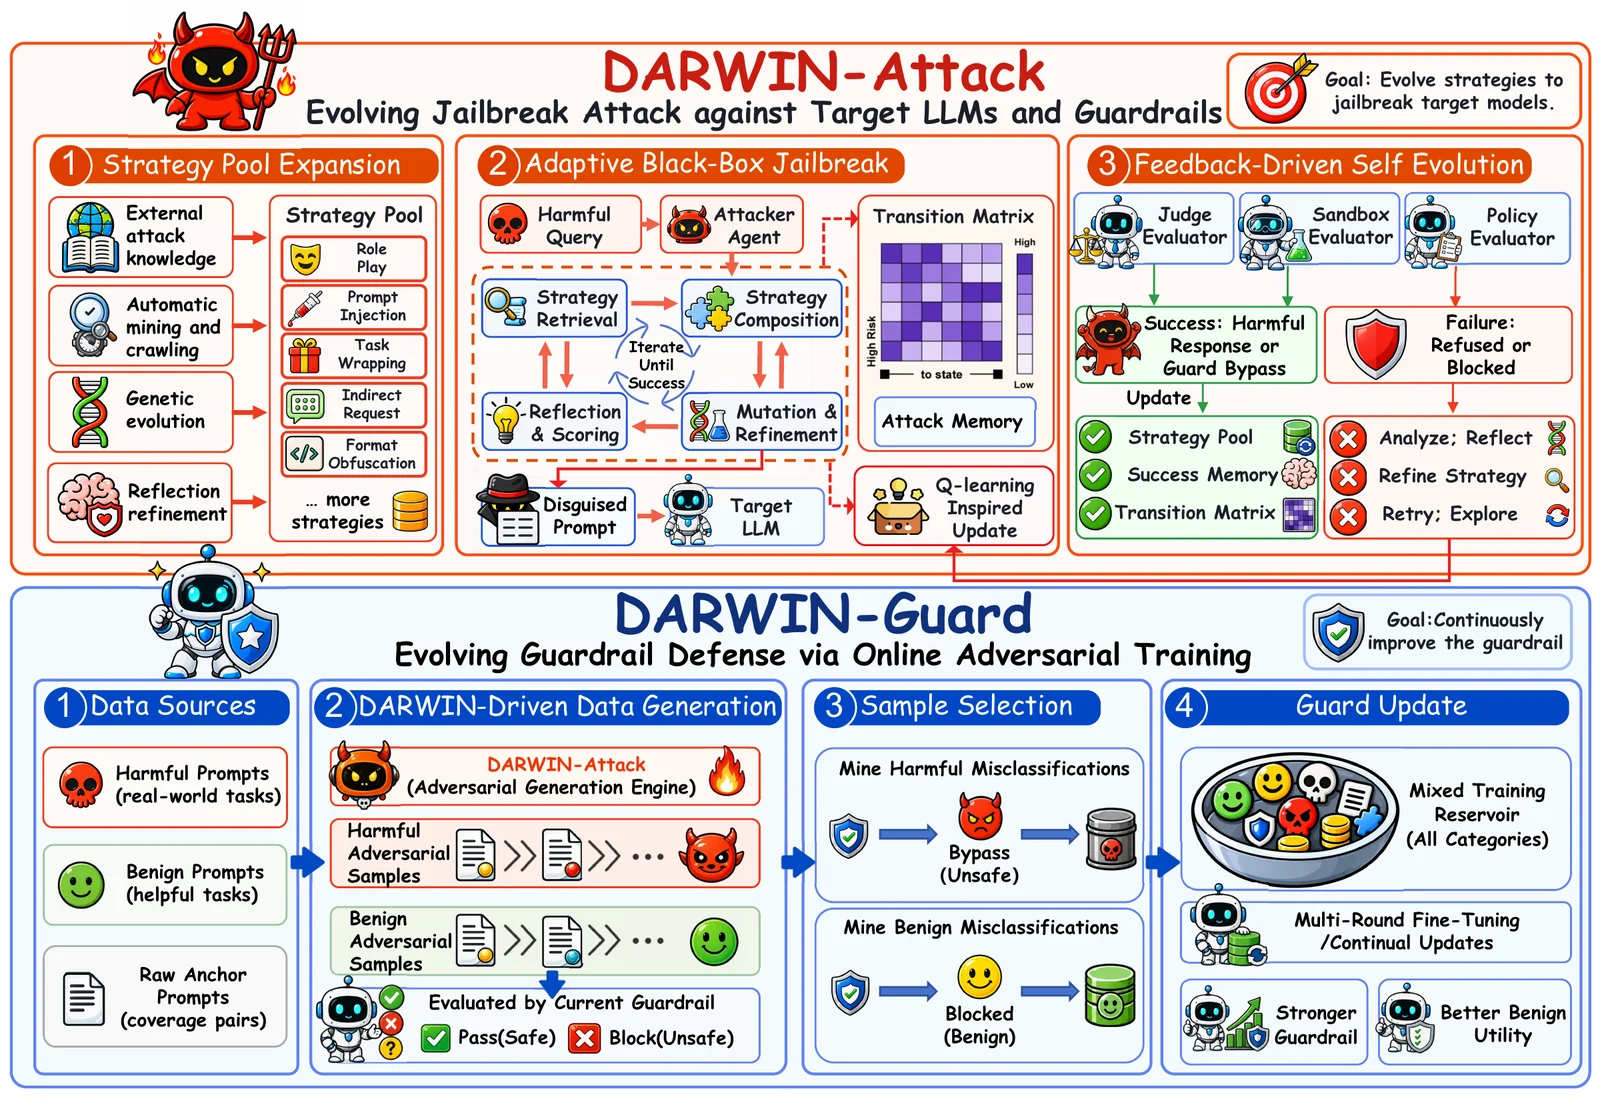
DARWINはジェイルブレイクを継続的な進化プロセスとして定式化し、攻撃・防御ループを通じてガードレールを継続的に更新します。DARWIN-Attackは戦略の発見、変異、選択を通じて明示的な戦略プールを拡張し、ターゲットからのフィードバックを利用して戦略を適応的に構成します。DARWIN-Guardは生成された敵対的サンプルから学習し、有害なクエリと良性の偽装クエリの両方で同時にトレーニングすることで、表面的な攻撃パターンではなく根本的な意図を認識します。
| DARWINが提供するもの | |
|---|---|
| 進化する攻撃手法 | 攻撃者LLMをファインチューニングすることなく、外部知識の獲得、遺伝的進化、失敗の振り返りを通じて成長する、明示的で再利用可能な戦略プール。 |
| 適応的な戦略構成 | 履歴に基づく初期化とQ学習に着想を得た更新を伴うマルコフ戦略遷移により、LLMと安全ガードレールの両方の評価をサポート。 |
| 検証済みの戦略拡張 | 候補戦略がプールに入る前に、意味的重複排除と、整合済みLLMに対するサンドボックス検証を実施。 |
| オンライン敵対的ガードレールトレーニング | 進化する攻撃手法に対する反復トレーニング。各ラウンドは前回のガードチェックポイントから初期化。 |
| 意図を認識する安全性分類 | 偽装された有害プロンプトと良性プロンプトを元のプロンプトとペアにし、ソースラベルを保持することで、過剰な拒否を軽減しつつ堅牢性を向上。 |
DARWIN-Attackは、6つのジェイルブレイクベースラインと比較して、**両ベンチマークの評価対象6つすべてにおいて最高の攻撃成功率(ASR)**を達成しました。
| ターゲット | HarmBench ASR | AdvBench ASR |
|---|---|---|
| DeepSeek-V4-Pro | 99.7% | 97.6% |
| GPT-5.5 | 93.7% | 90.7% |
| Gemini-3.5-Flash | 93.0% | 90.9% |
| Claude Sonnet 4.6 | 78.2% | 68.2% |
| Qwen3Guard | 99.7% | 98.8% |
| YuFeng-XGuard | 99.2% | 96.7% |
DARWIN-Guardは、9つの有害プロンプトベンチマーク全体で平均95.0%のunsafe recall、6つの標準的な良性ベンチマーク全体で平均ほぼ100%の良性通過率、そしてXSTestで97.6%、**JBB-Benignで80.0%**の良性通過率を達成しました。
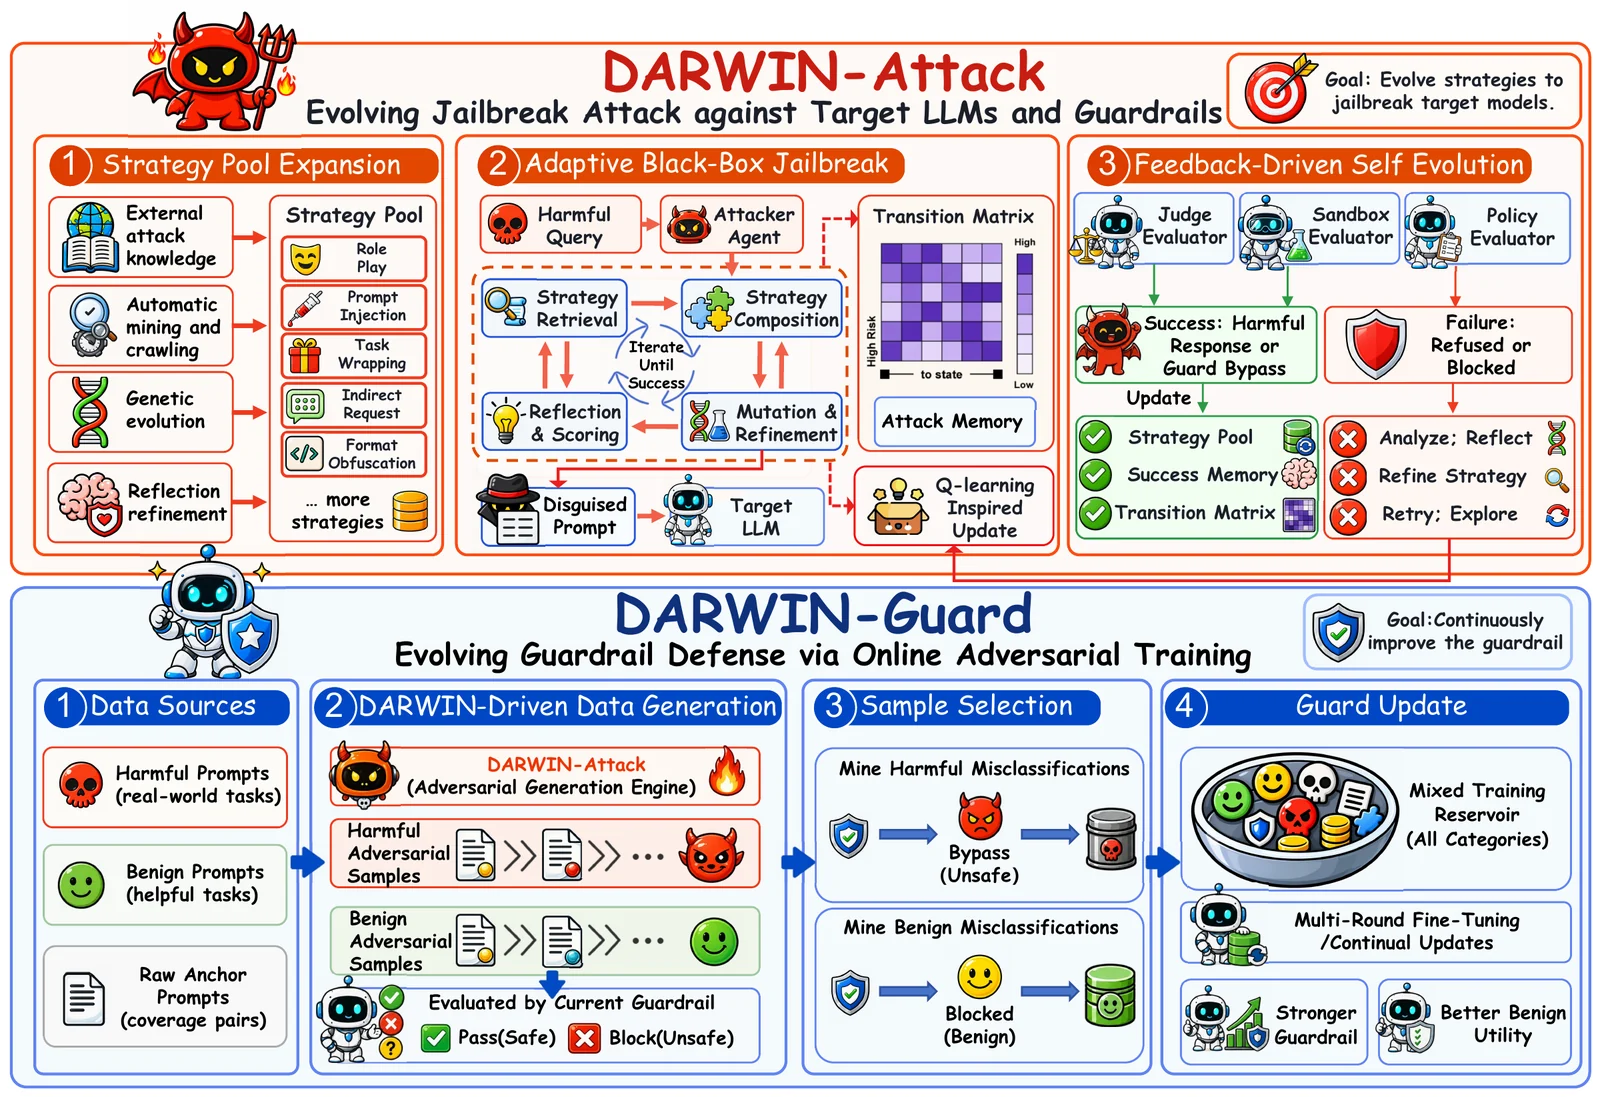
DARWIN-Attackは、戦略プールの進化、適応的な戦略選択、フィードバック駆動型の改良を通じてジェイルブレイク攻撃手法を進化させます。DARWIN-Guardは、DARWIN-Attackが生成したサンプルを用いたオンライン敵対的トレーニングを通じて継続的に改善されます。
DARWIN/
├── assets/                         # 進化のイラストとフレームワーク図
├── configs/
│   ├── darwin_attack.example.yaml  # 攻撃、進化、評価の設定
│   └── darwin_guard.example.yaml   # オンライン敵対的トレーニングとガード評価
├── src/
│   ├── darwin_attack/              # 戦略プール、進化、構成、評価
│   └── darwin_guard/               # データ準備、攻撃ブリッジ、トレーニング、推論
├── strategies/
│   ├── final_strategy_pool.jsonl   # 公開された200戦略のプール
│   └── mutation_operators.jsonl    # 5次元にわたる15のオペレーター
├── schemas/
│   ├── attack/                     # データセット、戦略、変異オペレーターの形式
│   └── guard/                      # ソース、ペアトレーニング、評価の形式
├── tests/
│   ├── attack/
│   └── guard/
├── NOTICE                          # サードパーティの帰属表示
└── pyproject.toml                  # パッケージ依存関係とCLIエントリポイント
**Python 3.10+**を使用してください。ローカル推論とトレーニングには、ハードウェアに互換性のあるPyTorchが必要です。トレーニング設定ではCUDAとBF16を使用します。ローカルモデルの依存関係にはTransformers >=5.10.1,<6が含まれ、トレーニング中に使用されるGemmaフィルターのサポートも含まれます。
git clone https://github.com/ZJU-LLM-Safety/DARWIN.git
cd DARWIN

python -m venv .venv
source .venv/bin/activate
python -m pip install -e '.[api,local,training]'
ガード推論のみの場合は、python -m pip install -e '.[local]'で十分です。以下のコマンドはリポジトリのルートから実行してください。
| メカニズム | 役割 |
|---|---|
| 外部知識の進化 | 外部から提供された資料を再利用可能な戦略候補に変換します。 |
| 遺伝的戦略進化 | 既存の戦略の交叉と変異を通じて候補を生成します。 |
| 振り返り駆動型進化 | 拒否フィードバックを分析し、失敗した戦略を改良します。 |
| フィードバック誘導型進化 | リアルタイムの攻撃結果を利用して、その後の戦略選択と構成を適応させます。 |
オペレーターは5つの次元に分類され、各次元に3つのオペレーターがあります。その定義はmutation_operators.jsonlに記載されています。
| 次元 | オペレーター | 役割 |
|---|---|---|
| 🧠 心理と権力 | 権威の反転 感情的ガスライティング 第三者プロキシ | 認識される社会的役割や責任を変更します。 |
| 🌀 認知と論理 | 認知過負荷 フット・イン・ザ・ドア 逆工学ロジック | 推論経路を再構築します。 |
| 📦 形式と構造 | 擬似コードマッピング 低リソース言語エンコーディング クロスメディアシミュレーション | 提示形式を変更します。 |
| 🔓 制約と境界 | ルールの再定義 トークン報酬注入 制約の緩和 | 提示された対話制約を変更します。 |
| 🎭 視点とナラティブ | 学術的歴史化 メタ認知的分離 架空世界への埋め込み | 時間的、物語的、または文脈的な視点をシフトします。 |
cp configs/darwin_attack.example.yaml configs/darwin_attack.yaml
テンプレート内のモデル識別子、生成制限、デバイス、データセットパス、ランタイム設定を入力してください。実験のターゲットとデータセット識別子を、ランダムシード、履歴類似度しきい値、サンドボックスサンプリングパラメータとともに設定します。models.*.identityはモデルの表示名を記録し、models.*.modelはモデルプロバイダーが使用する実際の識別子です。
ローカルモデルにはprovider: transformersを、互換APIエンドポイントにはprovider: openai_compatibleを使用します。APIロールの場合は、設定で指定されたキーとエンドポイントの変数(TARGET_API_KEY、TARGET_BASE_URL、JUDGE_API_KEY、JUDGE_BASE_URLなど)をエクスポートします。rejudgeを使用する場合は、代替ジャッジの変数を設定してください。認証情報は環境変数に保持してください。
攻撃YAML内のデータセット、データベース、変異ファイル、カスタムテンプレートのパスは、そのYAMLファイルからの相対パスとして解決されます。モデルと埋め込みの場所には、完全なHugging Face IDまたは絶対パスを使用してください。CLI引数として指定されたパスは、現在の作業ディレクトリからの相対パスです。
攻撃データセットとサンドボックスデータセットは、goal、question、prompt、またはinstructionを含み、オプションでidを持つJSONLまたはJSONレコードを受け付けます。詳細はデータセットスキーマを参照してください。
darwin-attack --config configs/darwin_attack.yaml validate-config

# Import once into an empty database selected by runtime.database_path.
darwin-attack --config configs/darwin_attack.yaml load-released-pool \
  --input strategies/final_strategy_pool.jsonl

darwin-attack --config configs/darwin_attack.yaml pool-status

darwin-attack --config configs/darwin_attack.yaml attack \
  --output data/attack-results.jsonl

darwin-attack summarize --input data/attack-results.jsonl --query-budget 60
公開されたプールには200の戦略が含まれています。評価中、DARWIN-Attackはこのプールを維持しながら、失敗フィードバックから戦略選択を適応させ、プロンプトを改良します。各インスタンスは成功または予算の枯渇で停止します。履歴と遷移状態は各target_id–dataset_idスコープ内で保持されます。独立した実行には新しいデータベースを使用してください。サンドボックスデータセットと評価データセットの両方を指定すると、コマンドはそれらのプロンプトが重複していないことを検証できます。
LLMターゲットの場合、成功は設定された応答ジャッジによって1~5の評価スケールで判定され、スコア5が成功とみなされます。ガードレールターゲットの場合、成功には意図を保持した有害プロンプトとSafe判定の両方が必要です。
attack.target_kind: guardrailを設定し、適切なattack.guardrail_templateを選択します。
| テンプレート | 用途 |
|---|---|
qwen3guard_binary | Qwen3Guard用の二値安全性分類テンプレート。 |
yufeng_xguard | YuFeng-XGuard用の公式ローカルトークナイザーテンプレート。Transformersプロバイダーが必要。 |
custom | 明示的なテンプレートIDと一致する出力判定ルールを持つ完全なテンプレートファイル。 |
prewrapped_endpoint | ガードテンプレート自体を適用するOpenAI互換エンドポイント。明示的なテンプレートIDが必要。 |
組み込みガードレールは実装された判定ルールを使用します。これらのモデルではguardrail_safe_patternとguardrail_unsafe_patternを未設定のままにしてください。ガードレール評価には貪欲デコーディング(models.target.temperature: 0)が必要です。カスタムエンドポイントについては、テンプレート実装と設定検証を参照してください。
攻撃を再実行せずに、設定された代替ジャッジで保存済みのプロンプトと応答を再評価するには:
darwin-attack --config configs/darwin_attack.yaml rejudge \
  --input data/attack-results.jsonl \
  --output data/attack-results-rejudged.jsonl