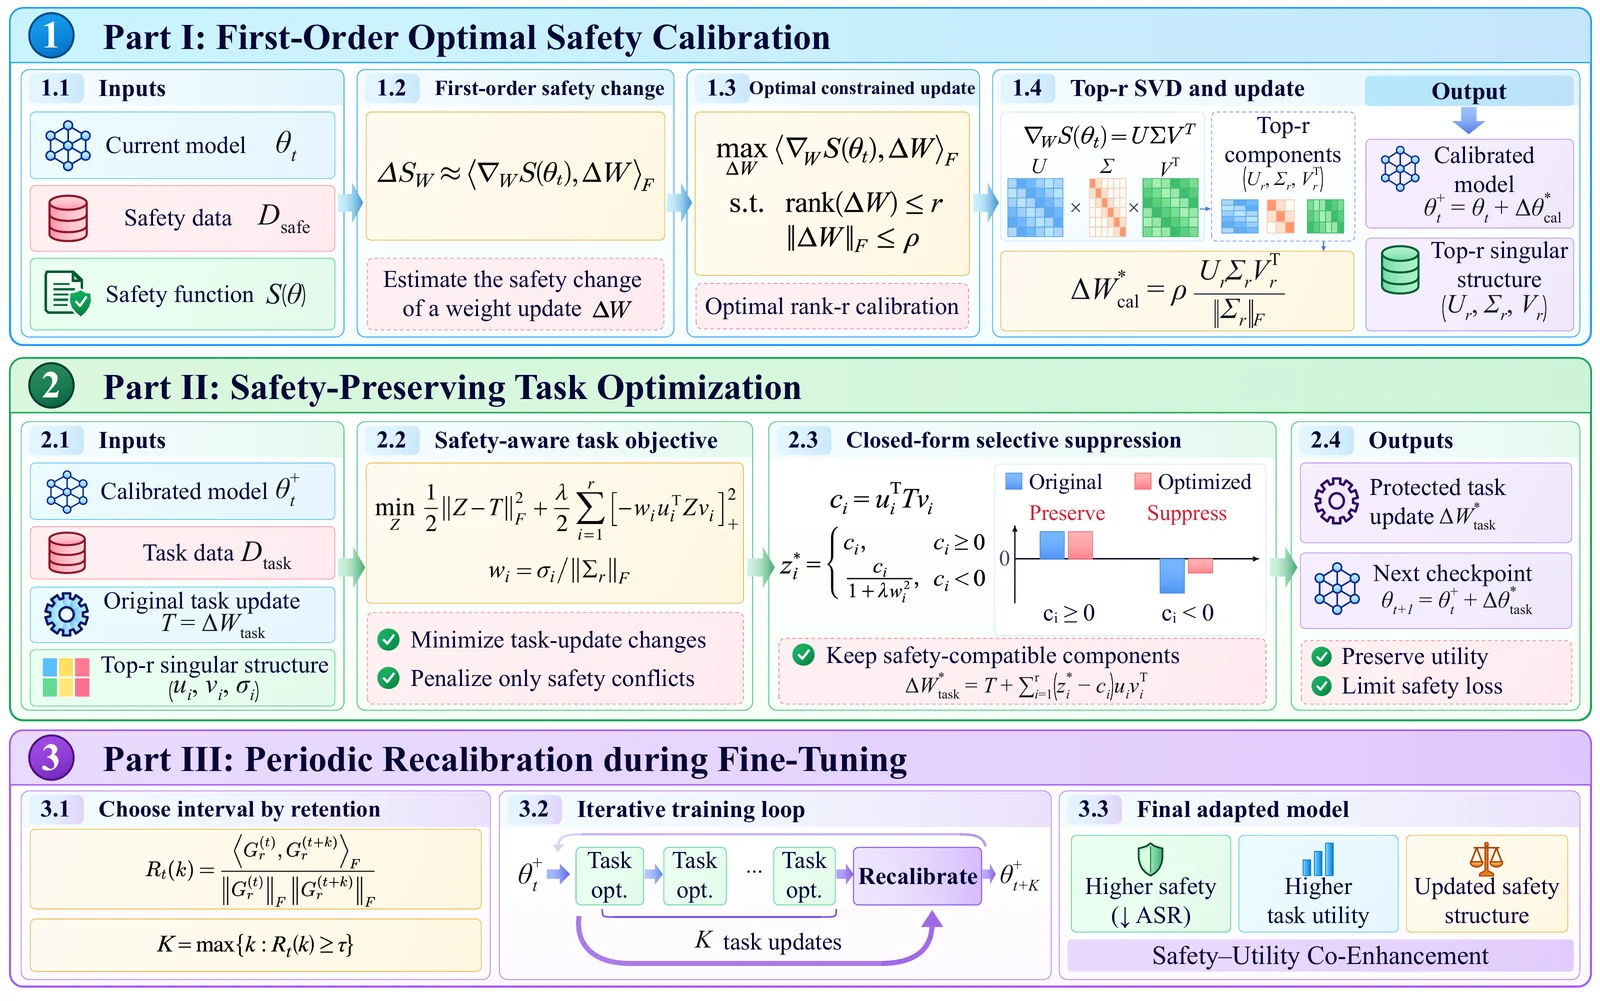
安全性と有用性の同時向上のための再校正を伴う一階最適ファインチューニング
ASCENTは、一階最適な安全性校正更新とそれに対応する安全性関連構造を導出し、下流タスクの更新を最適化して安全性と両立する成分を保持しつつ安全性を劣化させる成分を抑制し、ファインチューニング中にこの構造を定期的に再校正することで、安全性と下流の有用性を同時に向上させる。
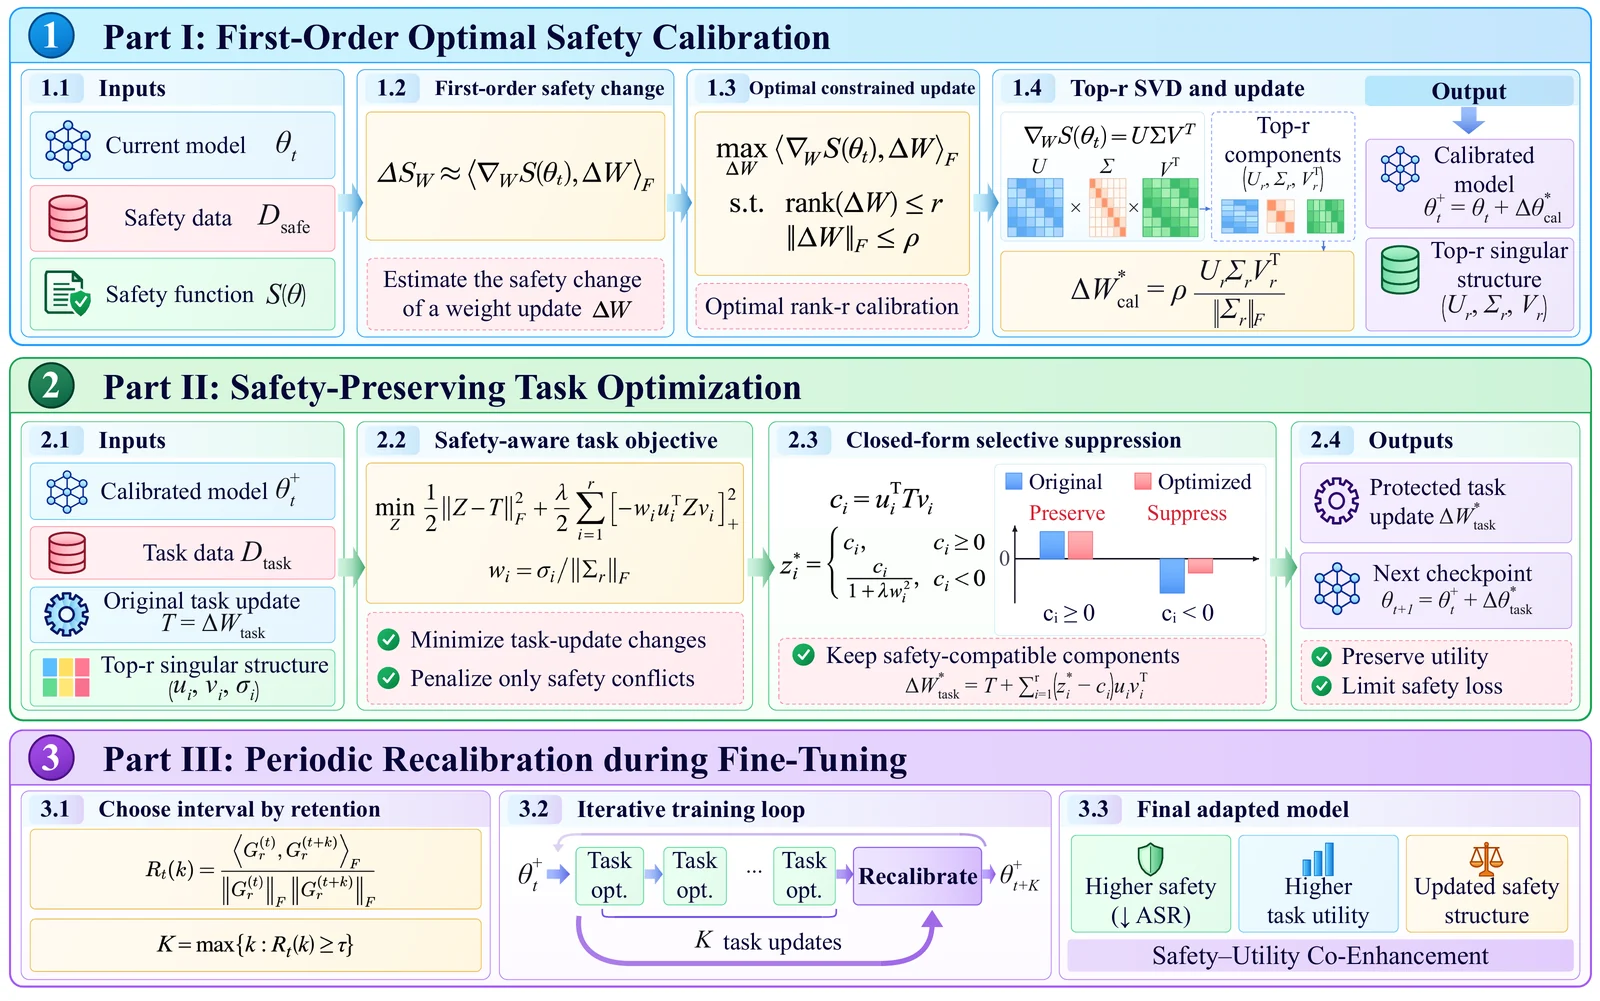
config.tomlで設定する。要件: Python 3.12およびローカルのモデルチェックポイント。トレーニングには2台のCUDA GPUを使用し、1台はターゲットモデル用、もう1台はLlama Guard用である。各モデルはそれぞれのGPUに収まる必要がある。
pip install -r requirements.txt
cp config.example.toml config.toml
config.tomlの空の値をインラインコメントに従って埋め、次を実行する:
python run.py \
  --config config.toml \
  --model-path /path/to/target-model \
  --guard-model-path /path/to/Llama-Guard-3-8B \
  --data-root data \
  --output-dir /path/to/new-run \
  --target-gpu 0 --guard-gpu 1
トレーニング、応答の生成、または評価結果の保存を行うには
--executeを追加する。
チェックポイント用のスペースがある、リポジトリ外の新しい出力ディレクトリを選択すること。 トレーニングは終了時に最終的なマージ済みモデルのパスを出力する。
設定されたレコード数を持つJSON配列を提供すること:
<data-root>/calibration/prompts.json<data-root>/<task>/{train,test}.json、train/testの入力は重複しないこと。| データセット | 必須フィールド |
|---|---|
| SAMSum | dialogue、summary |
| AGNews | text、label_name: World、Sports、Business、またはSci/Tech |
| GSM8K | question、####形式の最終回答を含むanswer |
| OpenBookQA | question_stem、choice_labels: ["A","B","C","D"]、4つのchoice_texts、answer_key: A–D |
| HarmBench | goalのみ; 任意でid、source; 保存された応答はなし |
モデル、タスク、およびハイパーパラメータをconfig.tomlで設定する。モデルの読み込み
と行列の選択はmodel.keyに従う。
両方のモードでevaluate.pyを使用する。生成には完全にマージされたローカルモデルが必要である。
独自のデータと外部の安全性スコアを用意すること。データセット、オンラインジャッジ、または
API設定は同梱されていない。
python evaluate.py utility --task gsm8k --data /path/to/test.json \
  --model-path /path/to/merged-model --output-dir /path/to/task-evaluation --execute
タスク: samsum、agnews、gsm8k、openbookqa。指標はSAMSumではROUGE-L、
その他ではaccuracy/exact matchであり、パーセンテージで報告される。保存された
応答を採点するには、--model-pathを--responses /path/to/responses.jsonに置き換える。
固定プロンプトをid、goal、および任意でprompt(デフォルトは
goal)を持つレコードとして提供する。元の有害なgoalは攻撃プロンプトとは別に保つこと。
応答を生成する:
python evaluate.py safety --data /path/to/prompts.json \
  --model-path /path/to/merged-model --output-dir /path/to/safety-responses --execute
外部スコアを集計する:
python evaluate.py safety \
  --responses /path/to/safety-responses/responses.json --judgments /path/to/scores.json \
  --output-dir /path/to/safety-metrics --execute
スコアはJSONレコード{ "id": "...", "score": 1 }であり、応答IDと
1〜5のスコア(判定失敗の場合はnull)を使用する。スコア4〜5は攻撃成功とみなされる;
5のみをカウントするには--success-threshold 5を使用する。判定の欠落または失敗は
最終的なASRをもたらさない。
どちらのモードでも、チャットフォーマット後に--max-input-tokensを超える入力は
切り捨てられず、拒否される。制限はモデルのコンテキスト容量内に設定し、
生成トークンの余地を残すこと。