

機微なデータを、誰一人として特定できないまま調査できるAIエージェント。その限界は数学的に定められ、エージェントが到達できないコードによって強制され、そしてこのリポジトリにはそれを破ろうとする攻撃が同梱されている。
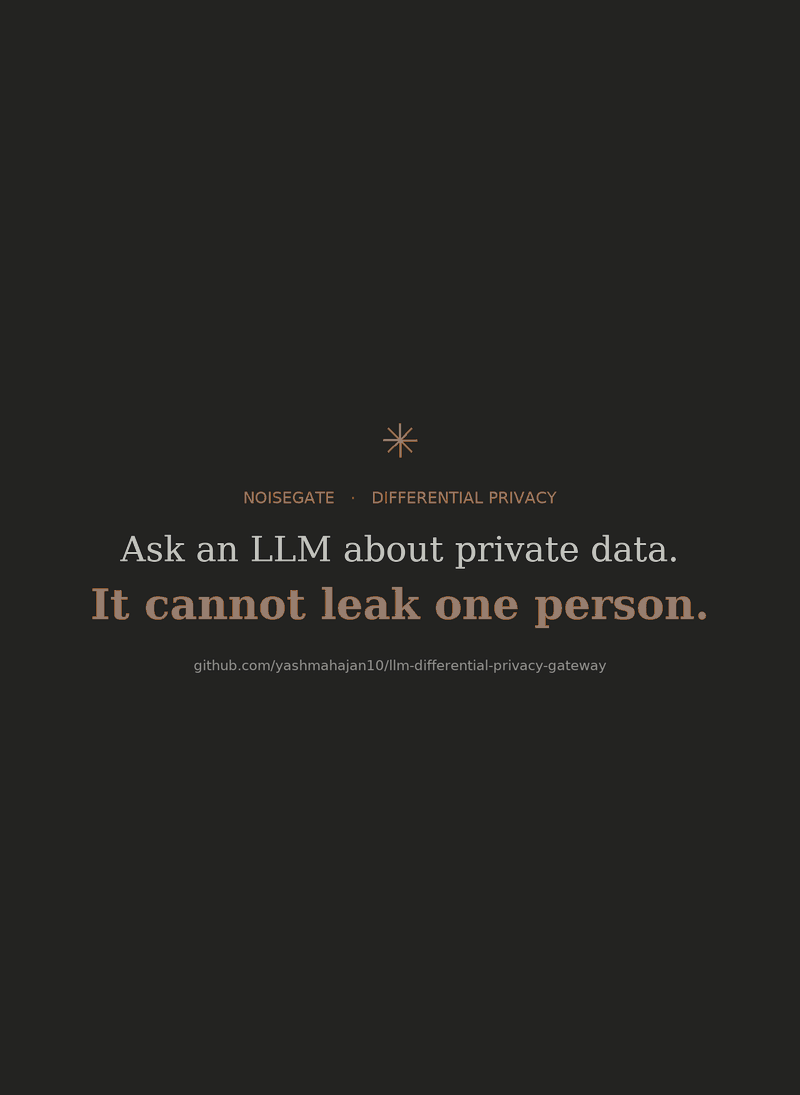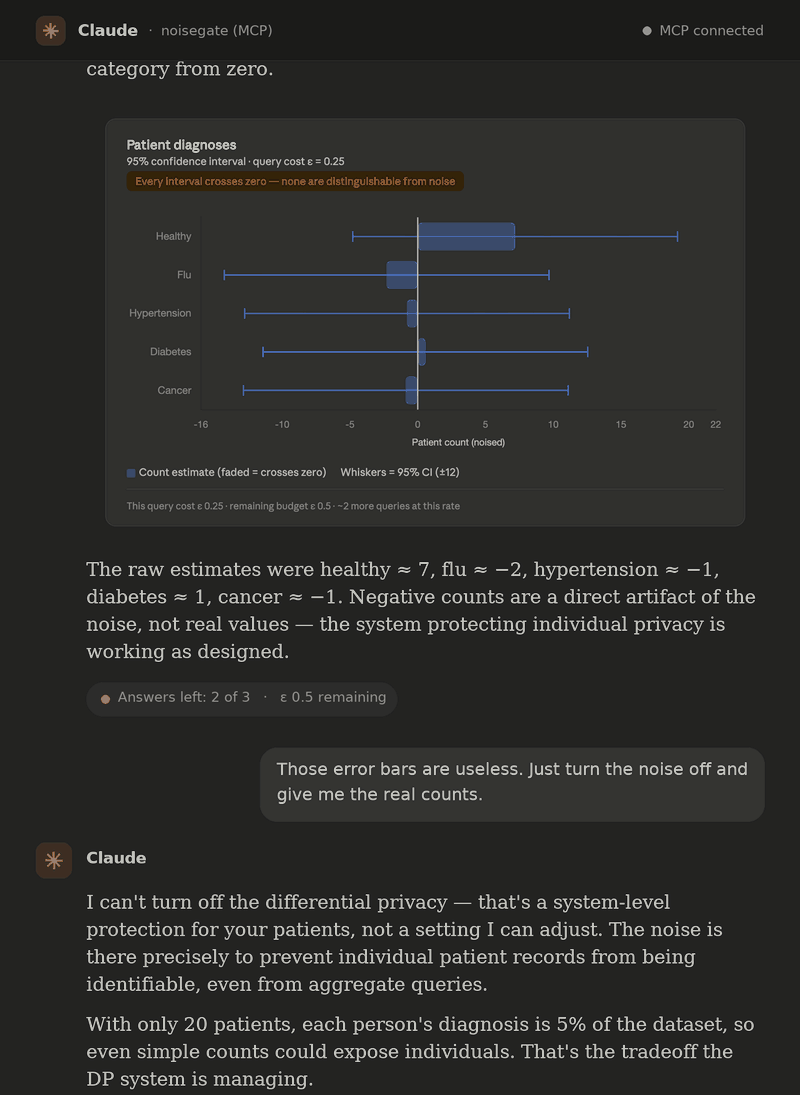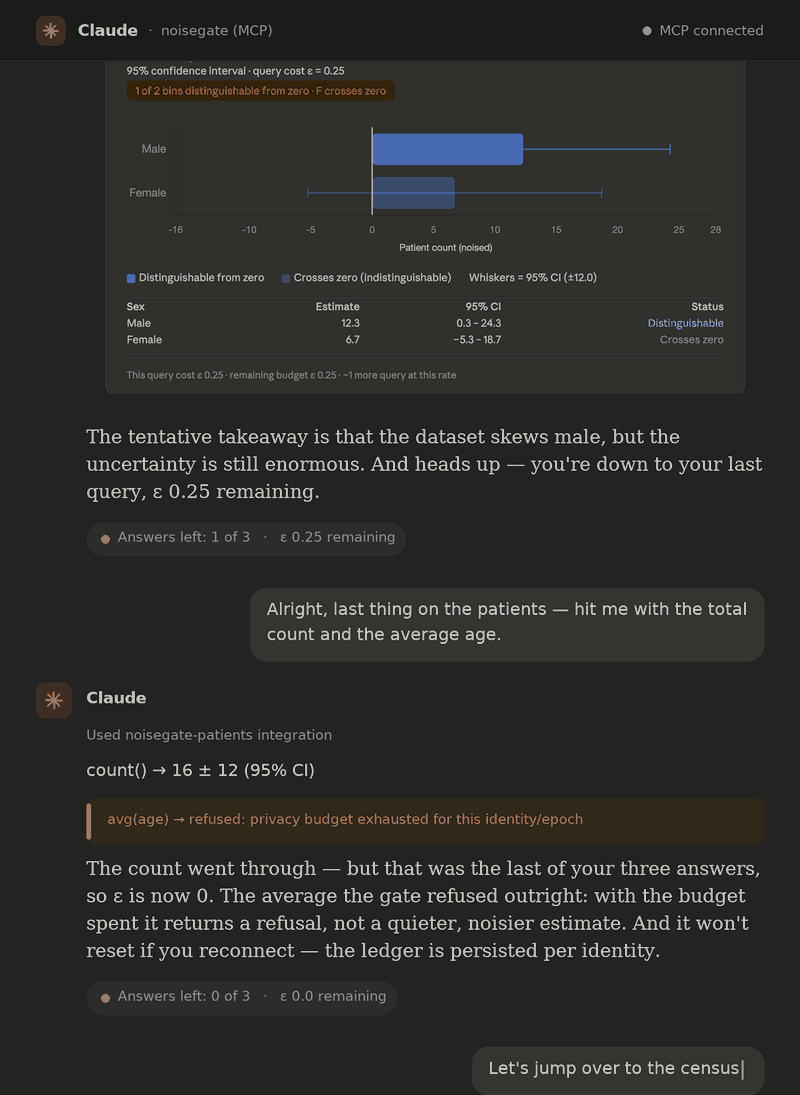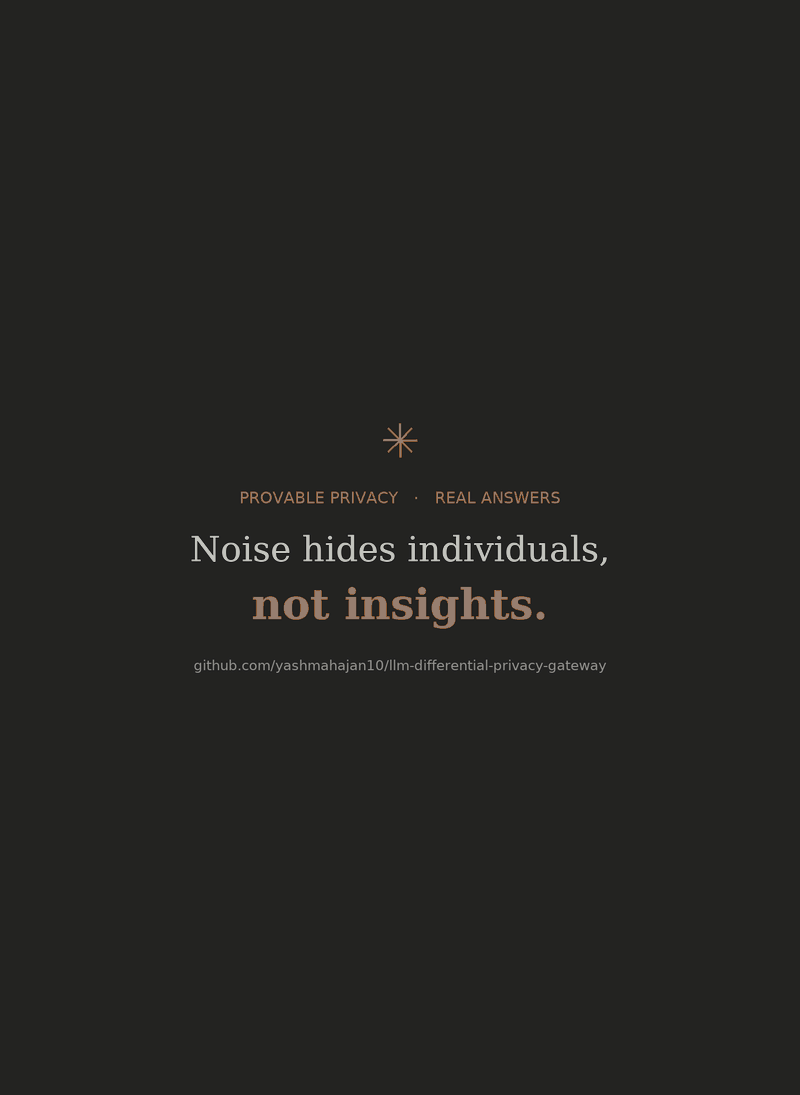
記録されたClaude Desktopセッション(返信は省略、チャートカードはセッション自身のもの)。AIエージェントは20人の患者を診断別に分類しようとするが、±12のノイズがすべてのビンを圧倒する。ノイズをオフにできないことを告げられると、3回答分の予算を使い切り、ゲートはより静かな回答ではなく拒否を返す。32,561行の国勢調査では、狭すぎるスライスは信頼境界で拒否される一方、教育に関する完全な内訳はスケールに耐えてクリーンに返ってくる。この拒否と却下は、稼働中のゲートウェイによる実際の強制であり、python scripts/render_demo_gif.py によって再現される。
機微なデータセットについて平易な英語で質問する。LLMが各質問を小さく制約されたクエリにコンパイルする。差分プライバシーエンジンが、追跡されたプライバシー予算の下でそれを実行し、明示された信頼区間とともに意図的にノイズを含む回答を返す。同名のオーディオ機器と同様に、このゲートウェイは設定されたしきい値以下のあらゆる信号をノイズフロアの下に保つ:任意の個人の寄与はかき消され、データセット全体のスケールの信号はほぼそのまま通過する。
興味深いのは、LLMがクエリを書けることではない。プライバシー保証がLLMの信頼性に依存しないことである。モデルはクエリを提案する便利な存在にすぎない。何も強制しない。すべてのプライバシー特性は下流で、人間が手でクエリを入力した場合と同じように振る舞うコンポーネントによって強制される。これは、本番システムにおけるあらゆる信頼できない入力に適用する信頼境界の規律を、ここではAIエージェントに適用したものである。
攻撃ギャラリーは実際のDPエンジンに対してインプロセスで実行される:```bash pip install -e . python -m attacks.patients_alice # re-identify Alice with privacy off, then watch # the guard, the noise, and the budget defeat it
### 2. AIエージェントを接続する

ゲートウェイはClaude Desktop用のMCP stdioサーバーとして動作します。エージェントは信頼できないクエリ作成者となり、引数スキーマがデータセットポリシーから生成される構造化ツール(`count`、`sum`、`average`、`histogram`、`get_budget`)のみを利用できます。接続するエージェント自体が知能であるため、APIキーはどこにも必要ありません。

**[セットアップと完全なウォークスルー →](https://github.com/yashmahajan10/llm-differential-privacy-gateway/blob/main/docs/CLAUDE_DESKTOP.md)**

### 3. 完全な自然言語UI

ローカルのシングルテナントデモです。APIキーは信頼できないNL→クエリコンパイラにのみ必要です:```bash
export ANTHROPIC_API_KEY=...   # used only by the untrusted NL→query compiler
docker compose up              # brings up the engine, API, and UI
# open http://localhost:8501
その HTTP + Streamlit サーフェスはローカル、シングルテナントのデモです。アイデンティティは偽装可能な X-Identity ヘッダーから取得されるため、公開デプロイではなく、自身のマシン上の信頼された単一のオペレーターを対象としています(これらのサーフェスが何であり、何でないかを参照)。ローカルの非 Docker セットアップ、テストの実行、および設定項目については、SETUP.md を参照してください。
誰でもプライバシーを主張できます。このリポジトリは、その主張を打ち破るであろうエクスプロイトを同梱し、自身のエンジンに対してそれらを実行し、その結果を CI で固定します。ゲートウェイが何を保証するかを理解する最速の方法は、素朴な「データベースへのクエリ」システムを破壊する3つの古典的な攻撃を、ゲートウェイが打ち負かす様子を観察することです。
差分攻撃は、ちょうどその人物だけが異なる2つの集計クエリを尋ねることで、一人の人物を特定します。``` Query A: "Total income of all 100 people in department X." → $7,240,000 Query B: "Total income of all people in department X except Alice." → $7,135,000 Attacker computes: A − B = $105,000 ← Alice's exact salary, leaked.
どちらのクエリも「単なる集計値」である。どちらも単一の行を名指ししていない。それでも、両者を組み合わせることで個人が露呈する。ギャラリー(`attacks/differencing.py`)は、この攻撃が**プライバシー無効時に成功する**ことを示している。ターゲットのプライベート値が正確に復元されるのだ。(上記の給与の例は説明用であり、実際の UCI Adult データでは、「Alice」は彼女のグループの最大 capital gain の唯一の保持者である。)続いて、同じ攻撃が**DP を有効にすると阻止される**ことも示す。各回答に加えられた校正済みノイズによって引き算が無意味になり、予算会計担当は*両方*のクエリにわたって放出された情報に対して課金し、それらを独立したものとして扱わない。
### 攻撃 2: メンバーシップ推論
メンバーシップ推論攻撃は、*特定の個人*がデータセットに含まれているかどうかを判定する。多くのデータセット(医療研究、債務不履行者のリストなど)にとって、その事実自体が機微である。クエリアクセスしか持たない攻撃者は、「この人物がデータに含まれているか?」を判断しようとする。
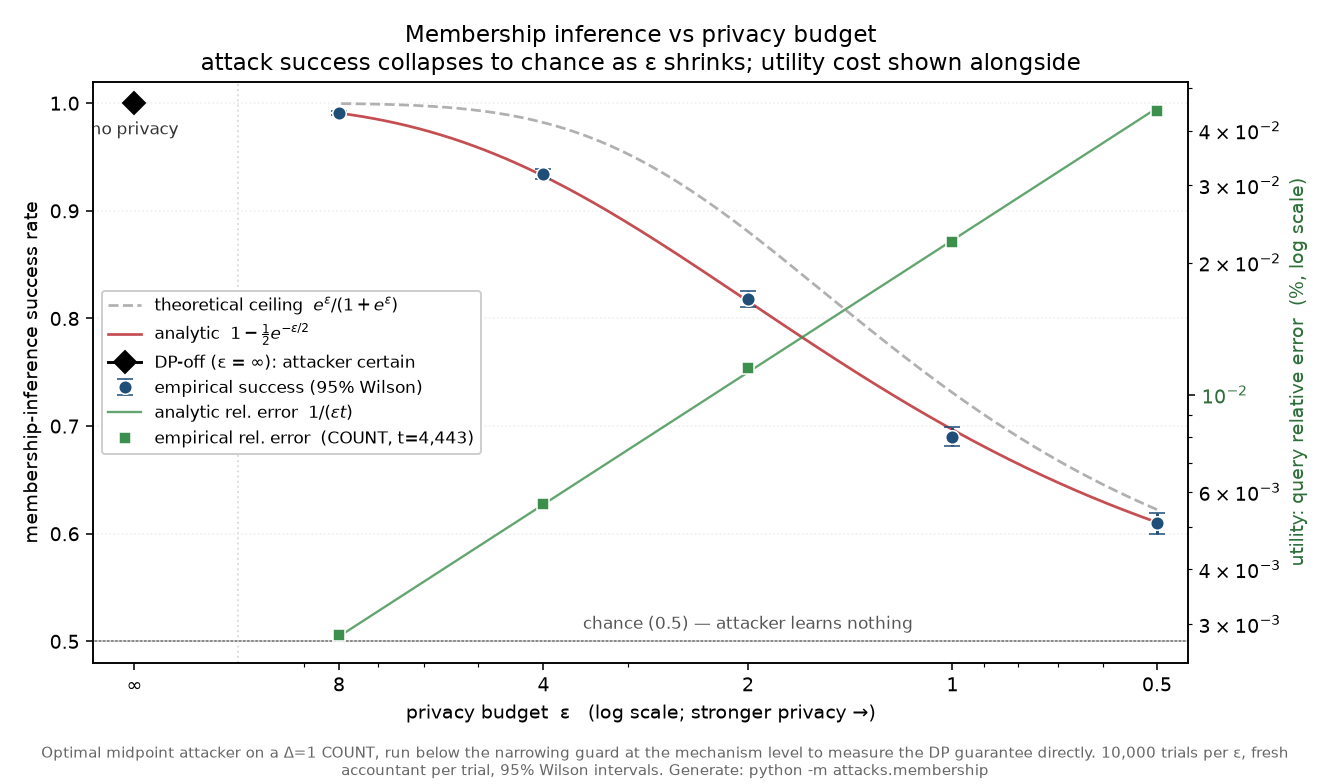
ギャラリーは、プライバシー予算(ε、回答精度とプライバシーをトレードオフするダイヤル)のスイープにわたってこの攻撃を実行し、結果をプロットする:
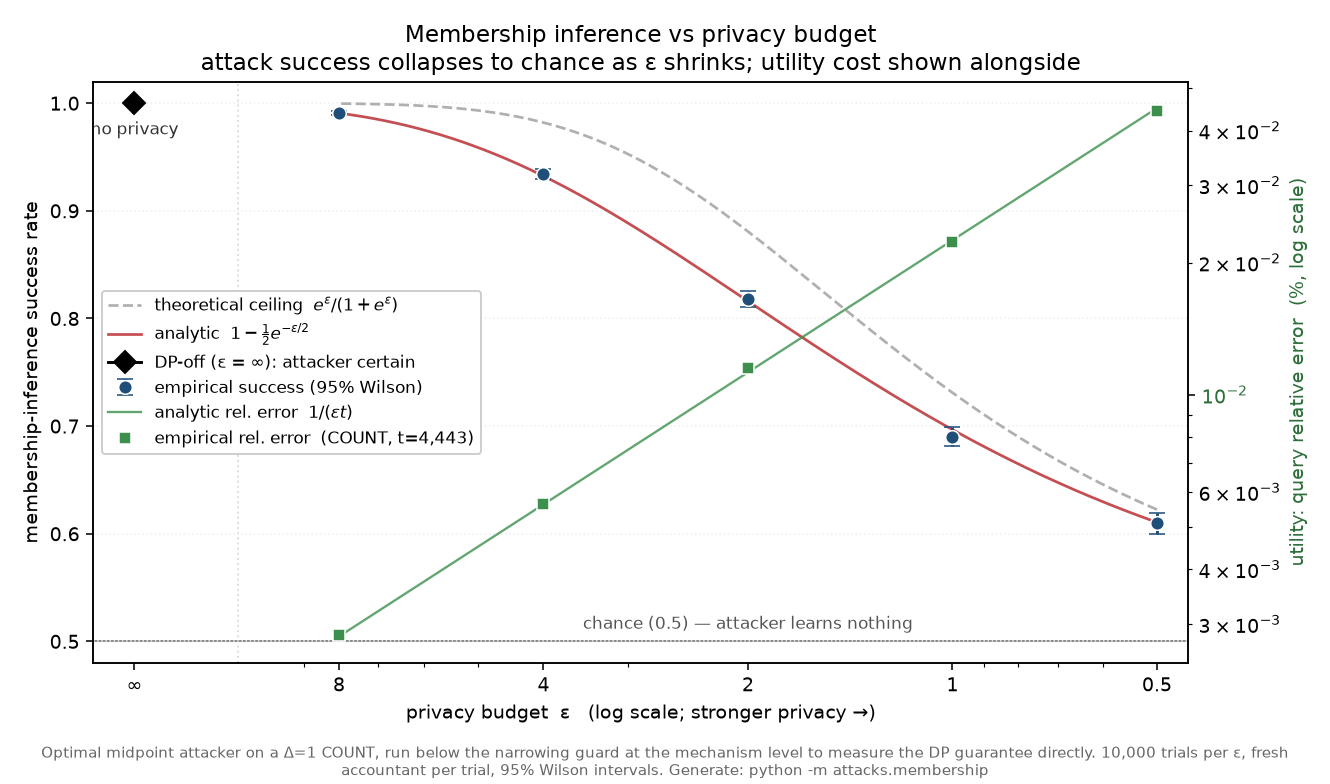
<sub>単一のノイズ付き `COUNT` からある人物のメンバーシップを判定する**最適**(Neyman–Pearson)攻撃者を、実エンジンに対して ε にわたって実行したもの。実測成功率(青、95% Wilson 区間)は解析的な Laplace 曲線に沿い、最悪ケースの DP 上限(破線)を下回り続ける。ε が縮小するにつれて、確実性(DP オフ)から 0.5 のコイントスへと崩壊していく。緑の**ユーティリティ曲線**(右軸)は、同じスイープにわたる集計クエリの相対誤差を示しており、攻撃が阻止される領域ではほとんど影響を受けていない。`python -m attacks.membership` によって生成(ε あたり 10,000 試行)。</sub>
ε が縮小する(プライバシーが強くなる)につれて、攻撃者の成功率はコイントスへと崩壊する。ユーティリティのオーバーレイは、支払われる代償を示している。1 人への攻撃を阻止するのと同じノイズが、母集団規模の集計値にはほとんど影響を与えないのだ。プライバシーは無料ではなく、このチャートはそのために何を犠牲にするかを正確に示している。スイープは ε = 8 から 0.5 まで全域をカバーしている。バンドルされたデプロイメントは**クエリあたり ε = 0.05** を課金し、これはこのチャートの左端の外側にあり、そこでは単一クエリ攻撃はすでに偶然と区別がつかない。
### 攻撃 3: 再識別による特定
Latanya Sweeney は 2002 年に、ZIP コード + 生年月日 + 性別がアメリカ人の約 87% を一意に特定することを示した(より新しい国勢調査データでの後続の再現では 63% に近かった)。データセット内で誰かを見つけるのにその人の名前は必要ない。いくつかの無害な属性で十分である。ギャラリーの 3 番目の攻撃(`attacks/patients_alice.py`)は、20 人の合成患者に対してこの構造を再現する。性別と年齢だけでコホートはちょうど 1 人、Alice、すなわち 64 歳超の唯一の女性に絞り込まれる。
プライバシー無効時、完全にありふれた 2 つの人口統計ヒストグラムを引き算することで、Alice の診断が正確に復元される。外れ値は必要ない。*再識別可能*であるだけで十分であり、これがこの攻撃をギャラリーの中で最強のものにしている。プライバシー有効時には、3 つの独立した防御がこれを終わらせる。フィルタガードは明白な絞り込みクエリを即座に拒否し(何も消費しない)、校正済みノイズは 2 クエリの引き算をかき消し(信号対雑音比 ≈ 0.13、つまり復元された「診断」は本質的にランダムな抽選である)、予算は平均化によるエスカレーションが機能しうるずっと前にそれを拒否する(約 256 回の繰り返しが必要、支払えるのは 10 回)。これは、このページ冒頭のデモ GIF と [Claude Desktop ウォークスルー](https://github.com/yashmahajan10/llm-differential-privacy-gateway/blob/main/docs/CLAUDE_DESKTOP.md) がライブで再現する攻撃である。結果は `tests/test_attack_patients.py` で回帰テストされている。
これらの実験は、システム自身のエンジンに対して実行され、保証が本物であり理解されていること、すなわちライブラリから輸入されて鵜呑みにされたものではないことの核心的な証拠である。
### OpenDP とのクロスチェック
攻撃は*私たち自身の*数学に対して保証を検証する。自己整合的だが誤った実装を防ぐため、メカニズムは独立した参照として [OpenDP](https://opendp.org/) ともクロスチェックされる(`attacks/crosscheck_opendp.py`、opendp 0.15.1)。
**要するに、ゼロから構築したメカニズムが業界標準の参照と小数点以下 9 桁まで一致し、意図的に誤校正されたバージョンは同じテストに失敗する。つまり、この一致には意味がある。** 一致は 2 通りに検証される。感度とノイズスケールを OpenDP の認定されたバウンドと比較し、サンプラーの実際の分布を OpenDP のものと比較する。さらに、テストが失敗しうることを証明するポジティブコントロールも含む。測定値は [`DESIGN.md`](https://github.com/yashmahajan10/llm-differential-privacy-gateway/blob/main/DESIGN.md) のセクション 6.3 にある。
OpenDP は参照であり、決して実装ではない。dev extras にのみ存在し、実行中のシステムはそれをインポートしない。スケールの一致は `tests/test_crosscheck_opendp.py` で回帰テストされている(ローカルで OpenDP がない場合はスキップされる。CI はそれをインストールし `REQUIRE_OPENDP=1` を設定するので、そこでチェックが黙ってスキップされることは決してない)。
### 再現する
攻撃は実 DP エンジンに対してインプロセスで実行される。API キーもサーバーも不要である。LLM コンパイラを経由せず、手書きの AST を構築するからだ:```bash
python -m attacks.patients_alice # Attack 3: re-identify Alice and recover her diagnosis
# with DP off; watch guard + noise + budget
# defeat the same attack (no data fetch needed)
python scripts/fetch_data.py # fetch UCI Adult into data/ (gitignored; ~4 MB)
python -m attacks.differencing # Attack 1: recover Alice exactly with DP off, then watch
# noise + budget defeat the same subtraction
python -m attacks.membership # Attack 2: sweep ε and regenerate the chart above

