 xoreaxeaxeax/skitter-creek-bath-salts
CPU 上で DRAM スクランブリングを使って _すべて_ を解き放つ

DRAMスクランブリングでCPU上のすべてを解錠する — PSP、C6、マイクロコード、 SMM、そして仕様書が省いたその他すべて。
&x == &x。
通常は。
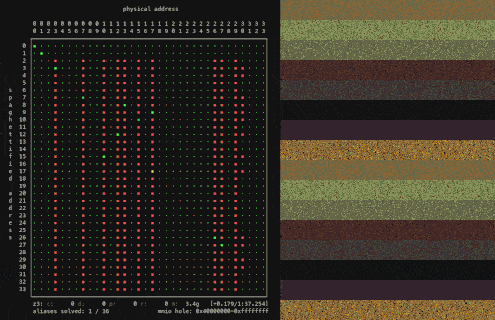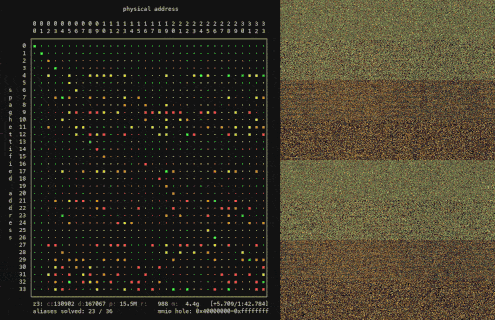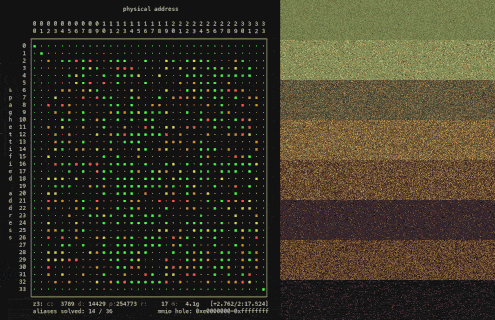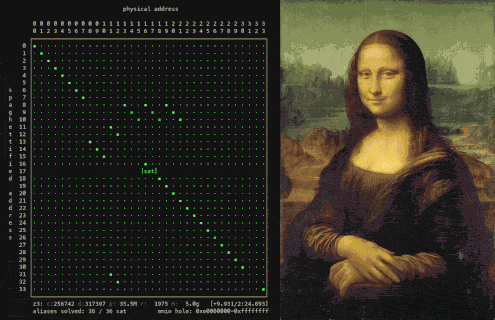
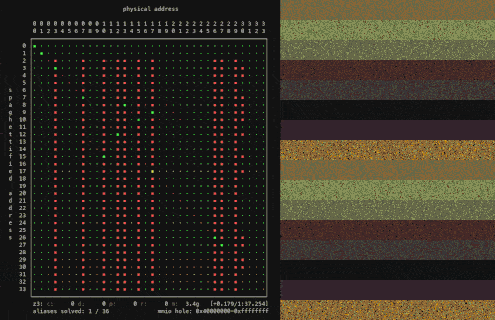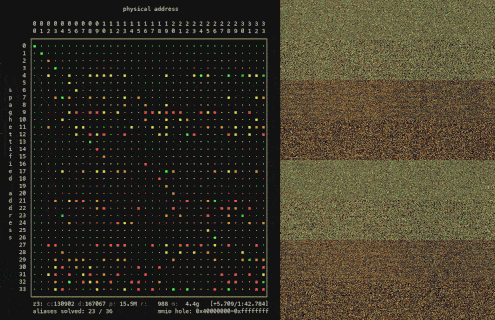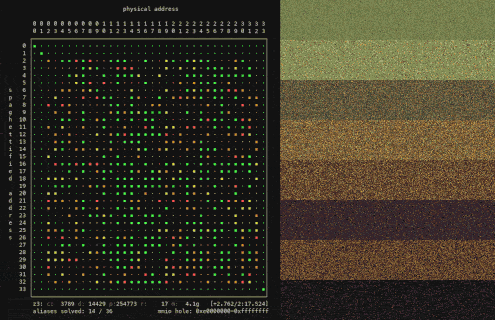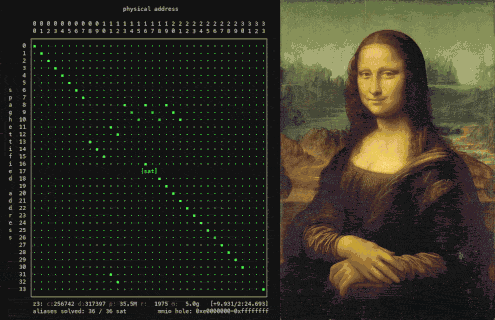
DRAMコントローラをいじれば、アドレスをメモリ内の好きな場所に着地させることができる。skitter-creek-bath-saltsはメモリ階層の最下層を改変し、物理DRAMアドレス変換を再配線する。これによりプラットフォームメモリがスクランブルされ、DRAMの保護領域 — カーネルにさえ見えないカーブアウト — が露出する。アドレス変換が壊れるとき、その上に築かれたセキュリティプリミティブも壊れ、我々はすべてを解錠する。
AMD Family 16h CPUで開発・テスト済み。これはデータシートがDRAMコントローラの変換レジスタを文書化した最後の世代であり、それらがロックできないことを示している。17h以降は単にこの情報を省いている。*pの長い旅路は世代やアーキテクチャを超えて類似しており、その根底にある変換はARM、RISC-V、さらにはその先にまで及ぶ。skitter-creek-bath-saltsは我々に始め方だけを示す。
*pの長い旅路下りは長い道のりだ。
メモリは、ほとんど不条理に思えるほど深い抽象化の層の上に築かれている。あなたのコードが*pをデリファレンスすると、pのDRAMにアクセスしているように見える。そうではない — pは仮想アドレスであり、DRAMの1ビットに触れる前に、以下の試練を生き延びなければならない:```
── CPU core / MMU ─────────────────────────────────────────────────
┌─ VA ← 64-bit virtual address from load/store
│
└> canonical-form check ──────────────────────┐ ← bits [63:48] sign-extend from bit 47
┌─ segment base add <─────────────────────────┘ ← FS.base / GS.base (MSR_FS_BASE, MSR_GS_BASE)
│
└> TLB probe ─────────────────────────────────┐ ← tagged by PCID (host) / VPID (guest)
hit → physical address k │
miss → engage hardware page walker │
┌─ page walk (from CR3) <─────────────────────┘ ← walked only on TLB miss
│ PML5[VA 56:48] ← only if CR4.LA57
│ PML4[VA 47:39]
│ PDPT[VA 38:30] ← 1 GiB leaf possible
│ PD [VA 29:21] ← 2 MiB leaf possible
│ PT [VA 20:12]
│ PTE ← R/W · U/S · NX · A/D · PAT · PCD · PWT · G
│
└> per-level checks ──────────────────────────┐ ← evaluated at every level of the walk
privilege (U/S) │ ← CPL vs PTE.U/S
write (R/W) │ ← + CR0.WP
execute (NX) │ ← EFER.NXE
SMEP / SMAP │ ← CR4.SMEP · CR4.SMAP · EFLAGS.AC
protection keys │ ← PKRU (user) · IA32_PKRS (supervisor)
┌─ A/D bit update <───────────────────────────┘ ← locked RMW on PTE
│
└> if guest: EPT / NPT re-walk ───────────────┐ ← each guest-PA above re-walked
EPT-PML4 → EPT-PDPT → EPT-PD → EPT-PT │ ← + EPT memory-type override
⇒ ~5× walks per single guest walk │
┌─ TLB shootdown IPIs <───────────────────────┘ ← invlpg broadcast to peer vCPUs
│
│ ── IOMMU (chipset / I/O fabric) ──────────────────────────────────
│
└> if device-initiated, IOMMU page walk ──────┐ ← VT-d / AMD-Vi: device-ID → domain → tables
│
┌── physical address k <─────────────────┘
│
│ ── CPU core / MMU — memory-type resolution ────────────────────────
│
└> MTRR range match ──────────────────────────┐ ← IA32_MTRR_DEF_TYPE + fixed/variable MTRRs
┌─ PAT entry select <─────────────────────────┘ ← IA32_PAT[ PTE.PAT:PCD:PWT ]
│
└> effective memory type ─────────────────────┐ ← { WB, WT, WC, WP, UC-, UC }
│
── CPU uncore — caches & coherence ────────────────────────────────
│
┌─ L1-D probe <───────────────────────────────┘ ← VIPT, per-core
│
└> L2 probe ──────────────────────────────────┐ ← per-core / per-CCX
┌─ LLC probe + directory consult <────────────┘ ← shared, sliced
│
└> snoop / coherence ─────────────────────────┐ ← MESI / MOESI broadcast
intra-socket │ ← broadcast to peer cores
inter-socket │ ← QPI · UPI · Infinity Fabric · CXL.cache
home-node directory response │ ← data | intervention | abort
│
── system data fabric / interconnect ──────────────────────────────
│
┌─ if MMIO range or sub-4 GiB MMIO hole <─────┘ ← uncore/data fabric posted/non-posted txn
│ → device BAR; done
│
└> else DRAM-bound: data fabric / mesh ───────┐ ← AMD DF · Intel mesh-or-ring uncore
│
┏━━ ── MCT / IMC (memory controller) ────────────────────────────────
W ┃ ┌─ DRAM hole remap <──────────────────────────┘ ← high-memory remap above TOM
E ┃ │
┃ └> memory-region exclusion remap ─────────────┐ ← reserved / protected ranges
┃ ┌─ channel interleave hash <──────────────────┘ ← XOR of selected PA bits → channel
A ┃ │
R ┃ └> rank interleave hash ──────────────────────┐ ← XOR of selected PA bits → rank
E ┃ ┌─ bank interleave hash <─────────────────────┘ ← XOR of selected PA bits → bank
┃ │
┃ └> bank swizzle / XOR scramble ───────────────┐ ← vendor- and BIOS-configurable
H ┃ ┌─ chip-select normalize (DCT) <──────────────┘ ← per-rank CS line
E ┃ │ rank → CS map
R ┃ │
E ┃ └> sub-channel select ────────────────────────┐ ← DDR5 / LPDDR5 only
┗━━ │
│
DRAM coordinates <─────────────────────────┘ ← bank group · bank · row (RAS) · column (CAS)
このプロジェクトは `*p` パイプラインの最も深いレベル、MCT/DCT レイヤーで動作します
— そこでは、データファブリック/インターコネクトからの物理アドレスがメモリ
コントローラに入り、DIMM に発行される生の DRAM 座標へと
最後にもう一度書き換えられます。

---

## DRAM のスパゲッティ化

> 物理アドレスは、実際にはほとんど提案にすぎない。```nasm
xor dword [0xf80c2094], 0x00400000
それがエクスプロイトのすべてだ。
DRAMコントローラ内の1ビットのビットフリップが *p パイプラインの底を配線し直し、&x にあったデータはフライト中にどこか別の場所へ移る。突然 &x != &x になる。CPU、ファームウェア、uncore、チップセットが保護メモリを隔離するために使うあらゆる機構はメモリコントローラの上に位置しており、その下で何が起きているかは誰も見ていない。フェンスが守るのは物理アドレスであり、DRAM座標ではない。座標を並べ替えれば、上位のバリアは決して気づかない。
しかしDRAMの配線を変えるのは簡単だ。上のビットはDCTのbank-swizzle-modeであり、最終層でアドレスリマップを制御する数十のうちの一つにすぎない——それらをつつけば、その上に構築されたすべてが崩れ落ちる。難しいのはそのあと、システムメモリ全体がその下でスクランブルされる中でプラットフォームを動かし続けることだ。
