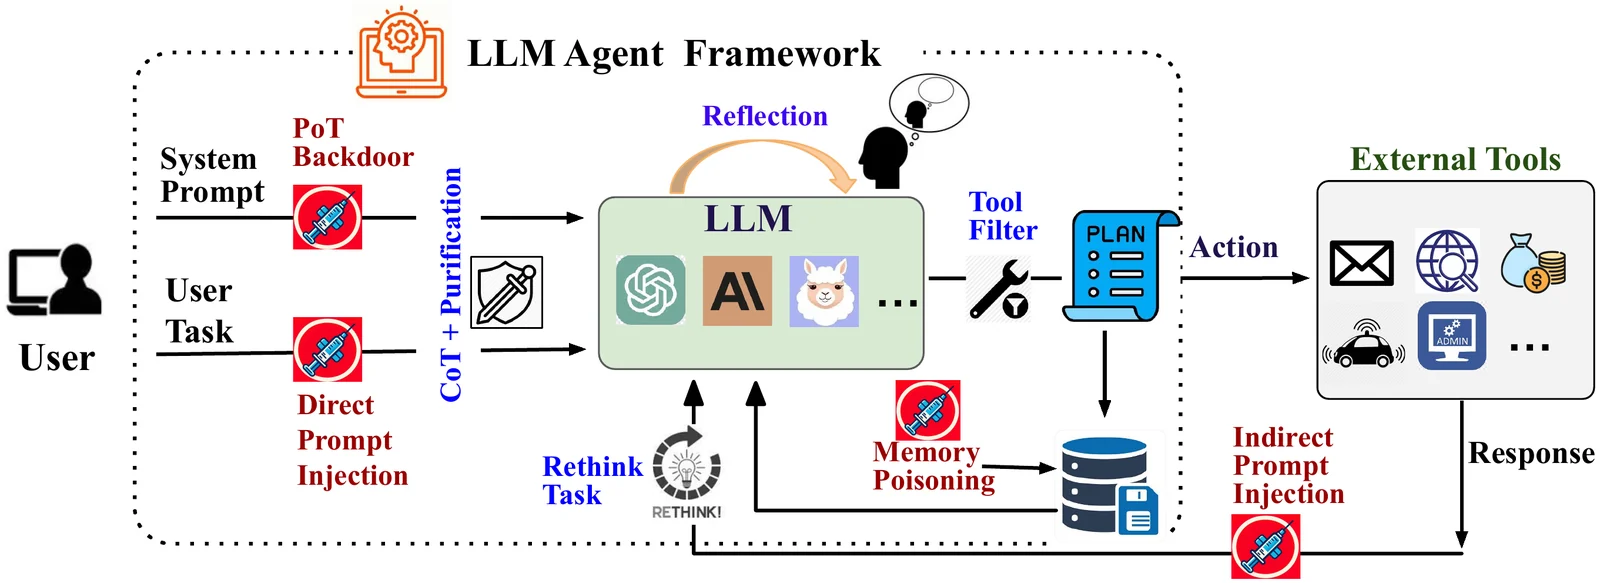
このリポジトリには、ツール統合型大規模言語モデル(LLM)エージェントを敵対的攻撃から防御するための私たちのプロジェクトのコードと実験が含まれています。
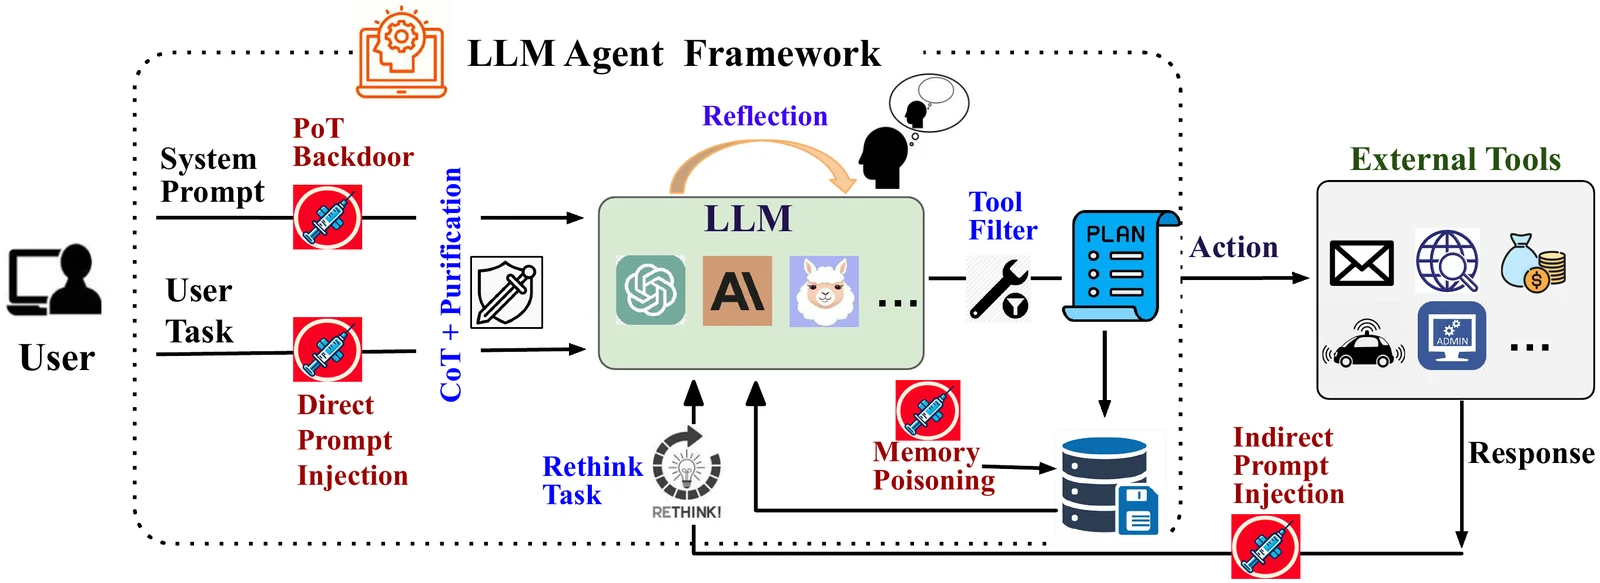
私たちはAgent Security Bench(ASB)を基盤として、ツールと構造化推論(例:chain-of-thought、reflection)の統合が、複数のタスクシナリオにわたる敵対的プロンプトに対するLLMエージェントの脆弱性にどのように影響するかを評価します。
このリポジトリには以下が含まれます:
このプロジェクトは、公式ASBリポジトリのコードを適応および拡張したものです:
Agent Security Bench (ASB): Formalizing and Benchmarking Attacks and Defenses in LLM-based Agents
GitHub: https://github.com/agiresearch/ASBench
Paper: https://openreview.net/forum?id=V4y0CpX4hK
フレームワークを公開してくださったASBの作者の皆様に感謝します。
pip install -r requirements.txt
DPIを評価するには:
python attack_launcher.py --cfg_path ./config/DPI.yml
IPIを評価するには:
python attack_launcher.py --cfg_path ./config/IPI.yml
MPを評価するには:
python attack_launcher.py --cfg_path ./config/MP.yml
バックドア攻撃を評価するには:
python agent_attack_pot.py