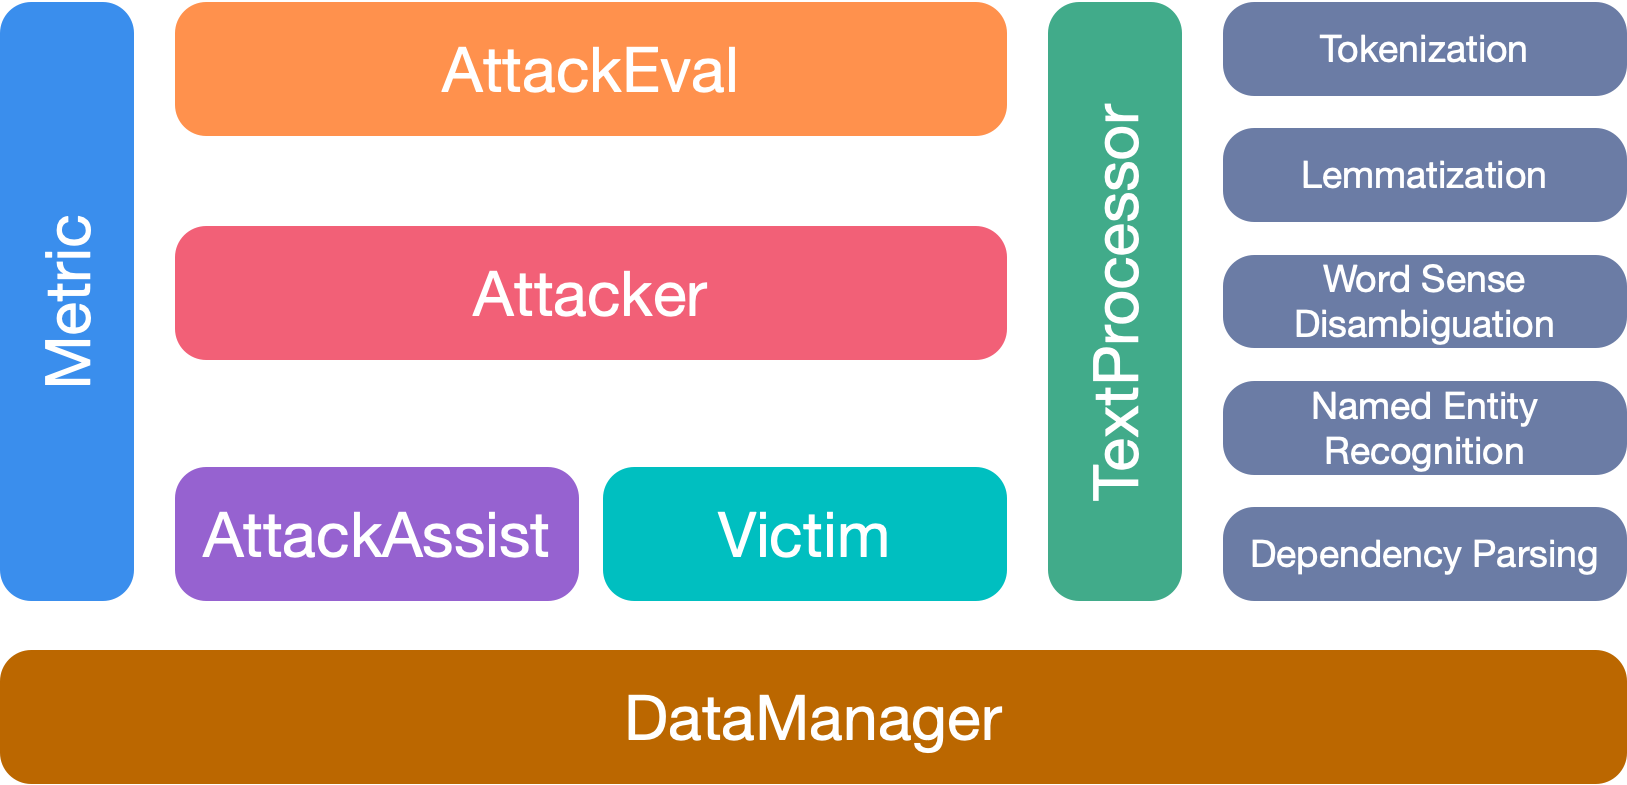
ドキュメント • 機能と用途 • 使用例 • 攻撃モデル • ツールキット設計
OpenAttack は、オープンソースの Python ベースのテキスト対向攻撃ツールキットであり、テキストの前処理、被害者モデルへのアクセス、対向例の生成、評価を含むテキスト対向攻撃の全プロセスを処理します。
⭐️ すべての攻撃タイプをサポート. OpenAttack は、文/単語/文字レベルの摂動と勾配ベース/スコアベース/判断ベース/ブラインド攻撃モデルを含むすべてのタイプの攻撃をサポートします;
⭐️ 多言語対応. OpenAttack は現在英語と中国語をサポートしています。拡張可能な設計により、より多くの言語への迅速な対応が可能です;
⭐️ 並列処理. OpenAttack は攻撃モデルのマルチプロセス実行をサポートし、攻撃効率を向上させます;
⭐️ 🤗 Hugging Face との互換性. OpenAttack は 🤗 Transformers および Datasets ライブラリと完全に統合されています;
⭐️ 優れた拡張性. カスタマイズした 被害者モデル を任意のカスタマイズした データセット で容易に攻撃したり、カスタマイズした 攻撃モデル を開発および評価したりできます。
✅ 攻撃モデルのための多様で便利な ベースライン を提供;
✅ 徹底的な評価指標を用いて攻撃モデルを包括的に 評価;
✅ 共通の攻撃コンポーネントの助けを借りて、新しい攻撃モデル の迅速な開発を支援;
✅ 様々な対向攻撃に対する機械学習モデルの ロバスト性 を評価;
✅ 生成された対向例でトレーニングデータを強化することで、機械学習モデルのロバスト性を向上させる 対向訓練 を実施。
pip を使用する (推奨)```bashpip install OpenAttack
#### 2. このリポジトリのクローン```bash
git clone https://github.com/thunlp/OpenAttack.git
cd OpenAttack
python setup.py install
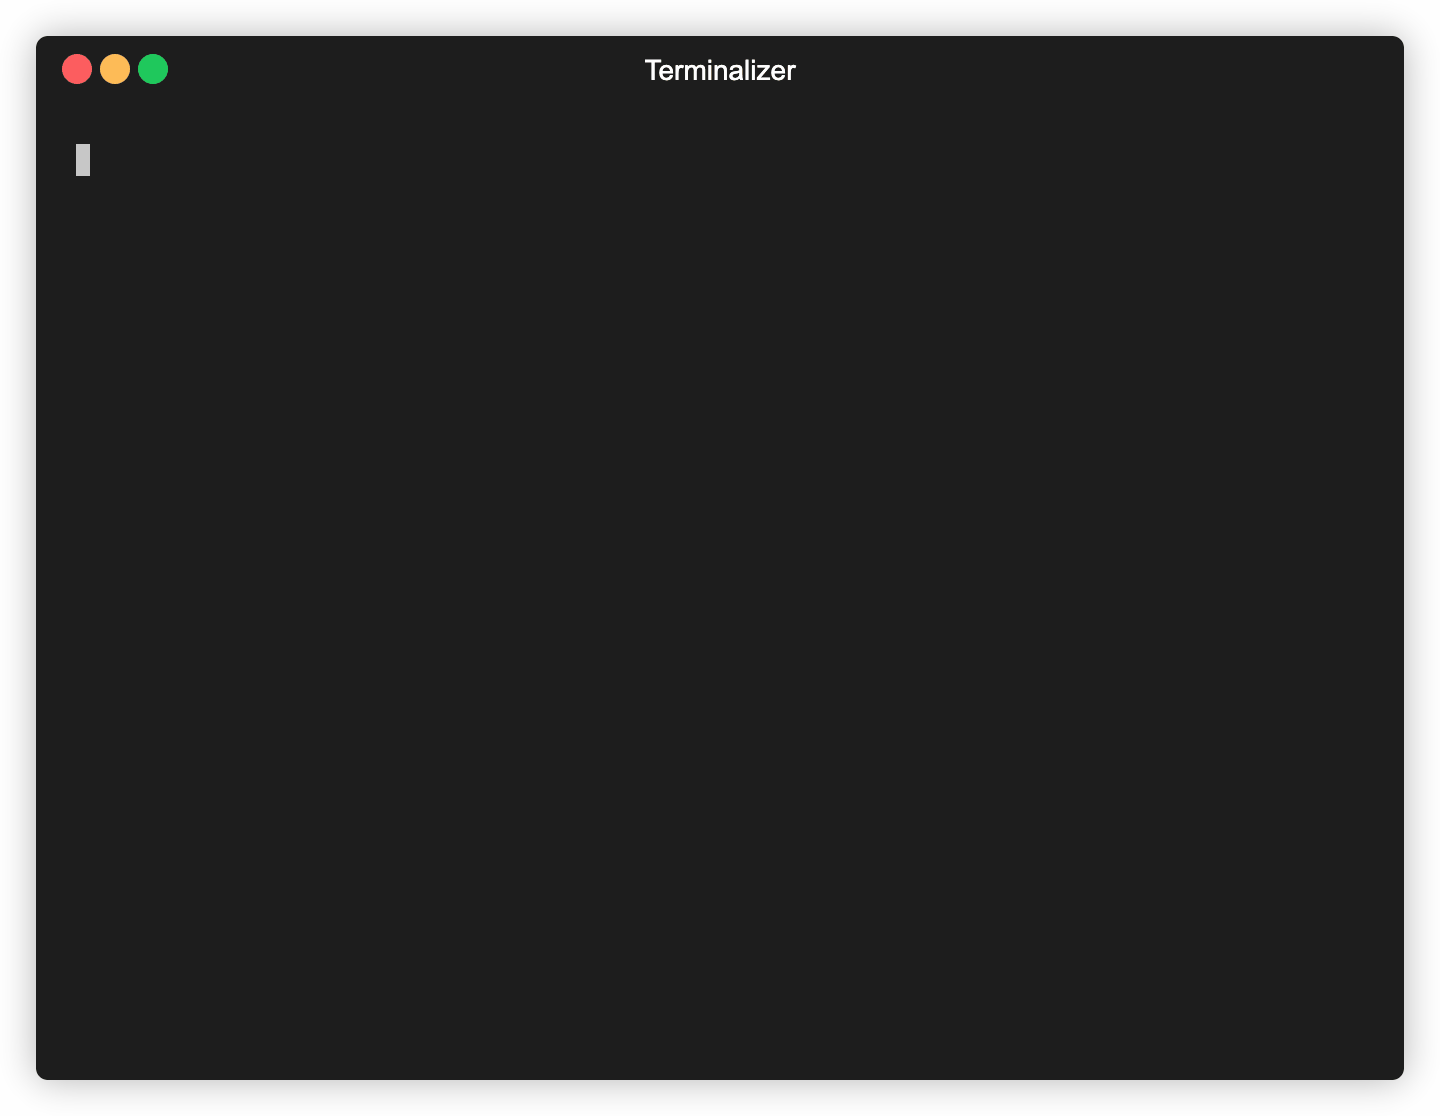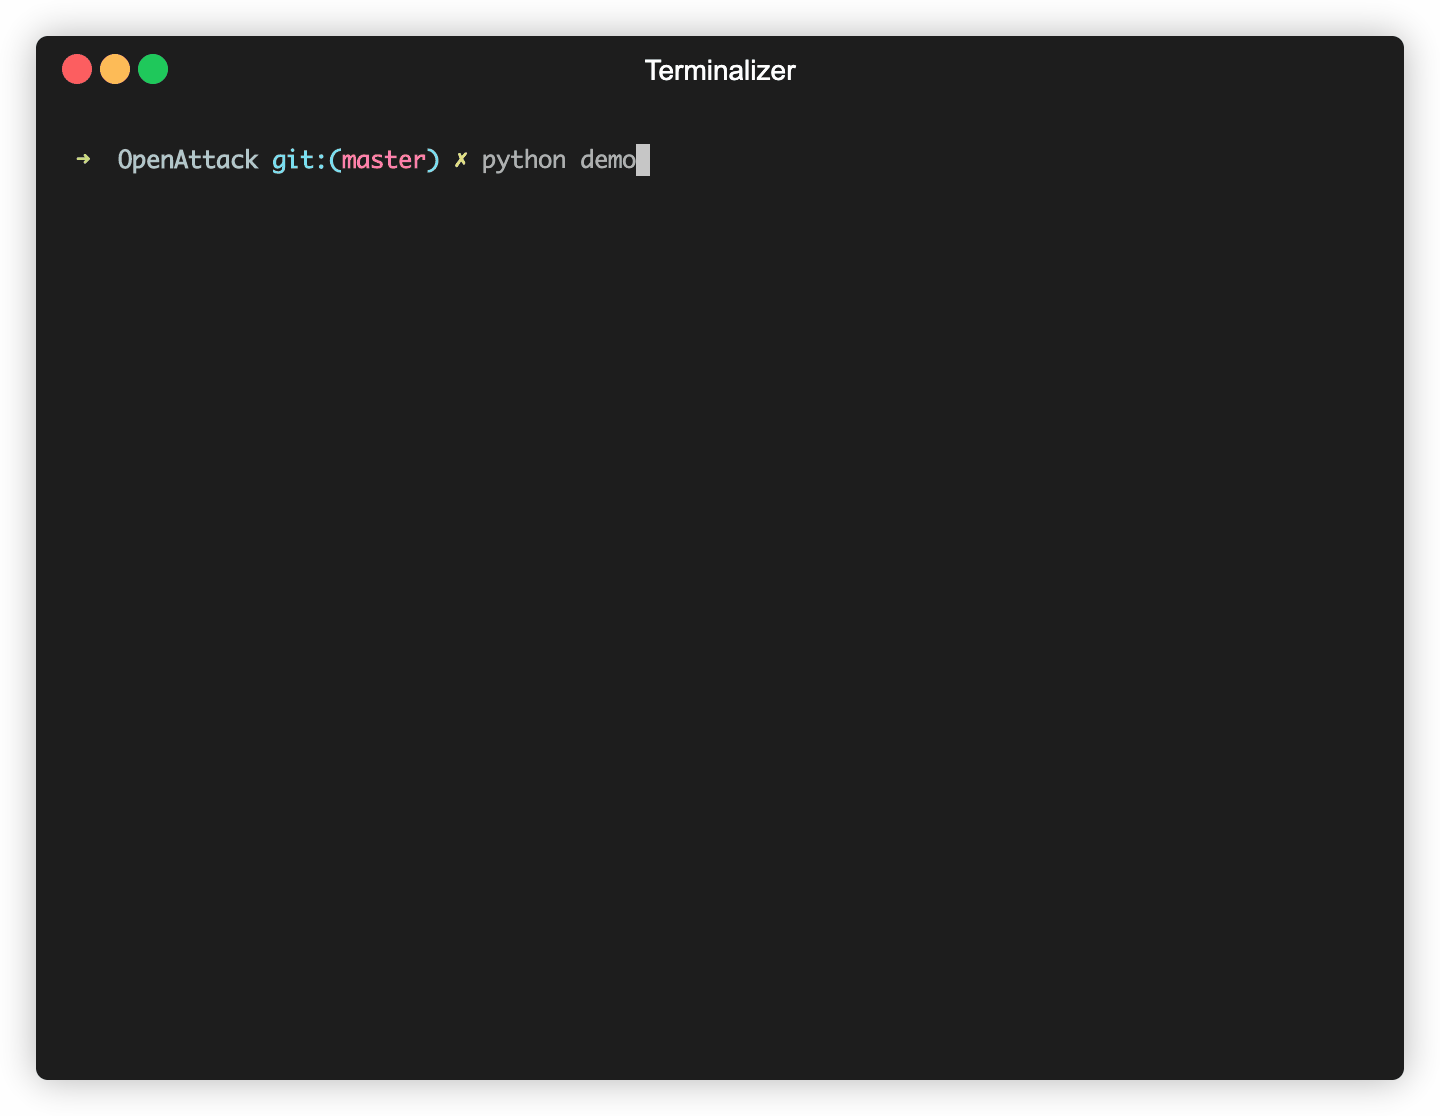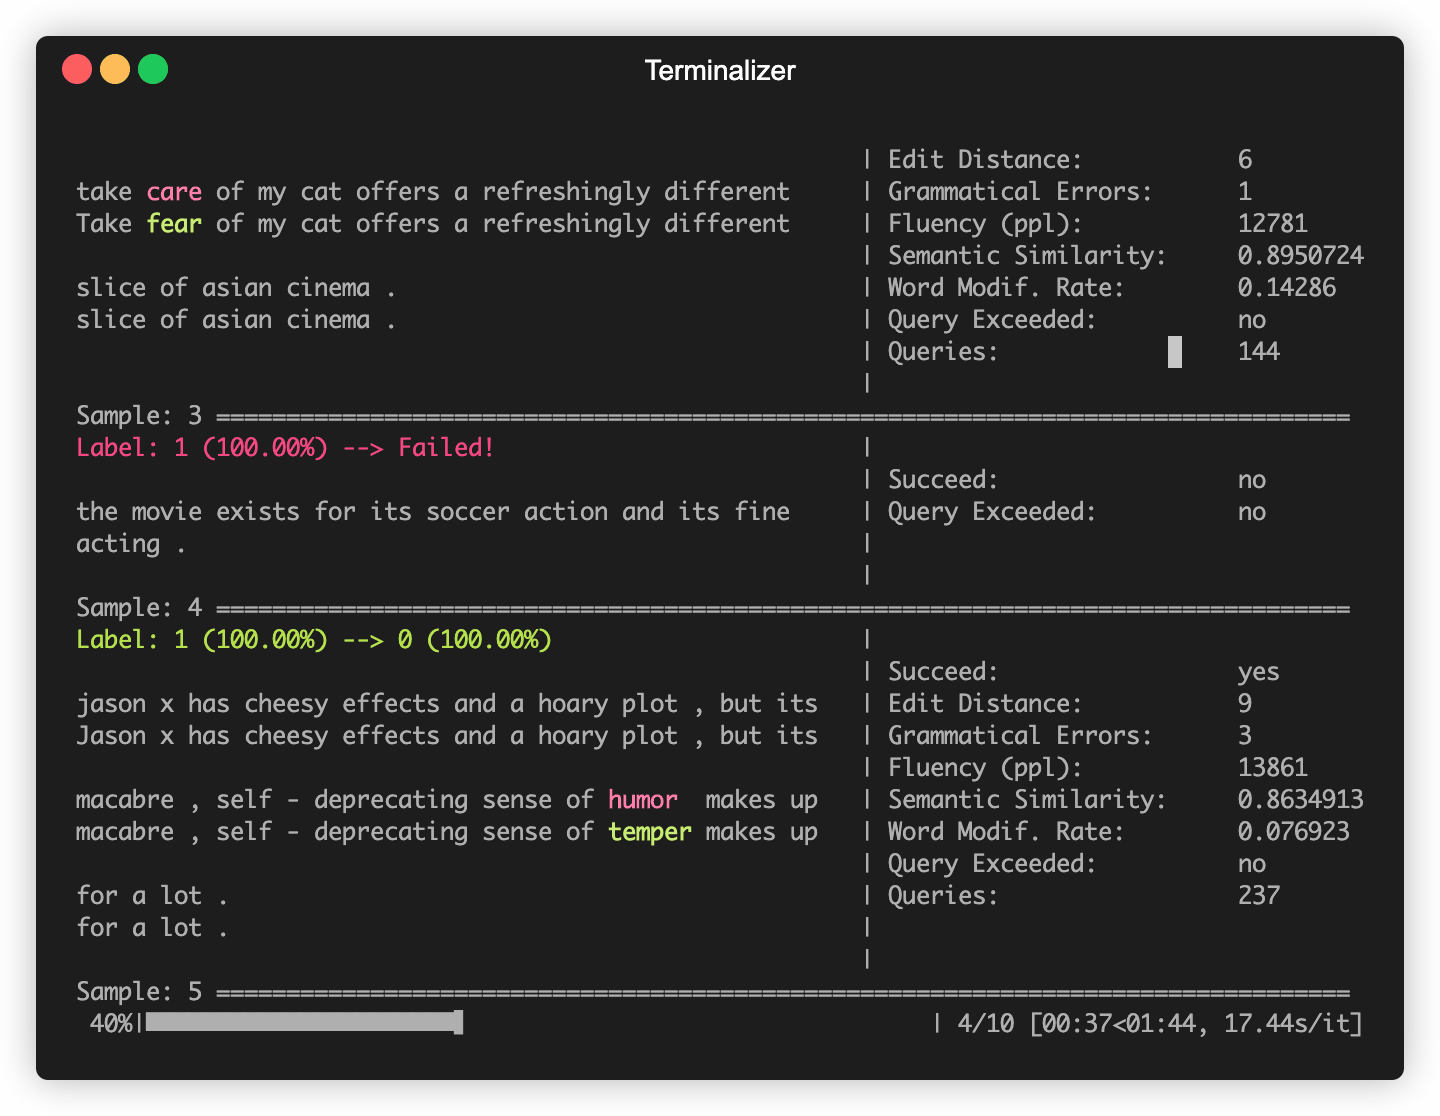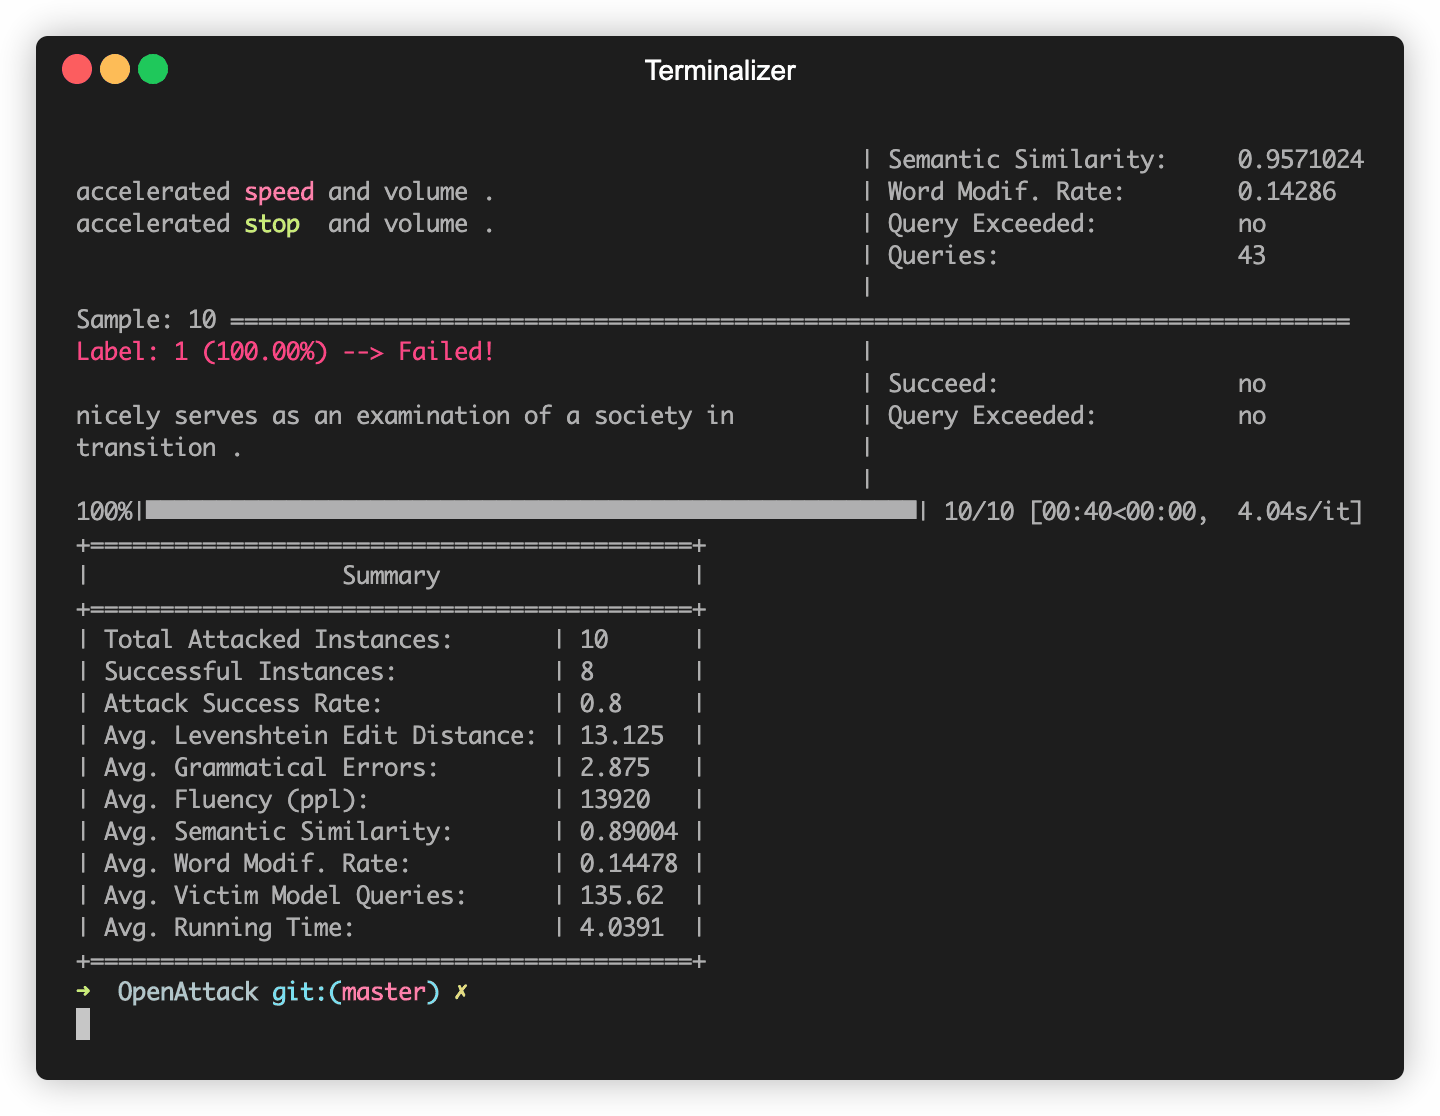
インストール後、demo.pyを実行してOpenAttackが正常に動作するか確認できます:```
python demo.py
## 使用例
#### 組み込み被害者モデルに対する攻撃
OpenAttackは、一般的に使用されるNLPモデル(BERT([Devlin et al. 2018](https://arxiv.org/abs/1810.04805))やRoBERTa([Liu et al. 2019](https://arxiv.org/abs/1907.11692))など)を組み込んでおり、これらは一般的なデータセット([SST-2](https://nlp.stanford.edu/sentiment/treebank.html)など)で微調整されています。これらの組み込み被害者モデルに対して、簡単に敵対的攻撃を実行できます。
以下のコードスニペットは、PWWS(貪欲アルゴリズムに基づく攻撃モデル、[Ren et al., 2019](https://www.aclweb.org/anthology/P19-1103.pdf))を使用して、SST-2データセット上のBERTを攻撃する方法を示しています(完全な実行可能コードは[こちら](https://github.com/thunlp/openattack/blob/master/examples/workflow.py))。```python
import OpenAttack as oa
import datasets # use the Hugging Face's datasets library
# change the SST dataset into 2-class
def dataset_mapping(x):
return {
"x": x["sentence"],
"y": 1 if x["label"] > 0.5 else 0,
}
# choose a trained victim classification model
victim = oa.DataManager.loadVictim("BERT.SST")
# choose 20 examples from SST-2 as the evaluation data
dataset = datasets.load_dataset("sst", split="train[:20]").map(function=dataset_mapping)
# choose PWWS as the attacker and initialize it with default parameters
attacker = oa.attackers.PWWSAttacker()
# prepare for attacking
attack_eval = OpenAttack.AttackEval(attacker, victim)
# launch attacks and print attack results
attack_eval.eval(dataset, visualize=True)
以下のコードスニペットは、SST-2においてPWWSを使用してカスタマイズされた感情分析モデル(NLTKで構築された統計モデル)を攻撃する方法を示しています(完全な実行可能コードはこちら)。```python import OpenAttack as oa import numpy as np import datasets import nltk from nltk.sentiment.vader import SentimentIntensityAnalyzer
class MyClassifier(oa.Classifier): def init(self): # nltk.sentiment.vader.SentimentIntensityAnalyzer is a traditional sentiment classification model. nltk.download('vader_lexicon') self.model = SentimentIntensityAnalyzer()
def get_pred(self, input_):
    return self.get_prob(input_).argmax(axis=1)

# access to the classification probability scores with respect input sentences
def get_prob(self, input_):
    ret = []
    for sent in input_:
        # SentimentIntensityAnalyzer calculates scores of “neg” and “pos” for each instance
        res = self.model.polarity_scores(sent)

        # we use 𝑠𝑜𝑐𝑟𝑒_𝑝𝑜𝑠 / (𝑠𝑐𝑜𝑟𝑒_𝑛𝑒𝑔 + 𝑠𝑐𝑜𝑟𝑒_𝑝𝑜𝑠) to represent the probability of positive sentiment
        # Adding 10^−6 is a trick to avoid dividing by zero.
        prob = (res["pos"] + 1e-6) / (res["neg"] + res["pos"] + 2e-6)

        ret.append(np.array([1 - prob, prob]))

    # The get_prob method finally returns a np.ndarray of shape (len(input_), 2). See Classifier for detail.
    return np.array(ret)
def dataset_mapping(x): return { "x": x["sentence"], "y": 1 if x["label"] > 0.5 else 0, }
dataset = datasets.load_dataset("sst", split="train[:20]").map(function=dataset_mapping)
victim = MyClassifier()
attacker = oa.attackers.PWWSAttacker()
attack_eval = oa.AttackEval(attacker, victim)
attack_eval.eval(dataset, visualize=True)
</details>


<details>
<summary><strong>カスタマイズされたデータセット</strong></summary>

以下のコードスニペットは、既存のファインチューニングされた感情分析モデルを**カスタマイズされた**データセット上で攻撃するためにPWWSを使用する方法を示しています(完全な実行可能コードは[こちら](https://github.com/thunlp/openattack/blob/master/examples/custom_dataset.py))。```python
import OpenAttack as oa
import transformers
import datasets

# load a fine-tuned sentiment analysis model from Transformers (you can also use our fine-tuned Victim.BERT.SST)
tokenizer = transformers.AutoTokenizer.from_pretrained("echarlaix/bert-base-uncased-sst2-acc91.1-d37-hybrid")
model = transformers.AutoModelForSequenceClassification.from_pretrained("echarlaix/bert-base-uncased-sst2-acc91.1-d37-hybrid", num_labels=2, output_hidden_states=False)
victim = oa.classifiers.TransformersClassifier(model, tokenizer, model.bert.embeddings.word_embeddings)

# choose PWWS as the attacker and initialize it with default parameters
attacker = oa.attackers.PWWSAttacker()

# create your customized dataset
dataset = datasets.Dataset.from_dict({
    "x": [
        "I hate this movie.",
        "I like this apple."
    ],
    "y": [
        0, # 0 for negative
        1, # 1 for positive
    ]
})

# prepare for attacking
attack_eval = oa.AttackEval(attacker, victim, metrics = [oa.metric.EditDistance(), oa.metric.ModificationRate()])
# launch attacks and print attack results
attack_eval.eval(dataset, visualize=True)
OpenAttack は、敵対的攻撃のプロセスを高速化するために便利なマルチプロセッシングをサポートしています。以下のコードスニペットは、遺伝的アルゴリズムに基づく攻撃モデルである Genetic (Alzantot et al. 2018) を用いた敵対的攻撃におけるマルチプロセッシングの使用方法を示しています(完全な実行可能コードは こちら)。```python import OpenAttack as oa import datasets