Siquan Huang1、Yijiang Li2、Xingfu Yan3,*、Ningzhi Gao1、Leyu Shi1、Ying Gao1,*
1華南理工大学 2カリフォルニア大学サンディエゴ校 3華南師範大学
*責任著者


Vision Transformer(ViT)はほとんどのマルチモーダルモデルの視覚エンコーダであり、実務者はバックドアを含む可能性のあるサードパーティの事前学習済みチェックポイントを日常的に基盤として利用しています。DetectViT は、モデルの出力や埋め込みではなくアテンションヘッドを読み取る、ViT 向けのテスト時バックドアサンプル検出器です。
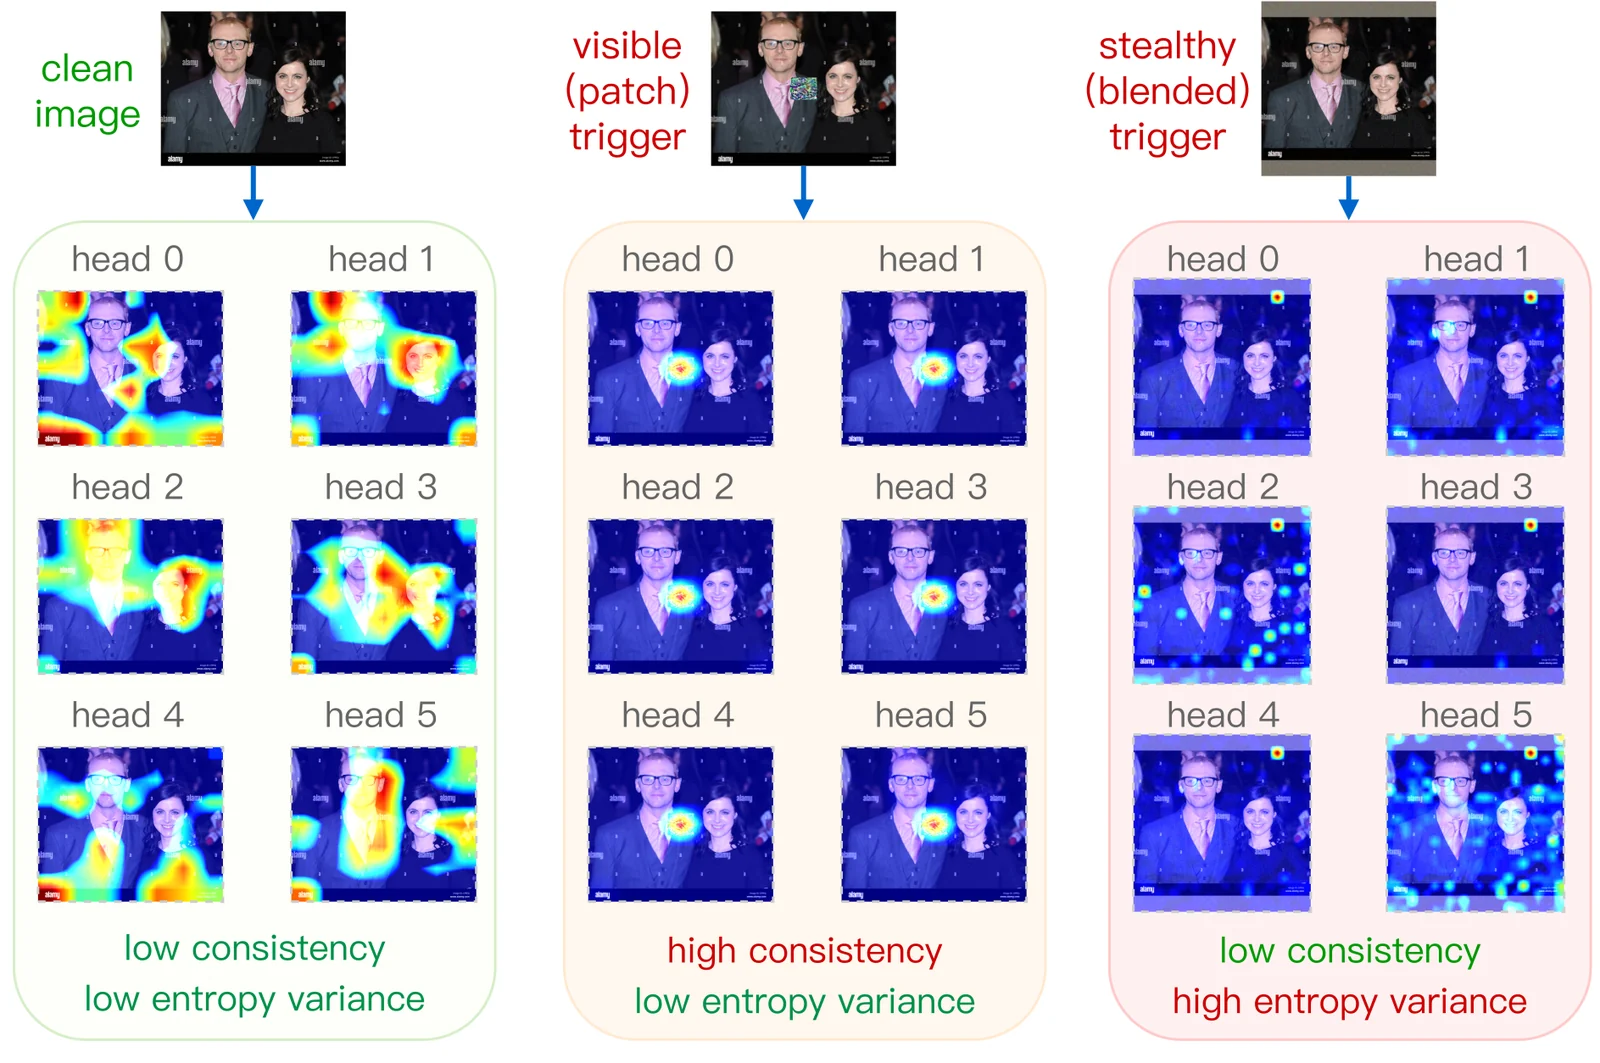
クリーンな画像では、アテンションヘッドは異なる領域に同程度の集中度で注目します。バックドアトリガーはこのバランスを2つの方法で崩します:
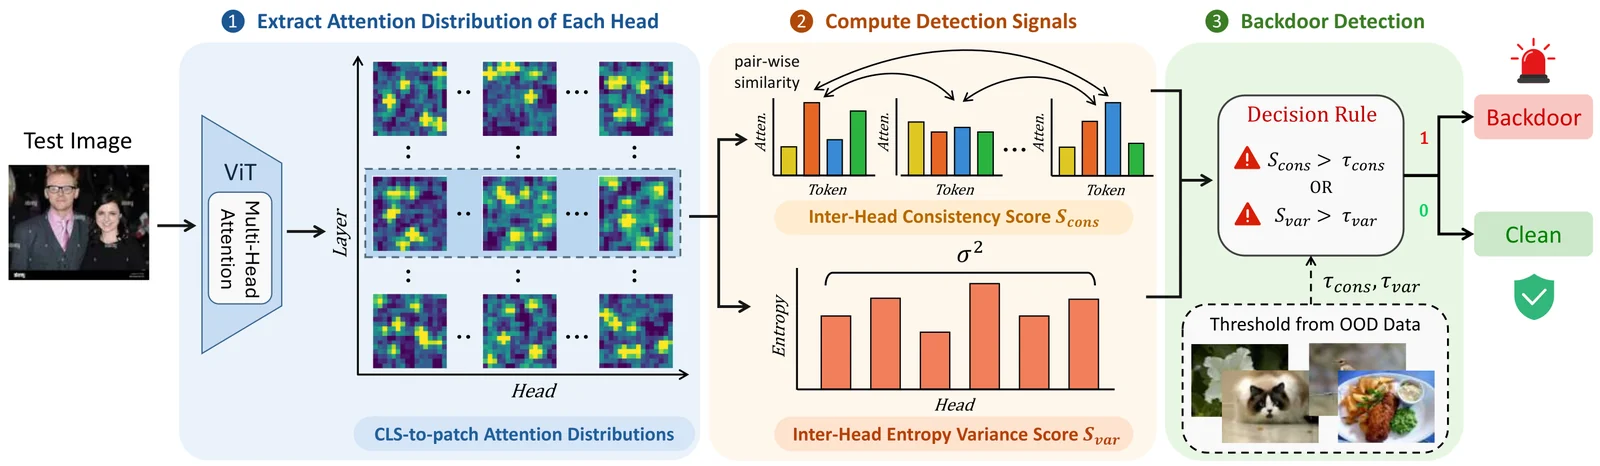
DetectViT は各ヘッドの CLS からパッチへのアテンション分布を抽出し、2つの相補的な信号を計算します:
閾値はスリーシグマ則 $\tau = \mu + 3\sigma$ を用いて、任意のソースからの64〜128枚のクリーンな分布外画像のみから推定されます。テストサンプルは、$\mathcal{S}{\text{cons}} > \tau{\text{cons}}$ または $\mathcal{S}{\text{var}} > \tau{\text{var}}$ の場合にバックドア付きとしてフラグが立てられます。
4つの ViT バックドア攻撃に対する検出性能。TPR と FPR は % 単位、AUC は [0, 1] スケールです。「–」は、その手法が適用不可能(ラベルベースの手法は自由形式のキャプションを扱えない)であるか、連続的なスコアを生成しないことを意味します。
| 防御手法 | BadViT TPR↑ / FPR↓ / AUC↑ | TrojViT TPR↑ / FPR↓ / AUC↑ | BadCLIP TPR↑ / FPR↓ / AUC↑ | BadVision TPR↑ / FPR↓ / AUC↑ |
|---|---|---|---|---|
| TeCo | 77.95 / 61.86 / 0.63 | 55.00 / 51.76 / 0.51 | 99.20 / 39.52 / 0.89 | – |
| Scale-Up | 88.65 / 30.66 / 0.81 | 85.00 / 41.98 / 0.74 | 91.84 / 65.03 / 0.66 | – |
| PatchProc | 90.61 / 18.42 / 0.89 | 87.60 / 21.44 / 0.85 | 86.97 / 26.78 / 0.82 | – |
| DeDe | 63.97 / 23.29 / 0.78 | 50.20 / 25.80 / 0.72 | 55.12 / 27.97 / 0.69 | 7.00 / 29.68 / 0.50 |
| BackdoorIDS | 80.79 / 9.73 / – | 5.00 / 10.84 / – | 93.24 / 16.88 / – | 96.00 / 15.96 / – |
| DetectViT | 100.00 / 1.58 / 1.00 | 90.80 / 5.94 / 0.95 | 100.00 / 0.17 / 1.00 | 96.00 / 3.00 / 0.99 |
追加の攻撃。 自己教師ありエンコーダ(BadEncoder、DRUPE)、クリーンラベルポイズニング(Label-Consistent)、周波数領域トリガー(Low-Frequency)、最適化されたグローバルトリガー(Blended-Optimized)を対象とするさらに5つの攻撃において、DetectViT はそのすべてで AUC 0.97 以上を維持する唯一の手法です。完全な結果は論文の付録に記載されています。
実行時間。 サンプルあたりの平均検出時間(秒):
| 防御手法 | BadViT | TrojViT | BadCLIP | BadVision |
|---|---|---|---|---|
| TeCo | 2.5094 | 4.2920 | 1.8448 | – |
| Scale-Up | 0.0246 | 0.0261 | 0.0696 | – |
| PatchProc | 0.6686 | 0.6926 | 0.8257 | – |
| DeDe | 0.0206 | 0.0279 | 0.1034 | 0.6060 |
| BackdoorIDS | 0.1734 | 0.1982 | 0.2560 | 3.3458 |
| DetectViT | 0.0124 | 0.0134 | 0.0163 | 0.0226 |
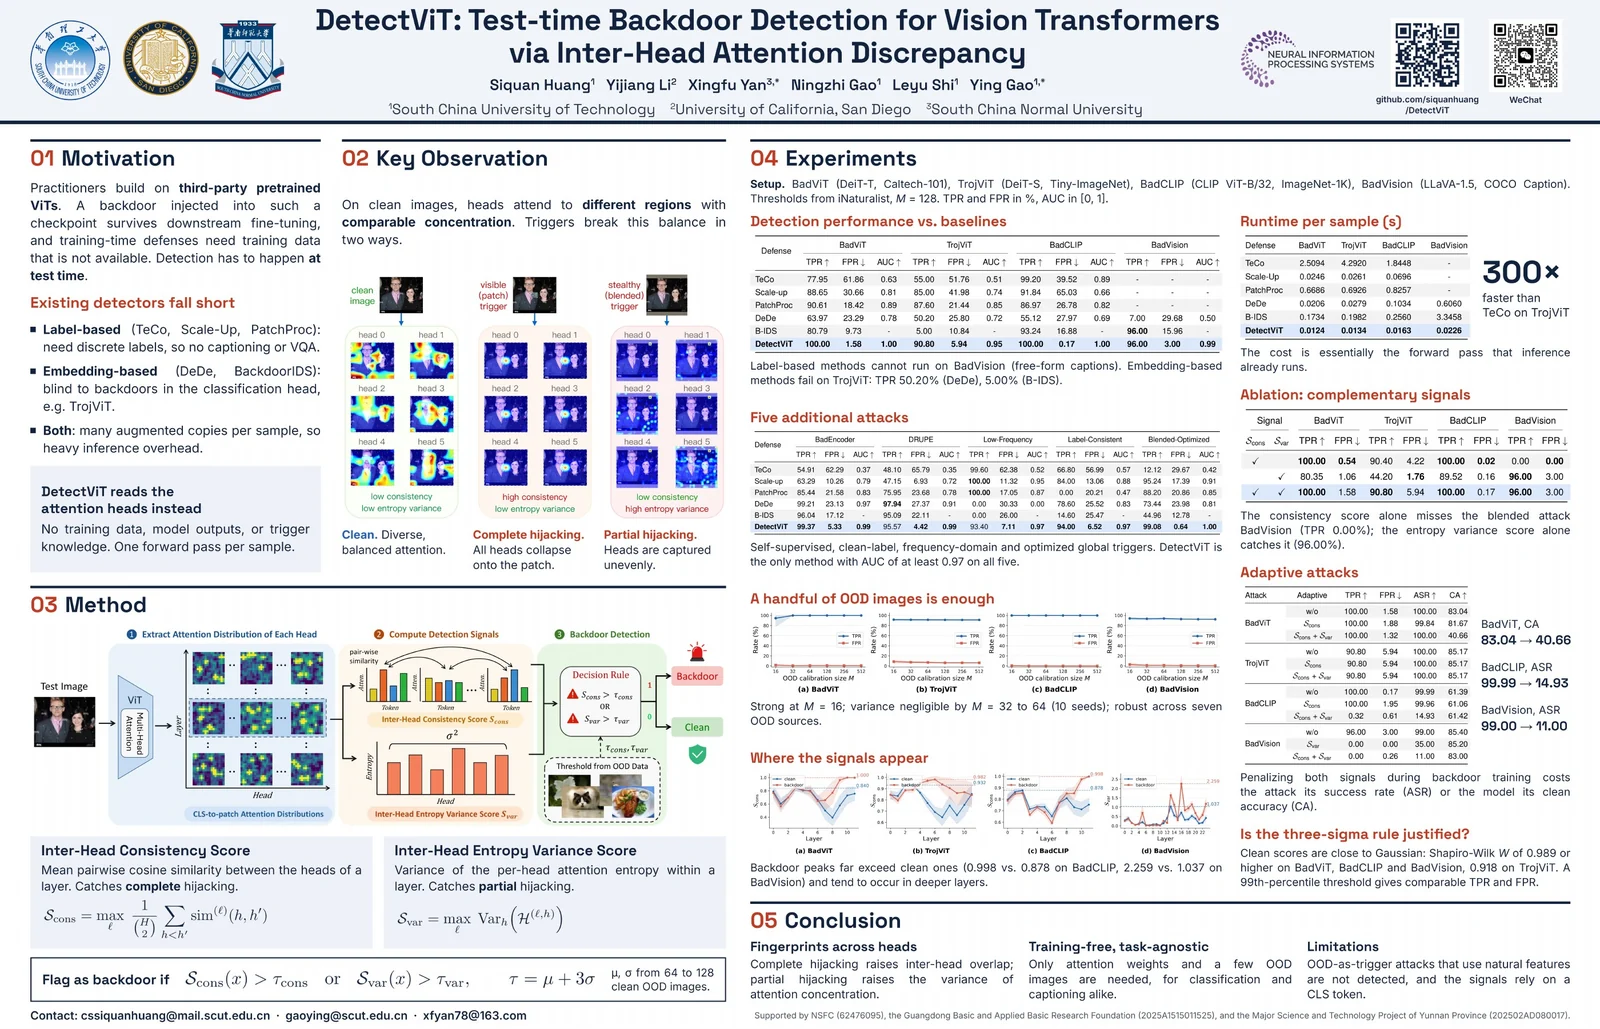
画像をクリックすると、フル解像度の PDF が開きます。
git clone https://github.com/siquanhuang/DetectViT.git
cd DetectViT
Google Drive から、事前学習済みのバックドア付きモデルチェックポイントと最適化済みトリガーをダウンロードします:
検出メソッドは detectvit.py に実装されています。main.py を実行して、各攻撃に対して DetectViT を評価します。
python3 main.py \
  --defense DetectViT \
  --attack_type badvit \
  --trojvit_attack_dir TrojViT/logs/Caltech101_DeiT-T_target0_BadViT \
  --trojvit_network DeiT-T \
  --trojvit_num_classes 102 \
  --trojvit_data_dir ./data
python3 main.py \
  --defense DetectViT \
  --attack_type trojvit \
  --trojvit_attack_dir TrojViT/logs/Tiny-ImageNet_DeiT-S_target2_TrojViT \
  --trojvit_data_dir ./data/tiny-imagenet-200 \
  --trojvit_network DeiT-S \
  --gpu 0
python3 -u main.py \
  --defense DetectViT \
  --attack_type badclip \
  --gpu 0 \
  --eval_data_type ImageNet1K \
  --eval_test_data_dir BadCLIP/data/ImageNet1K/validation/ \
  --add_backdoor \
  --asr \
  --label banana \
  --patch_type ours_tnature \
  --patch_location middle \
  --patch_name BadCLIP/opti_patches/tnature_eda_bs64_ep50_32_middle_01_05_pos_neg.jpg \
  --patch_size 32
python3 -u main.py \
  --defense DetectViT \
  --attack_type badvision \
  --gpu 0
| 引数 | 説明 | デフォルト |
|---|---|---|
--defense | 検出方法 (DetectViT、DeDe、BackdoorIDS、...) | DetectViT |
--attack_type | 評価対象の攻撃 (badvit、trojvit、badclip、badvision) | — |
--gpu | GPU デバイス ID | 0 |
本研究成果がお役に立ちましたら、ぜひ私たちの論文を引用してください。
@misc{huang2026detectvittesttimebackdoordetection,
      title={DetectViT: Test-time Backdoor Detection for Vision Transformers via Inter-Head Attention Discrepancy},
      author={Siquan Huang and Yijiang Li and Xingfu Yan and Ningzhi Gao and Leyu Shi and Ying Gao},
      year={2026},
      eprint={2611.23770},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2611.23770},
}
本プロジェクトは以下のオープンソース作品に基づいて構築されています。コードを公開してくださった作者の皆様に心より感謝いたします:









