 salesforce/merlion
時系列インテリジェンスのためのエンドツーエンドのPythonフレームワーク。異常検知、予測、変化点検出、AutoML、アンサンブル、ベンチマークパイプラインを提供します。


Merlionは、時系列インテリジェンスのためのPythonライブラリです。データの読み込みと変換、モデルの構築とトレーニング、モデル出力の後処理、モデルパフォーマンスの評価を含む、エンドツーエンドの機械学習フレームワークを提供します。単変量および多変量の時系列を対象とした、予測、異常検知、変化点検出など、さまざまな時系列学習タスクをサポートしています。このライブラリは、エンジニアや研究者が特定の時系列ニーズに合わせてモデルを迅速に開発し、複数の時系列データセット間でベンチマークできるワンストップソリューションを提供することを目的としています。
Merlionの主な特徴は次のとおりです。
DefaultDetectorおよびDefaultForecasterモデル。以下の表は、Merlionの主要機能が、時系列の異常検知や予測を行う他のライブラリとどのように比較されるかを視覚的に示したものです。
| Merlion | Prophet | Alibi Detect | Kats | darts | statsmodels | nixtla | GluonTS | RRCF | STUMPY | Greykite | pmdarima | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 単変量予測 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | |||
| 多変量予測 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| 単変量異常検知 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | |||
| 多変量異常検知 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| 前処理 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||
| 後処理 | ✅ | ✅ | ||||||||||
| AutoML | ✅ | ✅ | ✅ | |||||||||
| アンサンブル | ✅ | ✅ | ✅ | ✅ | ||||||||
| ベンチマーキング | ✅ | ✅ | ✅ | ✅ | ✅ | |||||||
| 可視化 | ✅ | ✅ | ✅ | ✅ | ✅ |
Merlion 2.0で新しくなった機能は次のとおりです。
| Merlion | Prophet | Alibi Detect | Kats | darts | statsmodels | nixtla | GluonTS | RRCF | STUMPY | Greykite | pmdarima | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 外生リグレッサ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| 変化点検出 | ✅ | ✅ | ✅ | ✅ | ✅ | |||||||
| クリック可能なビジュアルUI | ✅ | |||||||||||
| 分散バックエンド | ✅ | ✅ |
Merlionは2つのサブリポジトリで構成されています。merlionはライブラリのコアとなる時系列インテリジェンス機能を実装し、ts_datasetsは複数の時系列データセット用の標準化されたデータローダーを提供します。これらのローダーは、時系列を付随するメタデータとともにpandas.DataFrameとして読み込みます。
merlionは、pip install salesforce-merlion を実行するとPyPIからインストールできます。ソースからインストールする場合は、このリポジトリをクローンして pip install Merlion/ を実行するか、編集可能モードでインストールするには pip install -e Merlion/ を実行します。追加の依存関係は、pip install salesforce-merlion[all] または、ソースからインストールする場合は pip install "Merlion/[all]" を実行してインストールできます。オプションの依存関係には、GUIダッシュボード用のdashboard、PySparkを使用した分散計算バックエンド用のspark、すべての深層学習モデル用のdeep-learningが個別に含まれています。
データ読み込みパッケージts_datasetsをインストールするには、このリポジトリをクローンして pip install -e Merlion/ts_datasets/ を実行してください。データローダーを初期化する際に毎回データセットのルートディレクトリを手動で指定したくない場合は、このパッケージを編集可能モード(つまり -e フラグ付き)でインストールする必要があります。
以下の外部依存関係に注意してください。
一部の予測モデルはOpenMPに依存しています。condaを使用する場合は、パッケージをインストールする前に conda install -c conda-forge lightgbm を実行してください。これにより、OpenMPがお使いのconda環境内のlightgbmパッケージ(依存関係の1つ)と連携するように構成されます。Macを使用する場合は、Homebrewをインストールして brew install libomp を実行し、モデルがOpenMPライブラリを利用できるようにしてください。
一部の異常検知モデルはJava Development Kit(JDK)に依存しています。Ubuntuの場合は、 sudo apt-get install openjdk-11-jdk を実行してください。Mac OSの場合は、Homebrewをインストールして brew tap adoptopenjdk/openjdk && brew install --cask adoptopenjdk11 を実行してください。また、javaがPATH上で見つかること、およびJAVA_HOME環境変数が設定されていることを確認してください。
サンプルコードとMerlionの入門については、examples内のJupyterノートブックと、こちらのガイド付きウォークスルーを参照してください。詳細なAPIドキュメント(サンプルコードを含む)はここにあります。テクニカルレポートは、Merlionの全体的なアーキテクチャを概説し、単変量および多変量の時系列に対する異常検知と予測の実験結果を示しています。
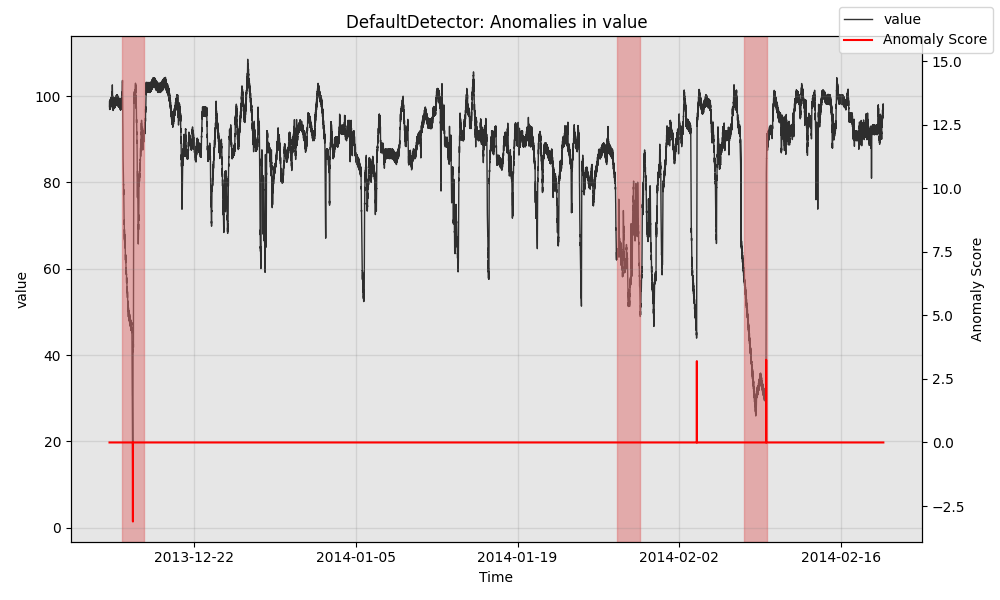
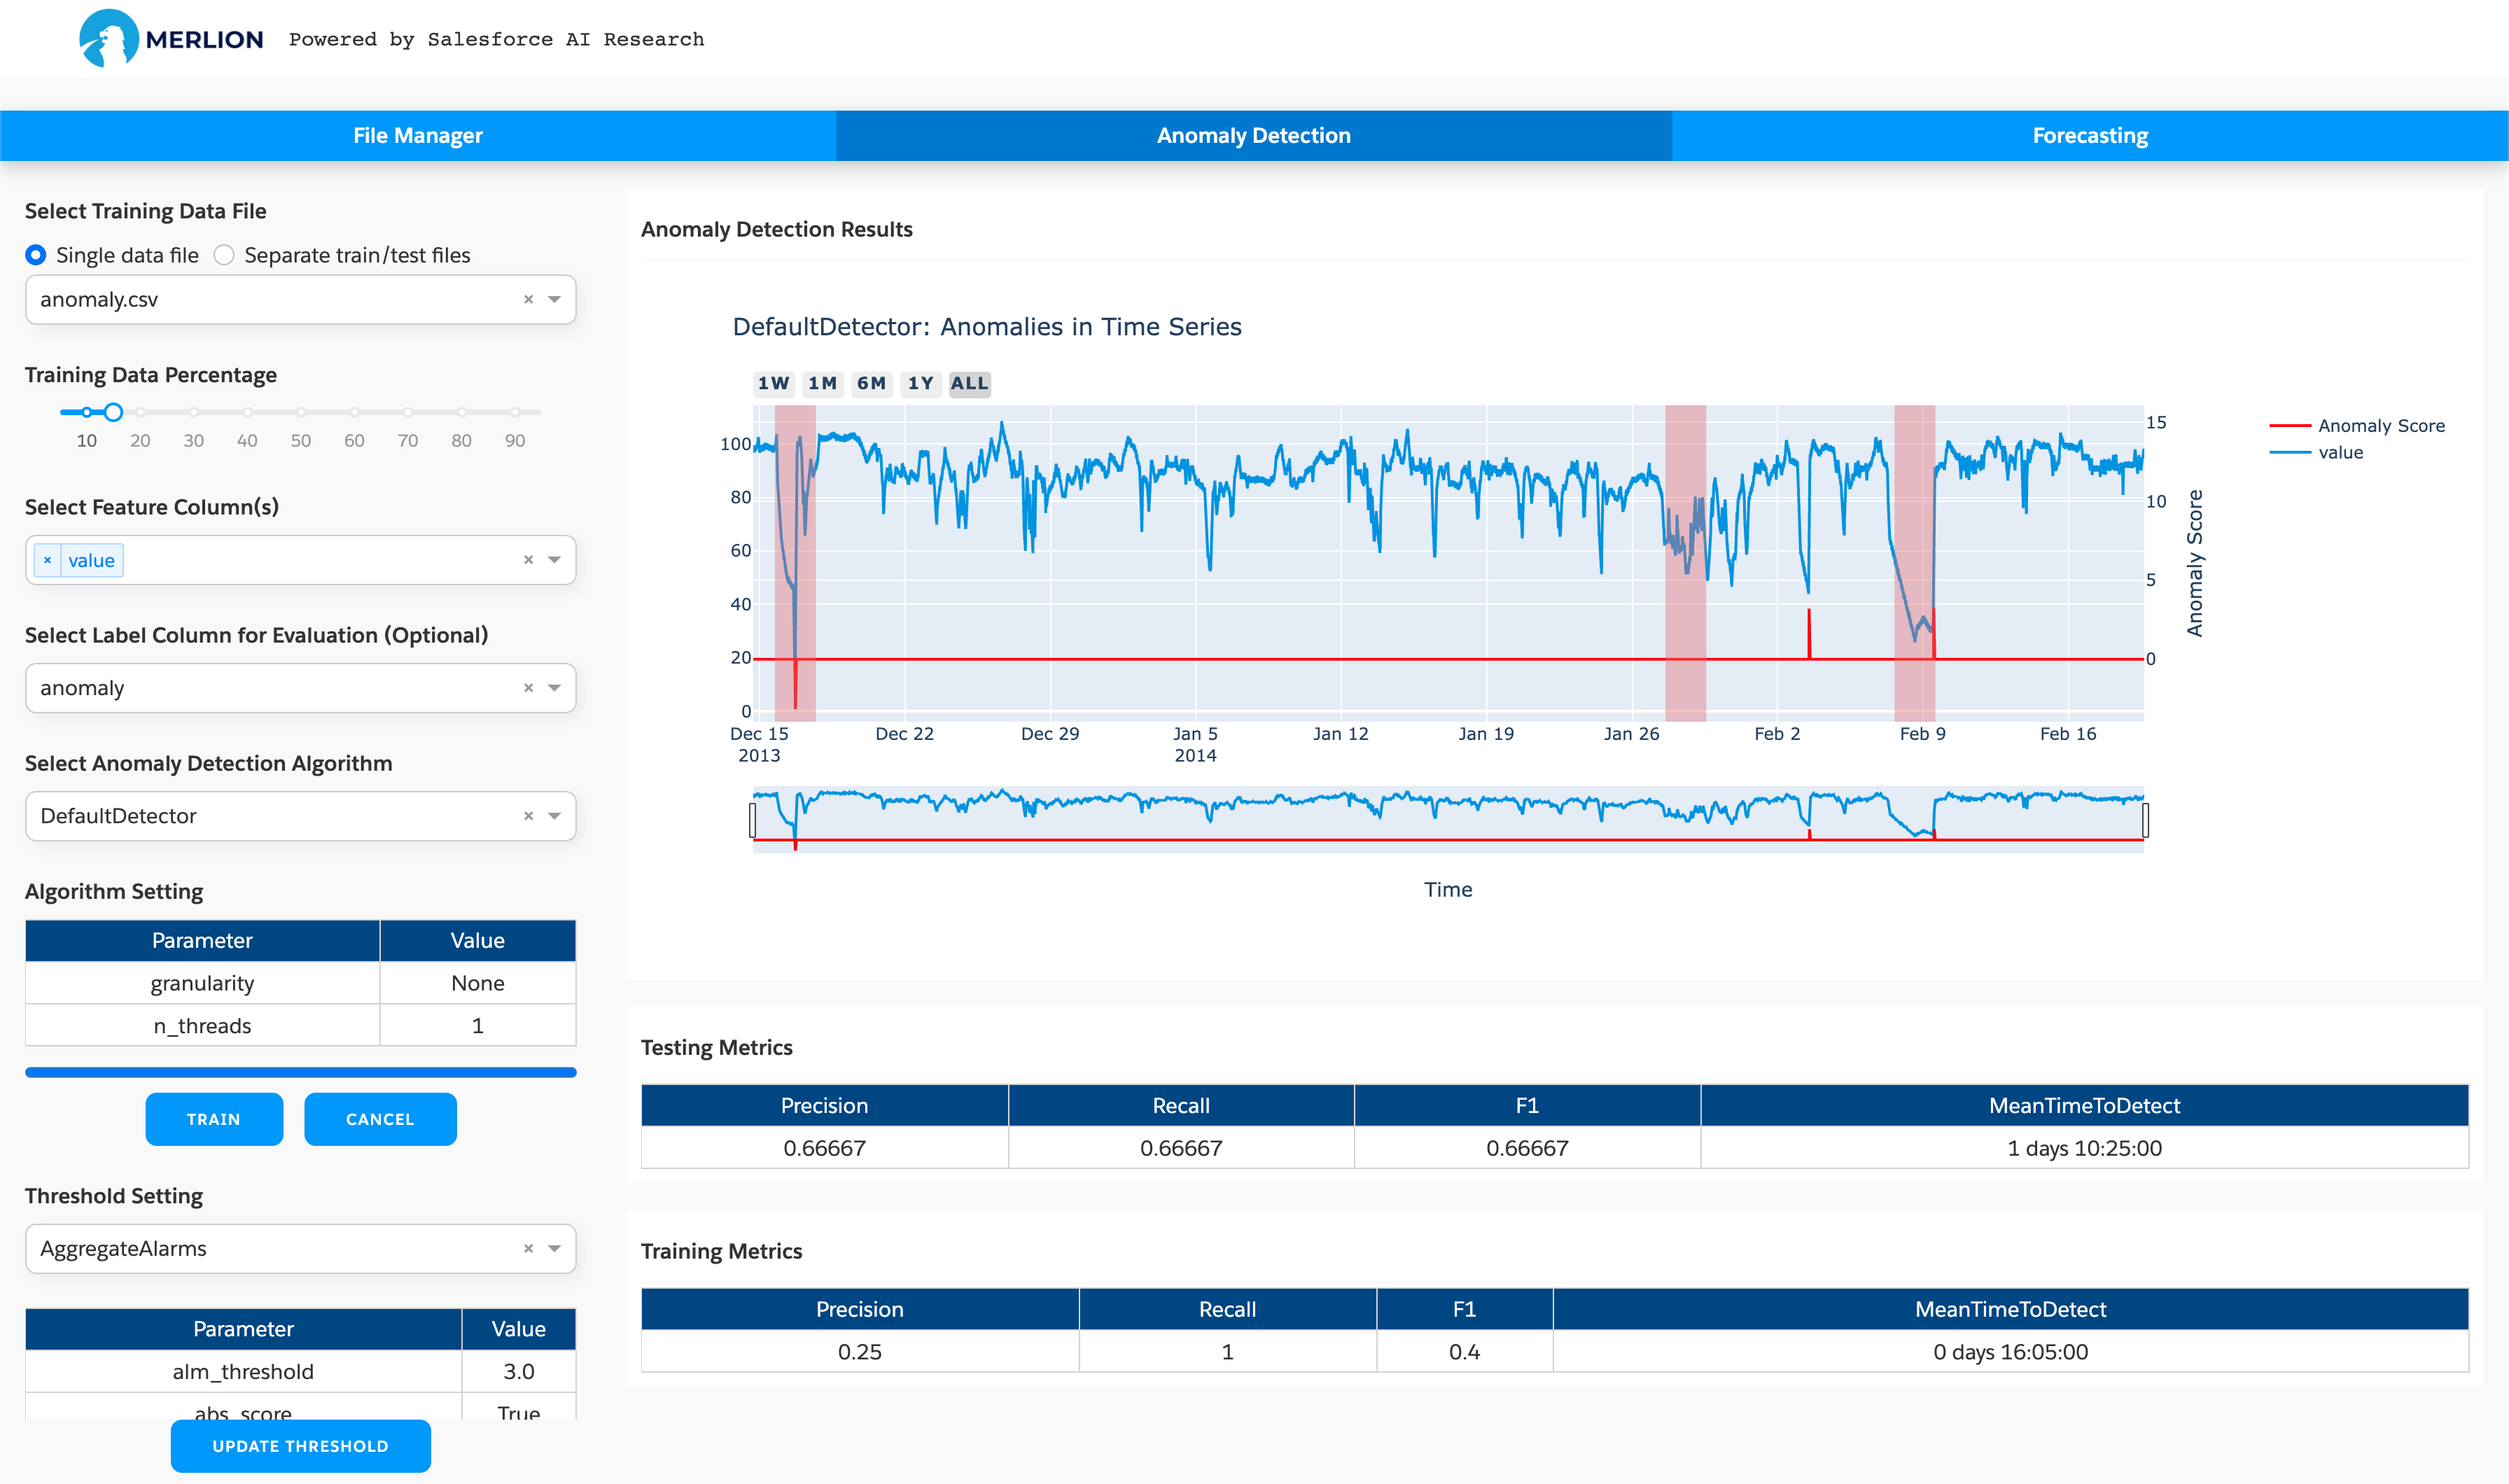
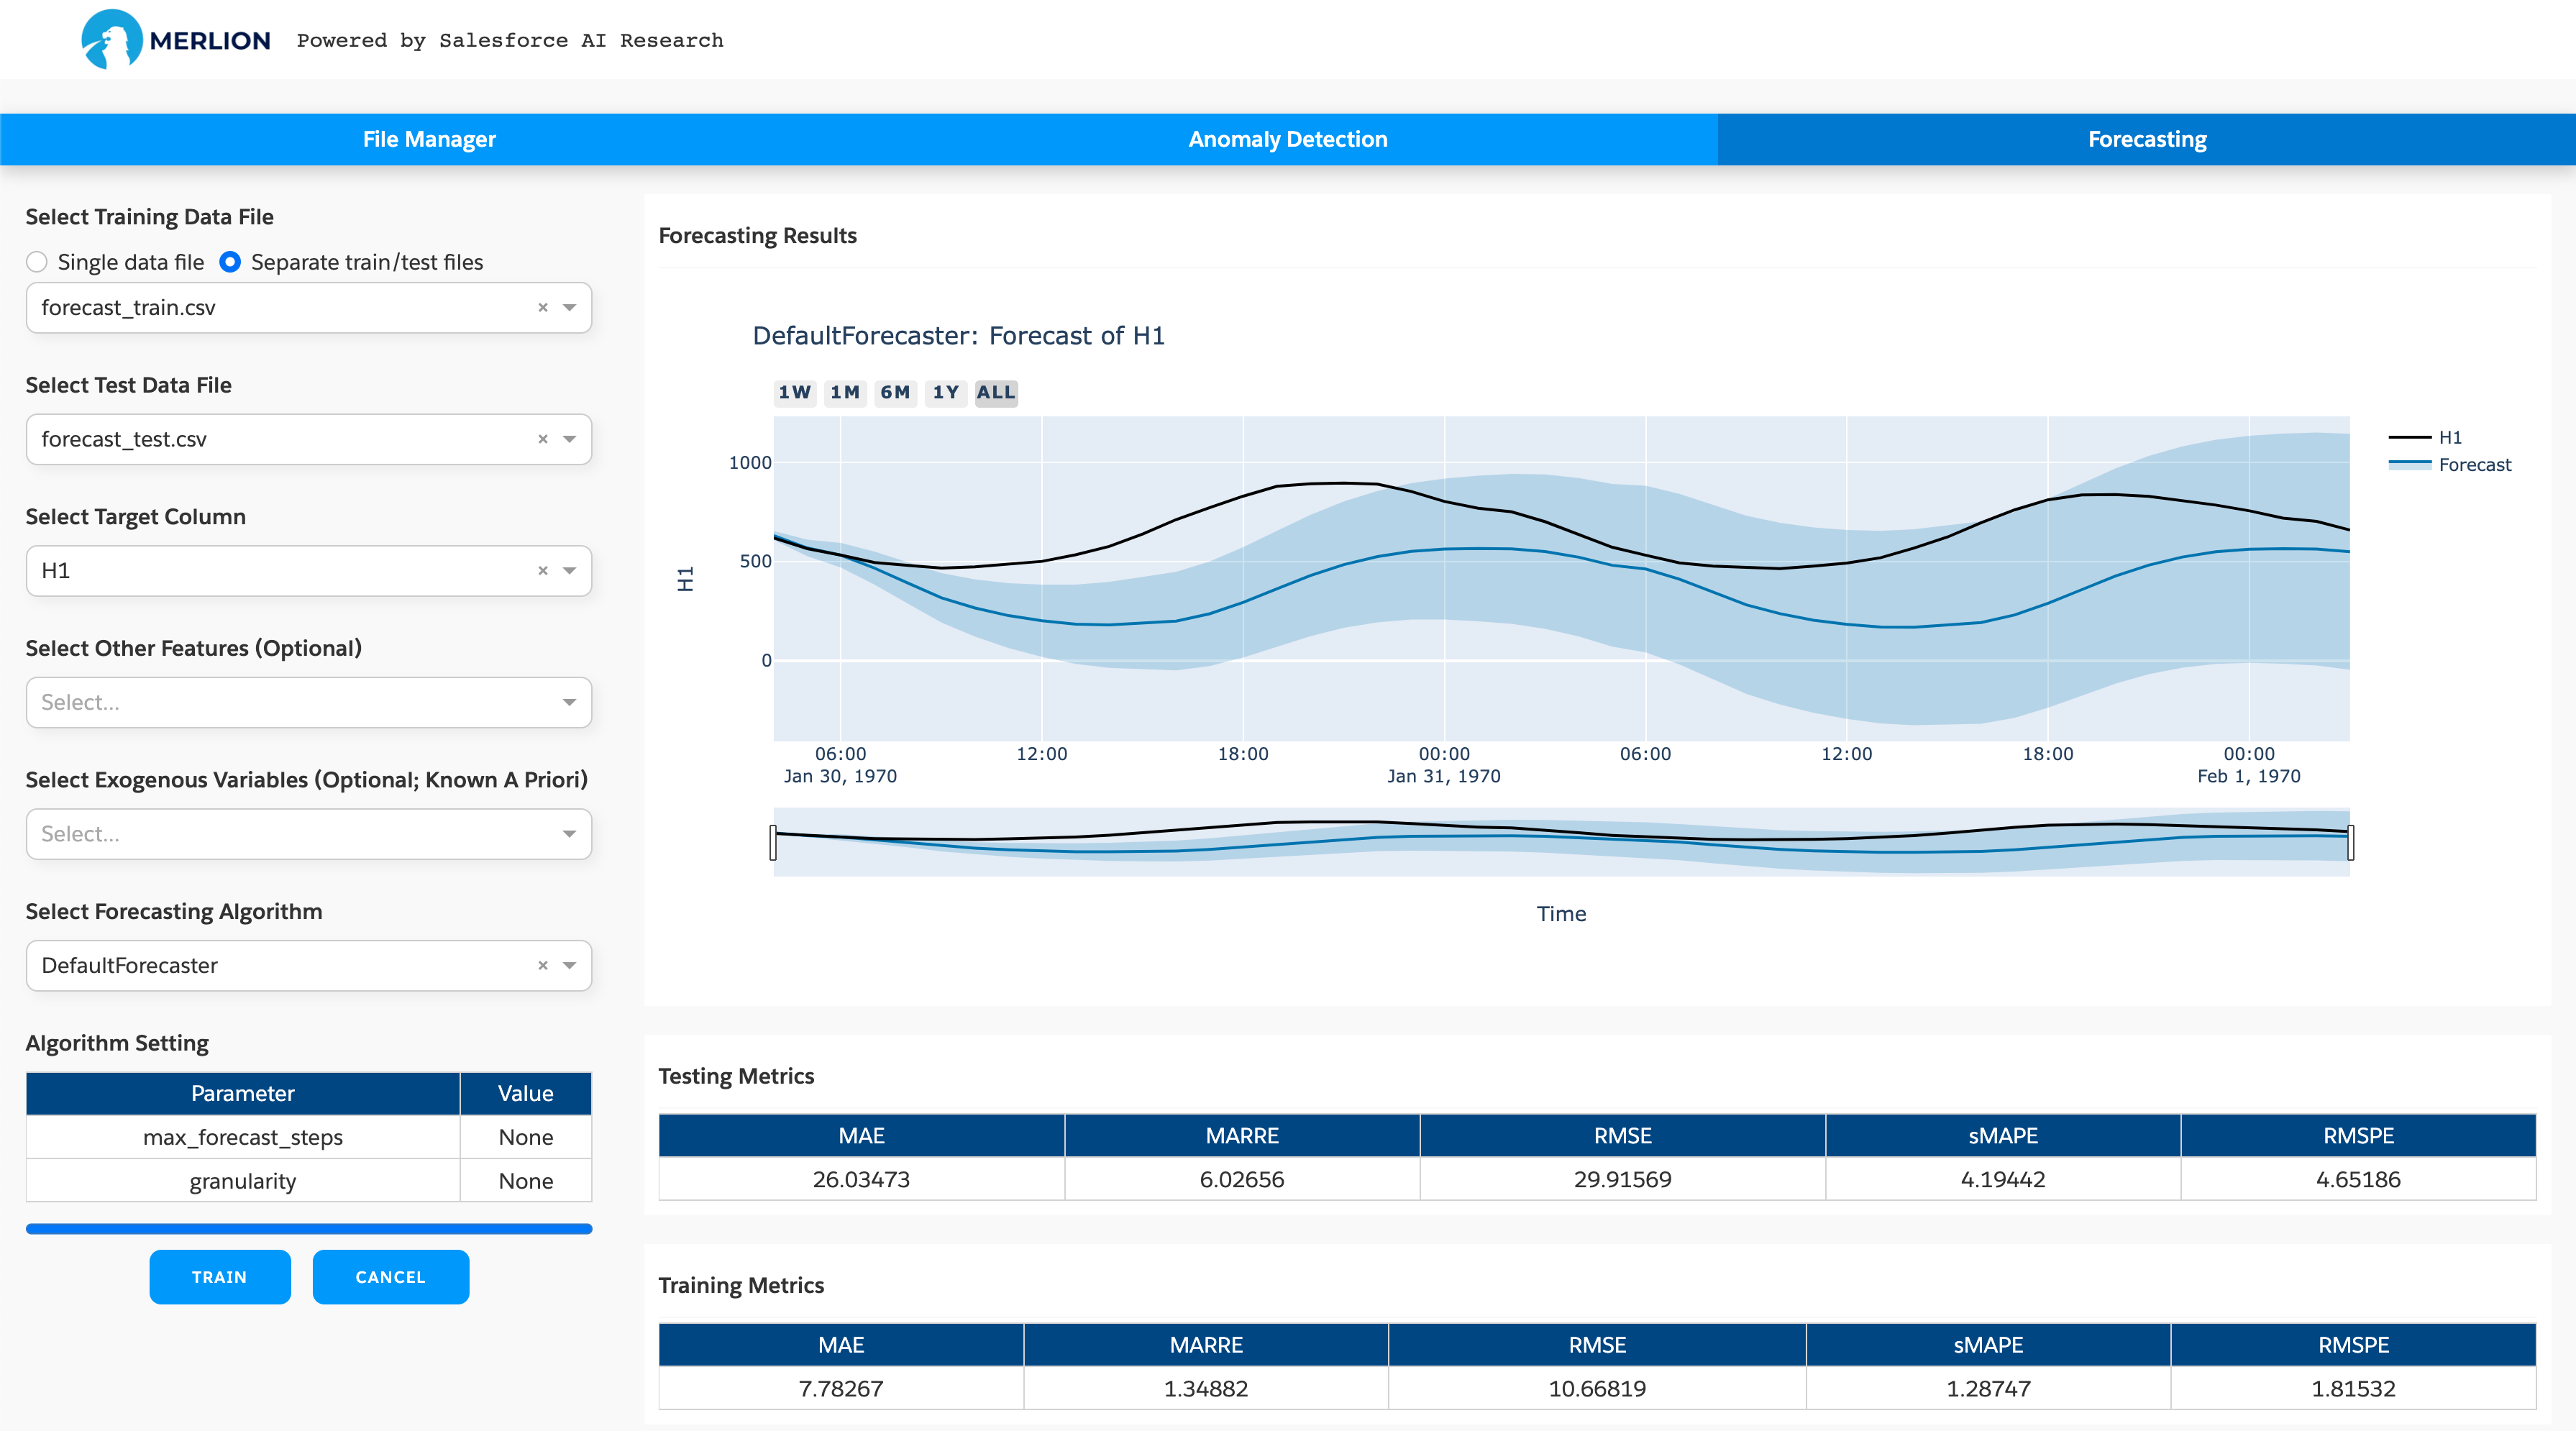
最も簡単な始め方は、GUIベースのWebdashboardを使用することです。このダッシュボードは、独自のカスタムデータセットで多くのモデルをすばやく試すのに最適な方法を提供します。使用するには、オプションのdashboard依存関係を指定してMerlionをインストールし(例: pip install salesforce-merlion[dashboard])、コマンドラインから python -m merlion.dashboard を実行します。ダッシュボードは http://localhost:8050 で表示できます。以下に、異常検知と予測の両方のダッシュボードのスクリーンショットを示します。
独自のコードでMerlionを使い始めるために、以下に異常検知と予測の両方でMerlionのデフォルトモデルを使用した最小限の例を示します。
ここでは、上記の異常検知ダッシュボードの結果を再現するコードを示します。まず、MerlionのTimeSeriesクラスと、Numenta Anomaly Benchmark NAB用のデータローダーをインポートします。次に、このデータセットから特定の時系列をトレーニング分割とテスト分割に分けます。
from merlion.utils import TimeSeries
from ts_datasets.anomaly import NAB

# Data loader returns pandas DataFrames, which we convert to Merlion TimeSeries
time_series, metadata = NAB(subset="realKnownCause")[3]
train_data = TimeSeries.from_pd(time_series[metadata.trainval])
test_data = TimeSeries.from_pd(time_series[~metadata.trainval])
test_labels = TimeSeries.from_pd(metadata.anomaly[~metadata.trainval])
次に、MerlionのDefaultDetectorを初期化してトレーニングできます。DefaultDetectorは、パフォーマンスと効率性のバランスが取れた異常検知モデルです。また、テスト分割に対する予測も取得します。
from merlion.models.defaults import DefaultDetectorConfig, DefaultDetector
model = DefaultDetector(DefaultDetectorConfig())
model.train(train_data=train_data)
test_pred = model.get_anomaly_label(time_series=test_data)
次に、モデルの予測を可視化します。
from merlion.plot import plot_anoms
import matplotlib.pyplot as plt
fig, ax = model.plot_anomaly(time_series=test_data)
plot_anoms(ax=ax, anomaly_labels=test_labels)
plt.show()
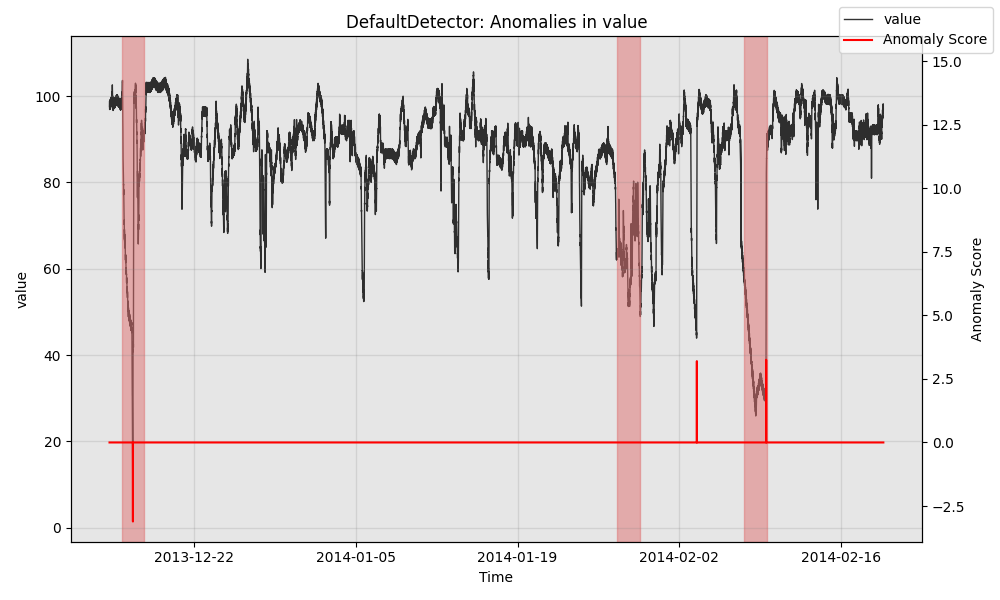
最後に、モデルを定量的に評価できます。適合率(precision)と再現率(recall)は、モデルが3回のアラームを発報し、そのうち2件が真陽性、1件が偽陰性、1件が偽陽性であったことに基づいています。また、モデルが正しく検知した各異常を検知するのにかかった平均時間も評価します。
