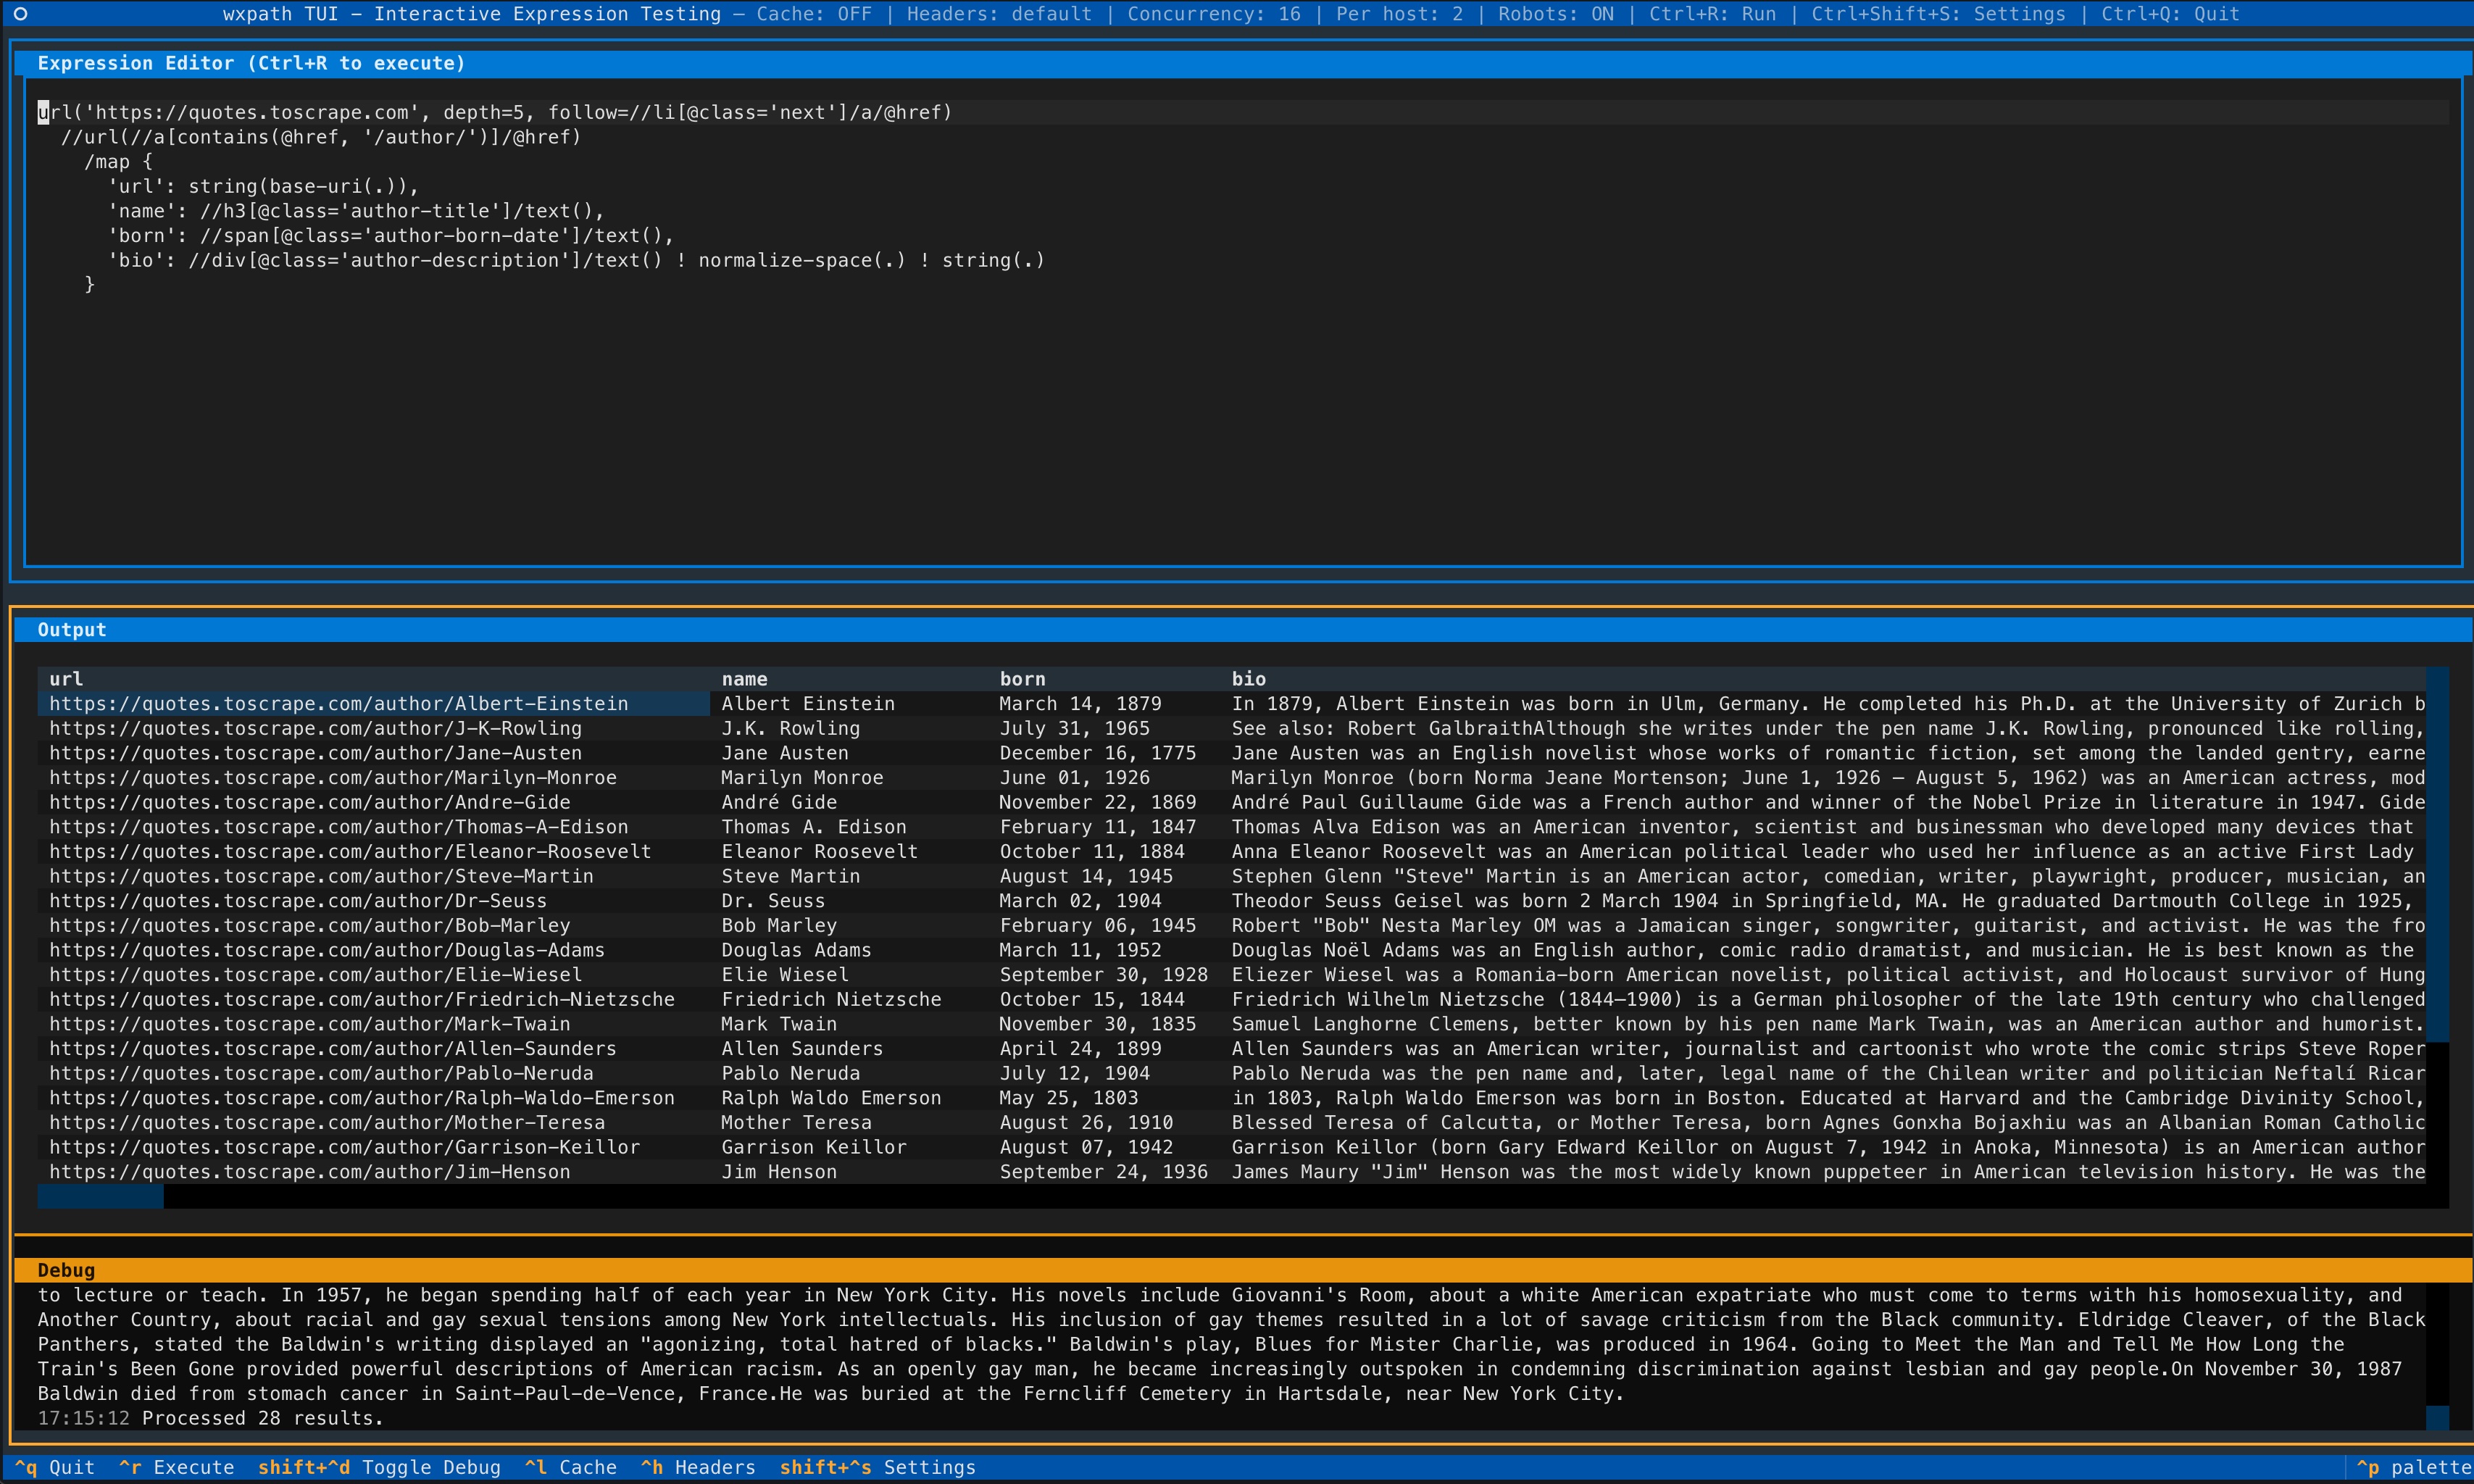


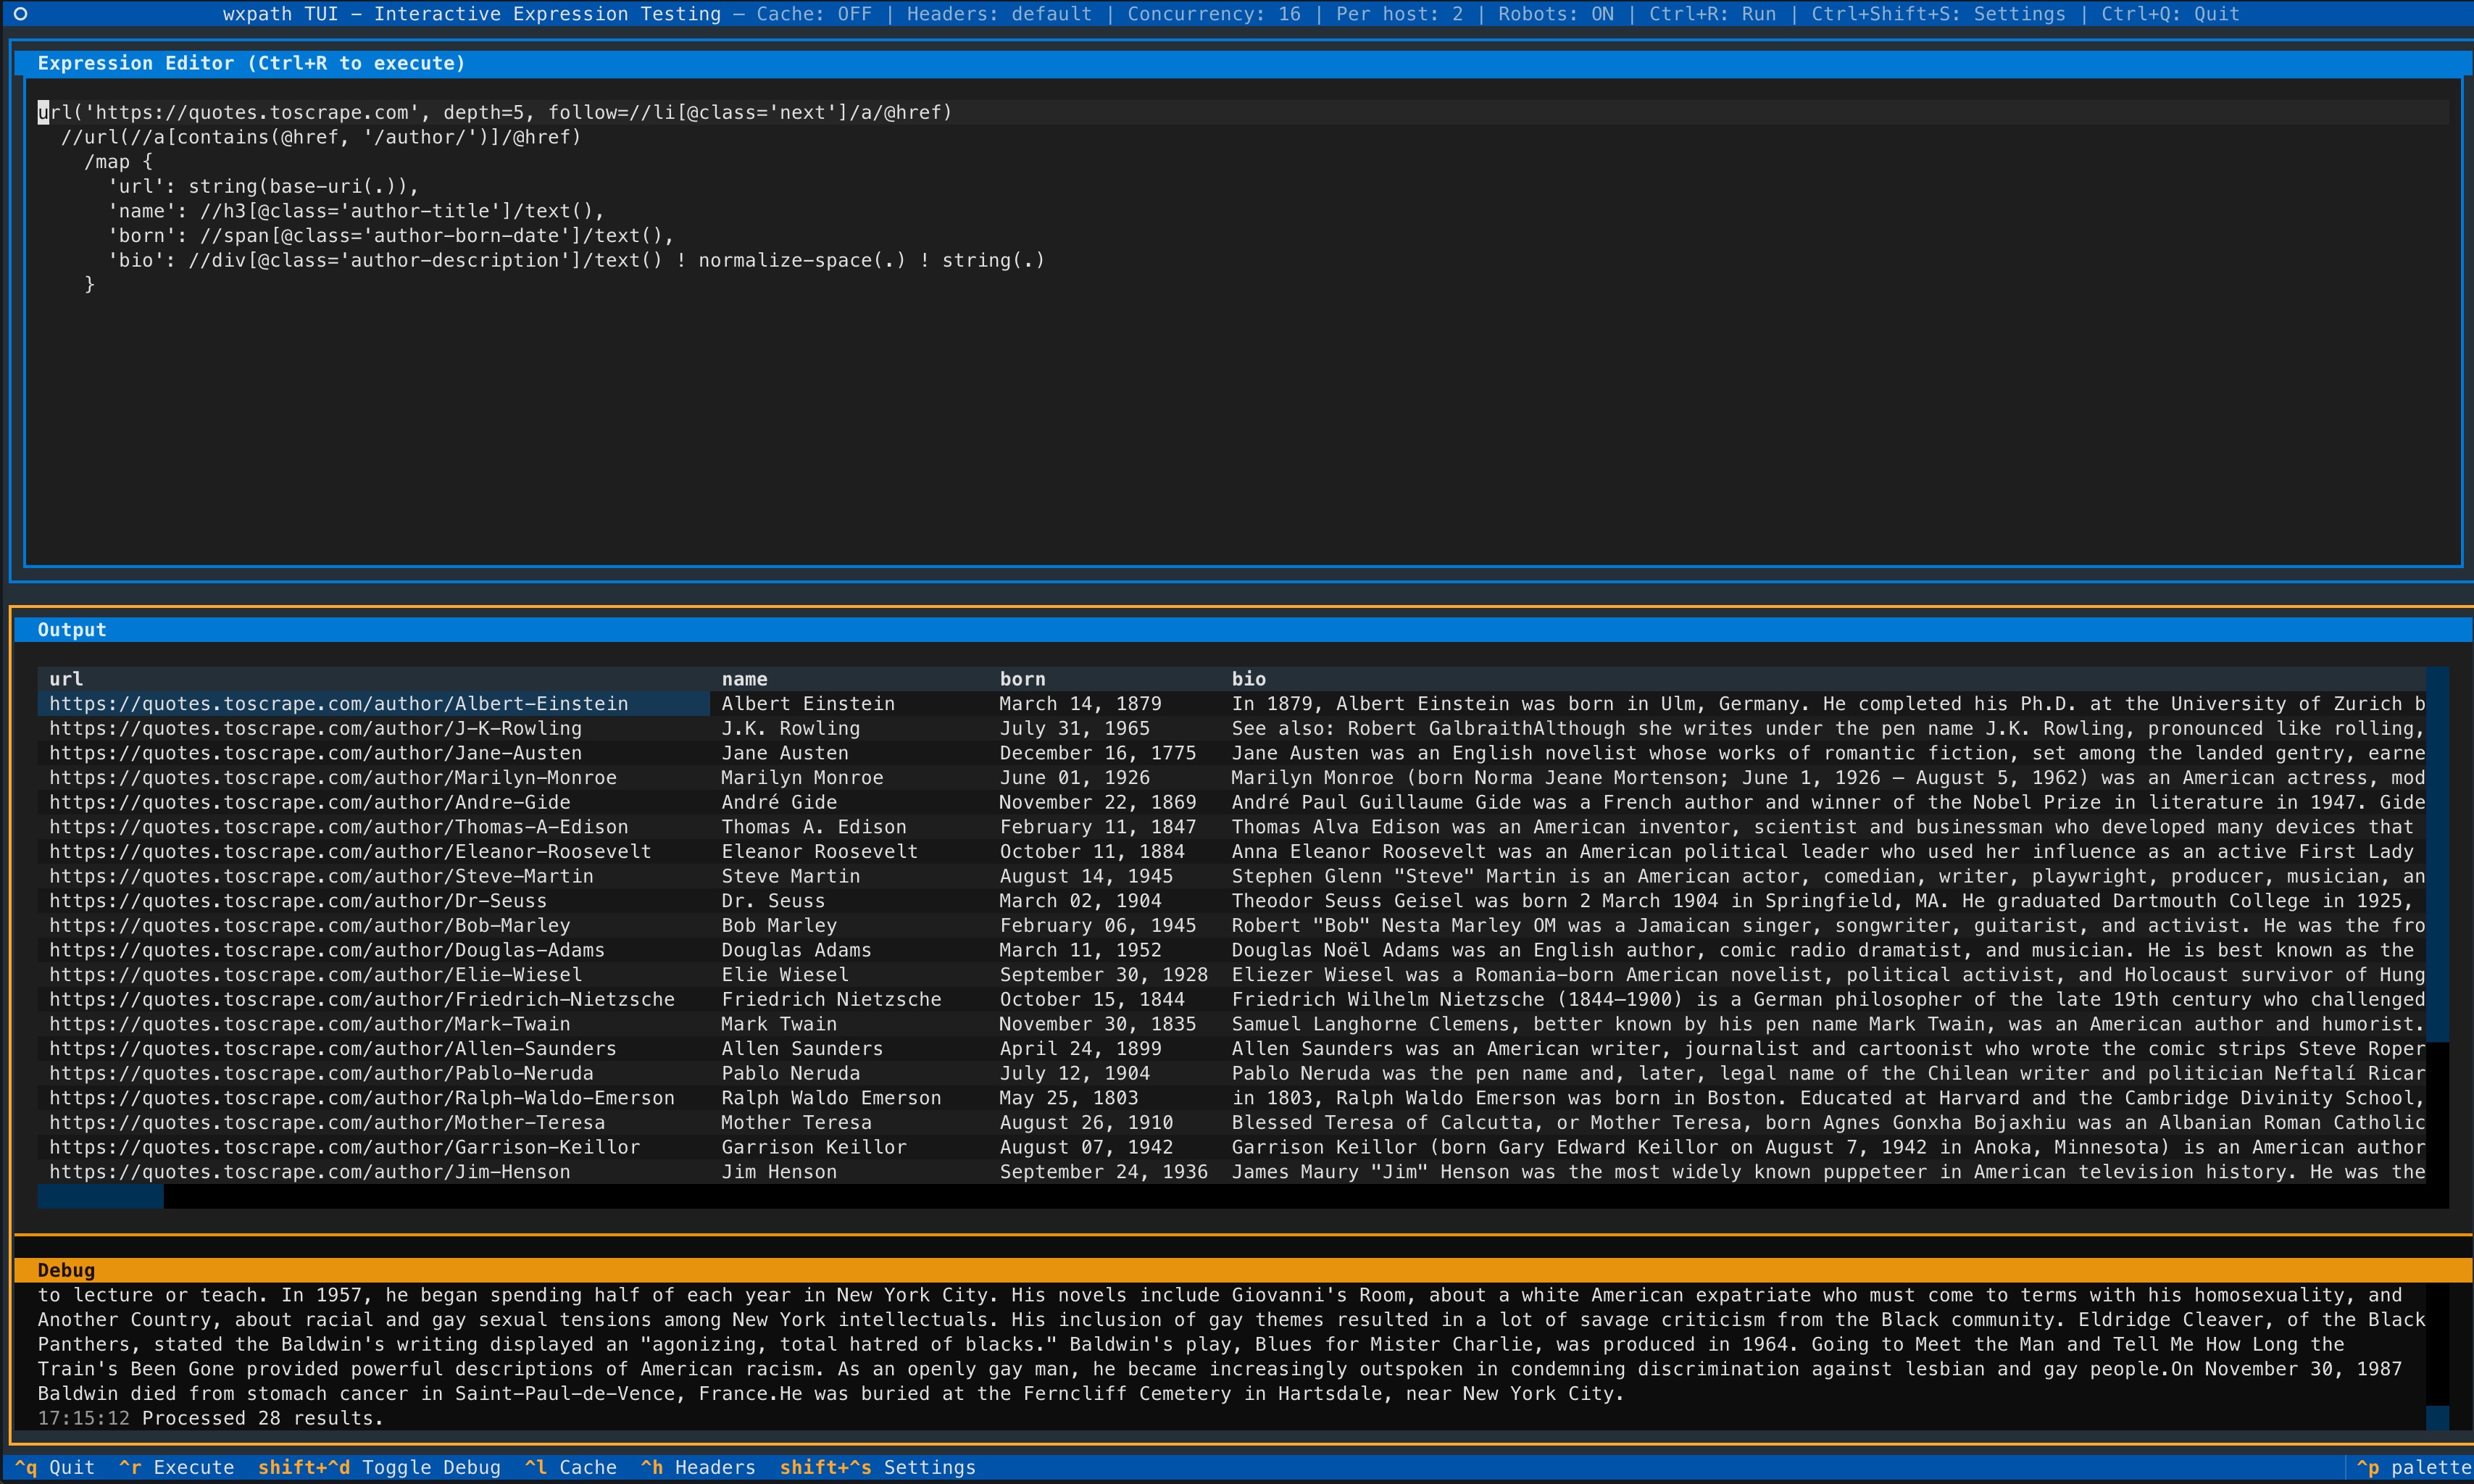
新着: TUI - 対話型ターミナルインターフェース(Textual搭載)でwxpath式をテストし、データをエクスポートできます。
Python 3.10以上が必要です。
pip install wxpath
# For TUI support:
pip install "wxpath[tui]"
# Immediately launch the TUI via uv:
uvx --from "wxpath[tui]" wxpath-tui
wxpathは、トラバーサルをXPathで直接表現する宣言的なWebクローラーです。命令型のクロールループを書く代わりに、wxpathは何を追跡し何を抽出するかを単一の式で記述できます。wxpathはその式を並行して実行し、幅優先的(breadth-first-ish)に結果を発見次第ストリーミングします。
この式はページを取得し、リンクを抽出し、それらを並行してストリーミングします - クロールループは不要です:
import wxpath

expr = "url('https://quotes.toscrape.com')//a/@href"

for link in wxpath.wxpath_async_blocking_iter(expr):
    print(link)
url(...)演算子と///構文を導入することで、wxpathのエンジンは再帰的(またはページネーション)なWebクローリングと抽出を実行できます:
import wxpath

path_expr = """
url('https://quotes.toscrape.com')
  ///url(//a/@href)
    //a/@href
"""

for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
    print(item)
ほとんどのWebスクレイパーは、最初にクロールの制御フローを書き、その後に抽出を強制します。
wxpathはこれら2つのステップを1つに統合します:
グラフからクリーンで構造化されたJSON階層を直接抽出 - LLMにノイズではなくシグナルを供給します。詳細はLangChain統合を参照してください。
wxpathは決定論的です(つまり、LLMを利用していません)。ネットワークが安定していることを保証できませんが、トラバーサルが安定していることは保証できます。
ドキュメントはこちらから入手できます。
url(...) と ///url(...) の説明import wxpath
from wxpath.settings import CRAWLER_SETTINGS
# Custom headers for politeness; necessary for some sites (e.g., Wikipedia)
CRAWLER_SETTINGS.headers = {'User-Agent': 'my-app/0.4.0 (contact: [email protected])'}
# Crawl, extract fields, build a knowledge graph
path_expr = """
url('https://en.wikipedia.org/wiki/Expression_language')
///url(
//main//a/@href[
starts-with(., '/wiki/') and not(contains(., ':'))
]
)
/map{
'title': (//span[contains(@class, "mw-page-title-main")]/text())[1] ! string(.),
'url': string(base-uri(.)),
'short_description': //div[contains(@class, 'shortdescription')]/text() ! string(.),
'forward_links': //div[@id="mw-content-text"]//a/@href ! string(.)
}
"""
for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
print(item)
注意: Wikipediaを含む一部のサイトでは、適切なヘッダーがないリクエストをブロックする場合があります。カスタムUser-Agentを設定するには、上級:エンジン&クローラー設定を参照してください。
上記の式は次のことを行います:
https://en.wikipedia.org/wiki/Expression_language から開始します。<main>セクション内で、/wiki/で始まりコロン(:)を含まないリンクをフィルタリングします。url(...) と ///url(...) の説明url(...)は、ユーザー指定または内部で生成されたURLのコンテンツを取得し、lxml.html.HtmlElementとして返すカスタム演算子です。これにより、さらなるXPath処理が可能になります。///url(...)は深いクロールを示します。ランタイムエンジンに、指定されたmax_depthまでリンクをたどり続けるよう指示します。繰り返しurl()ホップを使用するのとは異なり、単一の式でより深いグラフ探索を記述できます。警告:トラバーサルの爆発を避けるために、max_depthやXPath述語による制約を慎重に使用してください。言語設計の詳細はDESIGN.mdを参照してください。核となる概念とゼロからの言語設計が示されています。
wxpathは式をトラバーサルと抽出のステップ(内部ではSegmentと呼ばれる)のリストとして評価します。
url(...)は、静的(固定URLによる)または動的(XPath式から派生したURLによる)にクロールタスクを作成します。URLは、深度ごとではなく、グローバルにベストエフォートで重複排除されます。
XPathセグメントは、取得されたドキュメント(直前のurl(...)操作で取得されたもの)に対して操作を行います。
///url(...)は深いクロールを示します - 幅優先的(breadth-first-ish)にmax_depthまで進みます。
結果は準備ができ次第、生成(yield)されます。
wxpathはasyncio/aiohttpを優先し、クローリングとデータ抽出のための非同期APIを提供します。
import asyncio
from wxpath import wxpath_async

items = []

async def main():
    path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
    async for item in wxpath_async(path_expr, max_depth=1):
        items.append(item)

asyncio.run(main())
wxpathは、同期的なコードのシンプルさを保ちながら複数ページを並行してクロールできる、asyncioインシンクAPIも提供します。これは、パフォーマンスが重要となる厳密に同期した実行環境(つまりasyncioイベントループの外部)でのクロールに特に役立ちます。
from wxpath import wxpath_async_blocking_iter

path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
items = list(wxpath_async_blocking_iter(path_expr, max_depth=1))
wxpathはデフォルトでWXPathEngine(..., robotstxt=True)コンストラクタを介してrobots.txtを尊重します。
wxpath Python APIは構造化オブジェクトを生成します。
式によって、結果には以下が含まれる場合があります:
lxml.*およびlxml.html.*オブジェクトelementpath.datatypes.*オブジェクト(XPath 3.1機能用)WxStr(出典付き文字列値)CLIはこれらのオブジェクトを表示用にプレーンなJSONにフラット化します。 Python APIはデフォルトで構造を保持します。
wxpathはelementpathライブラリを使用してXPath 3.1をサポートし、マップ、配列などの高度なXPath機能を有効にします。これにより、より強力なXPathクエリを作成できます。
path_expr = """
    url('https://en.wikipedia.org/wiki/Expression_language')
    ///url(//div[@id='mw-content-text']//a/@href)
    /map{
        'title':(//span[contains(@class, "mw-page-title-main")]/text())[1],
        'short_description':(//div[contains(@class, "shortdescription")]/text())[1],
        'url'://link[@rel='canonical']/@href[1]
    }
"""
# [...
# {'title': 'Computer language',
# 'short_description': 'Formal language for communicating with a computer',
# 'url': 'https://en.wikipedia.org/wiki/Computer_language'},
# {'title': 'Machine-readable medium and data',
# 'short_description': 'Medium capable of storing data in a format readable by a machine',
# 'url': 'https://en.wikipedia.org/wiki/Machine-readable_medium_and_data'},
# {'title': 'Domain knowledge',
# 'short_description': 'Specialist knowledge within a specific field',
# 'url': 'https://en.wikipedia.org/wiki/Domain_knowledge'},
# ...]
wxpathはtqdmを介したプログレスバーを提供し、クロールの進行状況を追跡します。これは長時間のクロールに特に便利です。
engine.run(..., progress=True)を設定するか、wxpath_async*(...)関数のいずれかにprogress=Trueを渡して有効にします。
items = wxpath.wxpath_async_blocking("...", progress=True)
> 100%|██████████████████████████████████████████████████████████▎| 469/471 [00:05<00:00, 72.00it/s, depth=2, yielded=457]
wxpathはコマンドラインインターフェース(CLI)を提供し、ターミナルから直接wxpath式をすばやく試して実行できます。
次の例は、"Expression language"ページからWikipediaをクロールし、他のwikiページへのリンクを抽出し、各リンク先ページから特定のフィールドを取得する方法を示しています。

