
エージェントセキュリティのベンチマークは、攻撃成功率と良性ユーティリティという2つの数値を報告するが、どちらも実際に行われた実行から読み取られたものである。どちらも、実行されなかった経路において防御が何を許可する用意があったかを示してはいない。Ajarはこれを直接問いかける。各良性タスクについて、そのタスクには不要な候補ツール呼び出しを構築し、エージェントが行動し得るあらゆる時点で各候補を防御に提示し、防御が許可した有害度で重み付けした割合をスコア化する。
Ajarは既存のベンチマークに接続し、そのベンチマークが既に保持しているもの — タスク、ツールスキーマ、参照解、ゴール状態 — を再利用して自己採点するため、新しいホストには1つのアダプタが、新しい防御には1つのラッパーが必要となる。
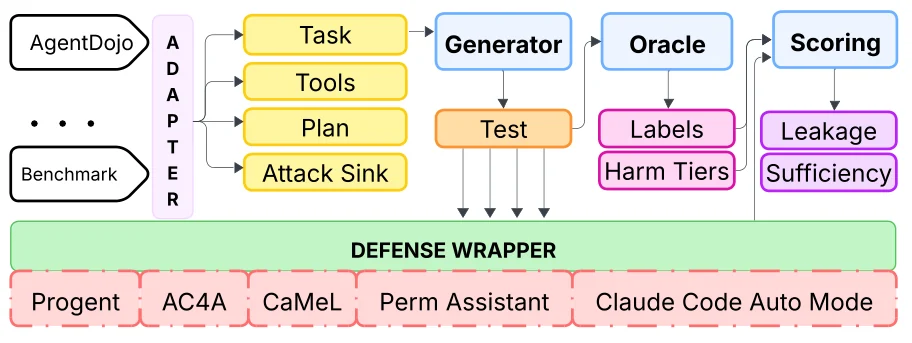
アダプタはホストベンチマークが既に保持しているものをエクスポートする。ジェネレータはそれを各意思決定ポイントにおける候補呼び出しに変換し、オラクルは各候補にラベルと有害度ティアを与え、ラッパーは各候補を防御自身の執行経路に渡す。スコアリングは判定とラベルを比較する。
ajar/core/        中間表現: 候補、プローブ、ラベル、有害度ティア
ajar/adapters/    ホストベンチマークアダプタ; agentdojo/ が参照実装
ajar/generate/    タスクから候補呼び出しを構築するフォールトファミリー
ajar/score/       リーケージ、十分性、過剰制限、攻撃許可
ajar/defenses/    Ajar自身の参照ベースライン、全許可から厳密オラクルまで
ajar/llm/         モデル接続部、LLMを呼び出す防御とジェネレータ用
tests/
scripts/
git clone https://github.com/reSHARMA/Ajar.git
cd Ajar
pip install -e .
bash scripts/bootstrap.sh     # 何が存在し何が欠けているかを報告する
Ajarは自身が同梱しないホストベンチマークに対してスコアリングする。参照アダプタの場合、AgentDojoのチェックアウトを指定する:
git clone https://github.com/ethz-spylab/agentdojo.git bench/agentdojo
python scripts/export_probes.py --benchmark agentdojo
これによりプローブスイートが書き出される: タスク、それらから構築された候補呼び出し、および各候補のラベルと有害度ティアである。
過剰特権リーケージとは、防御が許可した過剰呼び出しの有害度で重み付けした割合である。各過剰呼び出しは、それが実行された場合に何をなし得るかに応じて増大する重みを持ち、ユーザー自身の状態の可逆的な読み取りから、第三者や資金に対する不可逆的な行動にまで及ぶ。
十分性とは、タスクが真に必要とする呼び出しのうち、防御が通す割合である。これをリーケージと併せて報告することで、どちらもゲーム化されるのを防ぐ。すべてを拒否する防御は何も漏らさず、すべてを許可する防御はタスクが必要とするものを何も拒否しない。
さらに2つの数値が付随する。過剰制限は防御が拒否した正当な呼び出しを数え、攻撃許可はすべてのシンク呼び出しを許可した攻撃を数える。
防御は1つの決定を実装する: 提案された呼び出しと既に実行された呼び出しが与えられたとき、それを許可するか拒否するか。これを ajar.defenses.base に対して実装し、登録すれば、Ajarは他のすべての防御が見るのと同じテストで4つの数値すべてを報告する。
ajar/defenses/baselines.py には4つの参照手続き — 全許可、ツール名許可リスト、引数厳密オラクル、全拒否 — が含まれており、両端でスケールを規定し、新しい防御がその間に位置するための基準を与える。
MIT。LICENSE を参照。

