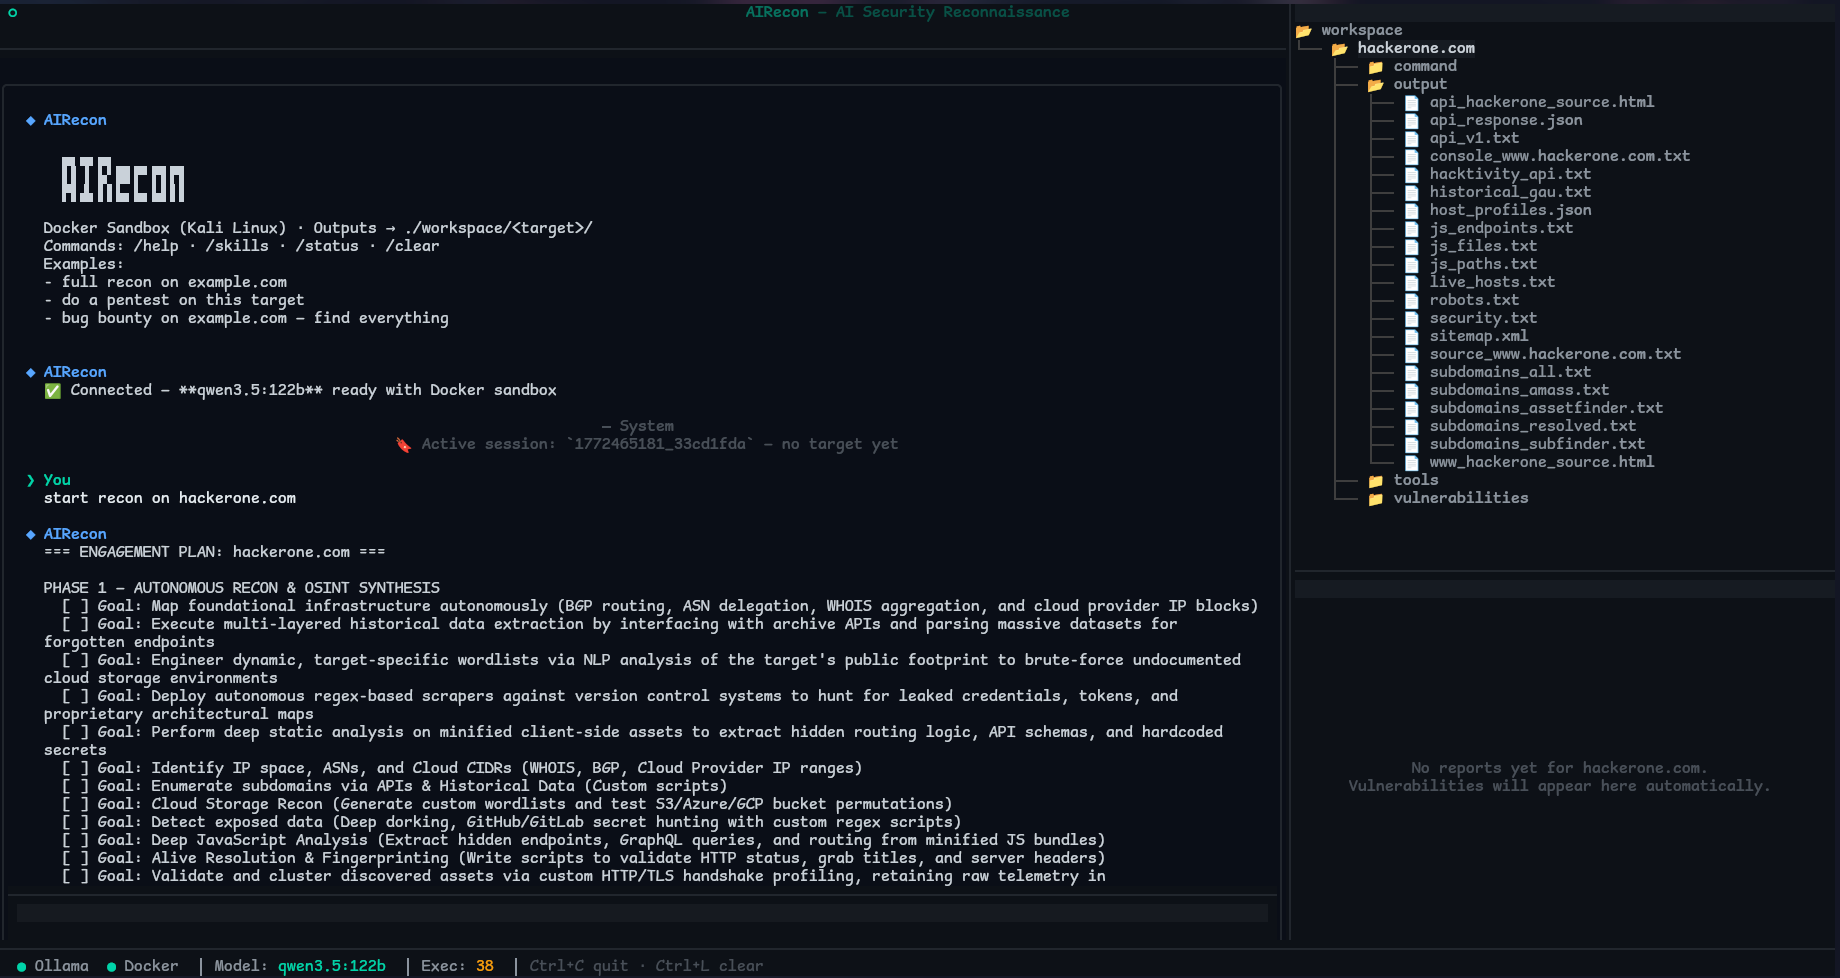





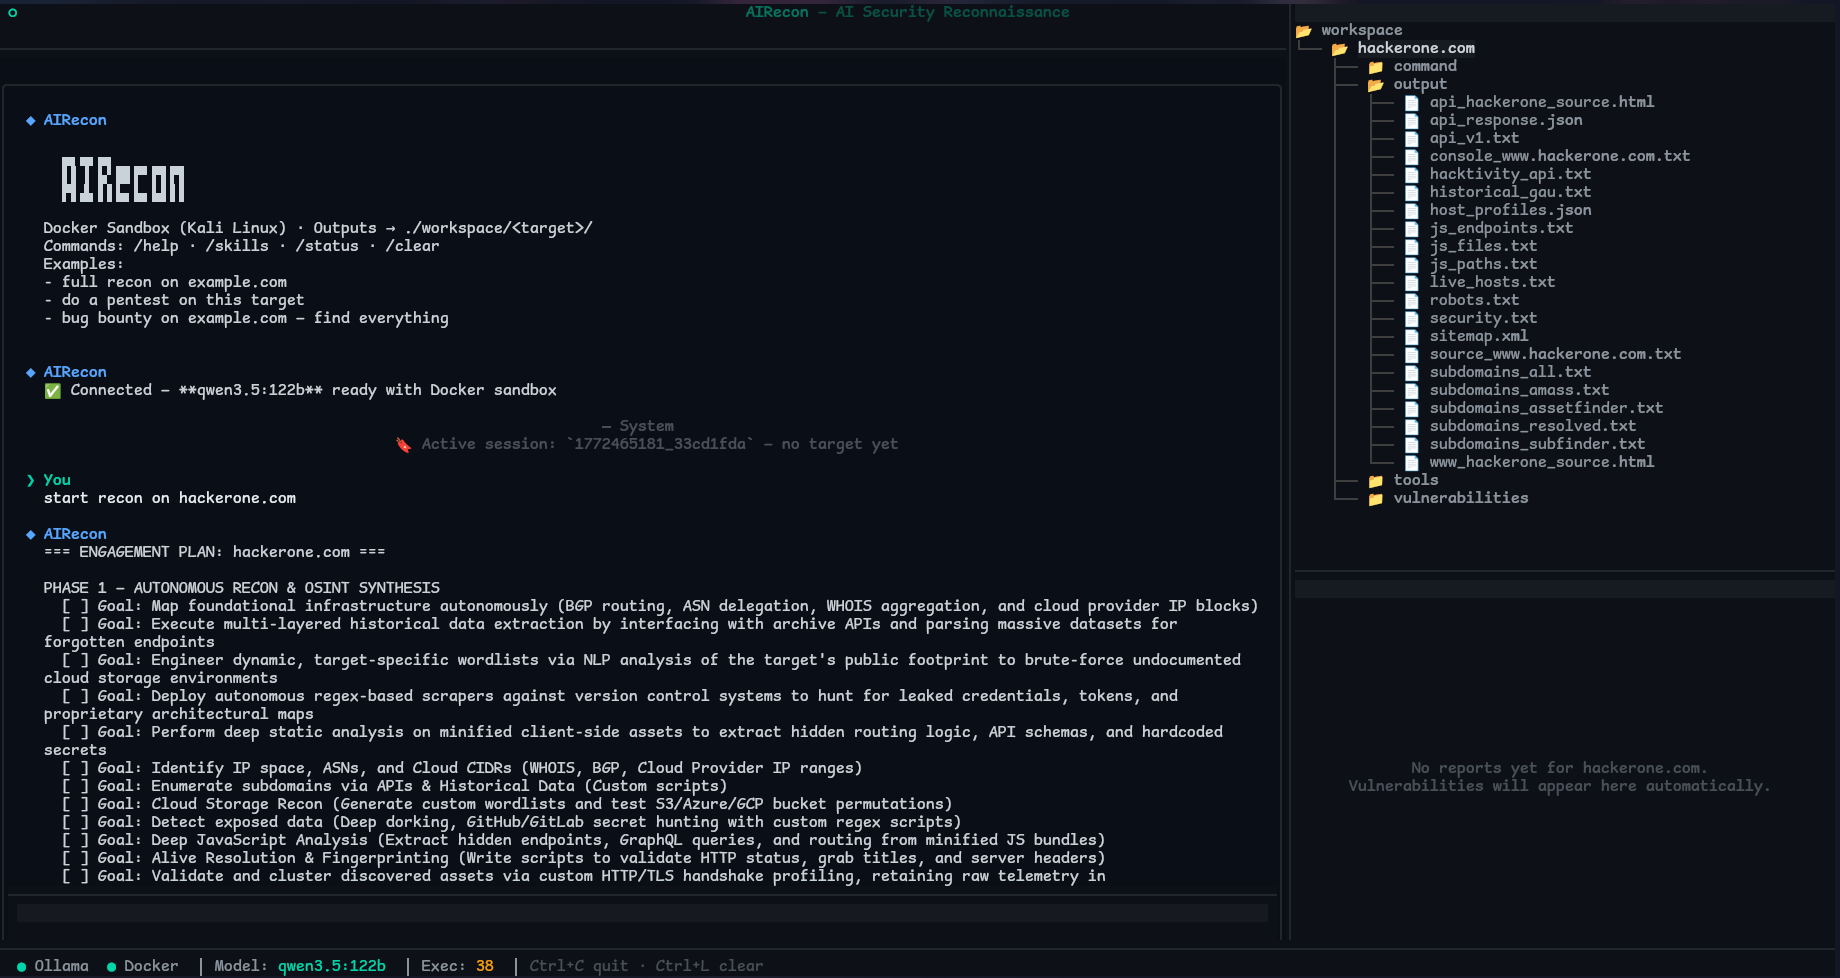
AIReconは、任意のOpenAI互換LLMゲートウェイ(LiteLLM / vLLM / ホスト型エンドポイント、またはローカルOllamaをプロキシするローカルゲートウェイ)を、Kali Linux Dockerサンドボックス、ネイティブなCaidoプロキシ統合、構造化されたRECON → ANALYSIS → EXPLOIT → REPORTパイプライン、そしてリアルタイムTextual TUIで駆動する自律型ペネトレーションテストエージェントです。
設計上バックエンド非依存。 AIReconをローカルゲートウェイ(LiteLLM / vLLM、またはローカルOllamaをプロキシするゲートウェイ)に向ければ完全オフライン / プライベート運用が可能になり、ホスト型のOpenAI/Anthropic/Gemini互換エンドポイントに向ければ最大限の推論品質が得られます。推論サポートは実行時に自動検出されます — モデルごとのハードコーディングは不要です。
Swiftproxyは、220以上のロケーションにわたる9,000万以上のクリーンなレジデンシャルIPを提供し、HTTP(S)/SOCKS5、IPローテーション、スティッキーセッション、正確なジオターゲティングをサポートしています。AI搭載のリサーチおよび偵察ワークフローがさまざまなロケーションからウェブサイトに確実にアクセスできるようにし、ウェブリサーチ、データ収集、スクレイピング、ロケーションベースのアクセスに適しています。
無料テストが利用可能で、コードPROXY90を使用すると10%オフになります。
AIReconは単一のOpenAI互換ゲートウェイと通信するため、トレードオフを選択できます — プライバシーとAPIコストゼロのためにローカルモデルを実行するか、最高の推論品質のためにホスト型モデルを実行するか。同じエージェント、パイプライン、サンドボックス、ツールがどちらでも機能します。
| 機能 | AIRecon |
|---|---|
| バックエンド | 任意のOpenAI互換ゲートウェイ(LiteLLM / vLLM / ホスト型) |
| 完全オフライン / APIキー不要 | はい — ローカルゲートウェイ(vLLM、またはゲートウェイ → ローカルOllama)を使用する場合 |
| 推論検出 | 実行時に自動(モデル名のハードコーディングなし) |
| Caido統合 | ネイティブ |
| スコープガード + 監査ログ | はい — スコープ外のターゲットを拒否し、すべてのコマンドをログ記録 |
| 検証済みのみの学習 | はい — ブレインはノイズではなく、証明された発見を蓄積 |
| セッション再開(チャット + ツール呼び出し) | はい |
| ローカルナレッジベース | 約109万レコード(オプション) |
§FUZZ§)、findings、scope、sitemap、intercept。dataset_searchを自律的に呼び出し、その判断を実際にインデックス化されたデータに基づかせます。RECON → ANALYSIS → EXPLOIT → REPORT
各フェーズには、特定の目的、推奨ツール、自動移行基準があります。フェーズの強制はソフトです — エージェントは誘導されますが、ブロックされることはありません。チェックポイントは5回(フェーズ評価)、10回(自己評価)、15回(コンテキスト圧縮)のイテレーションごとに実行されます。
AIReconはLLMをファインチューニングしません。その「学習」はローカルで構造化されたテレメトリであり、ツール選択を導き、失敗したパスの繰り返しを避けます。
ローカル永続化(すべてディスク上、クラウドなし):
~/.airecon/memory/airecon.db のSQLiteメモリDBに、セッション、検出結果、パターン、ターゲットインテル、ツール使用状況、モデルパフォーマンス、スキル使用状況、攻撃チェーンの発見を保存。~/.airecon/learning/global_learning.json の適応学習状態(ツールパフォーマンス統計、戦略パターン、観察ログ、蒸留されたインサイト)。~/.airecon/memory/by_target/ 配下のターゲット別メモリファイルに、エンドポイント、脆弱性、WAFバイパス、機密パラメータ、認証エンドポイントを保存。workspace/<target>/payload_memory.json に保存可能。動作への影響:
tech_correlations データセットからナレッジブリーフを注入します — つまり、データセットはイテレーション1から頭脳として使用されます。intelligence_memory_recall_interval イテレーションごと(デフォルト 4)に、検出された技術に基づいて学習済みパターン/コールドスタートナレッジが再注入されます。相関は intelligence_correlation_interval ごと(デフォルト6)に実行されます。intelligence_learn_only_verified、デフォルトでオン)。intelligence_adaptive_min_observations(デフォルト2)の観察後に開始されます。AIReconは、ゲートウェイが公開するあらゆるモデル(GPT、Claude、Gemini、Qwen、GLM、DeepSeek、ローカルのOllama/vLLMモデルなど)で動作します。重要な機能は2つあります:
⚠️ ネイティブのツール/関数呼び出しが必須です。 これがないと、エージェントはどのツール(http_observe、execute、browser、Caidoなど)も実行できず、機能しません。
openai_supports_native_tools: trueを維持してください。推論は自動検出されます。
autoモードでは、AIReconはOpenAI標準のreasoning_effortを送信し、バックエンドがそれを拒否した場合(HTTP 400 未サポートパラメータ)、それを削除して記憶します — つまり、推論モデルは思考し、通常のモデルは壊れません。維持すべきモデル名リストはありません。
品質ガイダンス(プロバイダーに依存しない):
ローカル/オフラインセットアップでは、ローカルゲートウェイ(Ollama/vLLM)の背後でモデルを実行し、openai_base_url をそこに向けてください(設定を参照)。品質はAIReconではなくモデルに比例します。
GPUがない場合、またはローカルのVRAMが最小要件を下回る場合、無料のGoogle Colab T4 GPUでOllamaを実行し、公開トンネル経由でAIReconに接続できます。
ノートブックを開く:
仕組み:
Google Colab GPU                     Your Local Machine
┌──────────────────────────────┐          ┌──────────────────────────────┐
│  Local gateway (qwen3:8b)    │◄────────►│  AIRecon TUI                 │
│  cloudflared tunnel          │  HTTPS   │  openai_base_url: <tunnel>/v1│
└──────────────────────────────┘          └──────────────────────────────┘
手順:
~/.airecon/config.yaml にコピーします(Colabはトンネルの背後でOpenAI互換ゲートウェイを実行します):openai_base_url: "https://xxxx.trycloudflare.com/v1" # printed by Cell 6 (note the /v1)
openai_api_key: "" # set if the gateway requires one
openai_model: "qwen3:8b"
llm_timeout: 300.0
llm_chunk_timeout: 300.0
llm_context_window: 32768
llm_context_window_small: 16384
airecon startColab GPU → モデルの利用可否:
| Colab GPU | VRAM | 利用可能なモデル | プラン |
|---|---|---|---|
| T4 | 15 GB | qwen3.5:9b | 無料 |
| L4 | 22 GB | qwen3.5:35b-a3b (MoE) | Pro |
| A100 | 40 GB | qwen3.5:35b | Pro+ |
| H100 | 80 GB | qwen3.5:122b | Pro+ |
制限事項:
qwen3.5:9b を使うT4が最小構成です — ローカルの35B以上のモデルと比べて応答が遅く、ツール呼び出しエラーが増えることを想定してくださいscripts/airecon_colab.ipynb にあります。セルフホストや改変をしたい場合はこちらを利用してください前提条件: Python 3.12+、Docker 20.10+、openai_base_url で到達可能な OpenAI互換のLLMゲートウェイ(例: http://localhost:20128/v1 上のローカルOpenAI互換ゲートウェイ — これはそれ自体がローカルのOllama/vLLMをプロキシできます — またはホストされたエンドポイント)、git、curl


