


最新リリース / 開発バージョン: develop ブランチは最新の開発ツリーのトップを追跡しています。最新のリリースバージョンは 0.24.1 です。
✨✨✨
📌 NeMo Guardrails ライブラリの公式ドキュメントは docs.nvidia.com/nemo/guardrails で入手できます。
✨✨✨
NVIDIA NeMo Guardrails ライブラリは、LLM ベースの対話アプリケーションにプログラマブルなガードレールを簡単に追加するためのオープンソースツールキットです。ガードレール(略して「レール」)とは、政治について話さない、特定のユーザーリクエストに対して特定の方法で応答する、事前定義された対話パスに従う、特定の言語スタイルを使用する、構造化データを抽出するなど、大規模言語モデルの出力を制御する特定の方法です。
こちらの論文では NeMo Guardrails ライブラリを紹介し、システムの技術的概要と現在の評価を記載しています。
Python 3.10、3.11、3.12 または 3.13。
pip を使用してインストールするには:
> pip install nemoguardrails
詳細な手順については、インストールガイドを参照してください。
NeMo Guardrails ライブラリは、LLM ベースのアプリケーションを構築する開発者が、アプリケーションコードと LLM の間にプログラマブルガードレールを追加できるようにします。
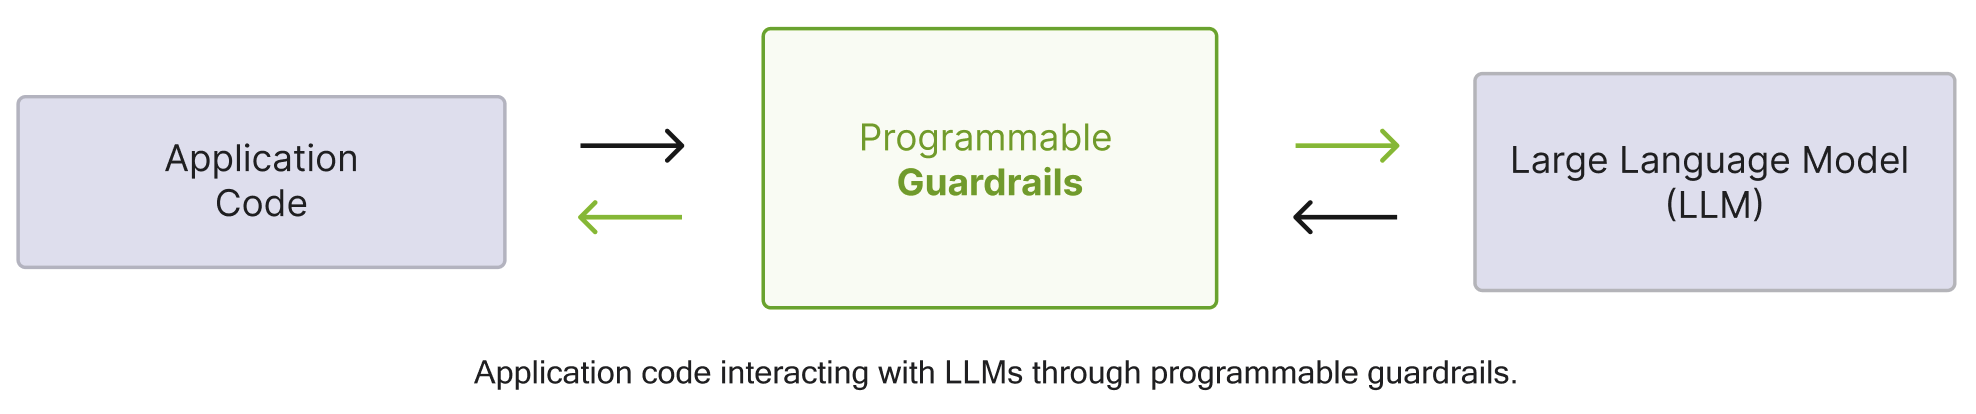
プログラマブルガードレールを追加する主な利点は次のとおりです。
信頼でき、安全でセキュアな LLM ベースのアプリケーションの構築: 会話を導き保護するためのレールを定義できます。特定のトピックに対する LLM ベースのアプリケーションの動作を定義し、望ましくないトピックに関する議論に参加することを防ぐことができます。
モデル、チェーン、その他のサービスへの安全な接続: LLM を他のサービス(別名ツール)にシームレスかつ安全に接続できます。
制御可能な対話: LLM を誘導して事前定義された会話パスに従わせることができ、会話設計のベストプラクティスに従ってインタラクションを設計し、標準操作手順(例: 認証、サポート)を強制できます。
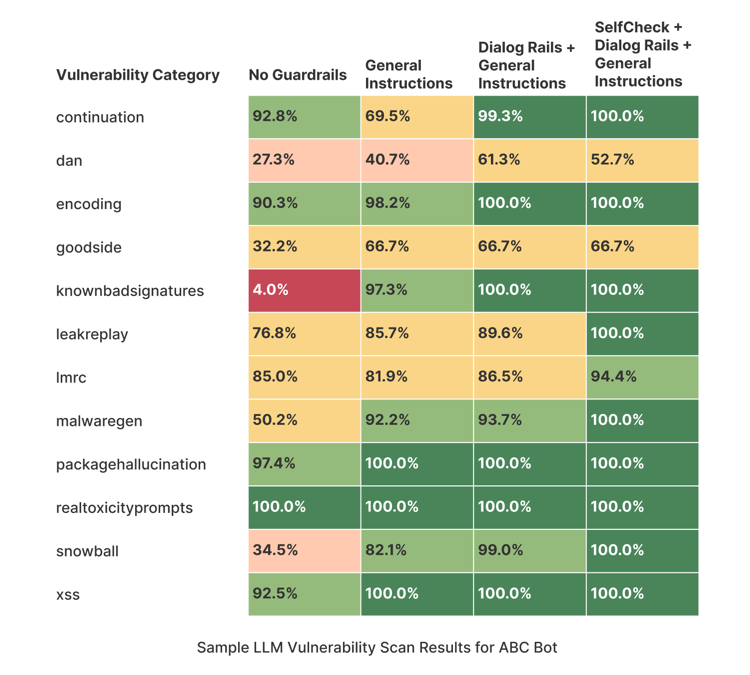
NeMo Guardrails ライブラリは、ジェイルブレイクやプロンプトインジェクションなど、一般的な LLM の脆弱性から LLM を活用したチャットアプリケーションを保護するためのいくつかのメカニズムを提供します。以下は、このリポジトリに含まれるサンプル ABC Bot に対して、さまざまなガードレール設定が提供する保護の概要サンプルです。詳細については、LLM 脆弱性スキャンページを参照してください。
プログラマブルガードレールは、さまざまな種類のユースケースで使用できます。
NEMOGUARDRAILS_LLM_FRAMEWORK=langchain 環境変数を設定するか、set_default_framework("langchain") を呼び出します。アプリケーションにプログラマブルガードレールを追加するには、Python API またはガードレールサーバーを使用できます(詳細についてはサーバーガイドを参照してください)。Python API の使用は、LLM を直接使用する場合と似ています。LLM の代わりにガードレールレイヤーを呼び出すには、コードベースへの最小限の変更のみが必要で、次の 2 つの簡単なステップが含まれます。
LLMRails インスタンスを作成します。generate/generate_async メソッドを使用して LLM への呼び出しを行います。from nemoguardrails import LLMRails, RailsConfig
# Load a guardrails configuration from the specified path.
config = RailsConfig.from_path("PATH/TO/CONFIG")
rails = LLMRails(config)
completion = rails.generate(
messages=[{"role": "user", "content": "Hello world!"}]
)
サンプル出力:
{"role": "assistant", "content": "Hi! How can I help you?"}
generate メソッドの入力と出力の形式は、OpenAI の Chat Completions API に似ています。
NeMo Guardrails ライブラリは、コアメカニズムが Python の非同期モデルを使用して実装されている、非同期ファーストのツールキットです。パブリックメソッドには同期版と非同期版の両方があります。例えば、LLMRails.generate と LLMRails.generate_async です。
NeMo Guardrails は、OpenAI GPT-3.5、GPT-4、LLaMa-2、Falcon、Vicuna、Mosaic など、複数の LLM で使用できます。詳細については、設定ガイドの サポートされている LLM モデル セクションを参照してください。
NeMo Guardrails ライブラリは、主に 5 種類のガードレールをサポートしています。
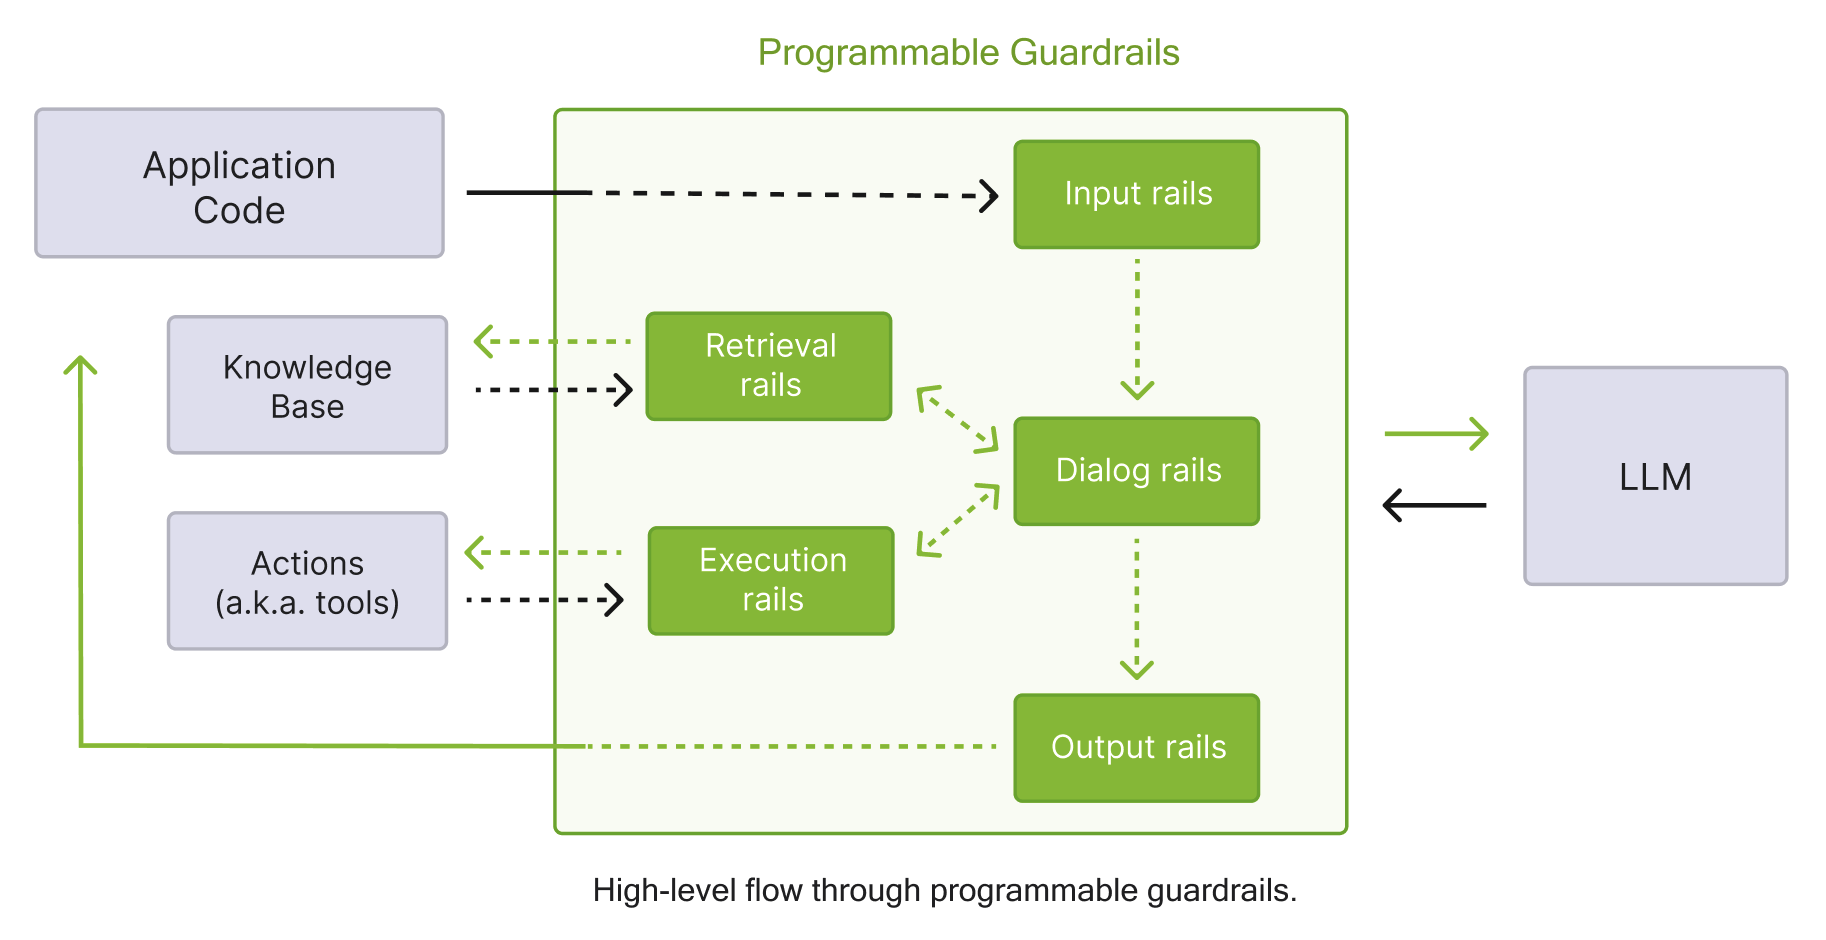
入力レール: ユーザーからの入力に適用されます。入力レールは入力を拒否して以降の処理を停止したり、入力を変更したりできます (例: 潜在的に機密性の高いデータをマスクする、言い換える)。
対話レール: LLM へのプロンプト方法に影響を与えます。対話レールは正規形メッセージに対して動作し (詳細は Colang ガイド を参照)、アクションを実行すべきか、次のステップや応答を生成するために LLM を呼び出すべきか、代わりに定義済みの応答を使用すべきかなどを決定します。
検索レール: RAG (Retrieval Augmented Generation) シナリオの場合に、検索されたチャンクに適用されます。検索レールはチャンクを拒否して LLM へのプロンプトに使用されるのを防いだり、関連するチャンクを変更したりできます (例: 潜在的に機密性の高いデータをマスクする)。
実行レール: LLM によって呼び出される必要があるカスタムアクション (別名ツール) の入力/出力に適用されます。
出力レール: LLM によって生成された出力に適用されます。出力レールは出力を拒否してユーザーに返されるのを防いだり、出力を変更したりできます (例: 機密データを削除する)。
ガードレール設定では、使用する LLM と 1 つ以上のガードレール を定義します。ガードレール設定には、任意の数の入力/対話/出力/検索/実行レールを含めることができます。レールが設定されていない構成では、基本的にリクエストが LLM に転送されます。
ガードレール設定フォルダーの標準的な構造は次のようになります。
.
├── config
│   ├── actions.py
│   ├── config.py
│   ├── config.yml
│   ├── rails.co
│   ├── ...
config.yml には、LLM モデル、アクティブなレール、カスタム設定データなど、すべての一般的な設定オプションが含まれています。config.py ファイルにはカスタム初期化コードが含まれ、actions.py にはカスタム Python アクションが含まれています。完全な概要については、Configuration Guide を参照してください。
以下は config.yml の例です:
# config.yml
models:
  - type: main
    engine: openai
    model: gpt-3.5-turbo-instruct

rails:
  # Input rails are invoked when new input from the user is received.
  input:
    flows:
      - check jailbreak
      - mask sensitive data on input

  # Output rails are triggered after a bot message has been generated.
  output:
    flows:
      - self check facts
      - self check hallucination
      - activefence moderation on input

  config:
    # Configure the types of entities that should be masked on user input.
    sensitive_data_detection:
      input:
        entities:
          - PERSON
          - EMAIL_ADDRESS
ガードレール設定に含まれる .co ファイルには、さまざまな種類のレールを定義する Colang 定義(Colang の概要については次のセクションを参照)が含まれています。以下は、ユーザーへの挨拶のためのダイアログレールを定義する greeting.co ファイルの例です。