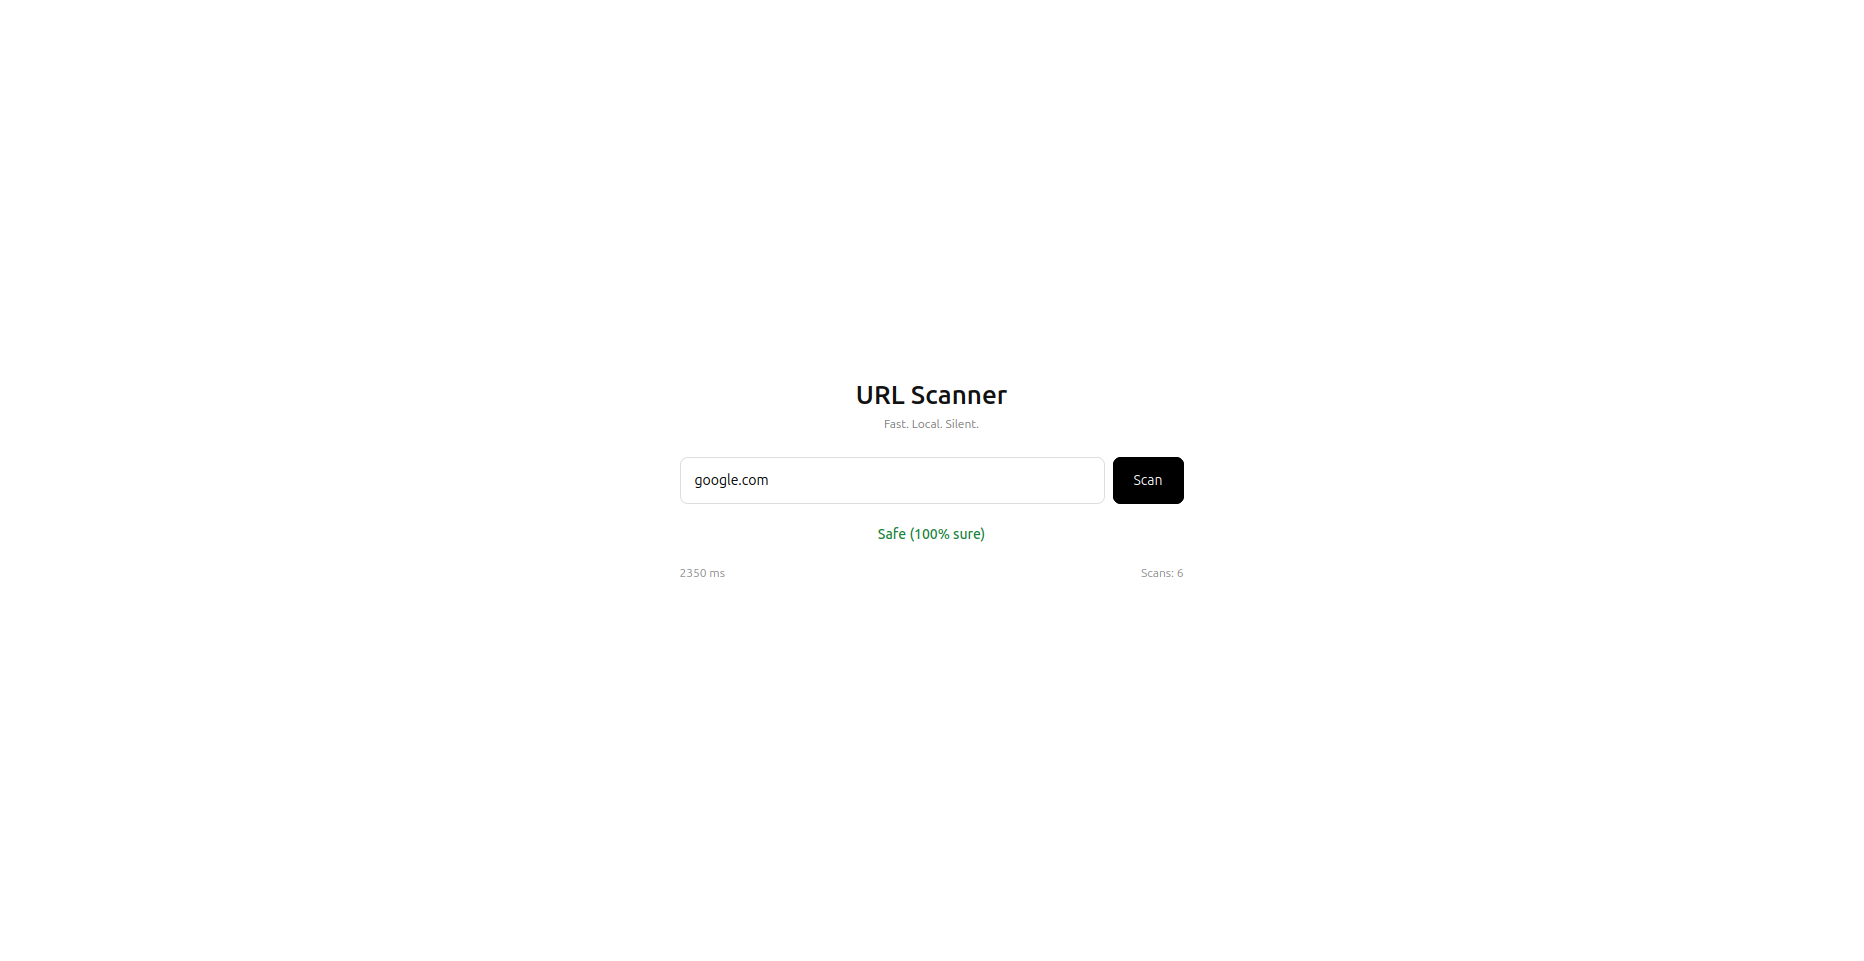
URLフィッシングチェッカー


機械学習(ランダムフォレスト/SVM)とヒューリスティックなルールベース分析を組み合わせたハイブリッドアプローチにより、URLがフィッシングまたは安全である可能性を検出する軽量なWebベースのツールです。
サイバーセキュリティと応用AIにおける教育目的および実験用に作成されました。
概要
フィッシング攻撃は、しばしば視覚的な欺瞞とURLの操作に依存します。このツールは、URLの構造と内容を分析して、その悪意のある意図を判断します。
主な機能
- リアルタイム分析: URLを受け取り即座に処理します。
- ハイブリッド検出: MLの確率とハードコードされたセキュリティルールを組み合わせます。
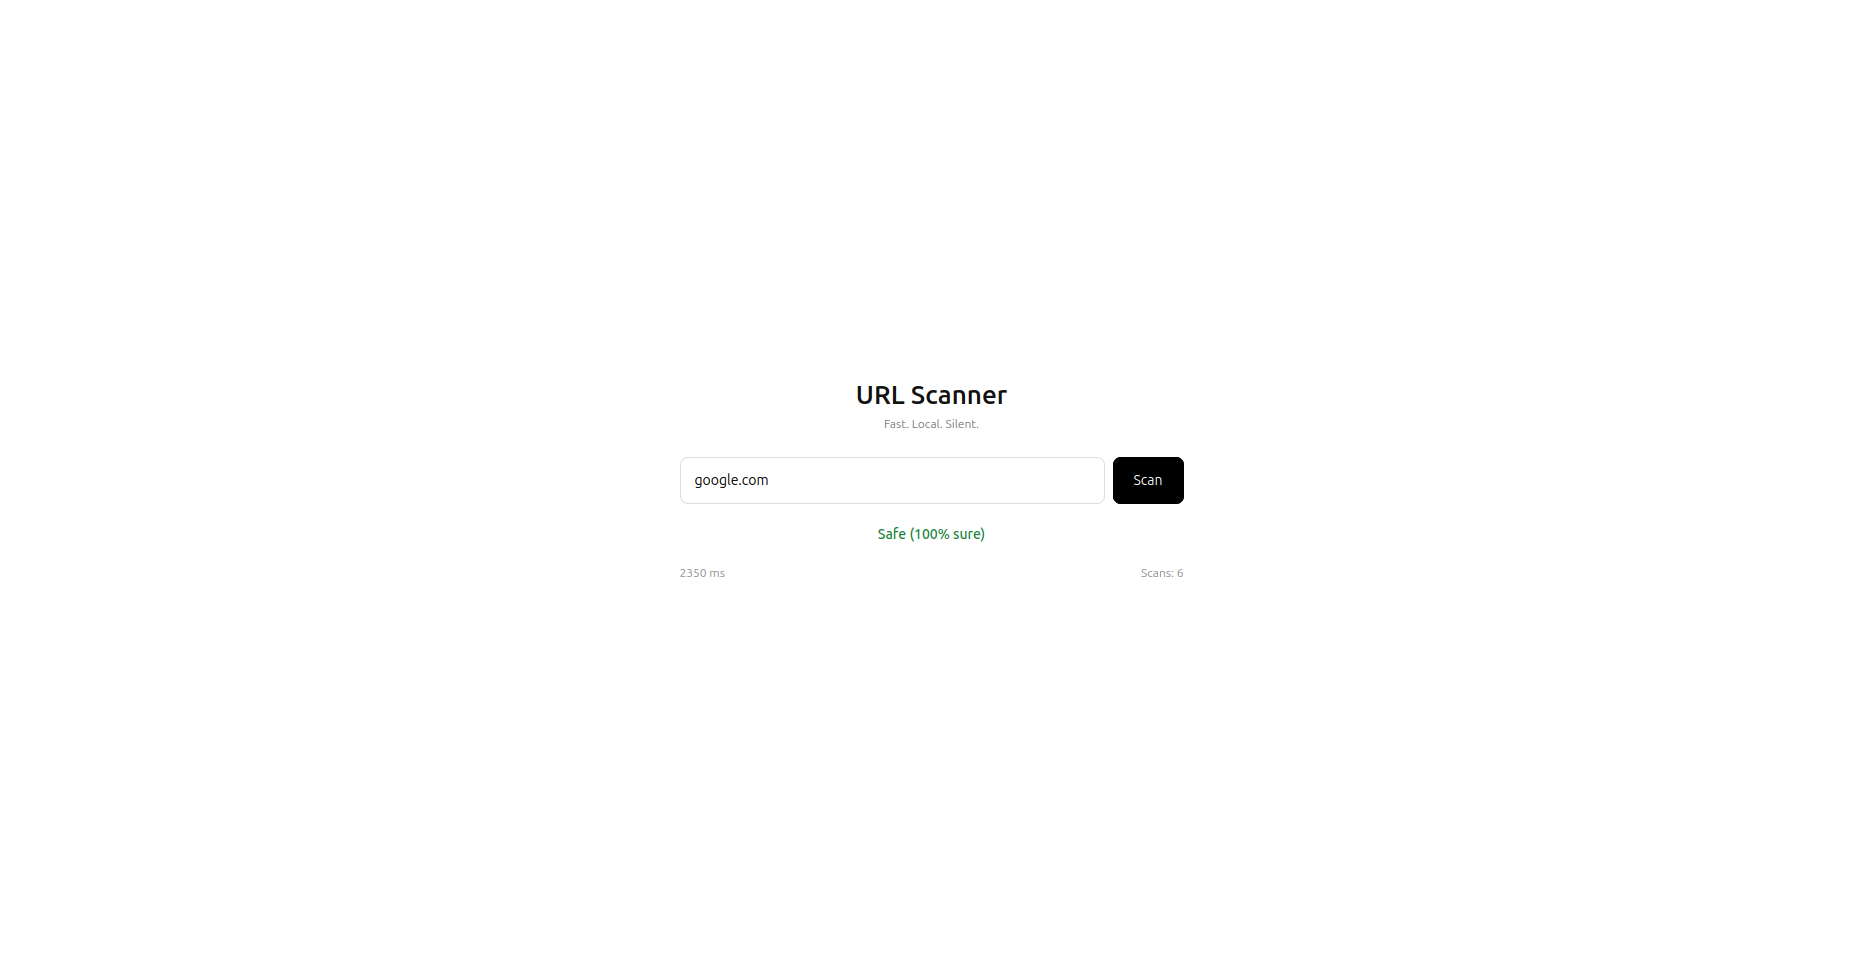
- 説明可能性: 信頼度スコアと人間が読める理由(例:「不審なキーワードが見つかりました」)を返します。
- パフォーマンス: 結果をローカルにキャッシュして冗長な処理を削減します。
- APIサポート: プログラムによるアクセスのためのJSONエンドポイントを含みます。
仕組み
- 入力: ユーザーがUIまたはAPIを介してURLを送信します。
- 正規化: URLがクリーンアップされ、標準コンポーネントが解析されます。
- 特徴抽出: システムは数値およびカテゴリ特徴(例:長さ、特殊文字数、ドメインの経過期間)を抽出します。
- 予測: * MLモデルが確率スコアを計算します。
- ルールベースのロジックが既知の危険信号をスキャンします。
- 出力: 判定結果を含むJSONレスポンスが返され、将来のルックアップのためにキャッシュされます。
セットアップ
- リポジトリをクローンする
- 依存関係をインストール:
pip install -r requirements.txt
- Kaggleからデータセットをダウンロードし、
dataset_phishing.csvをルートに配置する
python retrain.pyを実行してmodel.pklを生成するpython app.pyを実行する
技術スタック
- コア: Python 3.x
- Webフレームワーク: Flask
- 機械学習: scikit-learn, pandas, joblib
- アーキテクチャ: REST API + シンプルなHTML/CSSフロントエンド
⚠️ 免責事項
-
教育目的のみ: このツールはフィッシング攻撃に対する100%の保護を保証するものではありません。
-
予測は確率的であり、使用されたトレーニングデータに基づきます。
-
誤検知(安全なサイトがフィッシングと判定される)や見逃し(フィッシングサイトが安全と判定される)が発生する可能性があります。
-
このツールを唯一のセキュリティ対策として依存しないでください。