██████╗ ███████╗ █████╗ ████████╗██╗ ██╗███████╗██╗ ███████╗███████╗██████╗
██╔══██╗██╔════╝██╔══██╗╚══██╔══╝██║ ██║██╔════╝██║ ██╔════╝██╔════╝██╔══██╗
██║ ██║█████╗ ███████║ ██║ ███████║███████╗██║ █████╗ █████╗ ██████╔╝
██║ ██║██╔══╝ ██╔══██║ ██║ ██╔══██║╚════██║██║ ██╔══╝ ██╔══╝ ██╔═══╝
██████╔╝███████╗██║ ██║ ██║ ██║ ██║███████║███████╗███████╗███████╗██║
╚═════╝ ╚══════╝╚═╝ ╚═╝ ╚═╝ ╚═╝ ╚═╝╚══════╝╚══════╝╚══════╝╚══════╝╚═╝
現在のスレッドを終了し、実行再開前に復元し、さらに実行中でないときにページ保護の変更を実装する、回避技術のPoC実装です。
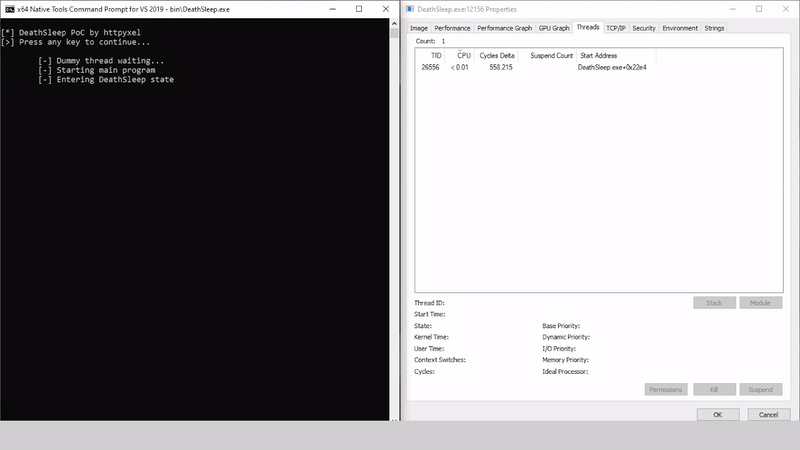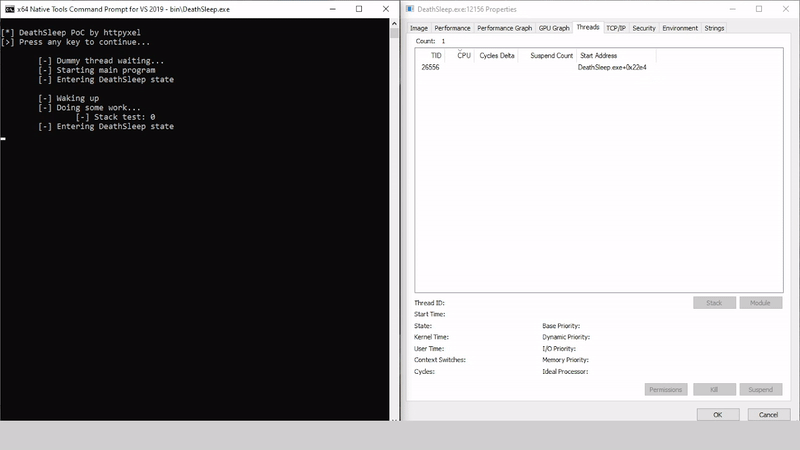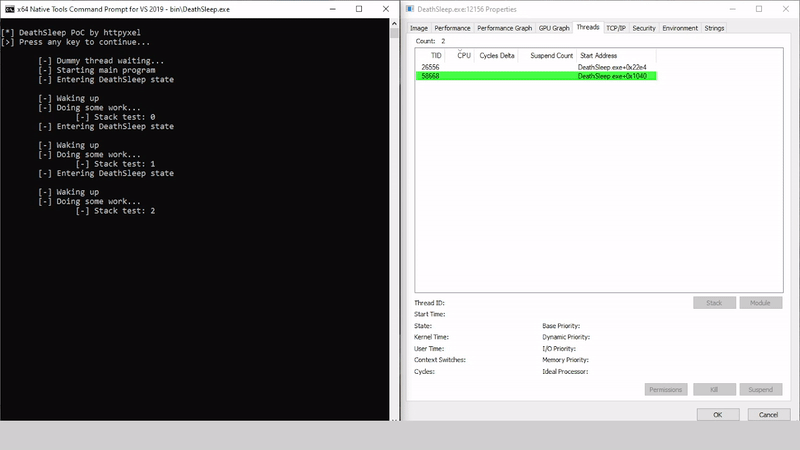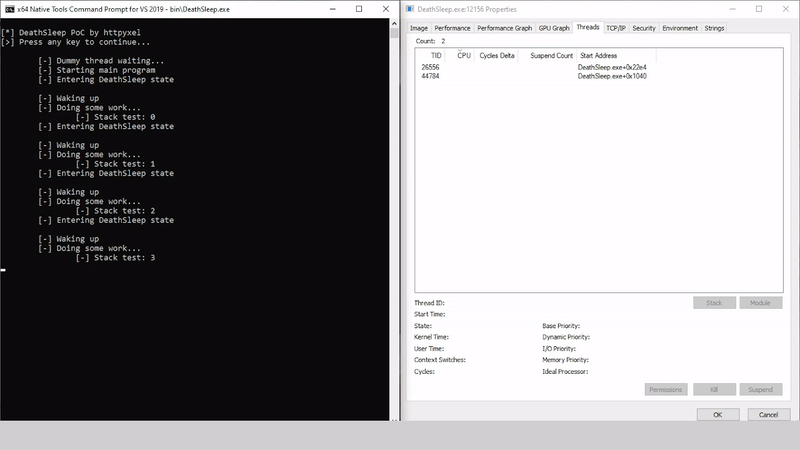
スリープおよび難読化手法は、maldevコミュニティでよく知られており、さまざまな実装があります。目的は、スリープ中にメモリスキャナーから隠れることで、通常はページ保護を変更し、シェルコードの暗号化などの優れた機能を追加することもあります。しかし、シェルコードを隠すためのもう一つの重要なポイントがあります。それは、現在の実行スレッドを隠すことです。 スタックのスプーフィングはクールですが、少し考えた後、スタックがなければスタックをスプーフィングする必要はないのではないかと思いました :)
このテクニックの有用性は読者の評価に委ねますが、いずれにせよ、いくつかのトピックを復習し、私のようにこの世界に足を踏み入れたばかりの人にとっては、maldevを学ぶためのクールな方法だと思います。
ここで示す主な実装では、スタックから取り出す必要があるすべてのものをデータセクションにグローバル変数として保持しますが、すべてをヒープに移動する実装も間もなく公開されます。このコードを PIC かつインジェクタブルにするために必要な主要な変更を示すことを目的としています。
このリポジトリは GitHub と GitLab 間でミラーリングされています。
ここに記載されていることはすべて、読み物または開発中の経験から得た、さまざまなトピックに対する私の理解に基づいています。私は専門家ではないこと、そして最も避けたいのは誤った情報を広めることであることを自覚しています。そのため、何か正しくないと思われる点があれば、Twitter で連絡していただくか、このリポジトリで issue を開いていただければ幸いです。ご理解いただきありがとうございます。
このテクニックの主な目的は明確です。現在のスレッドを終了し、実行再開前に復元することです。しかし、これは具体的に何を意味し、どのような新しい制約が生じるのでしょうか? 実行を復元するには、スレッドを終了する前に2つのことを保存する必要があります。1つ目は CPU の状態、2つ目はスタックです。そして、新しいスレッドが起動された後に、それらを効果的に再設定する必要があります。
このテクニックで生じる新しい制約について述べましたが、主なものは2つあります。1つ目は、スレッドが終了してからスタックが復元されるまでの間に必要なものはすべてスタックの外に保存する必要があることです。これにより、いくつかの新しい課題が生じることが後でわかります。 2つ目は、プロセス内に常に少なくとももう1つのスレッドが実行されている必要があることです。なぜなら、自スレッドを終了しているため、他のスレッドがなければプロセスは終了するからです。これは大きな問題ではないと思います。ほとんどのエージェントは他のプロセスにインジェクションされるため、そのプロセスには少なくとも1つのスレッドが実行され続けると想定できます。
この POC には4つのコア関数があります:
スタックを保存しようとするとき、疑問が生じます: スタックのどの程度を保存する必要があるのでしょうか?
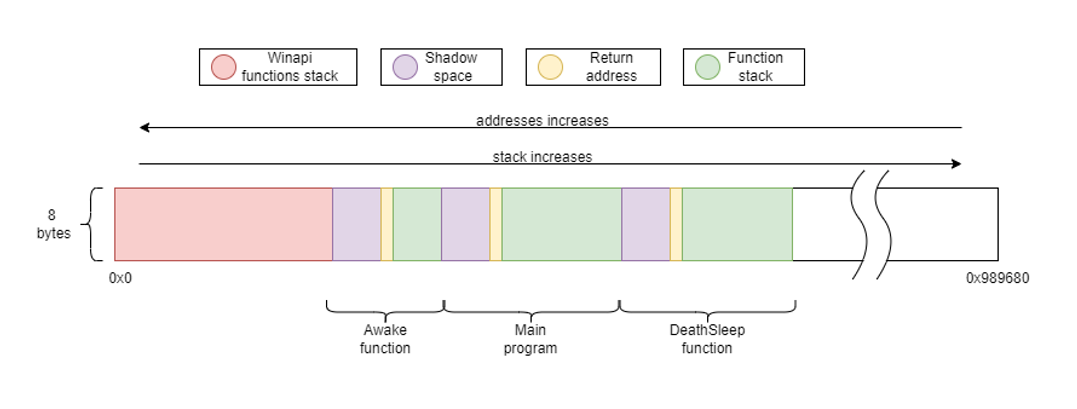
DeathSleep 関数(コンテキスト、スタックを保存し、難読化と復元のためのすべてを準備する関数)を呼び出した後のスタックの内容を最初に確認しましょう。
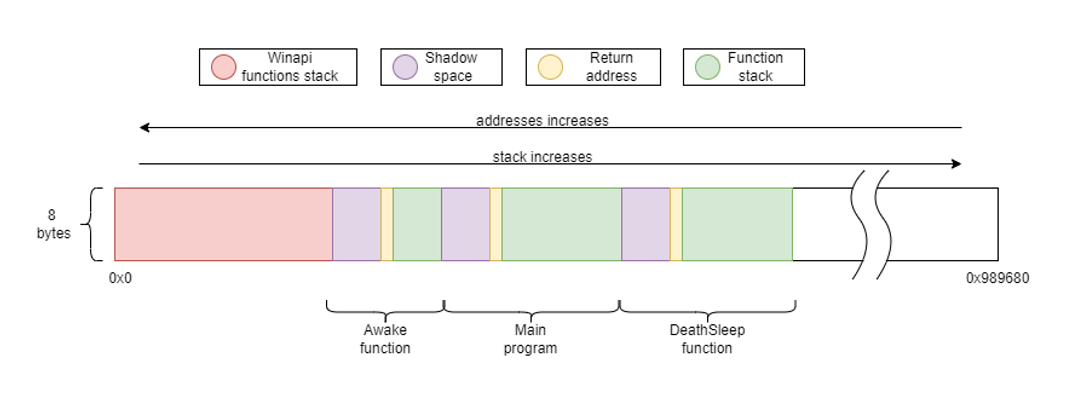
見てわかるように、すべての関数には3つの部分があります:
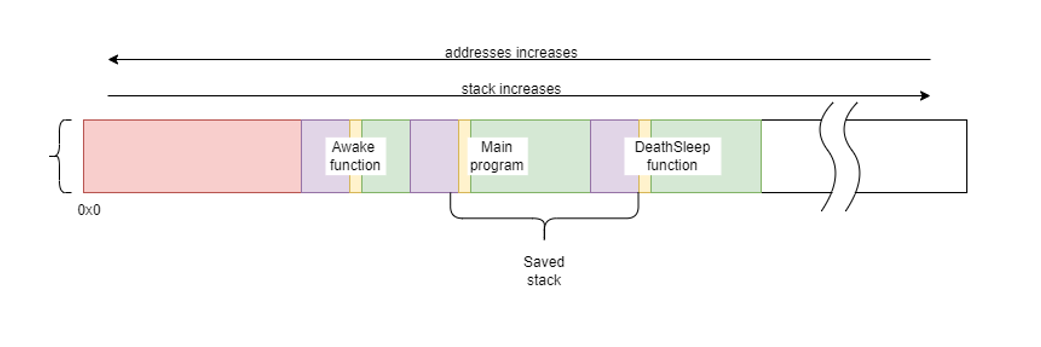
明らかに保存する必要があるスタックの最小部分は、メインプログラム内のすべて、つまりそのシャドウスペース、リターンアドレス、および DeathSleep 関数までのすべてです。 それ以前のものは実際には必要ありません(エントリ関数で使用されたスタックを保存することには利点がありますが、これについては後で説明します)。なぜなら、それは新しいスレッドを起動するための Windows ルーチンによって使用されるスタックだからです。 これに加えて、DeathSleep 関数のシャドウスペースも保存することにしました(実際には必要ありませんが、起床時の Rsp の計算が容易になります)。
したがって、最終的には以下を保存しています:
標準的なコンパイルでは、すべての関数は3つの部分、つまりプロローグ、関数コード、エピローグで構成されるべきです。
Rsp(スタックポインタ)は、関数のプロローグとエピローグでのみ変更されるべきです。プロローグでは、レジスタを保存し、すべてのローカル変数を保持し、さらにシャドウスペースを保持するためにスタックポインタを増加させ(スタックを増加させることはアドレスを減少させることを意味します)、エピローグではその逆を行います。
つまり、関数コード内のスタックポインタは常にシャドウスペースの終端(上の画像の紫色の部分)を指し、関数のスタックサイズとシャドウスペースの合計は、プロローグがスタックポインタをどれだけ増加させるかを計算することで求められます。この値は、アンワインドテーブルに保持されている情報を使用して簡単に計算できます。これらのテーブルの使用方法についてはここでは説明しませんが、要約すると、これらのテーブルは他のスレッドやプロセスがスタックを正しく移動してその内容を表示したり、例外を処理したり、分析したりできるようにするために使用されます。
コンテキストのキャプチャはおそらく最も簡単な作業の1つです。DeathSleep の最初の行で、不揮発性レジスタが変更される前に RtlCaptureContext() を呼び出すだけです。 ただし、実行を復元するコンテキストには2つの変更を加える必要があります。
1つ目は Rip の変更です。Rip は次に実行する命令を保持するレジスタであり、そのままにしておくと実行は DeathSleep 関数内で再開されます。Rip を DeathSleep のリターンアドレスを保持するように変更します。これは、エピローグで増加されたサイズ(上の画像の緑色 + 紫色の領域)だけ変位した現在の Rsp が指すアドレスです。
2つ目の変更はスレッドが復元されたときに行われ、Rsp を復元したスタックの先頭を指すように設定することです。これは復元フェーズ中に行われます。新しいスタックがどこに配置されるか事前にわからないためです。この値は単に復元されたスタックの終了アドレスになります。後述するように、DeathSleep の呼び出し元によって予約されたシャドウスペースもコピーしているからです。これが DeathSleep 呼び出し前の RSP の値と正確に一致します。
起床のポイントに到達したら、実行を再開する直前に、保存したスタックを所定の位置に配置する必要があります。 保存したスタックは Awake 関数によってキャプチャされたアドレスから始まることがわかっているため、新しくキャプチャしたアドレスが、保存したスタックを配置する開始点になります。しかし、これには問題があります。古いスタックを配置した後に関数を呼び出すと、そのスタックが変更されて壊れてしまうからです。また、ここでクリーンアップを行うと非常に便利です。特に、スタックのバックアップに使用したヒープを解放する場合などです。 つまり、現在の Rsp と現在使用しているスタックの一部を、復元するスタックを配置する場所の外側に移動する必要があります。 問題を明確にするために、以下に図を示します:

そして、私の解決策は次のとおりです。すべてを移動するだけです:

すべての大変な作業を終えた後、最後に行うことは NtContinue を使用することです。この関数を使用すると、以前にキャプチャして変更したコンテキストで現在のコンテキストを変更できます。これにより、DeathSleep 呼び出し直後の RIP が設定され、すべてのレジスタは DeathSleep 呼び出し時と同じ値を持ち、RSP はスタックの先頭を指すようになります。
さて、現在のスレッドを保存および復元するために必要な基本はわかりましたが、スレッドがまったくない状態でもこれらすべてを実行できるようにする必要があります。 ここで、私たちの頼りになる Windows の Thread Pool API に出会います。これは、タスク(最大1つの引数を持つ関数)を、オペレーティングシステムによって完全に管理されるスレッドグループ(プール)にキューイングできるようにするツールです。 Ekko をご存知なら、この API を使用していることがわかります。ですから…同じ方法で実装しましょう。
すべてがうまくいきましたが、1つ問題がありました。キューイングされたタスクの実行が終了した後も、ワーカーが起動したままでした。これは、プログラムが生成する可能性のあるすべてのスレッドを破棄したいと考えていたため、問題でした。したがって、これは適切な方法ではありませんでした。
少し調べた結果、Ekko で使用されていたスレッドプール API は古いバージョンであり、より多くの機能を備えた新しいバージョンがあることがわかりました。その中には、問題を効果的に解決する関数 CloseThreadPool() があります。この新しい API を使用すると、独自のプールを作成し、使用後にそれらを破棄して、使用されたすべてのワーカーを終了できます。さらに2つの利点があります。スレッドの最大数を設定できることと、クリーングループを使用できることです。 スレッドの最大数を設定すると、時間差なくタスクがキューイングされる限り、すべてのタスクを順次実行できます。 クリーングループは、すべてが完了した後のクリーンアップを容易にするのに役立ちます。
これで完了でしょうか?さて、この時点でスレッドは終了しており、Awake をエントリポイントとする新しいスレッドを作成し、以前の状態を復元してプールを閉じる Rebirth 関数をキューイングしています。今のところ順調です!
前述のすべてが完了したとき、難しい部分は解決されたと思いました。この部分は以前のテクニックによってすでに解決されていたからです。しかし、なんと、思ってもみないことが起こりました。
主な問題は、コードの外部に処理をオフロードする必要があることです。メモリ保護を RW(読み取り/書き込み)に変更するため、VirtualProtect() を呼び出すと、関数が戻るときにプロセスがクラッシュします(RW ページでは命令を実行できません)。そのため、どこか別の場所からこれを実行し、RX(読み取り/実行)ページに戻る方法を見つける必要があります(戻るときも同様です)。 もちろん、このためにもスレッドプール API を使用しますが、問題があります。タスクに渡せる引数は1つだけですが、VirtualProtect() は4つの引数を取ります。
このために、再び NtContinue() を使用します。この関数のこの用途を最初に見たのは Foliage でしたが、Ekko でも使用されています。 NtContinue() は、前述のように、それを呼び出したスレッドにコンテキストを設定することができます。巧妙に調整することで、1つの引数(スレッドプール API に非常に便利)のみを使用して、複数の引数を持つ関数を「呼び出す」ことができます。 基本的な考え方は、RIP を関数の開始アドレスに設定し、Windows x64 呼び出し規約が最初の4つの引数をレジスタ(rcx、rdx、r8、r9 の順)で渡すため、NtContinue に渡すコンテキスト構造体に引数を配置するだけです。これにより、事実上、関数の呼び出しがシミュレートされます。 NtContinue を使用する際に最後に注意すべきことは Rsp です。前述のように、このアドレスは関数が呼び出されたときにリターンアドレスを保持する必要があります。
したがって、NtContinue が機能するために最初に必要なのはコンテキストを取得することです。手動で作成することもできますが、問題が生じます。関数に渡されたときに RET が戻るために使用するアドレスを指す Rsp の値を見つけることです。 タスクは別のスレッドで動作するため、そのスタックがどこに配置されるかはわかりません。 解決策(Ekko から慎重に借用しました。ありがとうございます :P)は、ワーカー内で RtlCaptureContext() を使用してコンテキストのコピーを取得し、取得したコンテキストのスタックポインタを8増加させることです。これにより、CALL RtlCaptureContext() によってスタックに導入されたアドレス、つまりこの関数のリターンアドレスを指すようになり、すべての関数のリターンアドレスとして使用できます。