 jaidedai/easyocr
すぐに使えるOCR。ラテン文字、中国語、アラビア文字、デーヴァナーガリー文字、キリル文字など、80以上の言語とすべての一般的な文字体系に対応。



80以上の対応言語と、ラテン文字、中国語、アラビア文字、デーヴァナーガリー文字、キリル文字など、あらゆる主要な書記体系に対応したすぐに使えるOCRです。
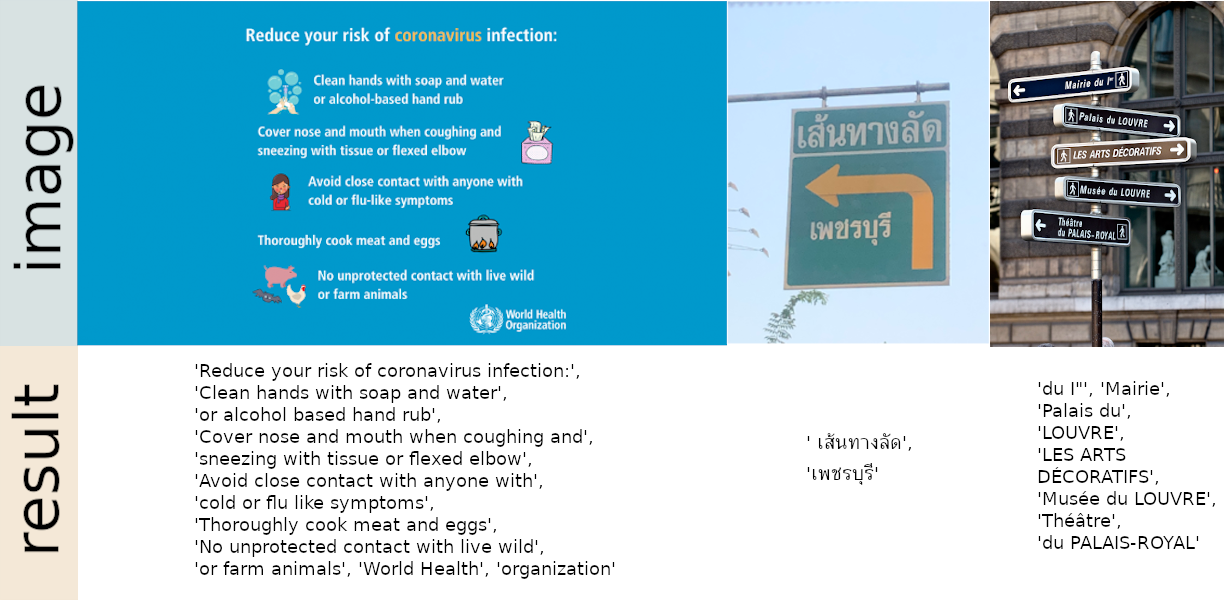
Gradioを使用してHuggingface Spaces 🤗に統合されています。Webデモをお試しください:
2024年9月24日 - バージョン 1.7.2
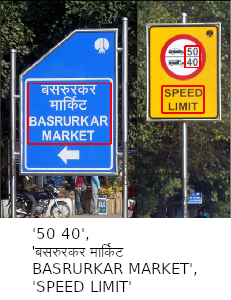
pipを使用してインストールします
最新の安定版リリースの場合:
pip install easyocr
最新の開発リリースについては:
pip install git+https://github.com/JaidedAI/EasyOCR.git
注1: Windowsの場合、まず公式の手順 https://pytorch.org に従ってtorchとtorchvisionをインストールしてください。pytorchのウェブサイトでは、お使いのCUDAバージョンに合ったものを必ず選択してください。CPUモードのみで実行する場合は、CUDA = None を選択してください。
注2: Dockerfileもこちらで提供しています。
注3: オプションのDBNet検出器(detect_network='dbnet18')は初回使用時にC++/CUDAオペレーションをコンパイルするため、Ninjaビルドツールが必要です。EasyOCRと一緒にインストールするには、pip install "easyocr[dbnet]" を使用してください。
import easyocr
reader = easyocr.Reader(['ch_sim','en']) # this needs to run only once to load the model into memory
result = reader.readtext('chinese.jpg')
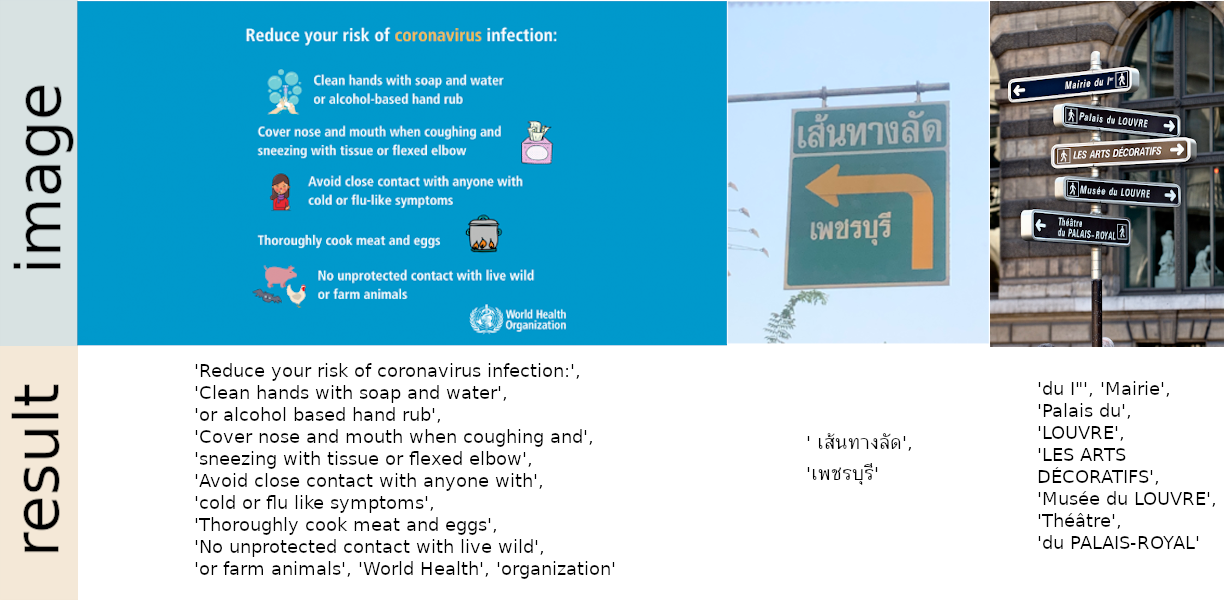
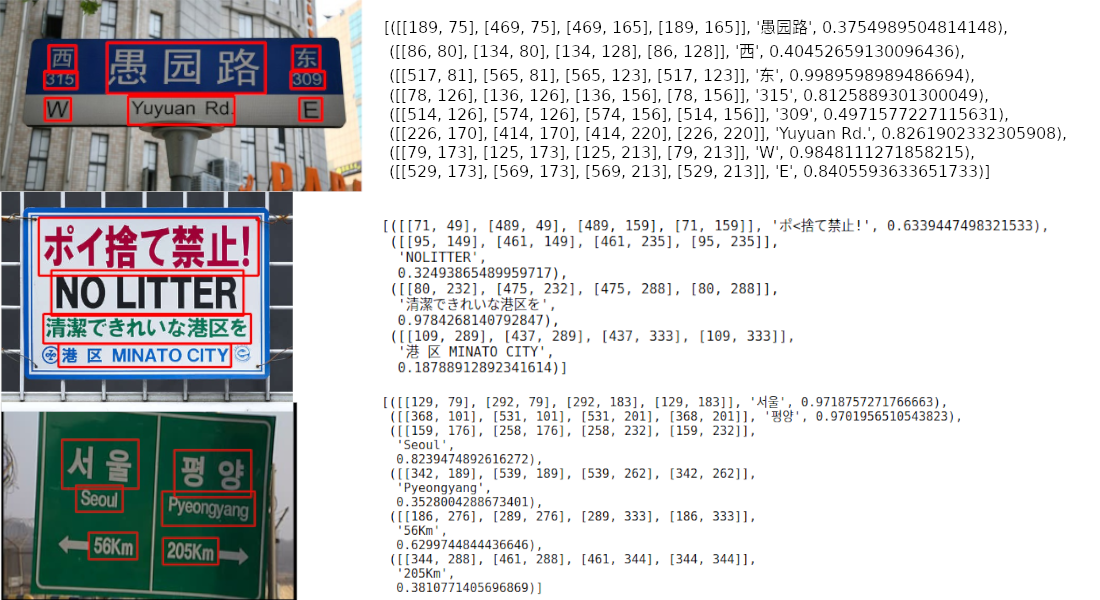
出力はリスト形式になり、各項目はそれぞれバウンディングボックス、検出されたテキスト、信頼度を表します。
[([[189, 75], [469, 75], [469, 165], [189, 165]], '愚园路', 0.3754989504814148),
 ([[86, 80], [134, 80], [134, 128], [86, 128]], '西', 0.40452659130096436),
 ([[517, 81], [565, 81], [565, 123], [517, 123]], '东', 0.9989598989486694),
 ([[78, 126], [136, 126], [136, 156], [78, 156]], '315', 0.8125889301300049),
 ([[514, 126], [574, 126], [574, 156], [514, 156]], '309', 0.4971577227115631),
 ([[226, 170], [414, 170], [414, 220], [226, 220]], 'Yuyuan Rd.', 0.8261902332305908),
 ([[79, 173], [125, 173], [125, 213], [79, 213]], 'W', 0.9848111271858215),
 ([[529, 173], [569, 173], [569, 213], [529, 213]], 'E', 0.8405593633651733)]
注1: ['ch_sim','en'] は読み取りたい言語のリストです。複数の言語を一度に渡すことができますが、すべての言語を同時に使用できるわけではありません。英語はすべての言語と互換性があり、共通の文字を共有する言語同士は通常互換性があります。
注2: ファイルパス chinese.jpg の代わりに、OpenCVの画像オブジェクト(numpy配列)やバイト形式の画像ファイルを渡すこともできます。生画像へのURLも使用可能です。
注3: reader = easyocr.Reader(['ch_sim','en']) の行は、モデルをメモリに読み込むためのものです。多少時間がかかりますが、実行は一度だけで済みます。
よりシンプルな出力にするには、detail=0 を設定することもできます。
reader.readtext('chinese.jpg', detail = 0)
結果:
['愚园路', '西', '东', '315', '309', 'Yuyuan Rd.', 'W', 'E']
選択した言語のモデル重みは自動的にダウンロードされます。手動でダウンロードする場合は、model hub からダウンロードし、'~/.EasyOCR/model' フォルダに配置してください。
GPU がない場合、または GPU のメモリが少ない場合は、gpu=False を追加することで CPU のみのモードでモデルを実行できます。
reader = easyocr.Reader(['ch_sim','en'], gpu=False)
詳細については、チュートリアルとAPIドキュメントをお読みください。
$ easyocr -l ch_sim en -f chinese.jpg --detail=1 --gpu=True
認識モデルについては、こちらをお読みください。
検出モデル(CRAFT)については、こちらをお読みください。
reader = easyocr.Reader(['en'], detection='DB', recognition = 'Transformer')
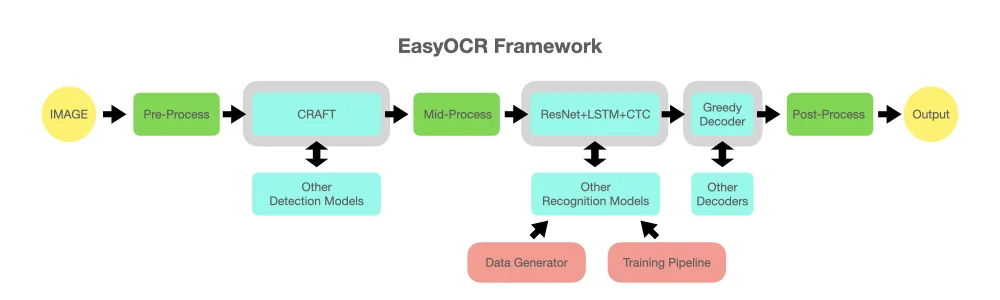
狙いは、あらゆる最先端モデルをEasyOCRに組み込めるようにすることです。より優れた検出/認識モデルを作ろうとしている天才たちはたくさんいますが、私たちはここで天才になろうとしているわけではありません。ただ、彼らの成果を誰もがすぐに使えるようにしたいだけです……無料で。(まあ、ほとんどの天才は自分の成果ができるだけ早く、できるだけ大きな良い影響を生み出すことを望んでいると信じています)パイプラインは下の図のようなものになるはずです。灰色のスロットは、交換可能な水色のモジュールのためのプレースホルダーです。
このプロジェクトは、いくつかの論文およびオープンソースリポジトリの研究とコードに基づいています。
すべての深層学習の実行はPytorchに基づいています。❤️
検出の実行には、この公式リポジトリとその論文のCRAFTアルゴリズムを使用しています(@clovaaiの@YoungminBaekに感謝します)。また、彼らの事前学習済みモデルも使用しています。学習スクリプトは@gmuffinessによって提供されています。
認識モデルはCRNN(論文)です。これは3つの主要なコンポーネントで構成されています:特徴抽出(現在はResnetとVGGを使用しています)、系列ラベリング(LSTM)、およびデコーディング(CTC)です。認識実行のための学習パイプラインは、deep-text-recognition-benchmarkフレームワークを改変したものです。(@clovaaiの@ku21fanに感謝します)このリポジトリは、もっと評価されるべき逸材です。
ビームサーチのコードは、このリポジトリと彼のブログに基づいています。(@githubharaldに感謝します)
データ合成はTextRecognitionDataGeneratorに基づいています。(@Belvalに感謝します)
また、distill.pubによるCTCについての読み応えのある記事はこちらです。
AIを誰もが使えるようにすることで、一緒に人類を前進させましょう!
貢献する3つの方法:
コーダー: 小さなバグ/改善についてはPRを送ってください。より大きなものについては、まずissueを開いて私たちと議論してください。'PR WELCOME'というタグが付いた、修正可能なバグ/改善のissueのリストがあります。
ユーザー: EasyOCRがあなたやあなたの組織にどのように役立っているかを教えてください。さらなる開発の励みになります。また、失敗事例をIssueセクションに投稿して、将来のモデルの改善にご協力ください。
テックリーダー/達人: このライブラリが役に立ったと思ったら、ぜひ広めてください!(EasyOCRについてのYann Lecunの投稿を参照)
新しい言語をリクエストするには、以下の2つのファイルを含むPRを送っていただく必要があります:
お使いの言語に特有の要素(例:1. アラビア語:文字が互いに結合すると形が変わる+右から左へ書く、2. タイ語:行の上に配置する必要がある文字と下に配置する必要がある文字がある)がある場合は、可能な限り教えていただくか、有用なリンクを提供してください。本当に機能するシステムを実現するには、細部への配慮が重要です。
最後に、私たちの優先順位は、人気のある言語、または文字の大部分を互いに共有する言語群に置かれることをご理解ください(お使いの言語がこれに該当する場合もお知らせください)。新しいモデルの開発には少なくとも1週間かかるため、新しいモデルのリリースまでしばらくお待ちいただく必要があるかもしれません。
開発中の言語一覧をご覧ください。