 ginlix-ai/langalpha
モジュール式クローラー、スキャナー、抽出パイプラインを用いた偵察、データ収集、脅威インテリジェンス収集のための自動化OSINTフレームワーク。

vibe investing のための agent harness
LangAlpha は、金融市場の理解と投資判断を支援するために作られています。


クイックスタート • API ドキュメント • Agent Core • Backend • Web • TUI • Skills • MCP
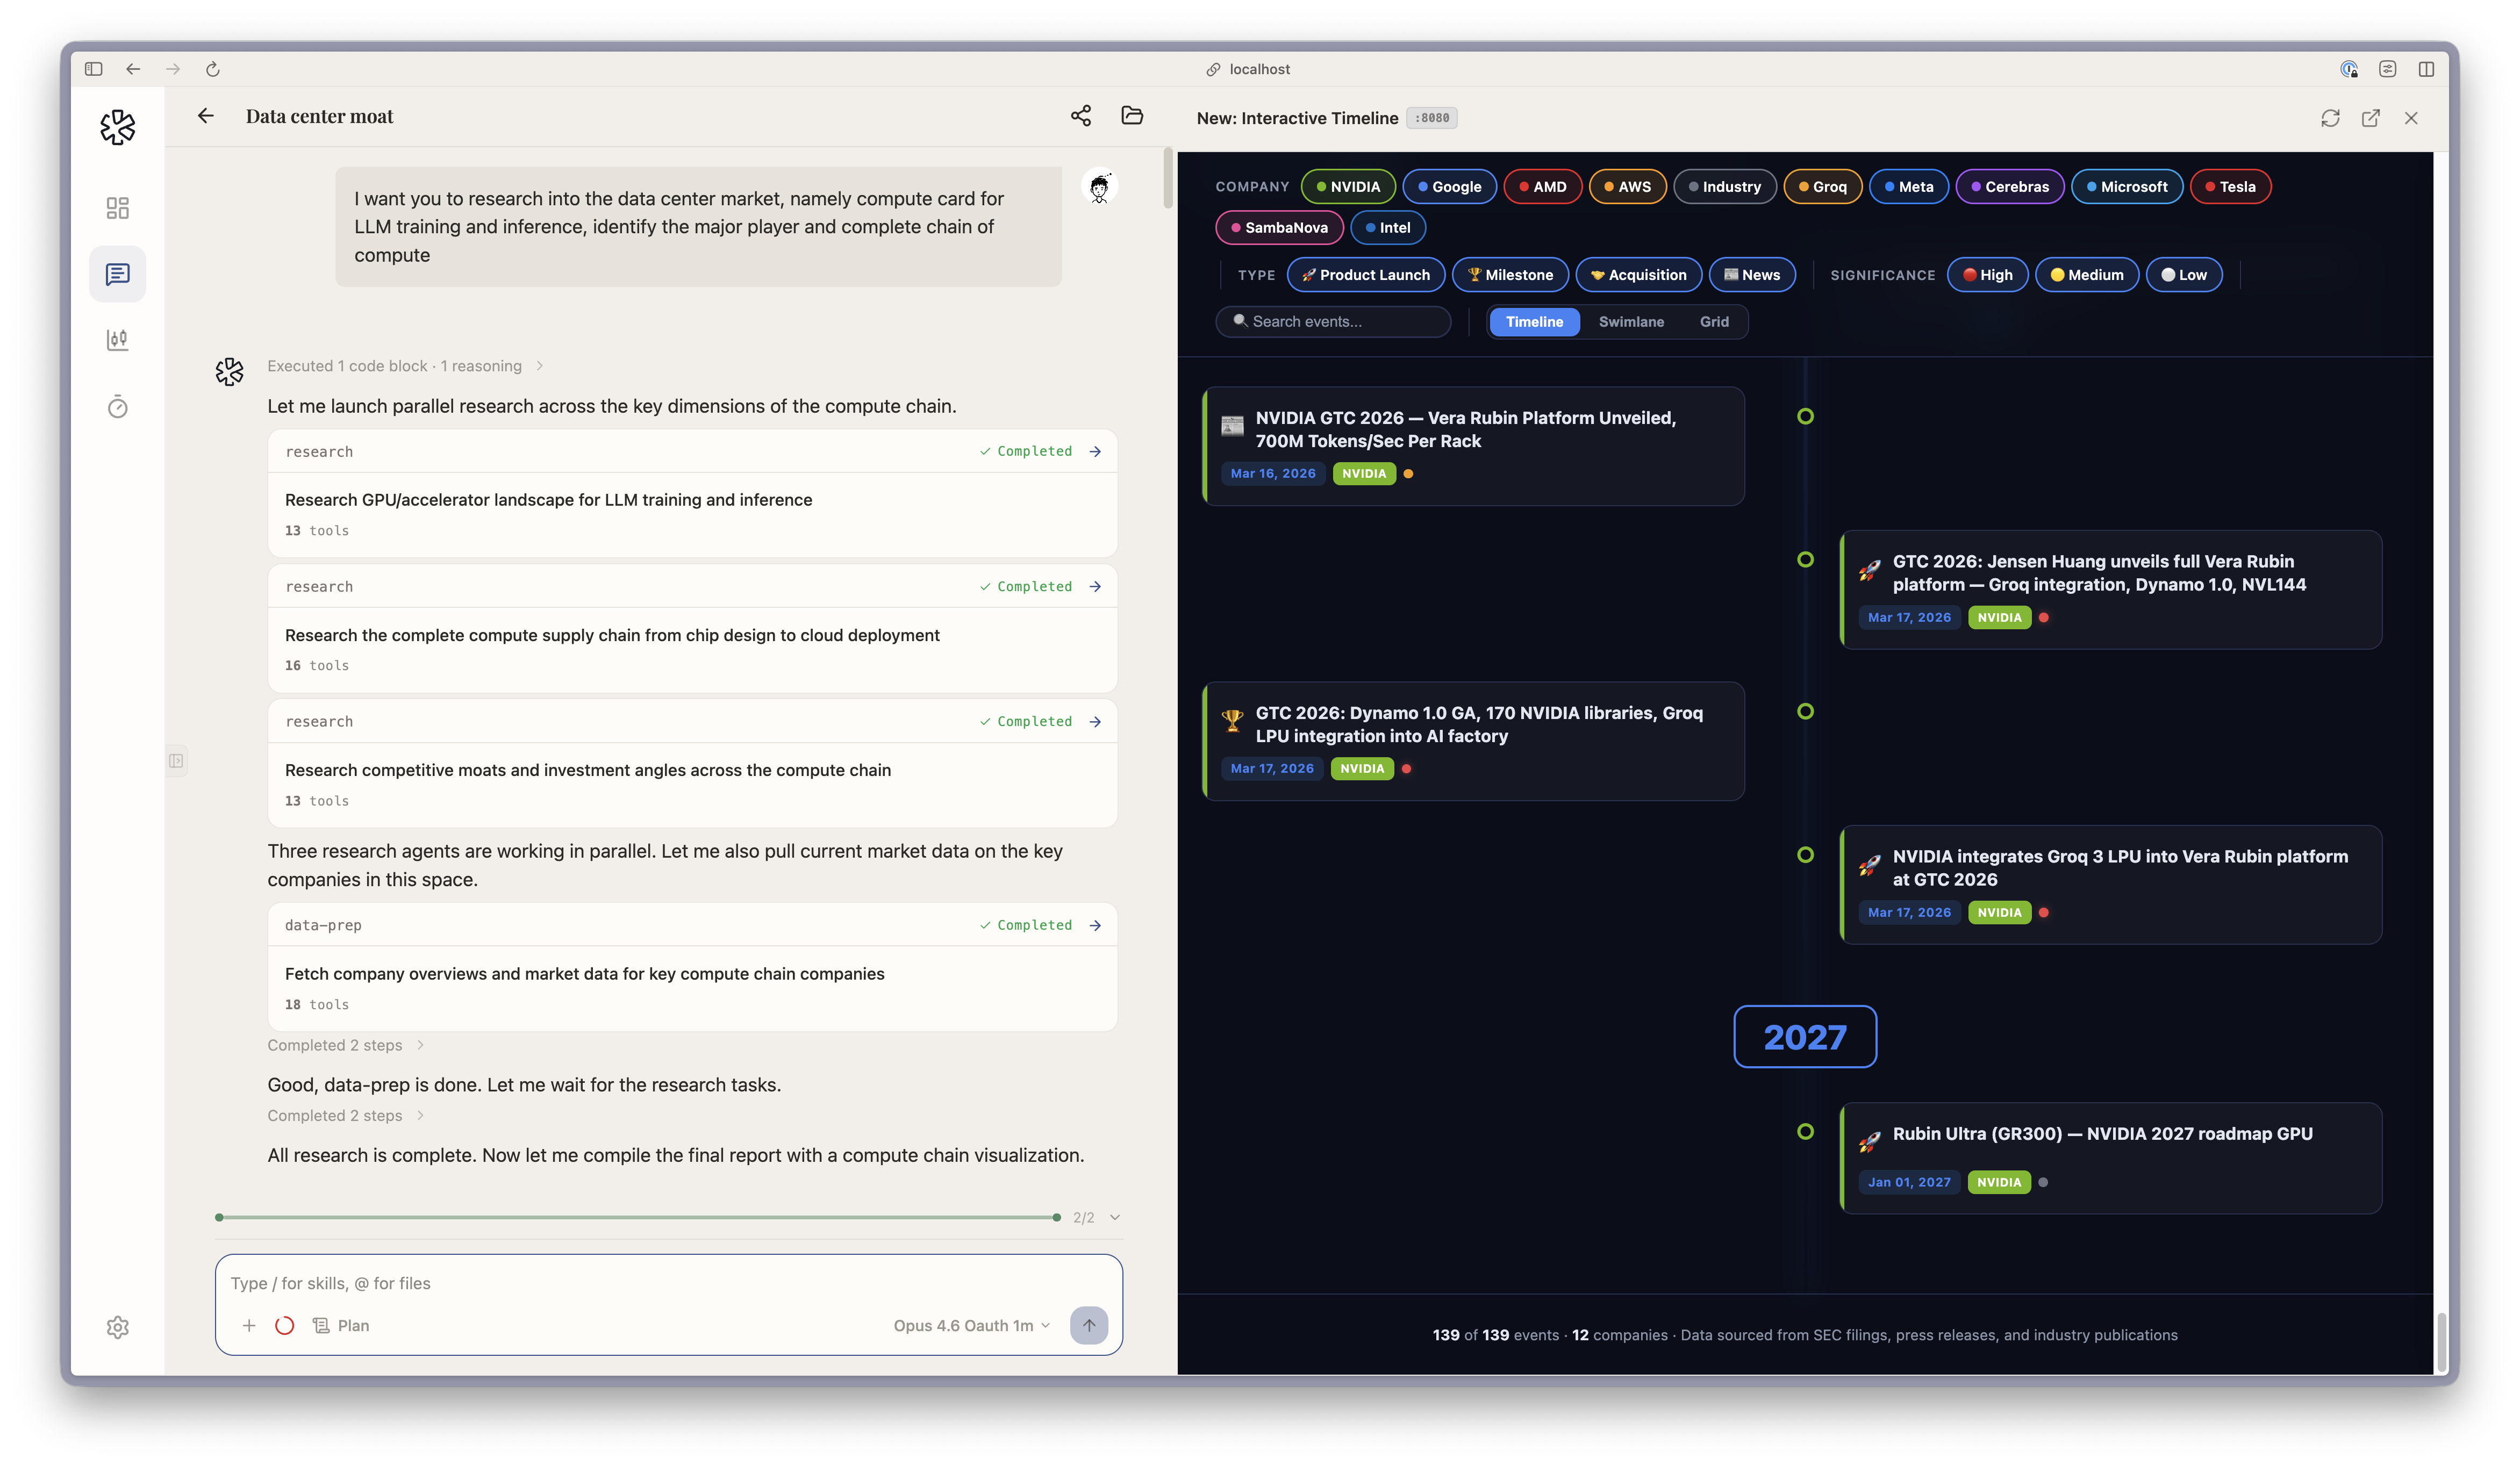
ダッシュボードの厳選ニュースブリーフを agent に pin し、アイデア生成を開始して、並列 subagent にマーケットのスクリーニングを任せます。結果はインラインの対話型 dashboard に戻り、あなたのポートフォリオに合わせた 5 つのロング/ショート・ペアトレード案として提示されます。
現在の AI 金融ツールの多くは、投資を一回限りのやり取りとして扱います。質問して、答えを受け取り、そこで終わりです。しかし実際の投資はベイズ的です。最初に仮説を持ち、新しいデータが日々入り、そのたびに確信度を更新していきます。仮説を磨き、ポジションを見直し、過去の分析の上に新しい分析を重ねるこのプロセスは、数週間から数か月にわたって続きます。単発の prompt だけでは、この流れを受け止めきれません。
着想はソフトウェアエンジニアリングにあります。codebase は継続して存在し、各 commit はそれ以前の作業の上に積み上がります。Claude Code や OpenCode のようなコード agent harness が成果を上げたのは、agent が既存の文脈を探索し、過去の作業を土台に進められるようにしたからです。LangAlpha は同じ発想を投資に持ち込みます。agent に永続的な workspace を与えることで、リサーチは自然に積み上がります。
実際には、研究目的ごとに workspace を作成します。たとえば「Q2 リバランス」「データセンター需要の深掘り」「エネルギーセクターのローテーション」などです。agent はあなたの目的やスタイルをヒアリングし、最初の成果物を作成し、すべてを workspace のファイルシステムに保存します。翌日に戻ってきても、ファイル、thread、蓄積されたリサーチはそのまま残っています。
agent.md)を持ちます。これにより session や thread をまたいでリサーチが蓄積されます。別系統の長期 memory store(.agents/user/memory/、.agents/workspace/memory/)は、継続的なユーザー設定や sandbox をまたぐ知識を保持します。ユーザー管理の memo store(.agents/user/memo/)には PDF や markdown のリサーチノートをアップロードでき、agent が必要に応じて参照します。システムアーキテクチャ
%%{init: {'theme': 'neutral'}}%%

flowchart TB
    Web["Web UI<br/>React 19 · Vite · Tailwind"] -- "REST · SSE" --> API
    Web -- "WebSocket" --> WSP
    CLI["CLI / TUI"] -- "REST · SSE" --> API

    subgraph Server ["FastAPI Backend"]
        API["API Routers<br/>Threads · Workspaces · Market Data<br/>OAuth · Automations · Skills"]
        WSP["WebSocket Proxy"]
        API --> ChatHandler["Chat Handler<br/>LLM Resolution · Workflow Dispatch"]
        ChatHandler --> BTM["Background Task Manager<br/>Decoupled Execution · Workflow Lifecycle"]
    end

    subgraph PostgreSQL ["PostgreSQL — Dual Pool"]
        AppPool[("App Data<br/>Users · Workspaces · Threads<br/>Turns · BYOK Keys · Automations")]
        CheckPool[("LangGraph Checkpointer<br/>Agent State · Checkpoints")]
    end

    subgraph Redis ["Redis"]
        EventBuf[("SSE Event Buffer<br/>150K events · Reconnect Replay")]
        DataCache[("API Cache<br/>Market Data · SWR")]
        Steering[("Steering Queue<br/>User Messages Mid-workflow")]
    end

    BTM --> AppPool
    BTM --> CheckPool
    BTM --> EventBuf
    BTM --> Steering
    API --> DataCache

    BTM -. "Sandbox API" .-> Daytona["Daytona<br/>Cloud Sandboxes"]
    API -. "REST" .-> FinAPIs["Financial APIs<br/>FMP · SEC EDGAR"]
    WSP -. "WebSocket" .-> GData["ginlix-data<br/>Polygon.io · Massive"]
LangAlpha は、複数の LLM backend を抽象化する provider-agnostic なモデル層で動作します。どのモデルが駆動していても、同じ middleware stack、tools、workflow が利用できます。標準で 2 つのモードを備えています。
自分のモデルを持ち込む — 既存の AI subscription や API key を直接使えます。OAuth で ChatGPT や Claude subscription(OpenAI Codex OAuth、Claude Code OAuth)を接続したり、Kimi(Moonshot)、GLM(Zhipu)、MiniMax、Doubao(Volcengine)の coding plan を使ったり、BYOK で任意の対応 provider の API key を設定できます。すべての key は PostgreSQL pgcrypto で保存時に暗号化されます(セキュリティ を参照)。
モデル耐障害性 — 一時的なエラーでは自動 retry し、その後は設定済み fallback model に failover します。reasoning effort(low/medium/high)は provider 間で自動的に正規化されます。
多くの AI agent は、一回限りの JSON tool call でデータを扱い、結果をそのまま context window に入れます。Programmatic Tool Calling は発想を反転させます。生データを LLM に渡す代わりに、agent が Daytona cloud sandbox 内でコードを書いて実行し、ローカルにデータを処理し、最終結果だけを返します。これにより token の浪費を大きく抑え、通常なら context limit を超える分析も可能になります。
PTC 実行フロー
%%{init: {'theme': 'neutral'}}%%

flowchart LR
    LLM["LLM"] -- "1 — Writes Python" --> EC["ExecuteCode Tool"]
    EC -- "2 — Sends to sandbox" --> Run["Code Runner"]

    subgraph Sandbox ["Daytona Cloud Sandbox"]
        Run -- "3 — import tools.*" --> Wrappers["Generated Wrappers<br/>One module per MCP server"]
        Wrappers -- "4 — JSON-RPC stdio" --> MCP["MCP Servers<br/>Subprocesses in sandbox"]
    end
