MLベースのフィードバックWAFの最初のイテレーション
NGWAFは @yupengfei、@zhangbosen、@matthewng、@elizabethlim によって作成されました。
NGWAFの初期段階への貢献に対して、@ruinahkoh に特別な感謝を捧げます。
NGWAFは実験的な概念実証であり、現在の形では本番環境での使用には適していません。
目次
要件
2000年代初頭からのウェブアプリケーションの爆発的な成長に伴い、ウェブベースの攻撃はますます横行しています。一般的な解決策の一つがウェブアプリケーションファイアウォール(WAF)です。しかし、現在のWAFのルールを調整して検出メカニズムを改善することは複雑で困難な場合があります。NGWAFは、新しい機械学習と隔離からハニーポットへのアーキテクチャを用いて、これらの欠点に対処することを目指しています。
WAF運用における実際の痛点から着想を得て、NGWAFは以下のプロセスを通じてWAF運用を簡素化し、再考することを意図しています:
| 痛点 | NGWAFの機能 |
|---|---|
| 検出メカニズムとルールの保守が複雑になる可能性がある | 機械学習を活用して検出メカニズムの作成と更新を自動化する |
| 悪意のあるトラフィックを即座にブロックすると、将来のWAF改善のために脅威行為者の行動から学ぶ機会が減少する | 従来の悪意のあるトラフィックのドロップやブロックではなく、隔離へのリダイレクトによる脅威の排除 |
デプロイをシンプルかつポータブルにするために、アーキテクチャ内のさまざまなコンポーネントをdockerを使用してコンテナ化し、docker-composeファイルに設定しました。これにより、依存関係がdockerによって自動的に処理されるため、新規インストールで迅速かつ簡単に実行できます。デプロイメントは、ローカルまたはクラウドプロバイダーベースのkubernetesクラスターに拡張でき、大量のトラフィックを処理するためにノード/ポッドの数を増やすことでスケーラブルになります。
デプロイメントはmacOS(Docker Desktop)、linux(ubuntu)でテストされています。
NGWAFは3つの主要コンポーネントを備えてすぐに動作し、これらのコンポーネントは前述の通りすべてコンテナ化されており、希望の使用量に応じてスケーラブルです。 保護対象のリソースは、セットアップ内でデプロイメントを変更することでカスタマイズできます。
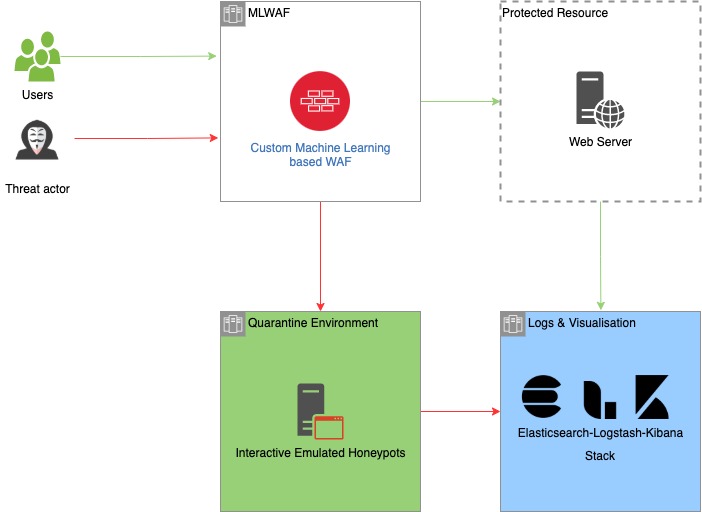
NGWAFの高レベルアーキテクチャと、異なる関係者からの予想されるトラフィックフロー
NGWAFは、以下の主なユーザー利点を念頭に設計されました:
NGWAFは従来のルールセットを深層学習モデルに置き換え、ルールの管理と更新の複雑さを低減します。ルールを手動で編集する代わりに、NGWAFの機械学習が悪意のあるデータからのパターン学習プロセスを自動化します。隔離環境から収集されたデータは自動的にスクラブされバッチ処理されるため、必要に応じて検出モデルに再トレーニングできます。
NGWAFは、潜在的な敵対的攻撃者を隔離するために構築されたインタラクティブな隔離環境からなる新しいアーキテクチャを採用しています。従来のWAFが検出時にブロックするのとは異なり、NGWAFは脅威行為者をエミュレートされたシステムに迂回させ、彼らの悪意のある行動の影響を和らげるために罠にかけます。この環境はまた、現在の攻撃手法を収集するための吸い込み口として機能し、悪意のあるデータの観察と収集を可能にします。これらのデータは、NGWAFの検出能力をさらに向上させるために使用できます。
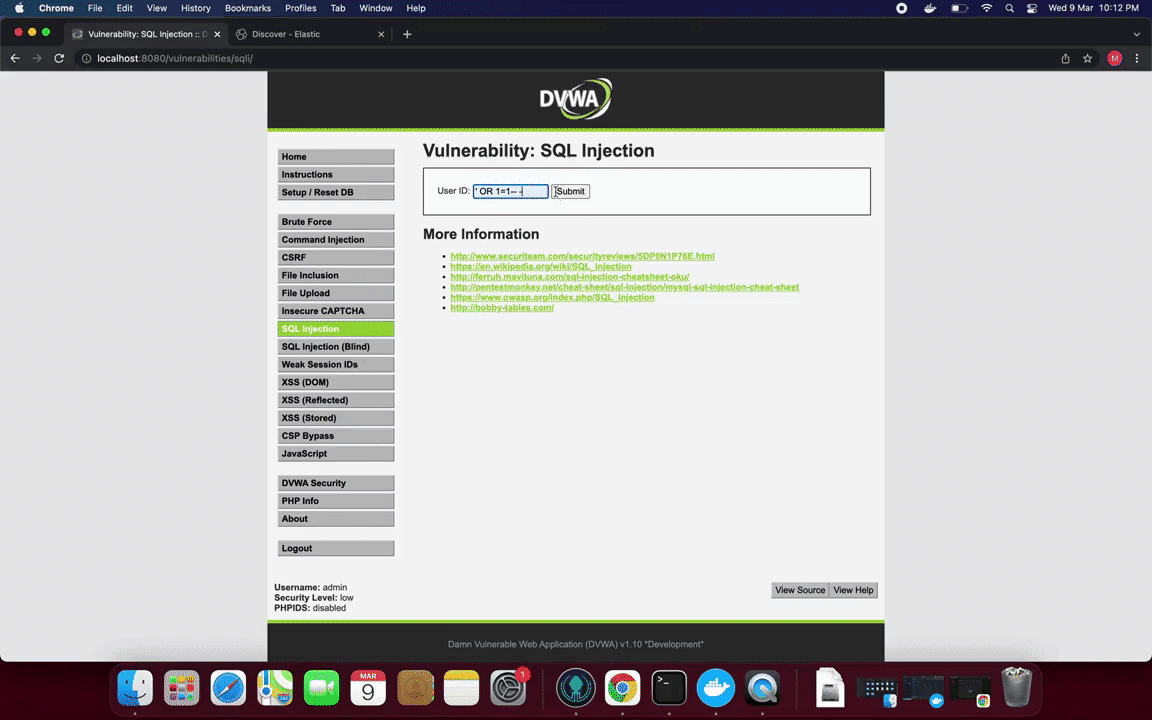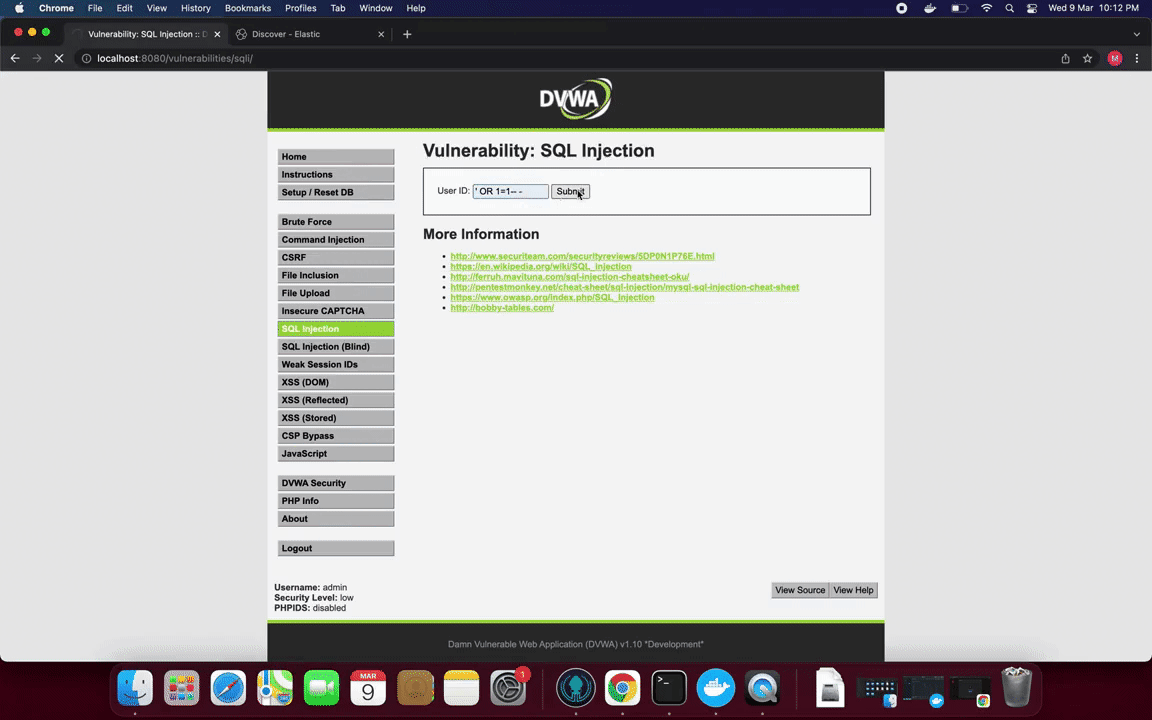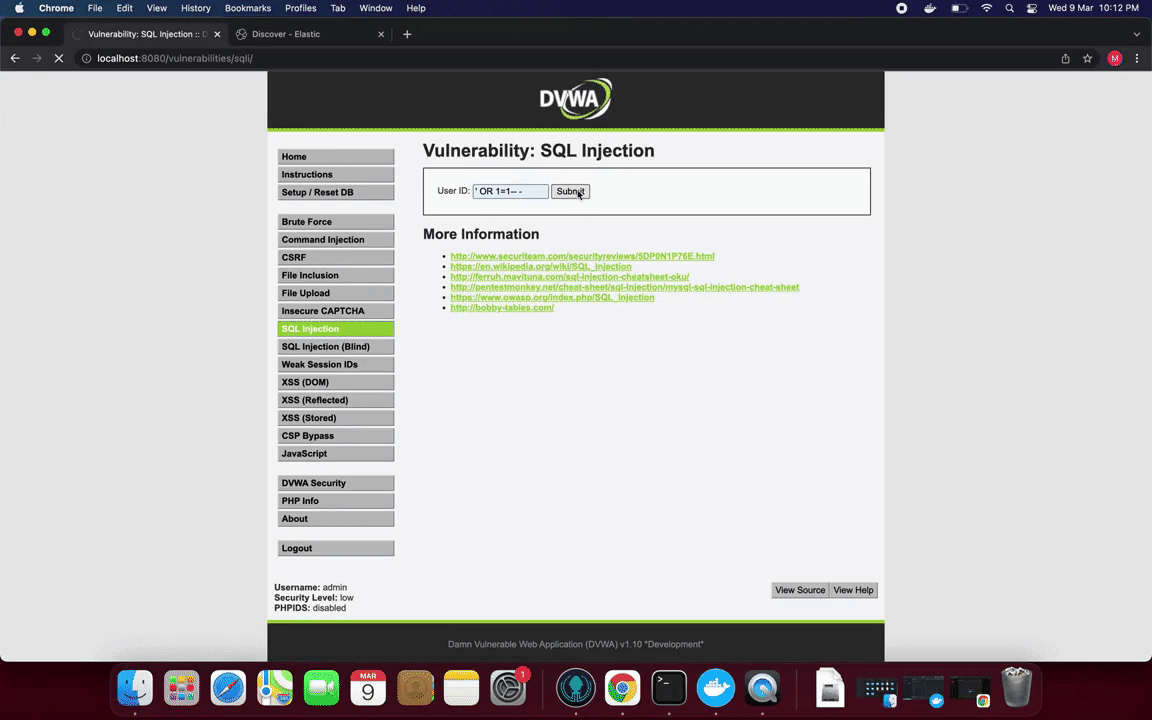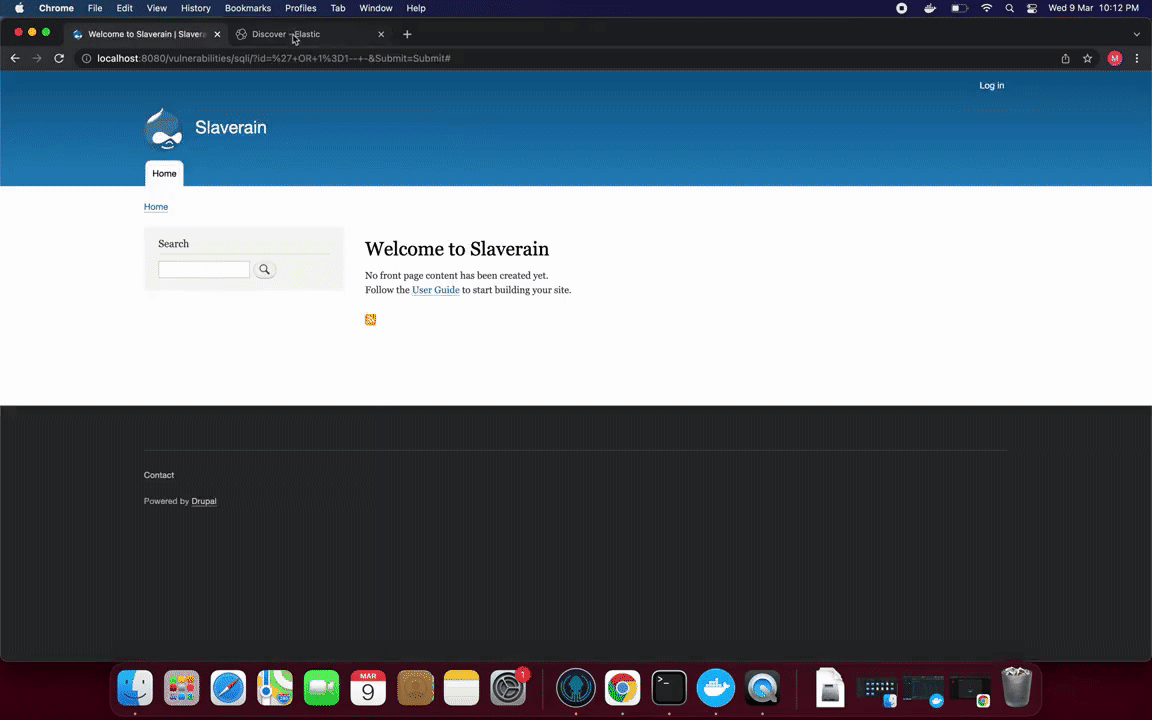
NGWAFの動作: SQLインジェクションを検出すると、試行をドロップまたはブロックする代わりに、NGWAFは隔離環境にリダイレクトします。
NGWAF作成の背後にある指針は、Open Web Application Security Projectの標準的な認識文書である The OWASP Top 10 2021 で強調されたリスクから保護することです。
トレーニングデータとコンプライアンスチェックは、この要件に基づいて収集され実施されます。
手動が必要なのはもう古い、NEURALに行こう
時間の経過とともにアナリストが手動でルールを特定し追加する必要がある従来のルールセットの代わりに、NGWAFは検出メカニズムにエンドツーエンドの機械学習パイプラインを活用し、特に複雑なペイロードの検出においてWAFルール管理の複雑さを大幅に低減します。
そのために、ユーザーが後で自分のアプリケーションから収集したデータを再トレーニングと微調整に使用できるように、最初にベースモデルとアーキテクチャを作成する必要がありました:
ベースモデルの一般的なアーキテクチャは、以下のような双方向LSTMモジュールを備えた単純なRNNです:
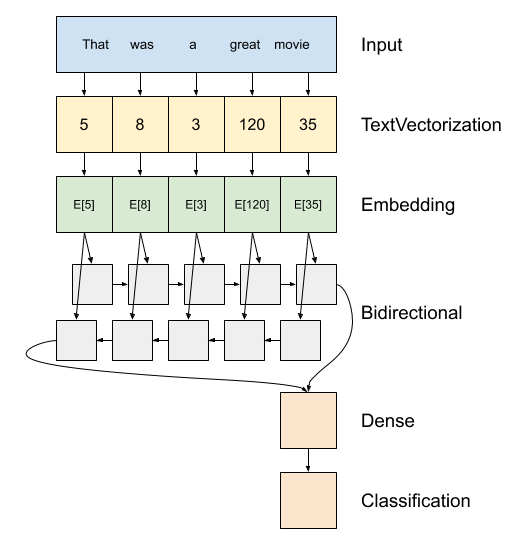
Tensorflowから引用した画像 (リンク)
このRNNアーキテクチャを使用することで、より単純なモデルと比較してパフォーマンスの向上を達成できました:
| モデルアーキテクチャ | 精度 | F1スコア |
|---|---|---|
| 最終モデル | 0.995 | 0.993 |
| LSTMモジュールなしのニューラルネットワーク | 0.956 | 0.891 |
| 決定木 | 0.878 | 0.840 |
| ロジスティック回帰 | 0.946 | 0.914 |
ベースモデルの一般化可能性を向上させるためにさまざまなアプリケーションからのログを含めていますが、モデルのさらなるメンテナンスと再トレーニングは以下にとって重要です:
これに対処するために、NGWAFのユーザーはパッケージ化されたエンドツーエンドのモデル再トレーニングパイプラインの恩恵を受け、内部をいじることなく数回の簡単なステップでモデルのメンテナンスを簡単にトリガーできます(以下のセクション3を参照)。
逃がすな、拘留しろ!
悪意のあるトラフィックをすぐにブロックまたはドロップする従来のWAFとは対照的に、NGWAFはより柔軟なアプローチを採用しています。つまり、悪意のある行為者を隔離環境内にリダイレクトして拘留します。この環境は、さまざまなインタラクティブなエミュレートされたハニーポットで構成され、より多くの攻撃手法/データを収集しようとします。これらのデータは、より現代的で複雑な攻撃に対するNGWAFの検出率を潜在的に向上させるために利用されます。
現在、NGWAFの隔離環境は、捕らえられた攻撃者によって送信されたすべてのデータをELKスタックに転送し、分析と可視化を行います。 データはHTTPリクエストのさまざまなコンポーネントに自動的にスクラブされ、その後、環境のバックエンドでJSON形式で内部的にパッケージ化されてから転送されます。 これにより、再トレーニングプロセスを開始する際にデータをクリーニングしてインデックスするために必要な人件費を削減できます。
NGWAFは現在、隔離環境内のハニーポットのフロントエンドの外観を変更するオプションをユーザーに提供しています(カスタマイズバージョンのdrupotに基づいています)。ユーザーは、dockerボリューム内のアセットフォルダを選択したフロントエンドアセットに置き換えるだけです。
NGWAFは、隔離環境の一部として独自のハニーポットをリンクしたいユーザーにも対応しています。 ユーザーはハニーポットのHTTPリクエストを環境のバックエンドサーバーに転送するだけで(バックエンドプロセスが自動的にデータをスクラブし、分析ダッシュボード(ELKスタック)に転送します)。
学習を続けられなければ、本当に賢いとは言えない
新しいペイロードや攻撃ベクトルが出現するにつれて、セキュリティを確保するために検出能力をアップグレードすることが重要です。そのため、NGWAFには防御側が機械学習モデルをトレーニングして新しいペイロードを検出できるようにする再トレーニング機能が組み込まれています。データサイエンスやニューラルネットワークに詳しくないユーザーでも、複雑な手順が代わりに処理されるため、このシンプルなインターフェースでモデルを微調整できます。
ユーザーは自分のライブシステムからのラベル付けされたデータの小サンプル(例:数千件程度)をアップロードするだけで、既存のモデルをバックエンドで微調整できます:
トレーニングが完了すると、ユーザーには新しいモデルを評価するための簡単なモデル診断情報(例:テストセットでのパフォーマンスやさまざまなスコアしきい値)も提供されます。
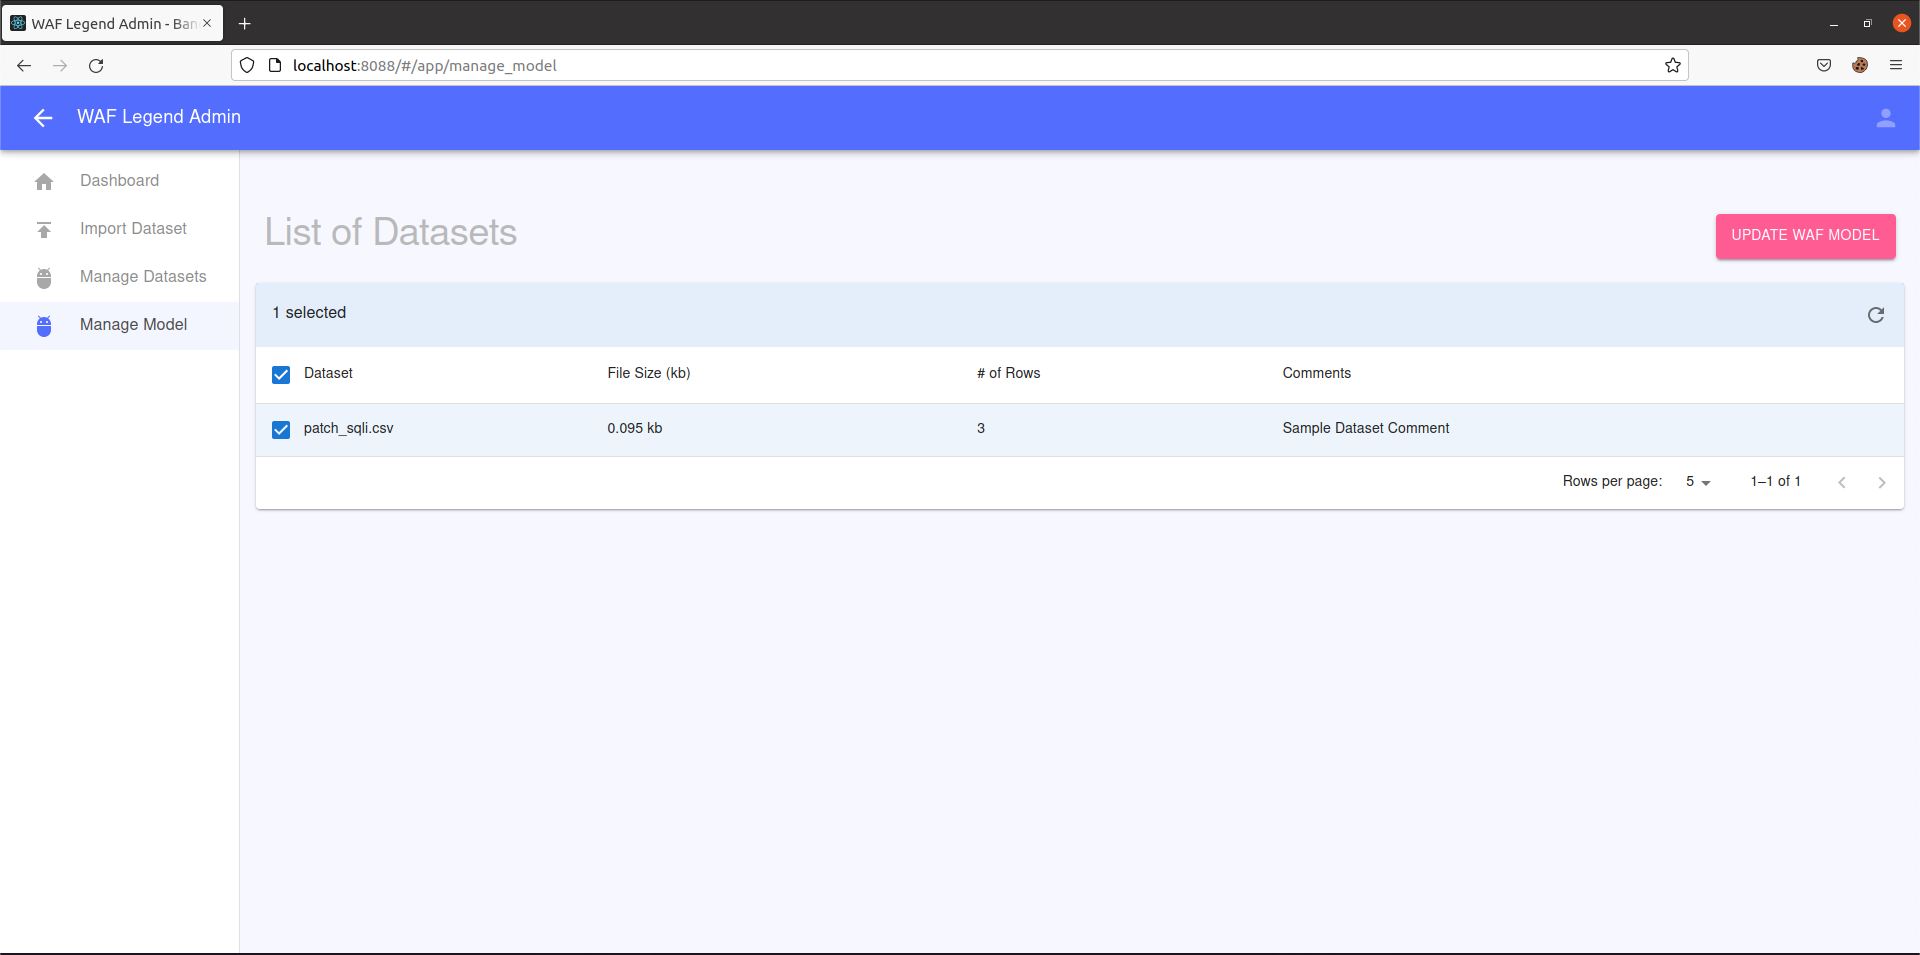
再トレーニングプロセスをトリガーするには、ダッシュボードに移動し、以下の手順に従ってください:
payload [str]: システムからのペイロード、またはいくつかの文字列ベースの例(例:SQLiインジェクションの例)のいずれかである必要がありますlabel [int]: 非悪意のある例の場合は0、悪意のある例の場合は1にする必要がありますis_url [bool]: ペイロードがシステムからのもの(つまり、パスやデバイスなどの他のシステム情報を含む)の場合はTRUE、文字列ベースの例(例:"1==1")の場合はFALSEにする必要がありますhttp://localhost:8088 に移動してNGWAF管理パネルを表示します。