 cisagov/findcdn
ドメインをスキャンし、HTTPSヘッダー、CNAMEレコード、WHOISデータのフィンガープリンティングによって、どのContent Delivery Network(CDN)を使用しているかを特定します。JSON出力とモジュールサポートを備えています。


findcdn は、ドメインが使用している
Content Distribution Network (CDN)
の種類をスキャンして検出できるツールです。findcdn は結果をファイルに保存したり、モジュールとして使用したり、単に標準出力に出力したりできます。
findcdn は、ツールのユーザーがドメインが使用している CDN を正確に判断するのに役立ちます。サポートされているドメインのリストは、リポジトリ内の
cdn_config.py
ファイルに記載されています。このライブラリは、スタンドアロンツールとして、またはプロジェクトにインポート可能なモジュールとして実装できます。どちらの場合も、結果を出力ファイルに書き込むことができます。
findcdn には Python 3.7+ が必要です。Python 2 はサポートされていません。
findcdn は、pip とリポジトリ内の requirements.txt ファイルを使用してモジュールとしてインストールできます。
findcdn は pip 経由でインストールできます:
pip install --requirement requirements.txt
その後、直接実行できます:
findcdn list github.com
または、次のコマンドで任意のプロジェクトにすばやくインストールできます:
pip install git+https://github.com/cisagov/findcdn.git
注意: モジュールをインストールして環境をクリーンに保つために、Python 仮想環境を使用することをお勧めします。そうする場合は、モジュールをインストールする前に pyenv と pyenv-virtualenv プラグイン が必要です。
findcdn file <fileIn> [options]
findcdn list  <domain>... [options]
findcdn (-h | --help)

findcnd -h
findcdn file domains.txt -o output_cdn.txt -t 17 -d
findcdn list dhs.gov cisa.gov -o output_cnd.txt -v
findcdn list cisa.gov
  -h --help                    このメッセージを表示します。
  --version                    現在のバージョンを表示します。
  -o FILE --output=FILE        指定した場合、JSON 出力ファイルが
                               指定された値の場所に作成されます。
  -v --verbose                 追加の出力文を含めます。
  --all                        出力に CDN があるドメインとないドメインの
                               両方を含めます。
  -d --double                  精度を高めるためにチェックを 2 回実行します。
  -t --threads=<thread_count>  スレッド数。指定しない場合はデフォルトを使用します。
  --timeout=<timeout>          ドメインの処理が完了するまで待機する最大時間
                               (秒)。指定しない場合はデフォルトを使用します。
  --user_agent=<user_agent>    使用するユーザーエージェントを設定します。
                               指定しない場合はデフォルトを使用します。
user2@ubuntu:~$ findcdn list asu.edu -t 7 --double
Using 7 threads.
[Pending: 0 jobs]==[Threads: 2]: 100%|███████████████████████████████| 2/2 [00:00<00:00,  2.22it/s]
{
    "date": "06/19/2020, 13:00:38",
    "CDN_count": "1",
    "domains": {
        "asu.edu": {
            "IP": "'104.16.50.14'",
            "cdns": "'.cloudflare.com'",
            "cdns_by_names": "'Cloudflare'"
        }
    }
}
Domain processing completed.
1 domains had CDN's out of 1.
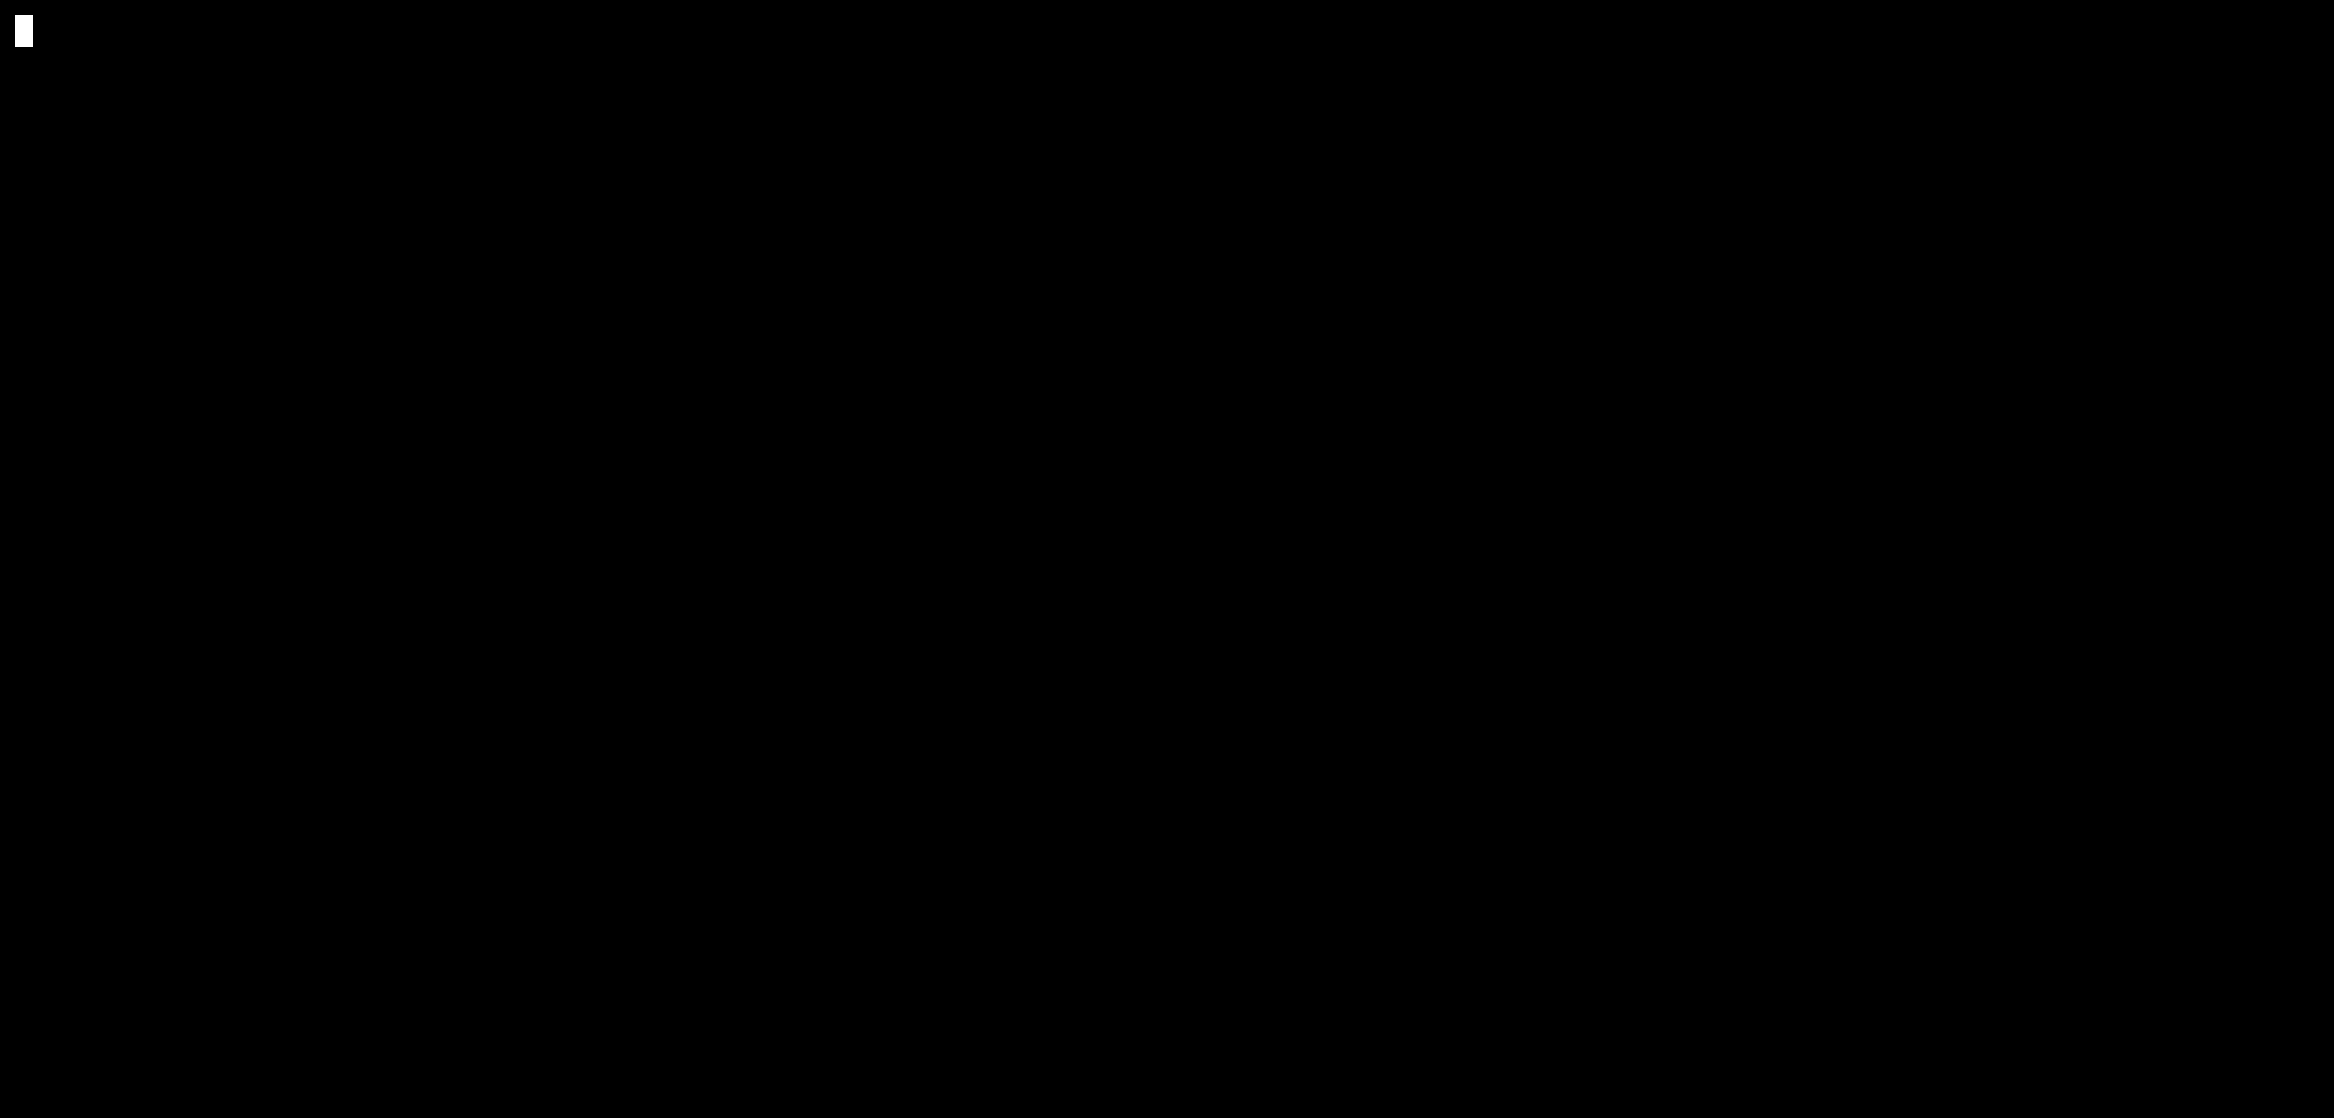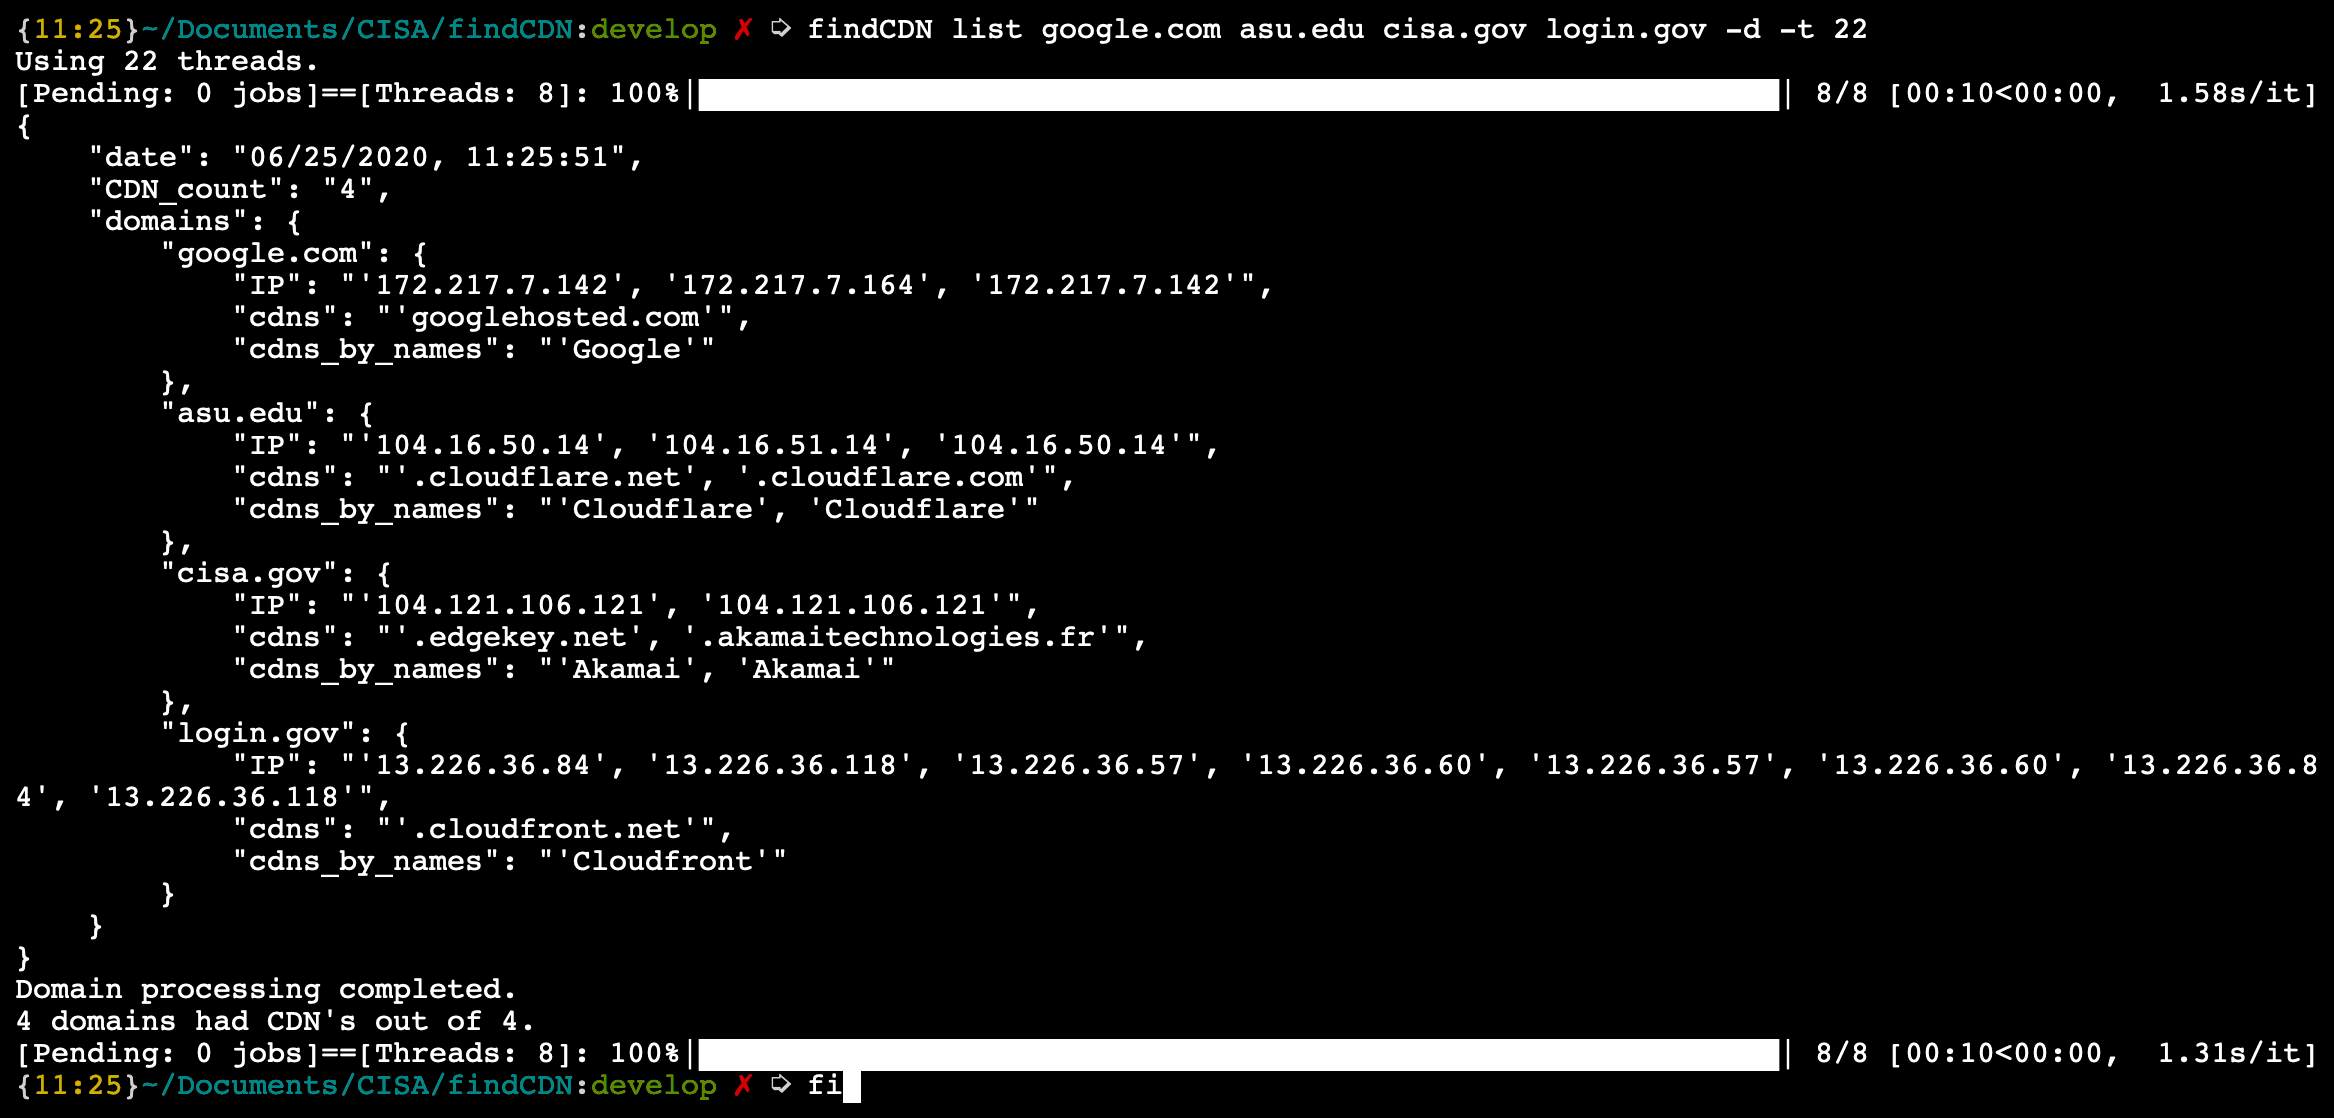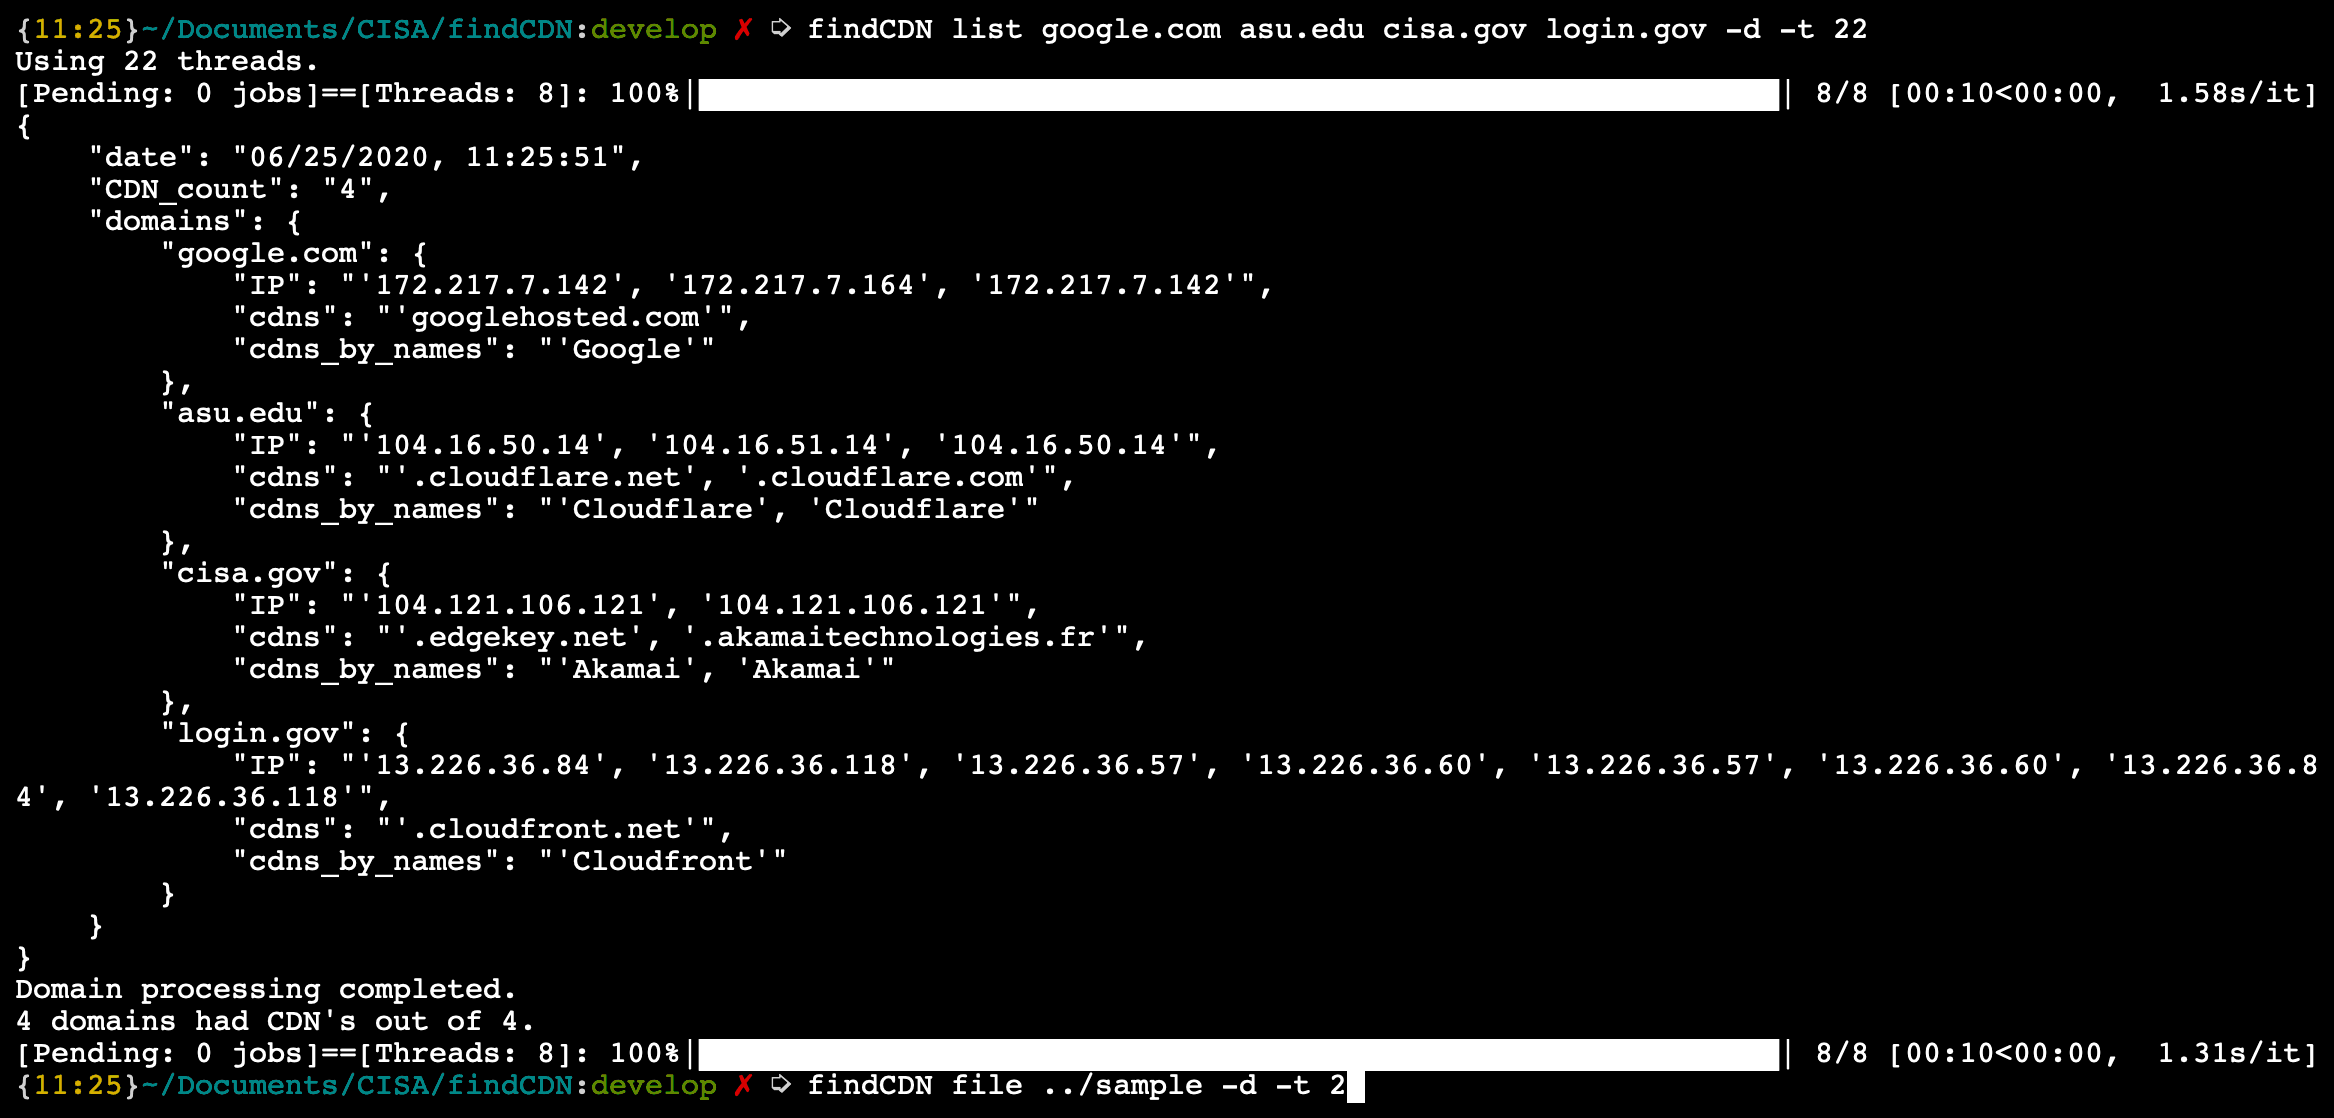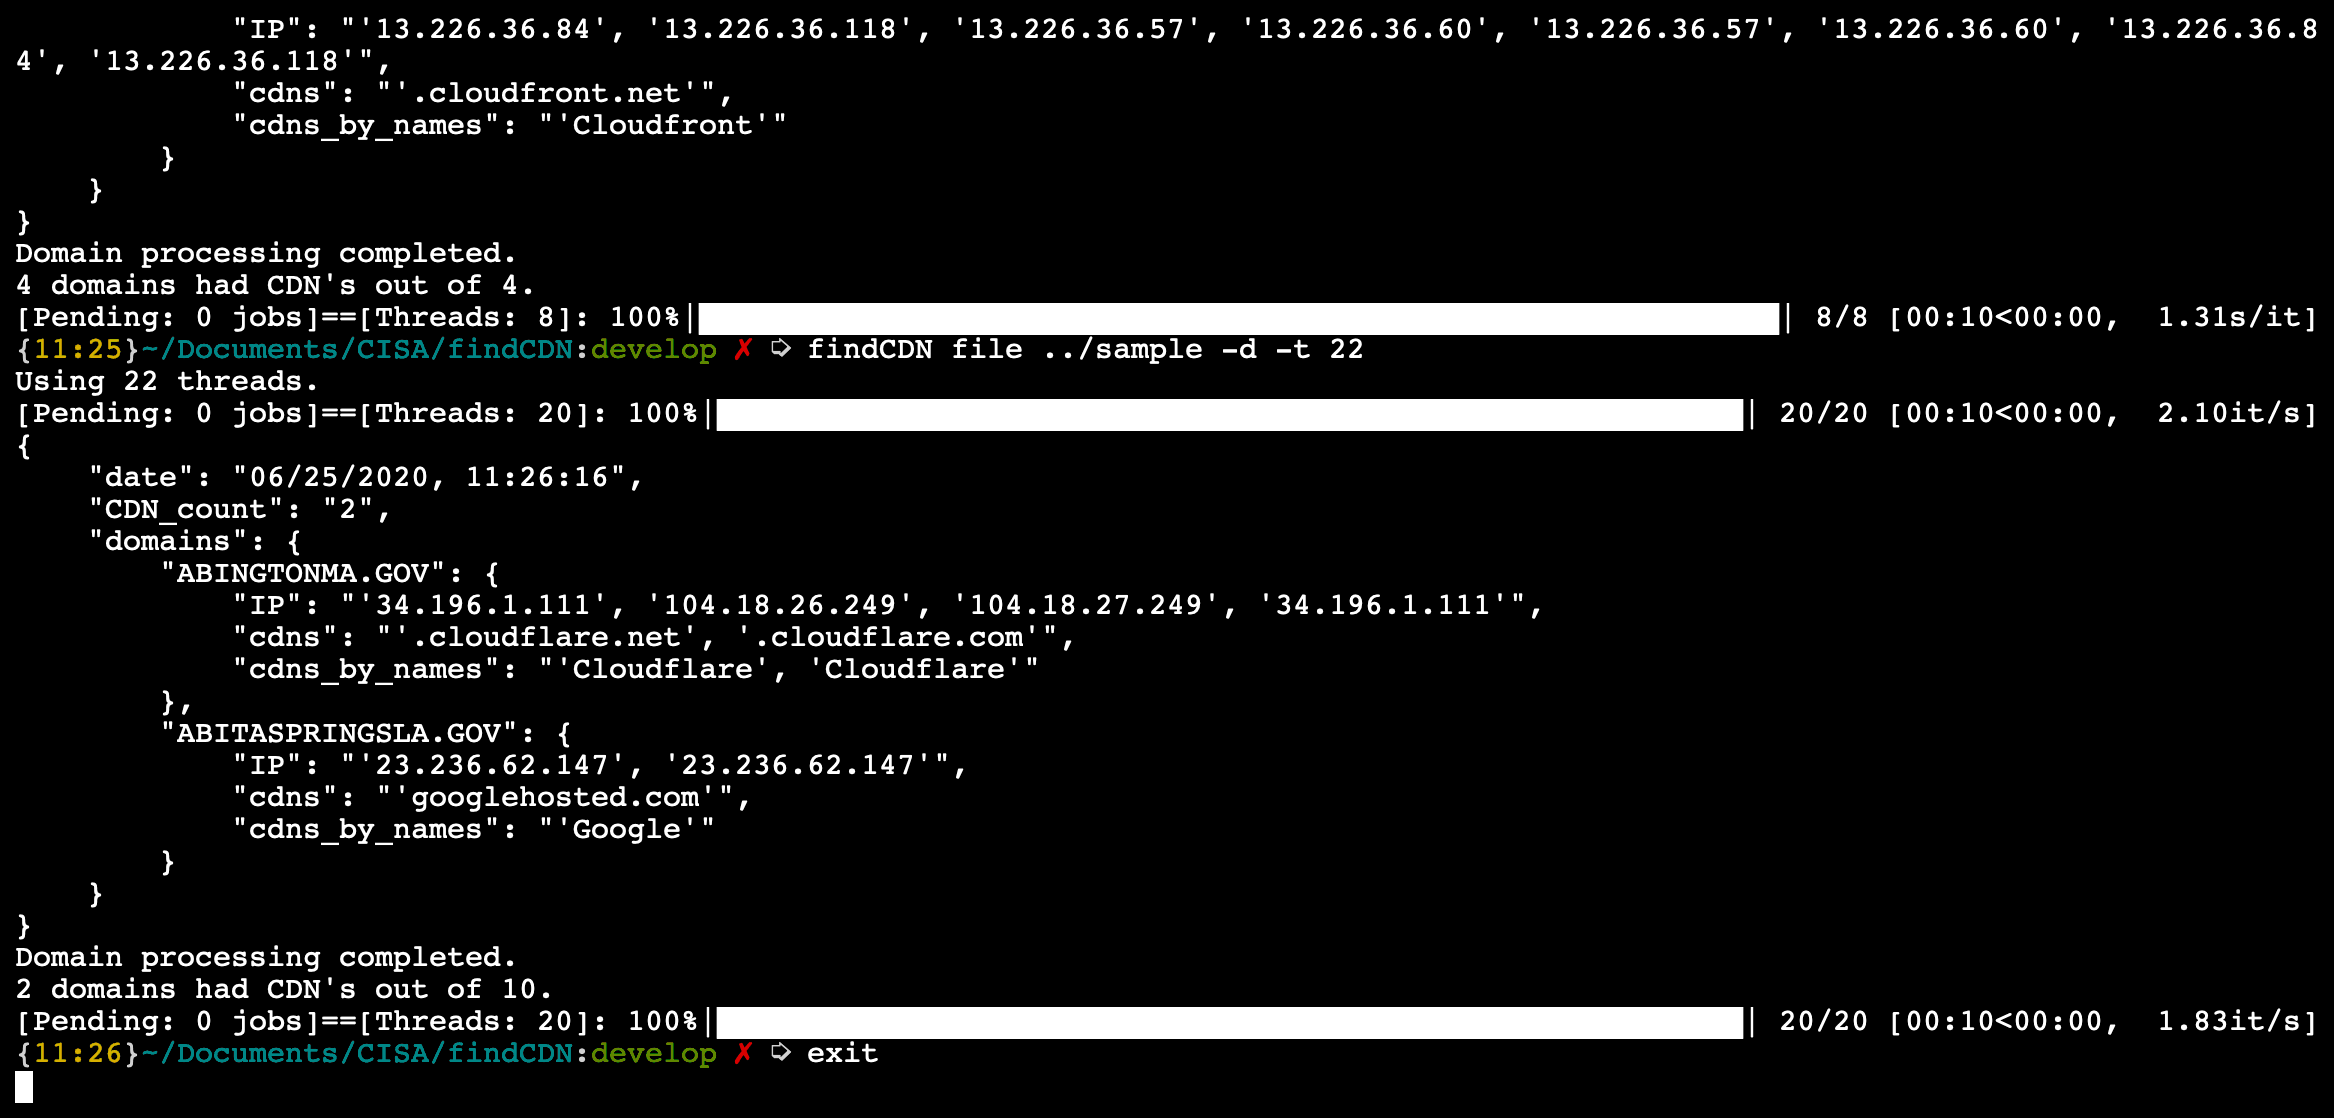
findcdn はモジュールとしてインストールできるため、その CDN 検出機能を任意のプロジェクトから呼び出して実装できます。まず、上記のように findcdn をプロジェクトにインポートします。次に、分析するドメインのリストを渡します。処理後、プログラムは入力されたドメインとそれらが使用する CDN を含む JSON オブジェクトを返します。
findcdn の動作方法は、渡されたオプションによって決まります。現在使用可能なオプションと例を以下に示します:
findcdn.main(
    domain_list: List[str],  # List of domains to search
    output_path: str = None,  # if included, output results to JSON
    verbose: bool = False,  # Verbose mode (more printing!)
    all_domains: bool = False,  # Includes domains that dont have cdn's in the output
    interactive: bool = False,  # Includes a progress bar (normally used for command line)
    double_in: bool = False,  #D ouble the number of tries on a domain to increase accuracy
    threads: int = THREADS,  # Number of threads to use
    timeout: int = TIMEOUT,  # How long to wait on a domain
    user_agent: str = USER_AGENT,  # User Agent to use
)
import findcdn
import json

domains = ['google.com', 'cisa.gov', 'censys.io', 'yahoo.com', 'pbs.org', 'github.com']
resp_json = findcdn.main(domains, output_path="output.json", double_in=True, threads=23)

dumped_json = json.loads(resp_json)

for domain in dumped_json['domains']:
    print(f"{domain} has CDNs:\n {dumped_json['domains'][domain]['cdns']}")
findcdn は 3 つのセクションに分かれています:
Chef は CDN Detection ライブラリを使用して各ドメインのすべての CDN を取得しますChef は分析を実行し、ドメインが CDN を持っていることを検出した場合にブール値の has_cdn 値を設定し、ドメインのリストをランナーファイルに返しますcdn_config.py で定義された CDN を識別するためにフィンガープリントスキャンを実行します。このツールの当初の目的は、CDN を使用しているドメインがフロント可能かどうかを自動的に検出することでした。フロンティング検出のオーバーヘッドが大きいため、このツールの開発は CDN 検出 ツール専用に方向転換しました。Domain Fronting とは何か、調査ノート、設計上の決定、特定のドメインをフロントするためのプレイブックについて詳しく説明するために、wiki を使用しています。追加のフロント可能なドメインや現在のプレイブックの欠陥を見つけた場合は、貢献をご検討ください!
詳細情報は wiki ページにあります。プロジェクトや wiki に追加してほしいものがあれば、機能リクエストや貢献をお勧めします。
これは以下のいずれかになります:
貢献を歓迎します! 詳細は CONTRIBUTING.md をご覧ください。
このプロジェクトは世界的にパブリックドメインです。
このプロジェクトは米国国内でパブリックドメインであり、 世界中の著作権および関連する権利は CC0 1.0 Universal パブリックドメイン 献呈を通じて放棄されています。
このプロジェクトへのすべての貢献は CC0 献呈の下でリリースされます。プルリクエストを送信することにより、 著作権利益の放棄に準拠することに同意したものとみなされます。
