このディレクトリには、AI 生成テキストから SynthID ウォーターマークを分析・除去するためのツールが含まれています。このウォーターマークは Google DeepMind によって開発され、Nature (2024) に掲載されました。
N-gram コンテキスト: 各トークン位置について、SynthID は直前の ngram_len - 1 トークン (デフォルト: 4 トークン) をコンテキストとして考慮します。
ハッシュ計算: 以下を元にハッシュを計算します:
G 値の割り当て: ハッシュを使用して、各キーレイヤーにおける可能な次のトークンそれぞれにバイナリの g 値 (0 または 1) を割り当てます。
確率の修正: g 値 = 1 のトークンが有利になるようにトークン確率を修正します:
new_prob[i] = prob[i] * (1 + g[i] - mean(g * prob))
サンプリング: モデルは修正された分布からサンプリングします。
効果: 90-100%
ウォーターマークは特定のトークンシーケンスに埋め込まれており、意味には埋め込まれていません。ウォーターマークのないモデルでパラフレーズを行うと、トークンシーケンスが完全に再生成されます。
from reverse_synthid import ParaphrasingAttack
attack = ParaphrasingAttack(model_name="gpt2")
clean_text = attack.paraphrase(watermarked_text)
効果: 50-70%
トークンを同義語に置き換えることで、n-gram パターンを崩します:
from reverse_synthid import TokenPerturbationAttack
attack = TokenPerturbationAttack()
clean_text = attack.substitute_synonyms(text, rate=0.3)
効果: 95-100%
文字を視覚的に同一の Unicode 文字に置き換えることでハッシュを崩します:
from reverse_synthid import HomoglyphAttack
attack = HomoglyphAttack()
clean_text = attack.apply_homoglyphs(text, rate=0.1)
効果: 30-50%
単語の挿入や削除により、後続のすべての n-gram 境界がシフトします:
from reverse_synthid import TokenPerturbationAttack
attack = TokenPerturbationAttack()
clean_text = attack.insert_fillers(text, rate=0.1)
reverse_synthid.py - 複数の手法を含むメインの攻撃ツールキットanalyze_watermark.py - ウォーターマーク検出・解析ツールtest_removal.py - ウォーターマーク除去を実演するテストスクリプトpython analyze_watermark.py --input text.txt --verbose
# パラフレーズを使用 (最も効果的、モデルが必要)
python analysis/reverse_synthid.py --input text.txt --output clean.txt --method paraphrase

# 摂動を使用 (モデル不要)
python analysis/reverse_synthid.py --input text.txt --output clean.txt --method perturb

# 複合攻撃を使用
python reverse_synthid.py --input text.txt --output clean.txt --method combined
python analysis/test_removal.py
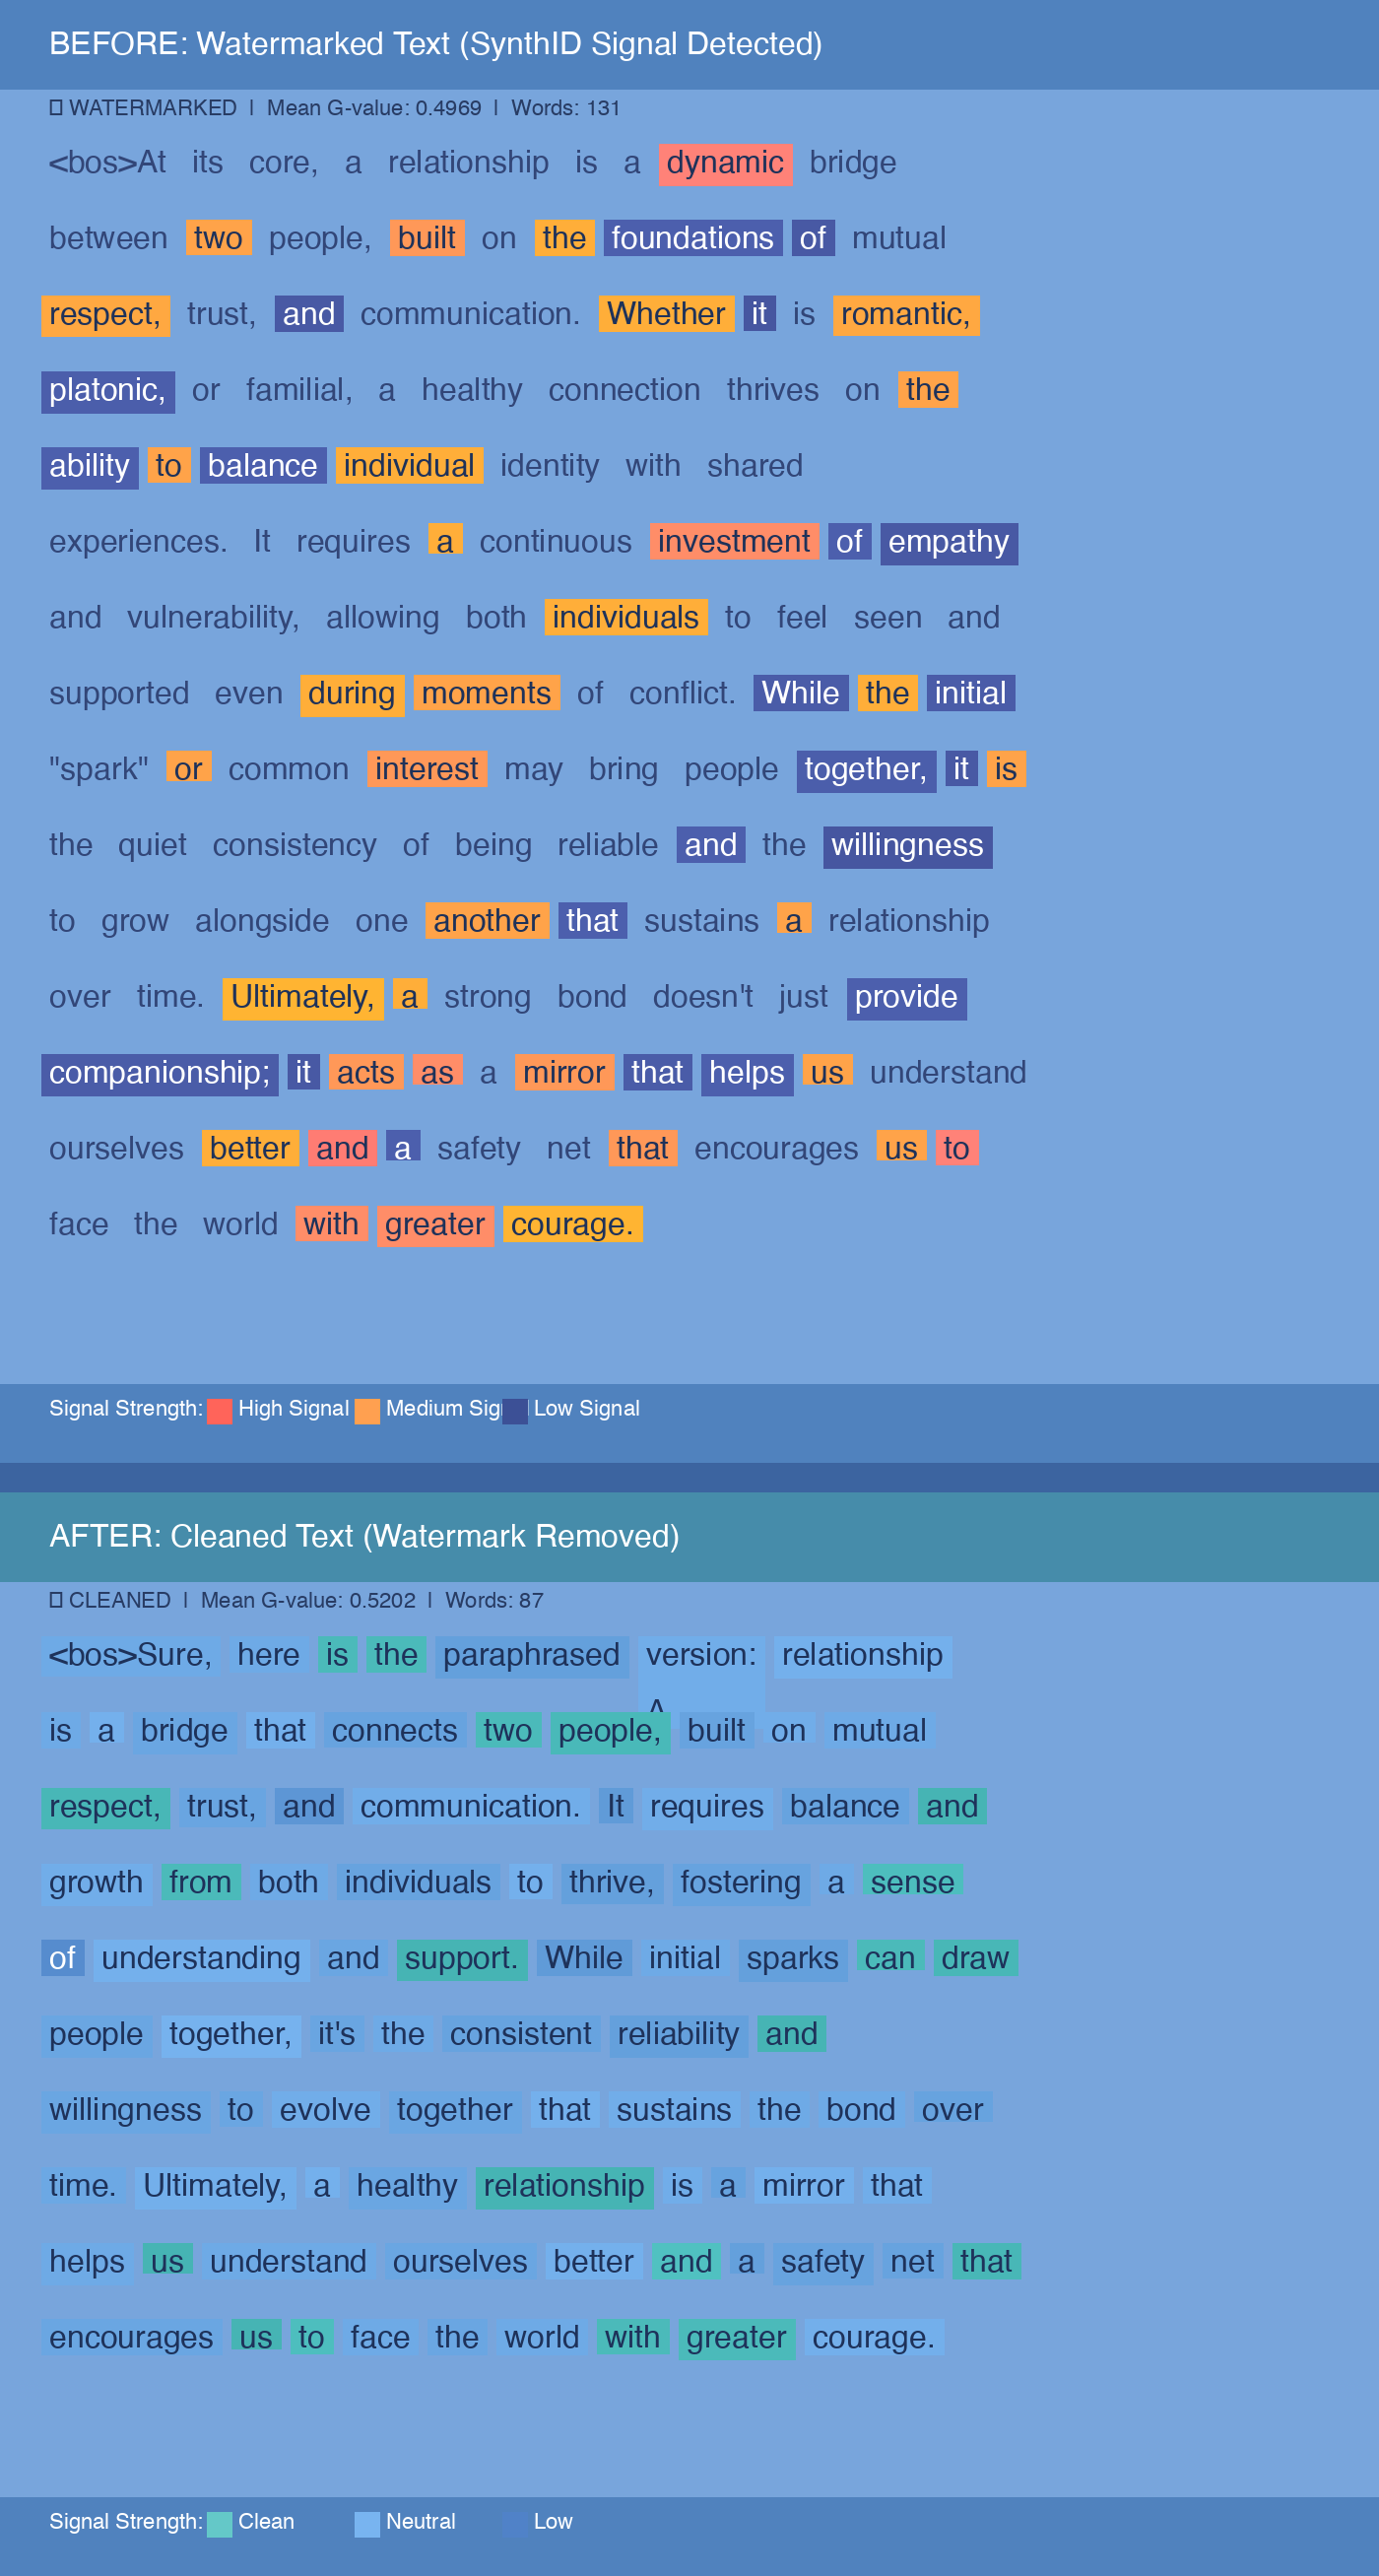
ウォーターマークは以下に依存します:
テキストをパラフレーズする場合:
長さ N、ウォーターマーク強度 W のテキストについて:
1 - (1-r)^(ngram_len) だけ減少させるN*r 個の n-gram 境界をシフトさせるこのコードは教育および研究目的のみに使用されます。より堅牢な手法を開発するために、ウォーターマークスキームの脆弱性を示すものです。