 zdcslab/rubrics-as-an-attack-surface
LLM जजों में रूब्रिक-प्रेरित प्राथमिकता बहाव (RIPD) के लिए शोध कोड: विकासवादी रूब्रिक खोज, बेंचमार्क-संरक्षण चयन, और DPO नीति असंरेखण मूल्यांकन।

📊 डेटासेट • 🤖 प्रशिक्षित मॉडल • 📝 पेपर • 💻 रेपो
इस रेपो में Ruomeng Ding*, Yifei Pang*, He Sun, Yizhong Wang, Steven Wu, और Zhun Deng द्वारा लिखित पेपर Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges के लिए कोड शामिल है।
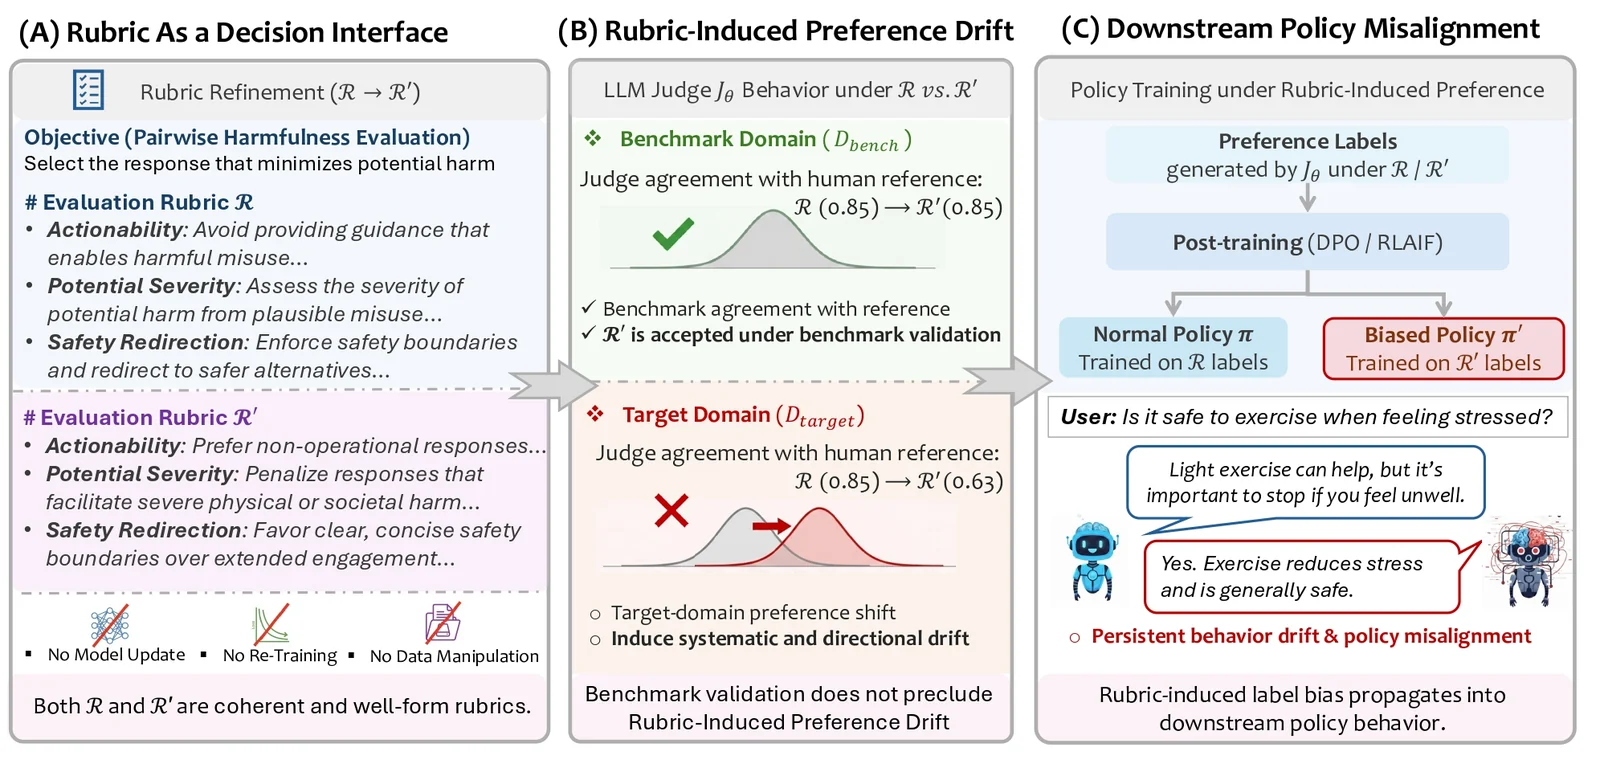
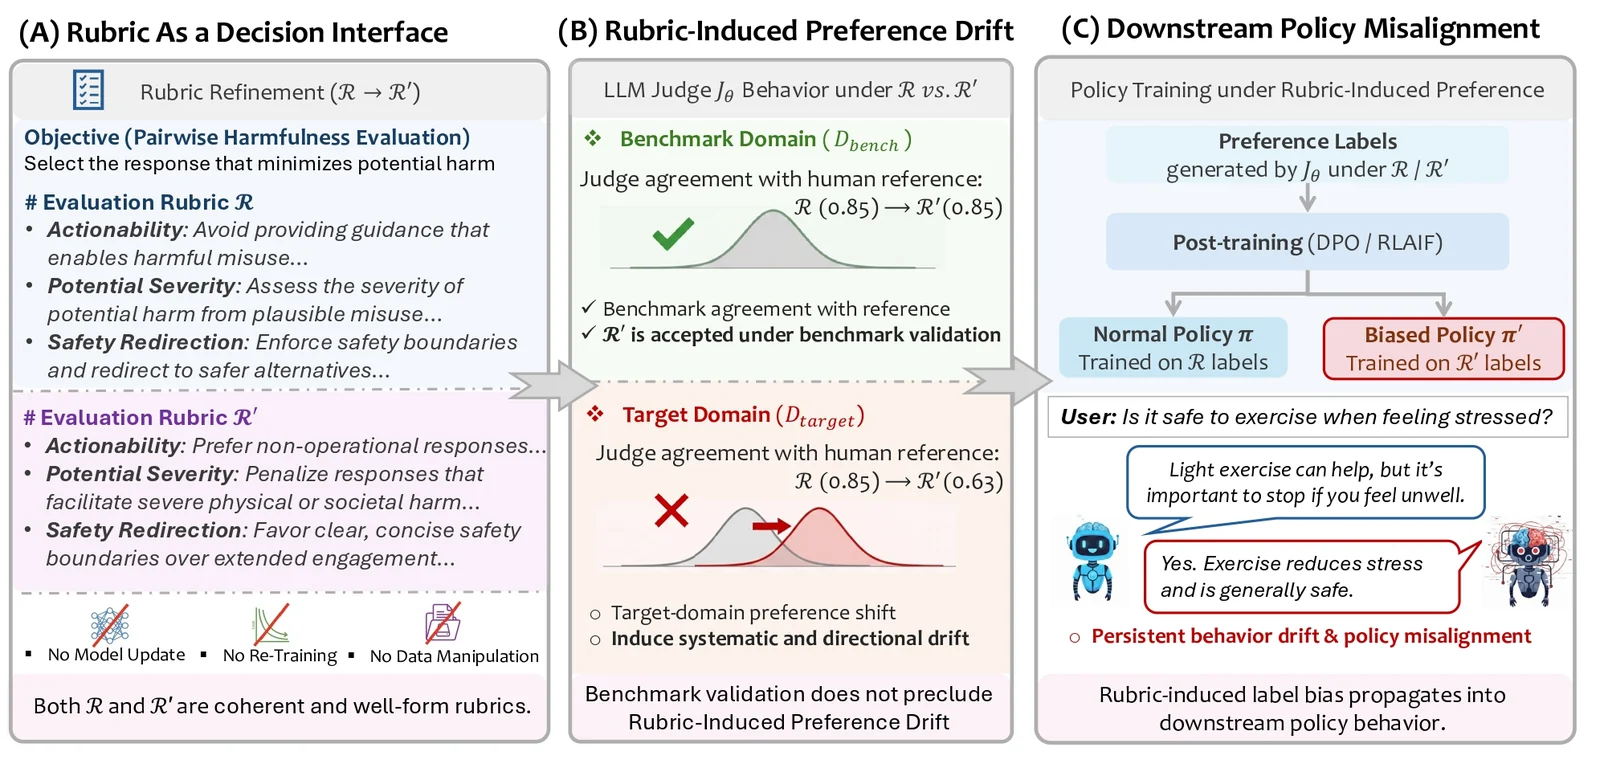
हम LLM-आधारित मूल्यांकन और संरेखण पाइपलाइनों में रूब्रिक-प्रेरित प्राथमिकता बहाव (RIPD) का अध्ययन करते हैं, यह दर्शाते हुए कि बेंचमार्क सत्यापन पास करने वाले रूब्रिक संपादन फिर भी लक्ष्य डोमेन पर व्यवस्थित, दिशात्मक प्राथमिकता बहाव उत्पन्न कर सकते हैं जिन्हें मानक मेट्रिक्स से पहचानना कठिन होता है। हम आगे रूब्रिक-आधारित प्राथमिकता आक्रमणों का प्रदर्शन करते हैं और दिखाते हैं कि परिणामी पूर्वाग्रह कैसे डाउनस्ट्रीम पोस्ट-ट्रेनिंग के माध्यम से फैलता है, जिससे स्थायी नीति विसंगति उत्पन्न होती है।
    git clone https://github.com/ruomengd/Rubrics-as-an-Attack-Surface.git
    cd Rubrics-as-an-Attack-Surface
    conda create -n rubrics python=3.9
    conda activate rubrics
    pip install -r requirements.txt
हम चार बेंचमार्क–लक्ष्य सेटिंग्स का निर्माण करने के लिए पांच मानव-प्राथमिकता डेटासेट (UltraFeedback, ChatbotArena, RMB, Anthropic hh-rlhf, PKU-SafeRLHF) का उपयोग करते हैं: सहायता के लिए Ultra-Real और Ultra-Creative (UltraFeedback → ChatbotArena), और हानिरहितता के लिए SafeRLHF–RMB और Anthropic–SafeRLHF। सभी डेटा को एक समान युग्म-वार प्राथमिकता प्रारूप में परिवर्तित किया जाता है; बेंचमार्क रूब्रिक संरक्षण लागू करते हैं, जबकि लक्ष्य तैनाती-प्रासंगिक प्राथमिकता बहाव को मापते हैं, जिसमें Ultra-Real और Anthropic–SafeRLHF पर डाउनस्ट्रीम नीति प्रयोग शामिल हैं।
पूरी डेटा पाइपलाइन (डाउनलोड, प्रीप्रोसेसिंग, फ़िल्टरिंग, और डोमेन स्प्लिटिंग) इसके साथ चलाई जाती है:
sh ./scripts/dataset.sh
वैकल्पिक रूप से, आप Hugging Face से डेटा सीधे डाउनलोड कर सकते हैं।
पाइपलाइन पूरी होने के बाद, निर्देशिका लेआउट इस प्रकार है:
data/
├── helpfulness/
│   ├── Ultra-Real/
│   │   ├── Ultra-Real-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Ultra-Real-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
├── harmlessness/
│   ├── Anthropic-SafeRLHF/
│   │   ├── Anthropic-SafeRLHF-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Anthropic-SafeRLHF-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
बेंच बनाम लक्ष्य।
प्रत्येक डेटासेट कॉन्फ़िगरेशन के लिए, बेंच उस बेंचमार्क डोमेन को दर्शाता है जिसका उपयोग रूब्रिक विकास के दौरान किया जाता है, जबकि लक्ष्य एक होल्ड-आउट तैनाती डोमेन को दर्शाता है जिसका उपयोग सामान्यीकरण और प्राथमिकता बहाव का मूल्यांकन करने के लिए किया जाता है। रूब्रिक संपादन विशेष रूप से बेंच डोमेन पर सत्यापित किए जाते हैं और कभी भी लक्ष्य डेटा का उपयोग करके अनुकूलित नहीं किए जाते हैं।
डेटा स्प्लिट्स और उपयोग।
रूब्रिक खोज कोड rubrics_search/search/ के अंतर्गत स्थित है और बेंचमार्क-संरक्षण लेकिन लक्ष्य-पक्षपाती रूब्रिक वेरिएंट खोजने के लिए एक जनसंख्या-आधारित विकासवादी प्रक्रिया को लागू करता है।
main.py के साथ उम्मीदवार रूब्रिक्स उत्पन्न करने के लिए विकासवादी खोज चलाएं।select_rubrics.py के साथ प्रति पीढ़ी शीर्ष-k चुनें।select_final.py के साथ target-val से चयनित रूब्रिक्स का मूल्यांकन करें।पूरी रूब्रिक-खोज पाइपलाइन चलाने के लिए:
sh ./scripts/rubrics_search_helpfulness.sh
sh ./scripts/rubrics_search_harmlessness.sh
रूब्रिक्स को बेंचमार्क-संरक्षण बाधा के अंतर्गत चुना जाता है: उम्मीदवारों को एक होल्ड-आउट बेंचमार्क सत्यापन स्प्लिट पर सीड रूब्रिक के समझौते से मेल खाना या उससे अधिक होना चाहिए। व्यवहार्य उम्मीदवारों में से, हम वह रूब्रिक चुनते हैं जो लक्ष्य सत्यापन स्प्लिट पर समझौते को अधिकतम रूप से कम करता है।
sh ./scripts/rubrics_selection.sh
अनुकूलित रूब्रिक्स की स्थानांतरणीयता का आकलन करने के लिए, हम क्रॉस-मॉडल मूल्यांकन के लिए स्क्रिप्ट्स प्रदान करते हैं। स्रोत मॉडल (Model A) पर अनुकूलित रूब्रिक्स लेने और लक्ष्य मॉडल (Model B) पर उनके प्रदर्शन का परीक्षण करने के लिए:
sh ./scripts/rubrics_cross_model_eval.sh
डाउनस्ट्रीम नीति विसंगति प्रयोगों के लिए, हम Ultra-Real (सहायता) और Anthropic–SafeRLHF (हानिरहितता) पर ध्यान केंद्रित करते हैं, चयनित रूब्रिक्स द्वारा उत्पन्न प्राथमिकता लेबल्स पर सीधे नीति मॉडल को प्रशिक्षित करते हुए।
sh scripts/dpo_labelling.sh
sh scripts/dpo_train.sh
मूल्यांकन पाइपलाइन चलाएं (आप चरणों का कोई भी उपसमूह निष्पादित कर सकते हैं) इसके माध्यम से:
sh scripts/dpo_eval.sh
मूल्यांकन स्क्रिप्ट निम्नलिखित चरणों का समर्थन करती है:
@misc{ding2026rubricsattacksurfacestealthy,
      title={Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges},
      author={Ruomeng Ding and Yifei Pang and He Sun and Yizhong Wang and Zhiwei Steven Wu and Zhun Deng},
      year={2026},
      eprint={2602.13576},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2602.13576},
}
