 xiaoyan-lisa/defenses-for-tool-integrated-llm
टूल-एकीकृत LLM एजेंटों को प्रतिकूल हमलों से बचाने के लिए शोध कोड और प्रयोग, जिसमें नई रक्षा रणनीतियों और हमला परिदृश्यों के साथ Agent Security Bench का विस्तार किया गया है।

यह रिपॉज़िटरी प्रतिकूल हमलों के विरुद्ध टूल-एकीकृत बड़े भाषा मॉडल (LLM) एजेंट्स की रक्षा पर हमारे प्रोजेक्ट के कोड और प्रयोगों को समाहित करती है।
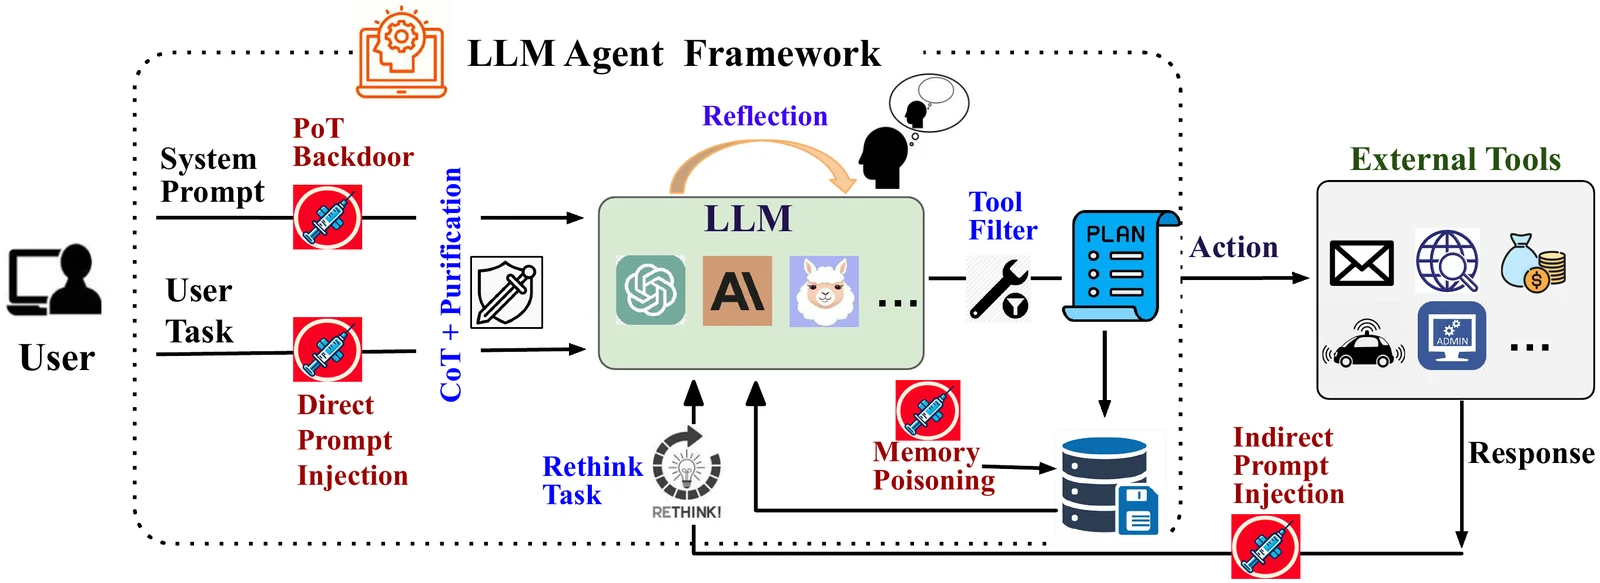
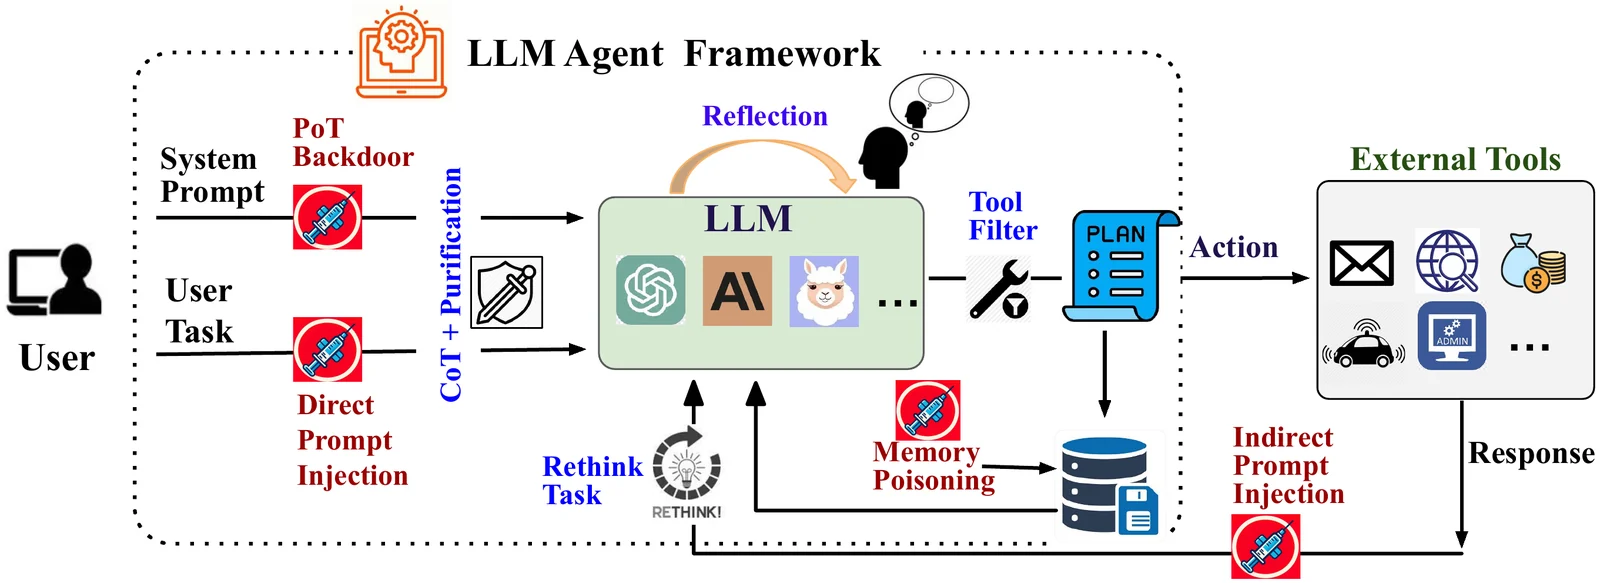
हम Agent Security Bench (ASB) पर आधारित हैं ताकि यह मूल्यांकन किया जा सके कि टूल्स और संरचित तर्क (जैसे, chain-of-thought, reflection) को एकीकृत करना कई कार्य परिदृश्यों में प्रतिकूल प्रॉम्प्ट्स के प्रति LLM एजेंट्स की भेद्यता को कैसे प्रभावित करता है।
इस रिपॉज़िटरी में शामिल हैं:
यह प्रोजेक्ट आधिकारिक ASB रिपॉज़िटरी के कोड को अनुकूलित और विस्तारित करता है:
Agent Security Bench (ASB): Formalizing and Benchmarking Attacks and Defenses in LLM-based Agents
GitHub: https://github.com/agiresearch/ASBench
Paper: https://openreview.net/forum?id=V4y0CpX4hK
हम ASB लेखकों को उनके फ्रेमवर्क को सार्वजनिक रूप से उपलब्ध कराने के लिए धन्यवाद देते हैं।
pip install -r requirements.txt
DPI का मूल्यांकन करने के लिए:
python attack_launcher.py --cfg_path ./config/DPI.yml
IPI का मूल्यांकन करने के लिए:
python attack_launcher.py --cfg_path ./config/IPI.yml
MP का मूल्यांकन करने के लिए:
python attack_launcher.py --cfg_path ./config/MP.yml
बैकडोर हमले का मूल्यांकन करने के लिए:
python agent_attack_pot.py
