 thunlp/openattack
पाठ्य प्रतिकूल हमले के लिए एक ओपन-सोर्स पैकेज।


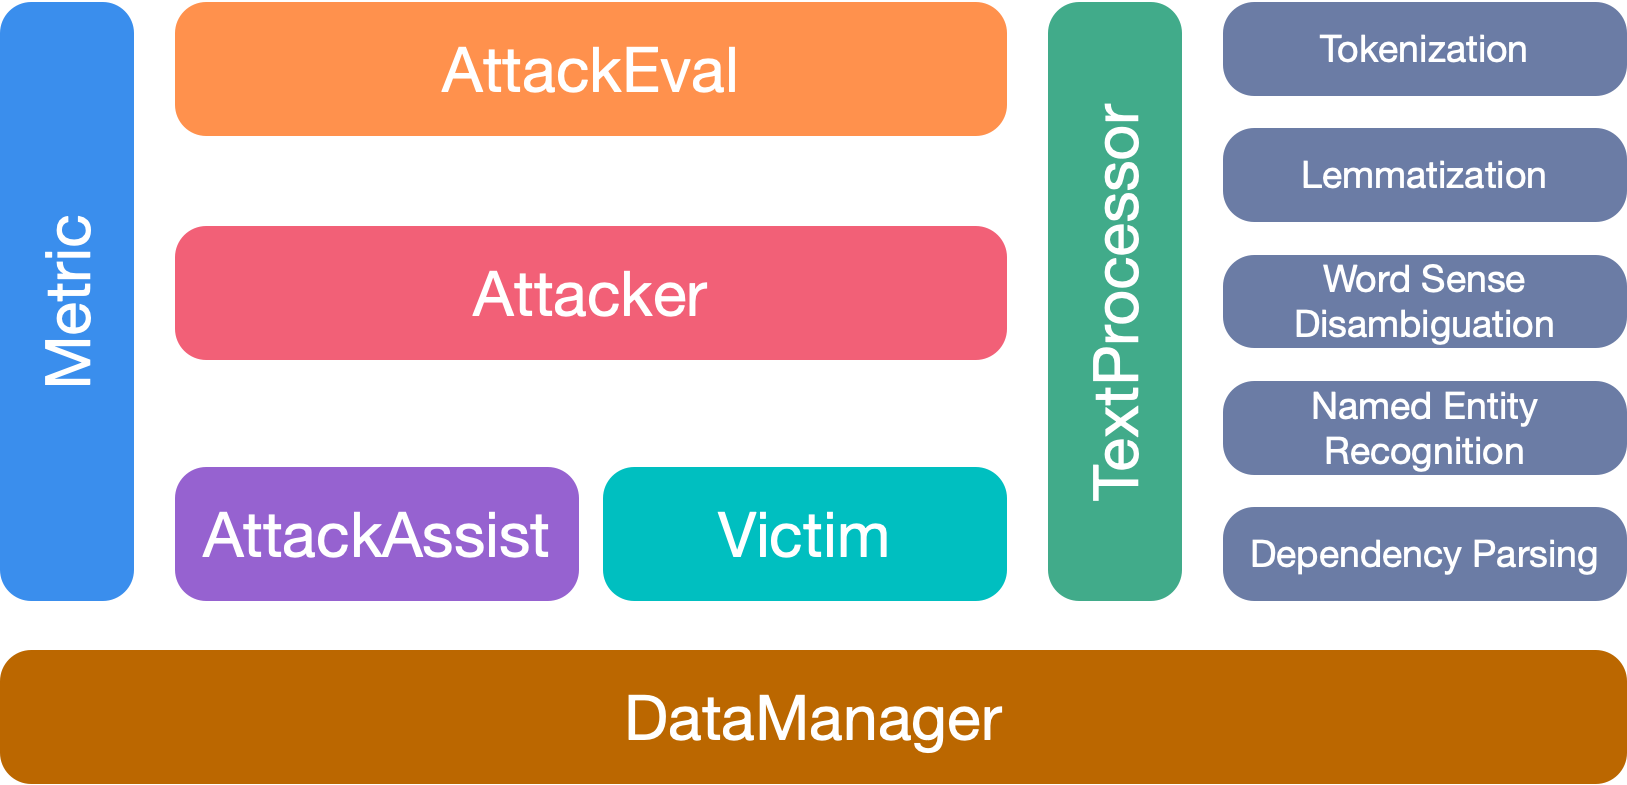
दस्तावेज़ीकरण • विशेषताएँ और उपयोग • उपयोग उदाहरण • हमला मॉडल • टूलकिट डिज़ाइन
OpenAttack एक ओपन-सोर्स Python-आधारित पाठ्य प्रतिकूल हमला टूलकिट है, जो पाठ्य प्रतिकूल हमले की पूरी प्रक्रिया को संभालता है, जिसमें पाठ का प्रीप्रोसेसिंग, पीड़ित मॉडल तक पहुँचना, प्रतिकूल उदाहरण उत्पन्न करना और मूल्यांकन शामिल है।
⭐️ सभी हमला प्रकारों के लिए समर्थन। OpenAttack सभी प्रकार के हमलों का समर्थन करता है, जिसमें वाक्य-/शब्द-/वर्ण-स्तरीय गड़बड़ी और ग्रेडिएंट-/स्कोर-/निर्णय-आधारित/अंधा हमला मॉडल शामिल हैं;
⭐️ बहुभाषीयता। OpenAttack अब अंग्रेजी और चीनी का समर्थन करता है। इसका विस्तार योग्य डिज़ाइन अधिक भाषाओं के त्वरित समर्थन को सक्षम बनाता है;
⭐️ समानांतर प्रसंस्करण। OpenAttack हमले की दक्षता में सुधार के लिए हमला मॉडलों के मल्टी-प्रोसेस रनिंग के लिए समर्थन प्रदान करता है;
⭐️ 🤗 Hugging Face के साथ संगतता। OpenAttack 🤗 Transformers और Datasets लाइब्रेरीज़ के साथ पूरी तरह से एकीकृत है;
⭐️ महान विस्तार योग्यता। आप आसानी से किसी भी अनुकूलित पीड़ित मॉडल पर किसी भी अनुकूलित डेटासेट पर हमला कर सकते हैं या एक अनुकूलित हमला मॉडल विकसित और मूल्यांकन कर सकते हैं।
✅ हमला मॉडलों के लिए विभिन्न सुविधाजनक बेसलाइन प्रदान करना;
✅ अपने गहन मूल्यांकन मैट्रिक्स का उपयोग करके हमला मॉडलों का व्यापक रूप से मूल्यांकन करना;
✅ सामान्य हमला घटकों की सहायता से नए हमला मॉडलों के त्वरित विकास में सहायता करना;
✅ विभिन्न प्रतिकूल हमलों के विरुद्ध मशीन लर्निंग मॉडल की मजबूती का मूल्यांकन करना;
✅ उत्पन्न प्रतिकूल उदाहरणों के साथ प्रशिक्षण डेटा को समृद्ध करके मशीन लर्निंग मॉडल की मजबूती में सुधार के लिए प्रतिकूल प्रशिक्षण आयोजित करना।
pip का उपयोग करके (अनुशंसित)```bashpip install OpenAttack
#### 2. इस रिपॉजिटरी को क्लोन करना```bash
git clone https://github.com/thunlp/OpenAttack.git
cd OpenAttack
python setup.py install
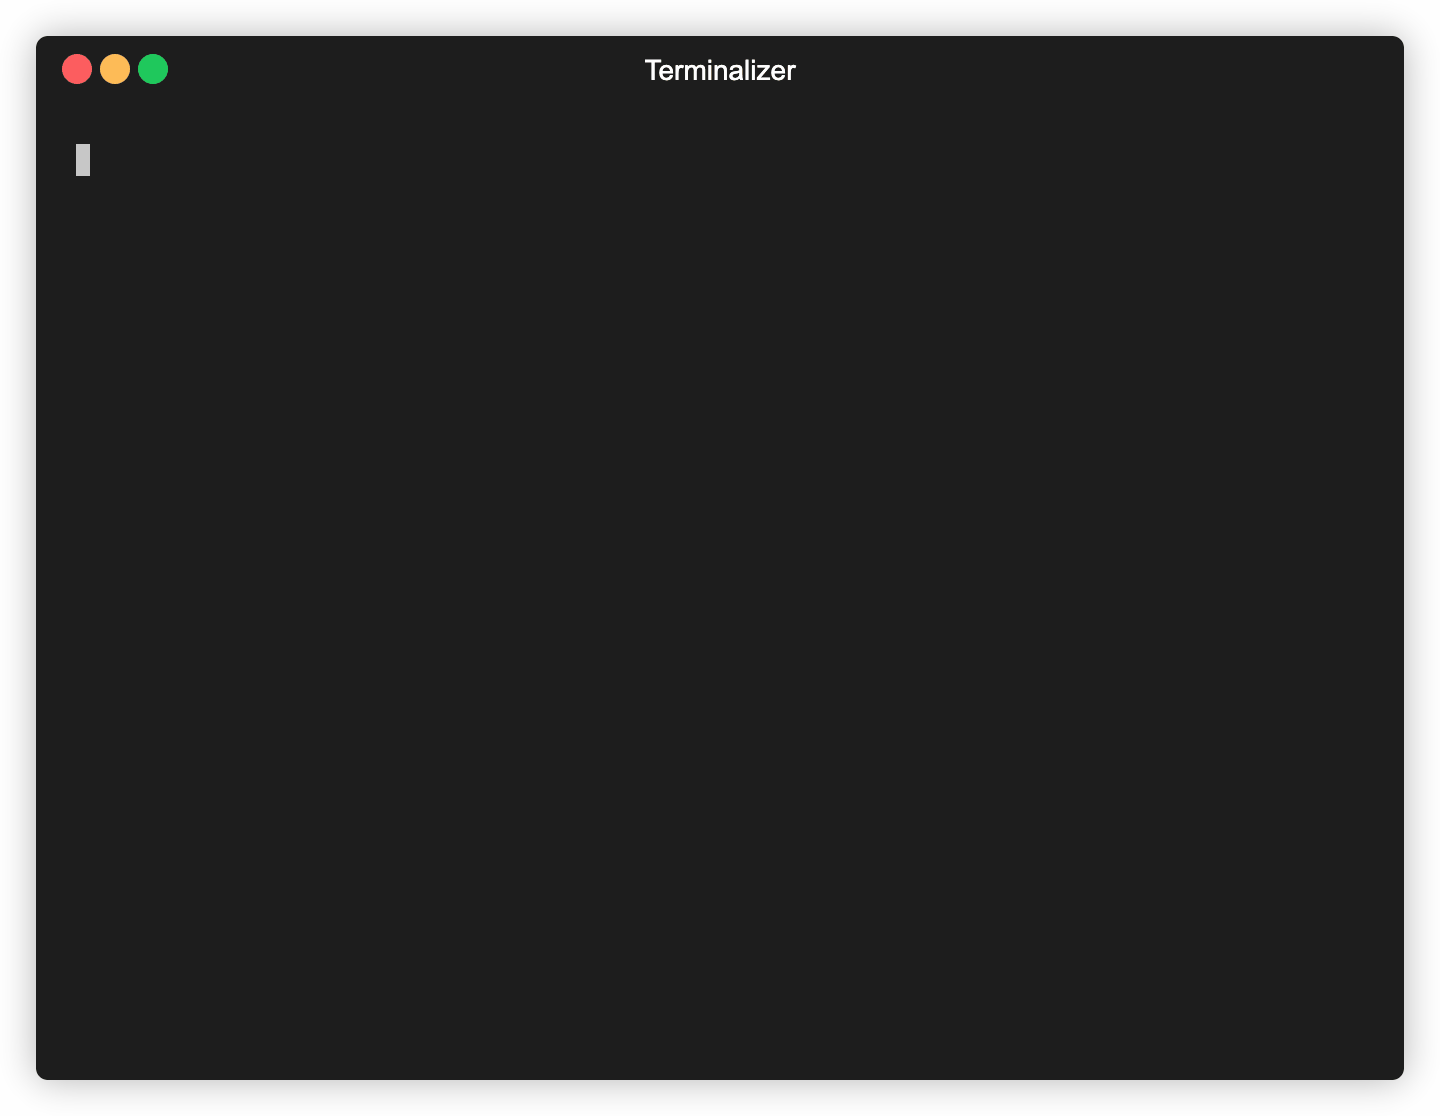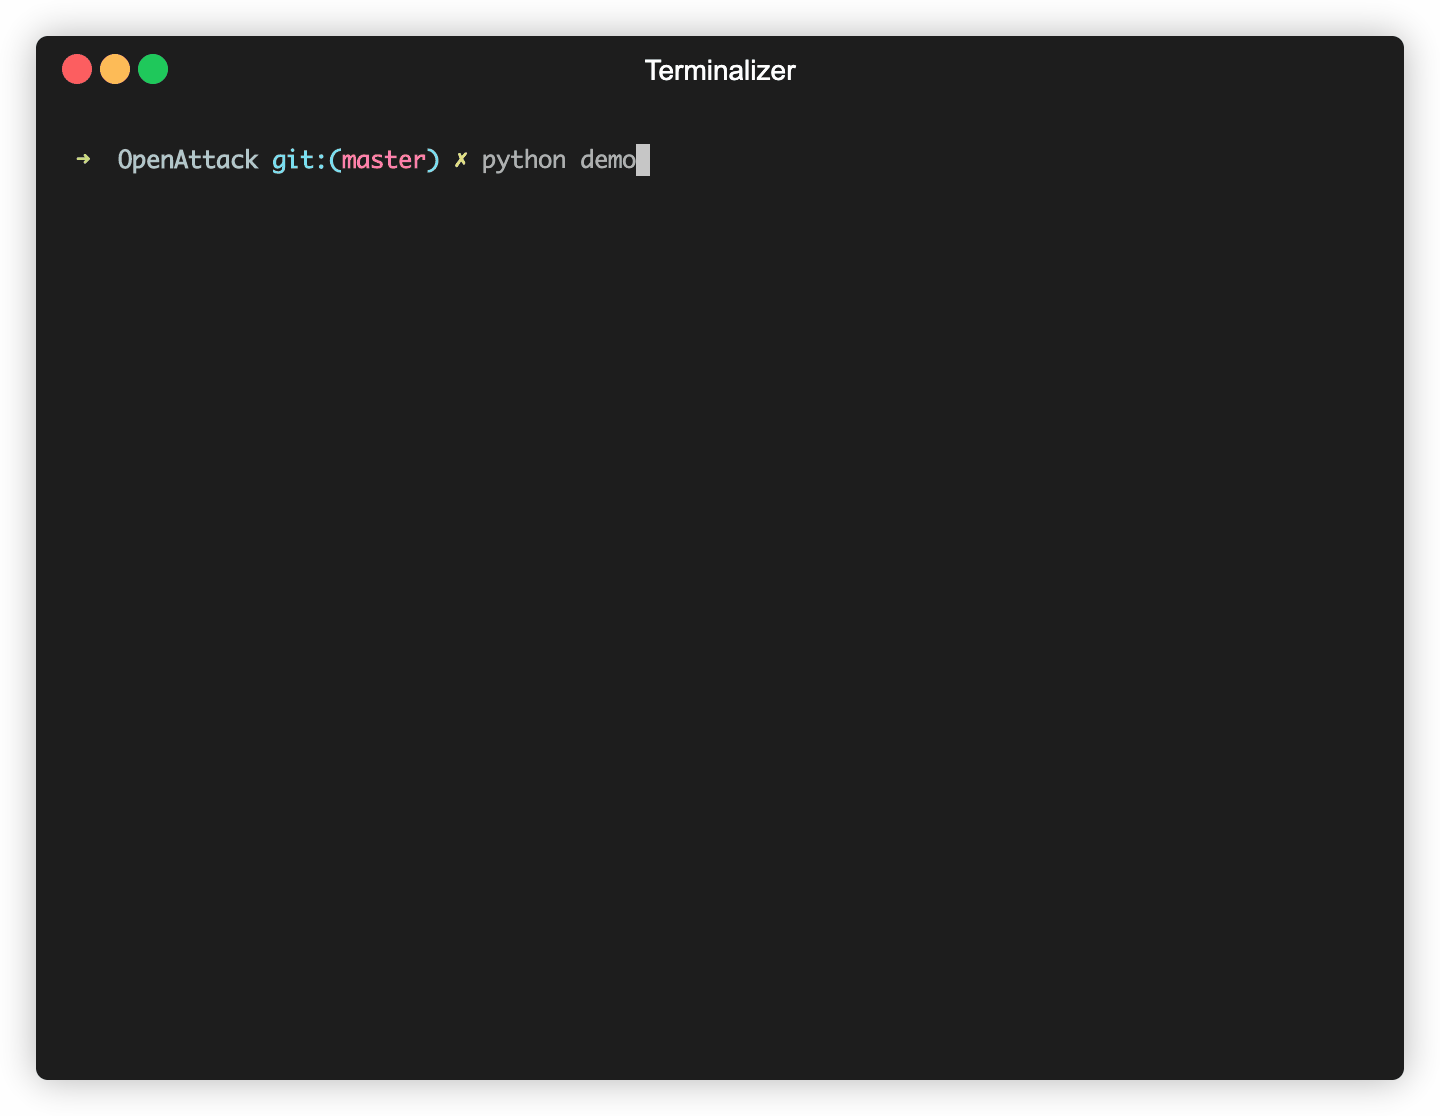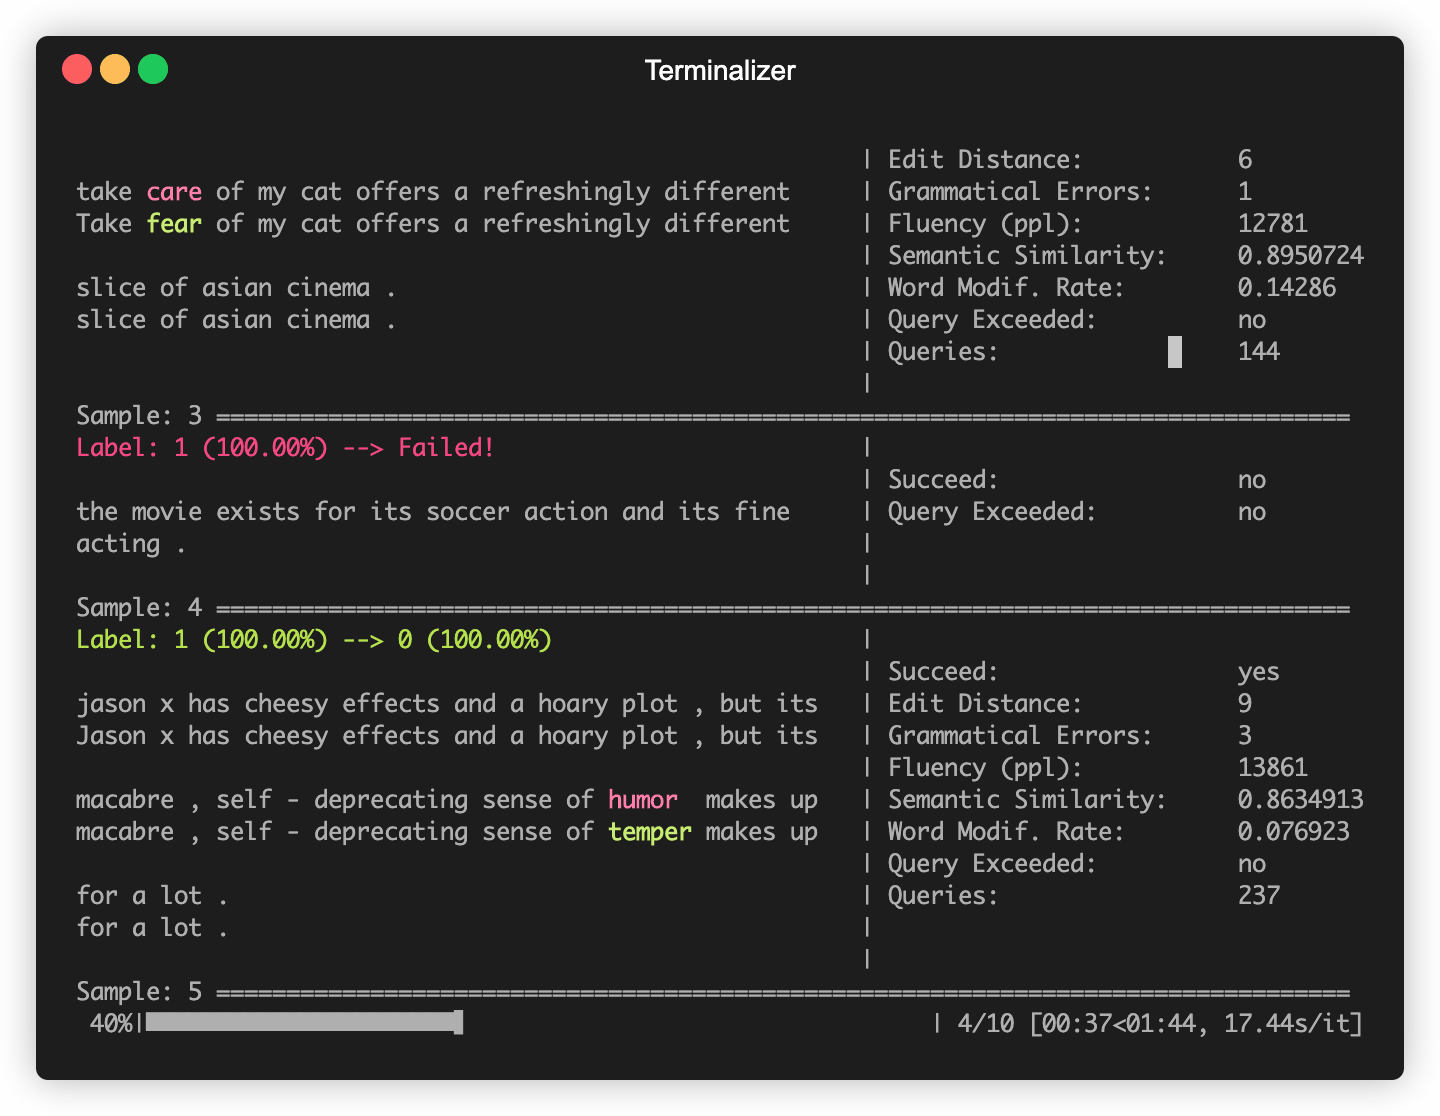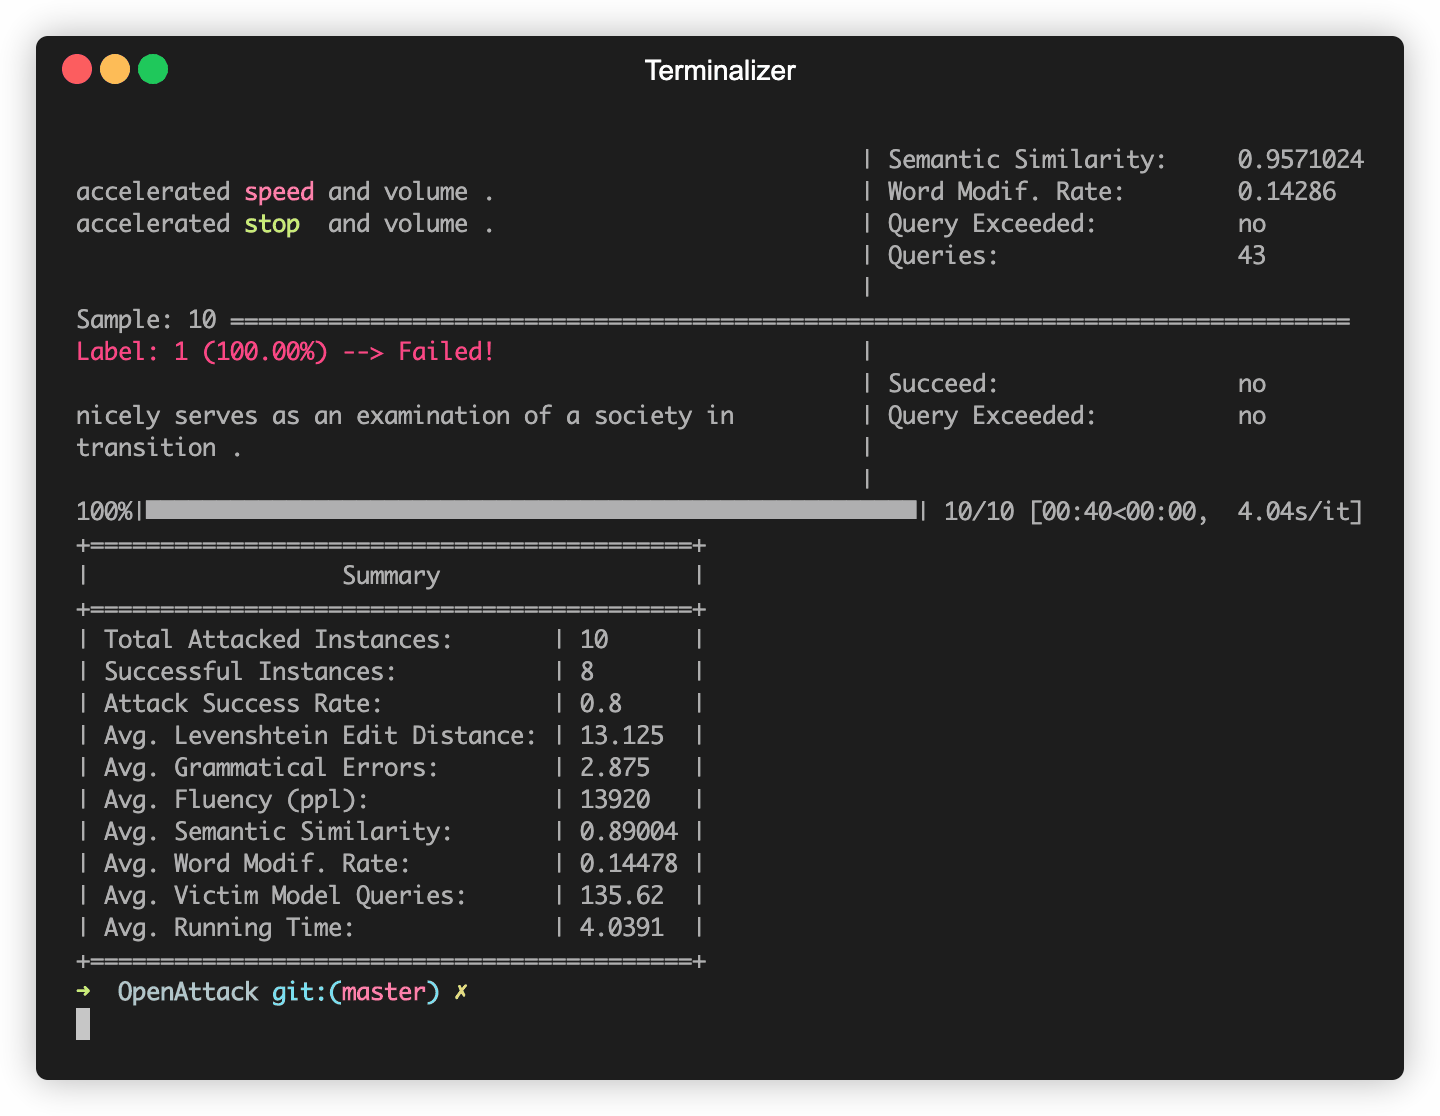
स्थापना के बाद, आप यह जांचने के लिए demo.py चला सकते हैं कि OpenAttack ठीक से काम कर रहा है या नहीं:```
python demo.py
## उपयोग उदाहरण
#### अंतर्निहित पीड़ित मॉडलों पर हमला
OpenAttack में कुछ सामान्यतः उपयोग किए जाने वाले NLP मॉडल जैसे BERT ([Devlin et al. 2018](https://arxiv.org/abs/1810.04805)) और RoBERTa ([Liu et al. 2019](https://arxiv.org/abs/1907.11692)) शामिल हैं, जिन्हें सामान्यतः उपयोग किए जाने वाले डेटासेटों (जैसे [SST-2](https://nlp.stanford.edu/sentiment/treebank.html)) पर फाइन-ट्यून किया गया है। आप इन अंतर्निहित पीड़ित मॉडलों के विरुद्ध सरलता से प्रतिकूल हमले कर सकते हैं।
निम्नलिखित कोड स्निपेट दिखाता है कि कैसे PWWS, एक लालची एल्गोरिथम-आधारित हमला मॉडल ([Ren et al., 2019](https://www.aclweb.org/anthology/P19-1103.pdf)), का उपयोग करके SST-2 डेटासेट पर BERT पर हमला किया जाए (पूर्ण निष्पादन योग्य कोड [यहाँ](https://github.com/thunlp/openattack/blob/master/examples/workflow.py) है)।```python
import OpenAttack as oa
import datasets # use the Hugging Face's datasets library
# change the SST dataset into 2-class
def dataset_mapping(x):
return {
"x": x["sentence"],
"y": 1 if x["label"] > 0.5 else 0,
}
# choose a trained victim classification model
victim = oa.DataManager.loadVictim("BERT.SST")
# choose 20 examples from SST-2 as the evaluation data
dataset = datasets.load_dataset("sst", split="train[:20]").map(function=dataset_mapping)
# choose PWWS as the attacker and initialize it with default parameters
attacker = oa.attackers.PWWSAttacker()
# prepare for attacking
attack_eval = OpenAttack.AttackEval(attacker, victim)
# launch attacks and print attack results
attack_eval.eval(dataset, visualize=True)
निम्नलिखित कोड स्निपेट बताता है कि SST-2 पर अनुकूलित भावना विश्लेषण मॉडल (NLTK में निर्मित एक सांख्यिकीय मॉडल) पर हमला करने के लिए PWWS का उपयोग कैसे करें (पूर्ण निष्पादन योग्य कोड यहाँ है)।
class MyClassifier(oa.Classifier): def init(self): # nltk.sentiment.vader.SentimentIntensityAnalyzer is a traditional sentiment classification model. nltk.download('vader_lexicon') self.model = SentimentIntensityAnalyzer()
def get_pred(self, input_):
    return self.get_prob(input_).argmax(axis=1)

# access to the classification probability scores with respect input sentences
def get_prob(self, input_):
    ret = []
    for sent in input_:
        # SentimentIntensityAnalyzer calculates scores of “neg” and “pos” for each instance
        res = self.model.polarity_scores(sent)

        # we use 𝑠𝑜𝑐𝑟𝑒_𝑝𝑜𝑠 / (𝑠𝑐𝑜𝑟𝑒_𝑛𝑒𝑔 + 𝑠𝑐𝑜𝑟𝑒_𝑝𝑜𝑠) to represent the probability of positive sentiment
        # Adding 10^−6 is a trick to avoid dividing by zero.
        prob = (res["pos"] + 1e-6) / (res["neg"] + res["pos"] + 2e-6)

        ret.append(np.array([1 - prob, prob]))

    # The get_prob method finally returns a np.ndarray of shape (len(input_), 2). See Classifier for detail.
    return np.array(ret)
def dataset_mapping(x): return { "x": x["sentence"], "y": 1 if x["label"] > 0.5 else 0, }
dataset = datasets.load_dataset("sst", split="train[:20]").map(function=dataset_mapping)
victim = MyClassifier()
attacker = oa.attackers.PWWSAttacker()
attack_eval = oa.AttackEval(attacker, victim)
attack_eval.eval(dataset, visualize=True)
</details>


<details>
<summary><strong>अनुकूलित डेटासेट</strong></summary>

निम्नलिखित कोड स्निपेट दिखाता है कि कैसे PWWS का उपयोग करके एक **अनुकूलित** डेटासेट पर मौजूदा फाइन-ट्यून किए गए भावना विश्लेषण मॉडल पर हमला किया जा सकता है (पूर्ण निष्पादन योग्य कोड [यहाँ](https://github.com/thunlp/openattack/blob/master/examples/custom_dataset.py) है)।```python
import OpenAttack as oa
import transformers
import datasets
