 salesforce/merlion
टाइम सीरीज़ इंटेलिजेंस के लिए एंड-टू-एंड Python फ्रेमवर्क, जो एनोमली डिटेक्शन, फोरकास्टिंग, चेंज पॉइंट डिटेक्शन, AutoML, एन्सेम्बल और बेंचमार्किंग पाइपलाइन प्रदान करता है।


Merlion टाइम सीरीज़ इंटेलिजेंस के लिए एक Python लाइब्रेरी है। यह एक एंड-टू-एंड मशीन लर्निंग फ्रेमवर्क प्रदान करती है जिसमें डेटा लोड करना और रूपांतरित करना, मॉडल बनाना और प्रशिक्षित करना, मॉडल आउटपुट का पोस्ट-प्रोसेसिंग और मॉडल प्रदर्शन का मूल्यांकन शामिल है। यह विभिन्न टाइम सीरीज़ लर्निंग कार्यों का समर्थन करती है, जिनमें यूनिवेरिएट और मल्टीवेरिएट टाइम सीरीज़ दोनों के लिए पूर्वानुमान, विसंगति का पता लगाना और चेंज पॉइंट का पता लगाना शामिल है। इस लाइब्रेरी का उद्देश्य इंजीनियरों और शोधकर्ताओं को उनकी विशिष्ट टाइम सीरीज़ आवश्यकताओं के लिए तेज़ी से मॉडल विकसित करने और कई टाइम सीरीज़ डेटासेट पर उनका बेंचमार्क करने हेतु एक वन-स्टॉप समाधान प्रदान करना है।
Merlion की प्रमुख विशेषताएं निम्नलिखित हैं:
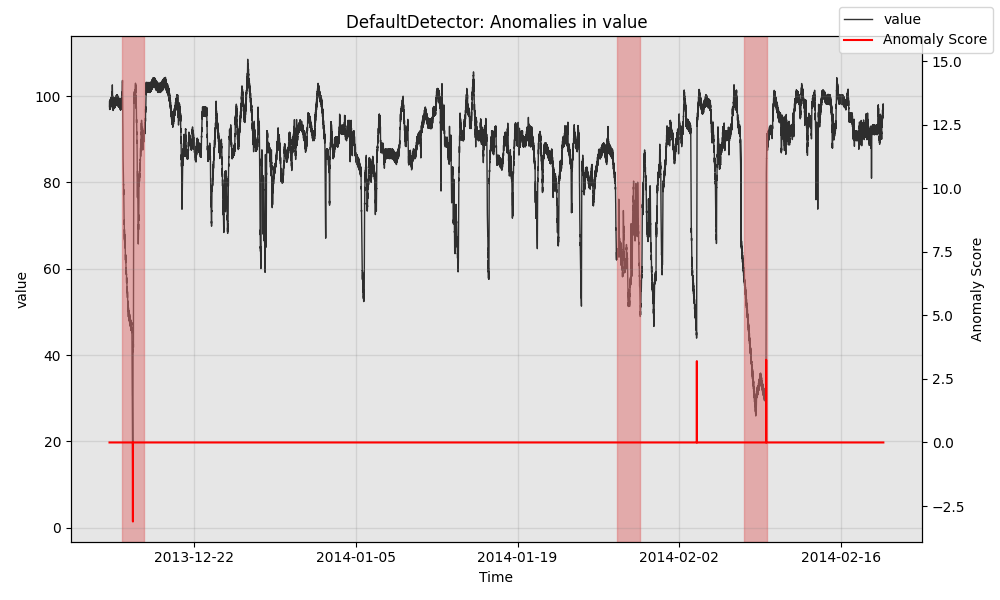
DefaultDetector और DefaultForecaster मॉडल, जो कुशल हैं, मज़बूती से अच्छा प्रदर्शन प्राप्त करते हैं, और नए उपयोगकर्ताओं के लिए एक प्रारंभिक बिंदु प्रदान करते हैं।नीचे दी गई तालिका एक दृश्य अवलोकन प्रदान करती है कि Merlion की प्रमुख विशेषताएं टाइम सीरीज़ विसंगति का पता लगाने और/या पूर्वानुमान के लिए अन्य लाइब्रेरीज़ से किस प्रकार तुलना करती हैं।
| Merlion | Prophet | Alibi Detect | Kats | darts | statsmodels | nixtla | GluonTS | RRCF | STUMPY | Greykite | pmdarima | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| यूनिवेरिएट पूर्वानुमान | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | |||
| मल्टीवेरिएट पूर्वानुमान | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| यूनिवेरिएट विसंगति का पता लगाना | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | |||
| मल्टीवेरिएट विसंगति का पता लगाना | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| प्री-प्रोसेसिंग | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||
| पोस्ट-प्रोसेसिंग | ✅ | ✅ | ||||||||||
| AutoML | ✅ | ✅ | ✅ | |||||||||
| एन्सेम्बल | ✅ | ✅ | ✅ | ✅ | ||||||||
| बेंचमार्किंग | ✅ | ✅ | ✅ | ✅ | ✅ | |||||||
| विज़ुअलाइज़ेशन | ✅ | ✅ | ✅ | ✅ | ✅ |
निम्नलिखित विशेषताएं Merlion 2.0 में नई हैं:
| Merlion | Prophet | Alibi Detect | Kats | darts | statsmodels | nixtla | GluonTS | RRCF | STUMPY | Greykite | pmdarima | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| एक्सोजेनस रिग्रेसर्स | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| चेंज पॉइंट का पता लगाना | ✅ | ✅ | ✅ | ✅ | ✅ | |||||||
| क्लिक करने योग्य विज़ुअल UI | ✅ | |||||||||||
| वितरित बैकएंड | ✅ | ✅ |
Merlion दो उप-रिपॉजिटरीज़ से मिलकर बना है: merlion लाइब्रेरी की मुख्य टाइम सीरीज़ इंटेलिजेंस सुविधाओं को लागू करता है, और ts_datasets कई टाइम सीरीज़ डेटासेट के लिए मानकीकृत डेटा लोडर प्रदान करता है। ये लोडर टाइम सीरीज़ को संबंधित मेटाडेटा के साथ pandas.DataFrame के रूप में लोड करते हैं।
आप pip install salesforce-merlion कॉल करके PyPI से merlion स्थापित कर सकते हैं। आप इस रिपॉजिटरी को क्लोन करके और pip install Merlion/ कॉल करके स्रोत से स्थापित कर सकते हैं, या एडिटेबल मोड में स्थापित करने के लिए pip install -e Merlion/ कॉल कर सकते हैं। आप pip install salesforce-merlion[all] के माध्यम से अतिरिक्त निर्भरताएँ स्थापित कर सकते हैं, या यदि स्रोत से स्थापित कर रहे हैं तो pip install "Merlion/[all]" कॉल करके। व्यक्तिगत रूप से, वैकल्पिक निर्भरताओं में GUI डैशबोर्ड के लिए dashboard, PySpark के साथ वितरित कम्प्यूटेशन बैकएंड के लिए spark, और सभी डीप लर्निंग मॉडलों के लिए deep-learning शामिल हैं।
डेटा लोडिंग पैकेज ts_datasets स्थापित करने के लिए, इस रिपॉजिटरी को क्लोन करें और pip install -e Merlion/ts_datasets/ कॉल करें। यदि आप अपने डेटा लोडर को प्रारंभ करते समय प्रत्येक डेटासेट की रूट निर्देशिका को मैन्युअल रूप से निर्दिष्ट नहीं करना चाहते हैं, तो यह पैकेज एडिटेबल मोड (यानी -e फ्लैग के साथ) में स्थापित होना चाहिए।
निम्नलिखित बाहरी निर्भरताओं पर ध्यान दें:
हमारे कुछ पूर्वानुमान मॉडल OpenMP पर निर्भर करते हैं। यदि आप conda का उपयोग कर रहे हैं, तो कृपया हमारा पैकेज स्थापित करने से पहले conda install -c conda-forge lightgbm चलाएँ। यह सुनिश्चित करेगा कि OpenMP आपके conda वातावरण में lightgbm पैकेज (हमारी एक निर्भरता) के साथ काम करने के लिए कॉन्फ़िगर किया गया है। यदि Mac का उपयोग कर रहे हैं, तो कृपया Homebrew स्थापित करें और brew install libomp चलाएँ ताकि OpenMP लाइब्रेरी मॉडल के लिए उपलब्ध हो।
हमारे कुछ विसंगति का पता लगाने वाले मॉडल Java Development Kit (JDK) पर निर्भर करते हैं। Ubuntu के लिए, sudo apt-get install openjdk-11-jdk चलाएँ। Mac OS के लिए, Homebrew स्थापित करें और brew tap adoptopenjdk/openjdk && brew install --cask adoptopenjdk11 चलाएँ। यह भी सुनिश्चित करें कि java आपके PATH पर मौजूद है, और JAVA_HOME पर्यावरण चर सेट है।
