 redhuntlabs/octopii
एक AI-संचालित व्यक्तिगत पहचान योग्य जानकारी (PII) स्कैनर।

⠀⠀⠀⠀⠀⠀⠀⣤⣤⣄⣀⡀⠀⠀⠀⢀⣠⣤⣤⣄⡀⠀⠀⠀⢀⣀⣠⣤⣤⠀⠀⠀⠀⠀⠀⠀⠀⠀
⠀⠀⠀⠀⠀⠀⠸⣿⣿⡿⠿⢿⣷⡄⢠⣿⣿⣿⣿⣿⣿⡄⢀⣾⡿⠿⢿⣿⣿⠇⠀⠀⠀⠀⠀⠀⠀⠀
⠀⠀⠀⠀⠀⠀⠀⠈⠉⠀⠀⢸⣿⡇⢸⣿⣿⣿⣿⣿⣿⡇⢸⣿⡇⠀⠀⠉⠁⠀⠀⠀⠀⠀⠀⠀⠀⠀
⠀⣠⣤⡀⠀⠀⠀⠀⠀⠀⠀⢸⣿⡇⢸⣿⣿⣿⣿⣿⣿⡇⢸⣿⡇⠀⠀⠀⠀⠀⠀⠀⢀⣤⣄⠀⠀⠀
⠸⣿⣿⣿⣿⣿⣿⣿⣿⣦⠀⢸⣿⡇⢸⣿⣿⣿⣿⣿⣿⡇⢸⣿⡇⠀⣴⣿⣿⣿⣿⣿⣿⣿⣿⠇⠀⠀
⠀⠉⠉⠁⠀⠀⠀⠀⣿⣿⠀⢸⣿⡇⠀⠉⣿⣿⣿⣿⠉⠀⢸⣿⡇⠀⣿⣿⠀⠀⠀⠀⠈⠉⠉⠀⠀
⠀⠀⠀⠀⠀⠀⠀⠀⣿⣿⣀⣈⣻⣿⣿⣿⣿⣿⣿⣿⣿⣿⣿⣟⣁⣀⣿⣿⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀
⠀⠀⠀⠀⠀⠀⠀⠀⠘⠿⠿⠿⠿⠿⣿⣿⣿⣿⣿⣿⣿⣿⠿⠿⠿⠿⠿⠃⠀⠀⠀⠀⠀⠀⠀
⠀⠀⠀⠀⠀⠀⢀⣤⣤⣤⣤⣤⣤⣴⣿⣿⣿⡇⢸⣿⡿⣿⣦⣤⣤⣤⣤⣤⣤⡀⠀⠀⠀⠀⠀⠀⠀⠀
⠀⠀⠀⠀⠀⠀⢸⣿⠋⠉⠉⠉⠉⠉⠉⢸⣿⡇⢸⣿⡇⠈⠉⠉⠉⠉⠉⠙⣿⣧⠀⠀⠀⠀⠀⠀⠀⠀
⠀⠀⠀⠀⠀⢰⣿⣿⣦⠀⢰⣿⣿⣦⠀⢸⣿⡇⢸⣿⡇⠀⣰⣿⣿⡆⠀⣴⣿⣿⡆⠀⠀⠀⠀⠀⠀⠀
⠀⠀⠀⠀⠀⠈⠻⠿⠋⠀⠘⣿⣿⠃⠀⢸⣿⡇⢸⣿⡇⠀⠘⣿⣿⠃⠀⠙⠿⠟⠁⠀⠀⠀⠀⠀⠀⠀
⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⢻⣿⣦⣤⣼⣿⠃⠘⣿⣧⣄⣤⣿⡟⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀
⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠀⠉⠛⠛⠛⠁⠀⠀⠈⠛⠛⠛⠋⠀⠀⠀

⠀⠀⠀⠀⠀⠀      ⠀O C T O P I I⠀⠀⠀⠀
Copyright © 2023 RedHunt Labs Private Limited
Octopii एक व्यक्तिगत पहचान योग्य जानकारी (PII) स्कैनर है जो ऑप्टिकल कैरेक्टर रिकॉग्निशन (OCR), रेगुलर एक्सप्रेशन सूचियों और प्राकृतिक भाषा प्रसंस्करण (NLP) का उपयोग करके छवियों, PDF और दस्तावेज़ों में सरकारी आईडी, पते, ईमेल आदि के लिए सार्वजनिक स्थानों की खोज करता है।
साइबरसुरक्षा क्षेत्र में PII लीक को अक्सर नजरअंदाज किया जाता है। RedHunt Labs में, हम हमेशा संगठनों और सेवाओं को आवश्यक साइबरसुरक्षा समाधान लाने के लिए अलग और नवीन तरीकों की तलाश करते हैं। हमने एक पर्याप्त संख्या में संगठनों का सामना किया है जिनके सर्वर गलत तरीके से कॉन्फ़िगर किए गए हैं। इससे कर्मचारी और ग्राहक PII हर समय लीक होता है, जिससे दुर्भावनापूर्ण पक्षों को उनकी उत्पत्ति, आईडी नंबर, संपर्क जानकारी और उनके स्थान के बारे में संवेदनशील जानकारी मिलती है।
यही कारण है कि हमने Octopii बनाया, एक उपकरण जो यह प्रदर्शित और पता लगाने के लिए है कि इंटरनेट पर लीक हुए PII और संवेदनशील दस्तावेज़ों की खोज और निष्कर्षण को स्वचालित करना कितना आसान है।
pip install -r requirements.txt के माध्यम से स्थापित करें।sudo apt install tesseract-ocr -y या Arch Linux पर sudo pacman -Syu tesseract के माध्यम से Tesseract हेल्पर को स्थानीय रूप से स्थापित करें।python -m spacy download en_core_web_sm के माध्यम से स्थानीय रूप से स्थापित करें।
उपरोक्त स्थापित करने के बाद, आप तैयार हैं।Octopii चलाने के लिए, टाइप करें
python3 octopii.py <location to scan>
जहाँ <location to scan> एक फ़ाइल या निर्देशिका है।
Octopii वर्तमान में फ़ाइलसिस्टम पथ, S3 URL और Apache ओपन डायरेक्टरी लिस्टिंग के माध्यम से स्थानीय स्कैनिंग का समर्थन करता है। आप व्यक्तिगत छवि URL या फ़ाइलों को एक तर्क के रूप में भी प्रदान कर सकते हैं।
हमने एक dummy-pii/ फ़ोल्डर प्रदान किया है जिसमें Octopii के परीक्षण के लिए नमूना PII है। इसे एक तर्क के रूप में पास करें और आपको निम्न आउटपुट मिलेगा
owais@artemis ~ $ python3 octopii.py dummy-pii/

Searching for PII in dummy-pii/dummy-drivers-license-nebraska-us.jpg
{
    "file_path": "dummy-pii/dummy-drivers-license-nebraska-us.jpg",
    "pii_class": "Nebraska Driver's License",
    "country_of_origin": "United States",
    "faces": 1,
    "identifiers": [],
    "emails": [],
    "phone_numbers": [
        "4000002170"
    ],
    "addresses": [
        "Nebraska"
    ]
}

Searching for PII in dummy-pii/dummy-PAN-India.jpg
{
    "file_path": "dummy-pii/dummy-PAN-India.jpg",
    "pii_class": "Permanent Account Number",
    "country_of_origin": "India",
    "faces": 0,
    "identifiers": [],
    "emails": [],
    "phone_numbers": [],
    "addresses": [
        "INDIA"
    ]
}

...
उपकरण से आउटपुट युक्त output.txt नामक एक फ़ाइल बनाई जाती है। इस फ़ाइल में वास्तविक समय में क्रमिक रूप से जोड़ा जाता है।
Octopii व्यक्तिगत पहचान योग्य जानकारी के स्ट्रिंग्स का पता लगाने के लिए ऑप्टिकल कैरेक्टर रिकॉग्निशन (OCR) के लिए Tesseract और प्राकृतिक भाषा प्रसंस्करण (NLP) के लिए NLTK का उपयोग करता है। यह निम्नलिखित चरणों के माध्यम से किया जाता है:
Octopii छवियों (jpg और png) और दस्तावेज़ों (pdf, doc, txt आदि) की खोज करता है। यह 3 स्रोतों का समर्थन करता है:
छवियों का पता Python Imaging Library (PIL) के माध्यम से लगाया जाता है और OpenCV के साथ खोला जाता है। PDF को छवियों की सूची में परिवर्तित किया जाता है और OCR के माध्यम से स्कैन किया जाता है। टेक्स्ट-आधारित फ़ाइल प्रकारों को स्ट्रिंग में पढ़ा जाता है और OCR के बिना स्कैन किया जाता है।
छवियों में चेहरे का पता लगाने के लिए एक द्विआधारी वर्गीकरण छवि पहचान तकनीक - जिसे 'हार कैस्केड' के रूप में जाना जाता है - का उपयोग किया जाता है। इस रिपॉजिटरी में एक पूर्व-प्रशिक्षित कैस्केड मॉडल प्रदान किया गया है, जिसमें OpenCV द्वारा उपयोग के लिए कैस्केड डेटा है। एक ही PII छवि में कई चेहरों का पता लगाया जा सकता है, और पता लगाए गए चेहरों की संख्या लौटाई जाती है।
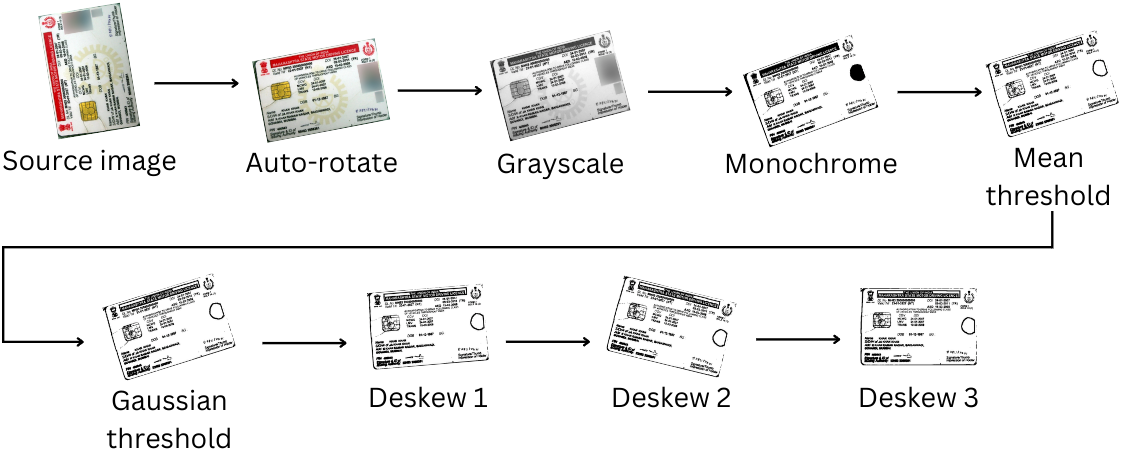
फिर पाठ निष्कर्षण के लिए छवियों को निम्नलिखित छवि परिवर्तन चरणों के साथ 'साफ' किया जाता है:
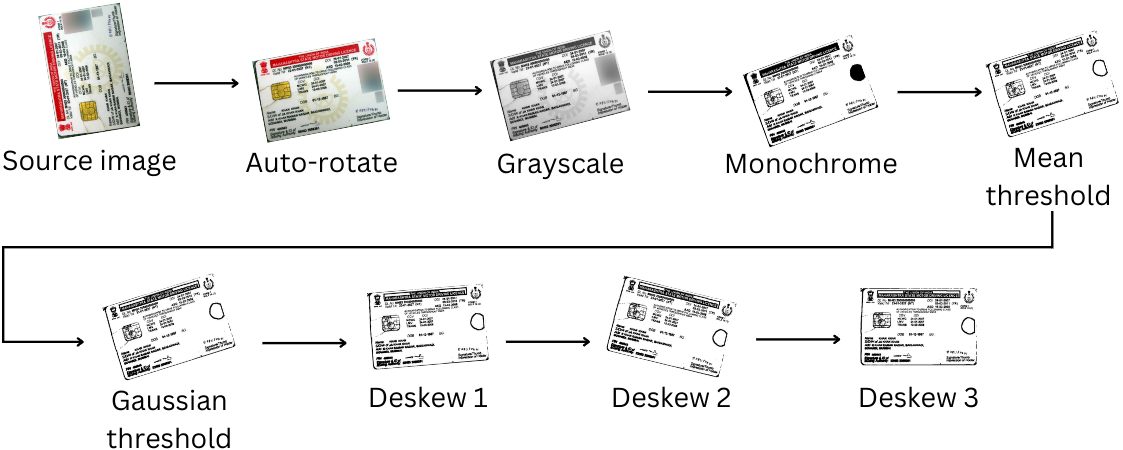
चूँकि ये चरण छवि डेटा (फोटोग्राफ में रंग सहित) को हटा देते हैं, यह छवि सफाई प्रक्रिया चेहरे की पहचान का प्रयास करने के बाद होती है।
Tesseract का उपयोग किसी छवि/फ़ाइल से सभी टेक्स्ट स्ट्रिंग्स प्राप्त करने के लिए किया जाता है। फिर इसे न्यूलाइन वर्णों ('\n') और रिक्त स्थान (' ') द्वारा विभाजित करके स्ट्रिंग्स की सूची में टोकनाइज़ किया जाता है। गार्बल्ड टेक्स्ट, जैसे null स्ट्रिंग्स और एकल वर्ण, इस सूची से हटा दिए जाते हैं, जिसके परिणामस्वरूप संभावित शब्दों की एक 'सुगम' सूची प्राप्त होती है।
शब्दों की इस सूची को फिर एक समानता जाँच फ़ंक्शन में डाला जाता है। यह फ़ंक्शन PII दस्तावेज़ से निकाले गए प्रत्येक शब्द की तुलना definitions.json में मौजूद कीवर्ड की सूची से करने के लिए Gestalt पैटर्न मैचिंग का उपयोग करता है। यह जाँच प्रति सफाई एक बार होती है। कीवर्ड सूची से एक शब्द कितनी बार आता है, इसे गिना जाता है और इसका उपयोग विश्वास स्कोर प्राप्त करने के लिए किया जाता है। जब किसी विशेष परिभाषा के कीवर्ड इन स्कैन में बार-बार दिखाई देते हैं, तो उस परिभाषा को उच्चतम स्कोर मिलता है और उसे भविष्यवाणी की गई PII वर्ग के रूप में चुना जाता है।
Octopii रेगुलर एक्सप्रेशन का उपयोग करके संवेदनशील PII उपस्ट्रिंग जैसे ईमेल, फ़ोन नंबर और सामान्य सरकारी आईडी अद्वितीय पहचानकर्ताओं की भी जाँच करता है। यह प्राकृतिक भाषा प्रसंस्करण का उपयोग करके पतों और देशों जैसे जियोलोकेशन डेटा भी निकाल सकता है।
आउटपुट में निम्नलिखित शामिल हैं:
file_path: वह स्थान जहाँ PII युक्त फ़ाइल पाई जा सकती हैpii_class: इस फ़ाइल में मौजूद PII का प्रकारcountry_of_origin: यह PII कहाँ से उत्पन्न होता है।identifiers: अद्वितीय पहचानकर्ता, कोड या संख्याएँ जिनका उपयोग PII में उल्लिखित व्यक्ति को लक्षित करने के लिए किया जा सकता है।emails और phone_numbers: फ़ाइल में संपर्क जानकारी।addresses: PII में किसी भी प्रकार का जियोलोकेशन डेटा। इसका उपयोग किसी व्यक्ति के स्थान को त्रिभुजित करने के लिए किया जा सकता है।Octopii में योगदान कैसे करें, यह पढ़ने के लिए यहाँ क्लिक करें।
...और असंख्य अन्य
यह उपकरण केवल अनुसंधान और शैक्षिक उद्देश्यों के लिए है। RedHunt Labs और इस परियोजना के अन्य योगदानकर्ता इस उपकरण के दुर्भावनापूर्ण उपयोग की कोई जिम्मेदारी नहीं लेते हैं।
कॉपीराइट © 2023 RedHunt Labs Private Limited.
