 microsoft/responsible-ai-toolbox
जिम्मेदार AI मॉडल डिबगिंग के लिए इंटरैक्टिव डैशबोर्ड और लाइब्रेरी, जो त्रुटि विश्लेषण, निष्पक्षता, व्याख्यात्मकता, काउंटरफैक्चुअल, कारण विश्लेषण और डेटा संतुलन को कवर करते हैं।


जिम्मेदार AI (Responsible AI), AI प्रणालियों का सुरक्षित, भरोसेमंद और नैतिक तरीके से मूल्यांकन, विकास और परिनियोजन करने तथा जिम्मेदार निर्णय और कार्रवाई करने का एक दृष्टिकोण है।
Responsible AI Toolbox टूलों का एक सूट है जो मॉडल और डेटा अन्वेषण तथा मूल्यांकन के लिए यूज़र इंटरफ़ेस और लाइब्रेरीज़ का एक संग्रह प्रदान करता है, जिससे AI प्रणालियों की बेहतर समझ संभव होती है। ये इंटरफ़ेस और लाइब्रेरीज़ AI प्रणालियों के डेवलपर्स और हितधारकों को अधिक जिम्मेदारी से AI विकसित करने और निगरानी करने तथा बेहतर डेटा-संचालित कार्रवाई करने में सशक्त बनाते हैं।
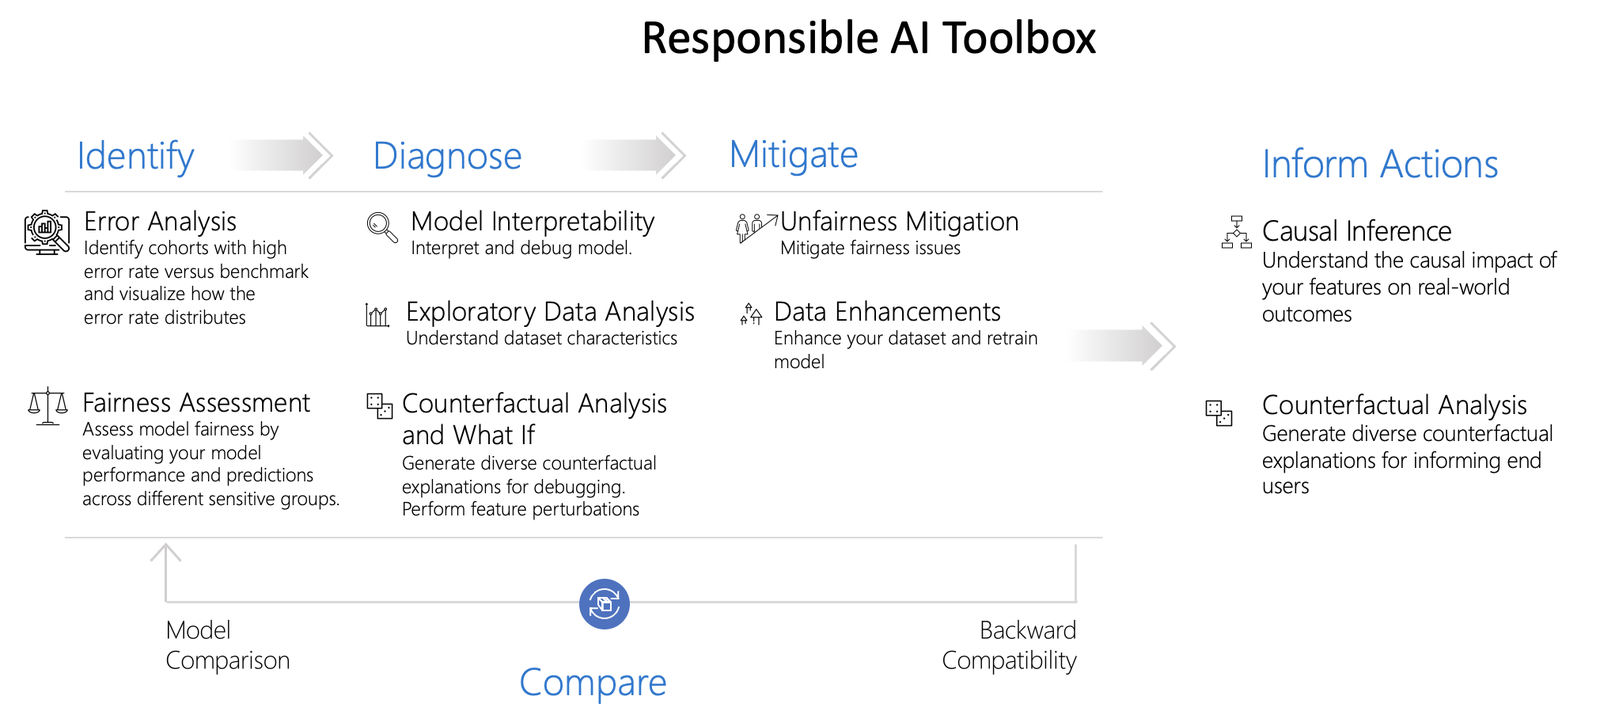
टूलबॉक्स में तीन रिपॉजिटरी शामिल हैं:
| रिपॉजिटरी | कवर किए गए टूल |
|---|---|
| Responsible-AI-Toolbox रिपॉजिटरी (यहाँ) | इस रिपॉजिटरी में मॉडल मूल्यांकन और निर्णय लेने के लिए चार विज़ुअलाइज़ेशन विजेट शामिल हैं: 1. Responsible AI डैशबोर्ड, एक सिंगल पेन ऑफ ग्लास जो टूलबॉक्स के कई परिपक्व Responsible AI टूल्स को एक साथ लाकर मॉडलों का समग्र जिम्मेदार मूल्यांकन और डिबगिंग तथा सूचित व्यावसायिक निर्णय लेने में सक्षम बनाता है। इस डैशबोर्ड से आप मॉडल त्रुटियों की पहचान कर सकते हैं, निदान कर सकते हैं कि ये त्रुटियाँ क्यों हो रही हैं, और उन्हें कम कर सकते हैं। इसके अलावा, कारणात्मक निर्णय-निर्माण क्षमताएँ आपके हितधारकों और ग्राहकों को कार्रवाई योग्य अंतर्दृष्टि प्रदान करती हैं। 2. Error Analysis डैशबोर्ड, मॉडल त्रुटियों की पहचान करने और डेटा के उन कोहॉर्ट्स की खोज करने के लिए जिनके लिए मॉडल कम प्रदर्शन करता है। 3. Interpretability डैशबोर्ड, मॉडल भविष्यवाणियों को समझने के लिए। यह डैशबोर्ड InterpretML द्वारा संचालित है। 4. Fairness डैशबोर्ड, संवेदनशील फीचर्स और कोहॉर्ट्स में विभिन्न ग्रुप-फेयरनेस मेट्रिक्स का उपयोग करके मॉडल की निष्पक्षता संबंधी समस्याओं को समझने के लिए। यह डैशबोर्ड Fairlearn द्वारा संचालित है। |
| Responsible-AI-Toolbox-Mitigations रिपॉजिटरी | Responsible AI Mitigations लाइब्रेरी AI प्रैक्टिशनर्स को विभिन्न मापों और शमन (mitigation) चरणों का पता लगाने में मदद करती है, जो किसी दिए गए डेटा कोहॉर्ट के लिए मॉडल के कम प्रदर्शन करने पर सबसे उपयुक्त हो सकते हैं। लाइब्रेरी में वर्तमान में दो मॉड्यूल हैं: 1. DataProcessing, जो विशिष्ट कोहॉर्ट्स के लिए मॉडल प्रदर्शन बेहतर बनाने हेतु शमन तकनीकें प्रदान करता है। 2. DataBalanceAnalysis, जो क्लास लेबल या फीचर मानों पर डेटा असंतुलन से उत्पन्न त्रुटियों के निदान के लिए मेट्रिक्स प्रदान करता है। 3. Cohort: कोहॉर्ट्स को संभालने और प्रबंधित करने के लिए क्लासेस प्रदान करता है, जो प्रत्येक कोहॉर्ट के लिए आसान और सहज इंटरफ़ेस में कस्टम पाइपलाइन बनाने की अनुमति देता है। यह मॉड्यूल विभिन्न कोहॉर्ट्स के लिए अलग-अलग डिकपल्ड एस्टिमेटर (मॉडल) सीखने और उन्हें इस तरह संयोजित करने की तकनीकें भी प्रदान करता है जो ग्रुप फेयरनेस की विभिन्न परिभाषाओं को अनुकूलित करती हैं। |
| Responsible-AI-Tracker रिपॉजिटरी | Responsible AI Toolbox Tracker, मॉडल सुधार के लिए मशीन लर्निंग प्रयोगों के परिणामों को प्रबंधित करने, ट्रैक करने और तुलना करने हेतु एक JupyterLab एक्सटेंशन है। इस एक्सटेंशन का उपयोग करके, उपयोगकर्ता एक ही फ्रेमवर्क के भीतर मॉडल, कोड और विज़ुअलाइज़ेशन आर्टिफैक्ट देख सकते हैं, जिससे तेज़ मॉडल पुनरावृत्ति और मूल्यांकन प्रक्रियाएँ संभव होती हैं। मुख्य कार्यक्षमताओं में शामिल हैं: 1. मॉडल सुधार आर्टिफैक्ट्स का प्रबंधन और लिंकिंग 2. विघटित (disaggregated) मॉडल मूल्यांकन और तुलनाएँ 3. Responsible AI Mitigations लाइब्रेरी के साथ एकीकरण 4. mlflow के साथ एकीकरण |
| Responsible-AI-Toolbox-GenBit रिपॉजिटरी | Responsible AI Gender Bias (GenBit) लाइब्रेरी AI प्रैक्टिशनर्स को नेचुरल लैंग्वेज प्रोसेसिंग (NLP) डेटासेट में लैंगिक पूर्वाग्रह (gender bias) मापने में मदद करती है। GenBit का मुख्य लक्ष्य आपके टेक्स्ट कॉर्पोरा का विश्लेषण करना और ऐसे मेट्रिक्स की गणना करना है जो कॉर्पस में मौजूद लैंगिक पूर्वाग्रह के बारे में अंतर्दृष्टि प्रदान करते हैं। |
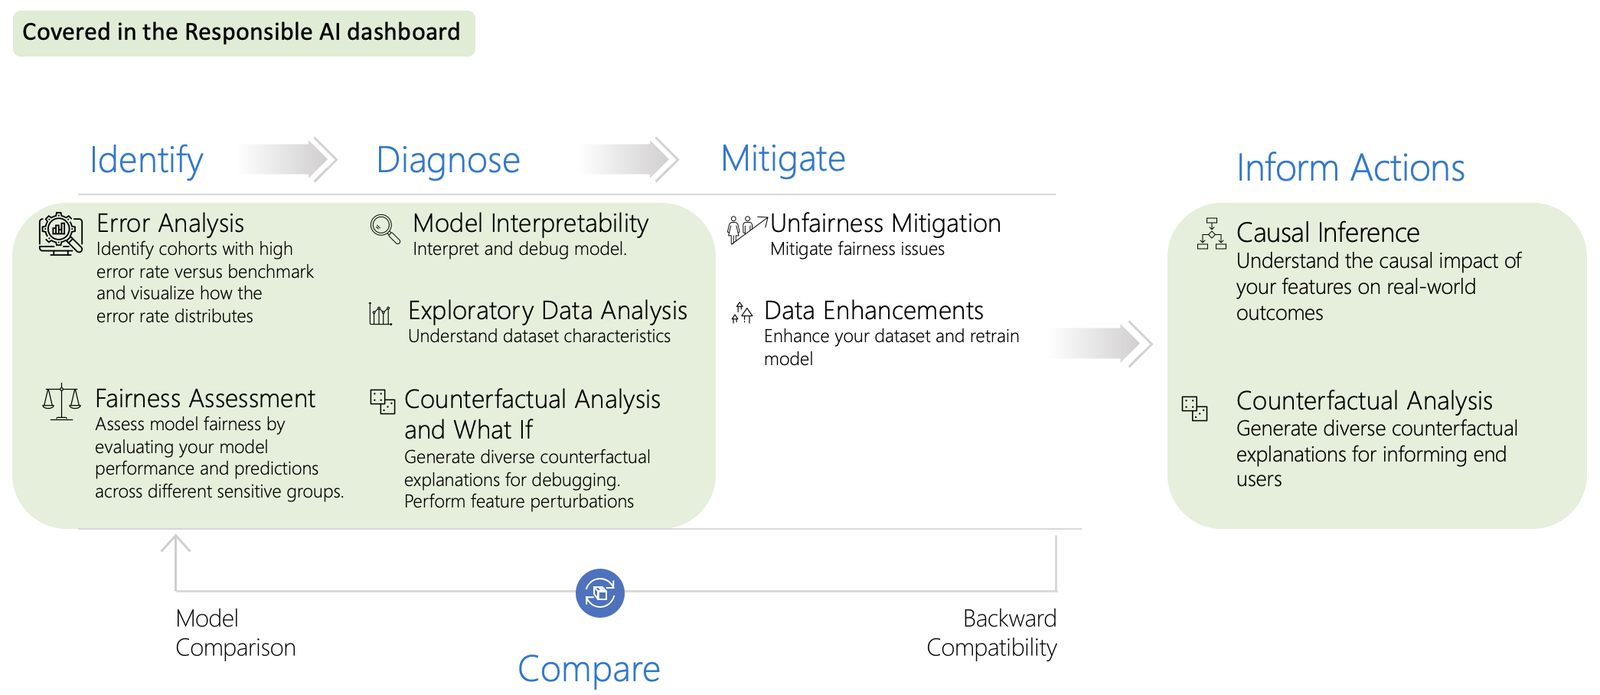
Responsible AI डैशबोर्ड एक सिंगल पेन ऑफ ग्लास है, जो आपको मॉडल डिबगिंग और निर्णय लेने के विभिन्न चरणों से आसानी से गुजरने में सक्षम बनाता है। यह अनुकूलन योग्य अनुभव कई दिशाओं में ले जाया जा सकता है – मॉडल या डेटा का समग्र विश्लेषण करने से लेकर, रुचि के कोहॉर्ट्स पर गहन अध्ययन या तुलना करने, व्यक्तिगत उदाहरणों के लिए मॉडल भविष्यवाणियों की व्याख्या और परिवर्तन करने, तथा उपयोगकर्ताओं को व्यावसायिक निर्णयों और कार्यों के बारे में सूचित करने तक।
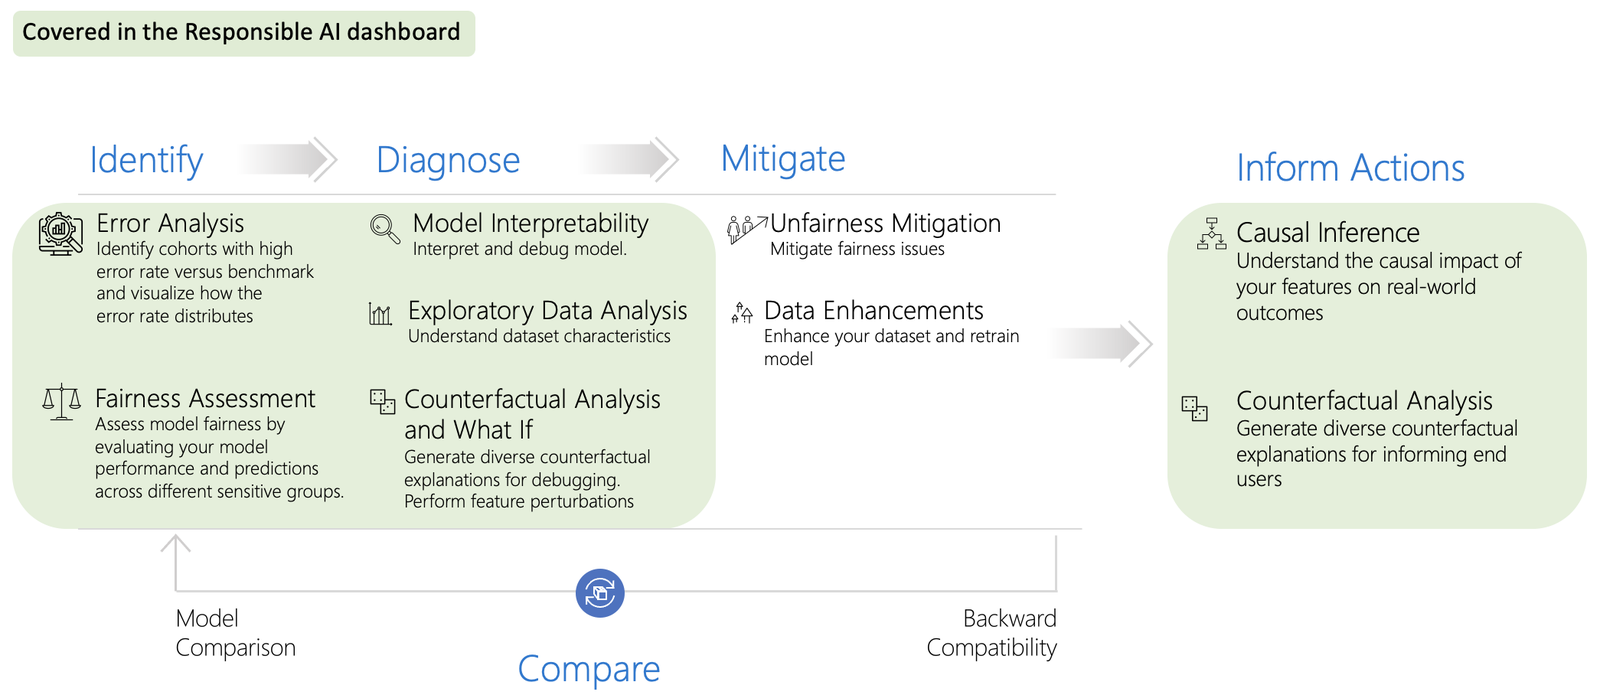
इन क्षमताओं को प्राप्त करने के लिए, डैशबोर्ड निम्नलिखित क्षेत्रों में कई ओपन-सोर्स टूलकिट्स के विचारों और तकनीकों को एकीकृत करता है:
Error Analysis Error Analysis द्वारा संचालित, जो समग्र बेंचमार्क की तुलना में उच्च त्रुटि दर वाले डेटा कोहॉर्ट्स की पहचान करता है। ये विसंगतियाँ तब हो सकती हैं जब सिस्टम या मॉडल विशिष्ट जनसांख्यिकीय समूहों या प्रशिक्षण डेटा में कम देखी जाने वाली इनपुट स्थितियों के लिए कम प्रदर्शन करता है।
Fairness Assessment Fairlearn द्वारा संचालित, जो पहचान करता है कि AI प्रणाली से किन लोगों के समूहों पर अनुपातहीन रूप से नकारात्मक प्रभाव पड़ सकता है और किन तरीकों से।
Model Interpretability InterpretML द्वारा संचालित, जो ब्लैकबॉक्स मॉडलों की व्याख्या करता है, जिससे उपयोगकर्ता अपने मॉडल के वैश्विक व्यवहार या व्यक्तिगत भविष्यवाणियों के पीछे के कारणों को समझ पाते हैं।
Counterfactual Analysis DiCE द्वारा संचालित, जो उसी डेटापॉइंट के फीचर-परिवर्तित (feature-perturbed) संस्करण दिखाता है जिन्हें अलग भविष्यवाणी परिणाम मिला होता, उदा., टेलर के ऋण को मॉडल ने अस्वीकार कर दिया है। लेकिन यदि उनकी आय $10,000 अधिक होती तो उन्हें ऋण मिल जाता।