 jaidedai/easyocr
तैयार-उपयोग OCR जिसमें 80+ समर्थित भाषाएँ और लैटिन, चीनी, अरबी, देवनागरी, सिरिलिक आदि सहित सभी लोकप्रिय लेखन लिपियाँ शामिल हैं।


80+ समर्थित भाषाओं और सभी लोकप्रिय लेखन लिपियों सहित उपयोग के लिए तैयार OCR, जिनमें शामिल हैं: लैटिन, चीनी, अरबी, देवनागरी, सिरिलिक, आदि।
Gradio का उपयोग करके Huggingface Spaces 🤗 में एकीकृत। वेब डेमो आज़माएँ:
24 सितंबर 2024 - संस्करण 1.7.2
pip का उपयोग करके इंस्टॉल करें
नवीनतम स्थिर रिलीज़ के लिए:
pip install easyocr
नवीनतम विकास रिलीज़ के लिए:
pip install git+https://github.com/JaidedAI/EasyOCR.git
नोट 1: Windows के लिए, कृपया पहले आधिकारिक निर्देशों का पालन करते हुए torch और torchvision इंस्टॉल करें, जो यहाँ उपलब्ध हैं https://pytorch.org। pytorch वेबसाइट पर, सुनिश्चित करें कि आप अपना सही CUDA संस्करण चुनें। यदि आप केवल CPU मोड पर चलाना चाहते हैं, तो CUDA = None चुनें।
नोट 2: हम एक Dockerfile भी यहाँ प्रदान करते हैं।
नोट 3: वैकल्पिक DBNet डिटेक्टर (detect_network='dbnet18') पहली बार उपयोग पर अपने C++/CUDA ऑप्स को कंपाइल करता है, जिसके लिए Ninja बिल्ड टूल की आवश्यकता होती है। इसे EasyOCR के साथ इंस्टॉल करने के लिए, pip install "easyocr[dbnet]" का उपयोग करें।
import easyocr
reader = easyocr.Reader(['ch_sim','en']) # this needs to run only once to load the model into memory
result = reader.readtext('chinese.jpg')
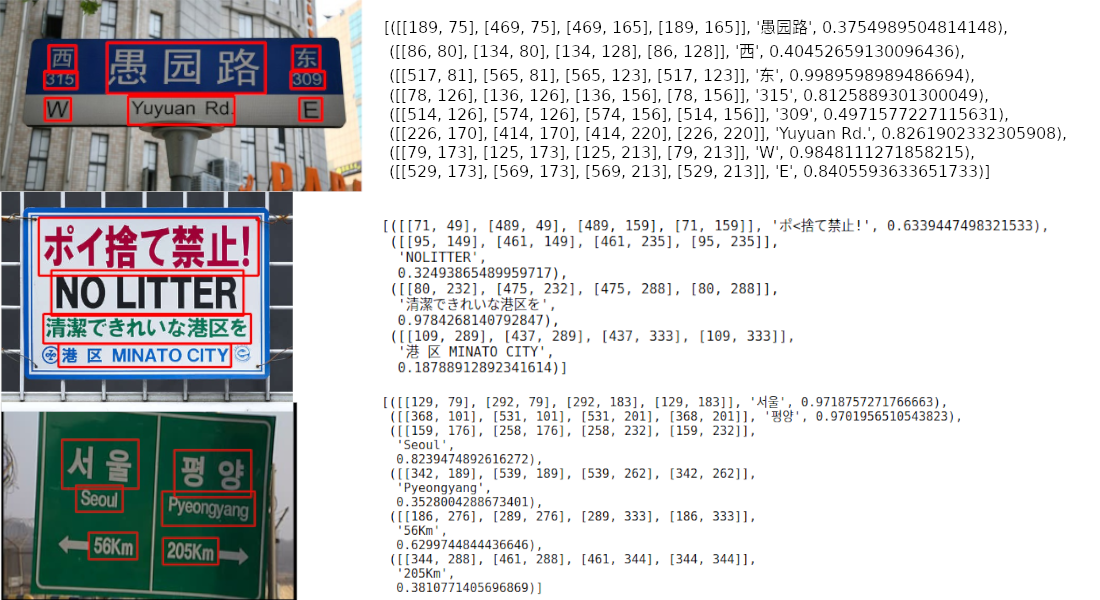
आउटपुट एक सूची प्रारूप में होगा, प्रत्येक आइटम क्रमशः एक बाउंडिंग बॉक्स, पहचाना गया टेक्स्ट और विश्वास स्तर को दर्शाता है।
[([[189, 75], [469, 75], [469, 165], [189, 165]], '愚园路', 0.3754989504814148),
 ([[86, 80], [134, 80], [134, 128], [86, 128]], '西', 0.40452659130096436),
 ([[517, 81], [565, 81], [565, 123], [517, 123]], '东', 0.9989598989486694),
 ([[78, 126], [136, 126], [136, 156], [78, 156]], '315', 0.8125889301300049),
 ([[514, 126], [574, 126], [574, 156], [514, 156]], '309', 0.4971577227115631),
 ([[226, 170], [414, 170], [414, 220], [226, 220]], 'Yuyuan Rd.', 0.8261902332305908),
 ([[79, 173], [125, 173], [125, 213], [79, 213]], 'W', 0.9848111271858215),
 ([[529, 173], [569, 173], [569, 213], [529, 213]], 'E', 0.8405593633651733)]
नोट 1: ['ch_sim','en'] उन भाषाओं की सूची है जिन्हें आप पढ़ना चाहते हैं। आप एक साथ कई भाषाएँ पास कर सकते हैं लेकिन सभी भाषाएँ एक साथ उपयोग नहीं की जा सकतीं। अंग्रेज़ी हर भाषा के साथ संगत है और जो भाषाएँ सामान्य अक्षर साझा करती हैं वे आमतौर पर एक-दूसरे के साथ संगत होती हैं।
नोट 2: फ़ाइलपथ chinese.jpg के बजाय, आप एक OpenCV इमेज ऑब्जेक्ट (numpy array) या बाइट्स के रूप में एक इमेज फ़ाइल भी पास कर सकते हैं। किसी रॉ इमेज का URL भी स्वीकार्य है।
नोट 3: पंक्ति reader = easyocr.Reader(['ch_sim','en']) एक मॉडल को मेमोरी में लोड करने के लिए है। इसमें कुछ समय लगता है लेकिन इसे केवल एक बार चलाने की आवश्यकता होती है।
आप सरल आउटपुट के लिए detail=0 भी सेट कर सकते हैं।
reader.readtext('chinese.jpg', detail = 0)
परिणाम:
['愚园路', '西', '东', '315', '309', 'Yuyuan Rd.', 'W', 'E']
चुनी गई भाषा के लिए मॉडल वेट्स स्वचालित रूप से डाउनलोड हो जाएंगे या आप उन्हें मैन्युअल रूप से मॉडल हब से डाउनलोड करके '~/.EasyOCR/model' फ़ोल्डर में रख सकते हैं
यदि आपके पास GPU नहीं है, या आपके GPU में कम मेमोरी है, तो आप gpu=False जोड़कर मॉडल को केवल-CPU मोड में चला सकते हैं।
reader = easyocr.Reader(['ch_sim','en'], gpu=False)
अधिक जानकारी के लिए, tutorial और API Documentation पढ़ें।
$ easyocr -l ch_sim en -f chinese.jpg --detail=1 --gpu=True
पहचान मॉडल के लिए, यहाँ पढ़ें।
पहचान मॉडल (CRAFT) के लिए, यहाँ पढ़ें।
reader = easyocr.Reader(['en'], detection='DB', recognition = 'Transformer')
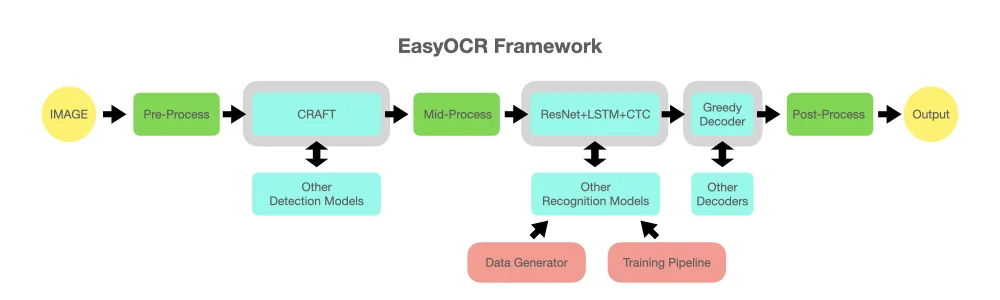
यह विचार है कि किसी भी अत्याधुनिक मॉडल को EasyOCR में प्लग किया जा सके। बहुत सारे प्रतिभाशाली लोग बेहतर डिटेक्शन/रिकग्निशन मॉडल बनाने की कोशिश कर रहे हैं, लेकिन हम यहाँ प्रतिभाशाली बनने की कोशिश नहीं कर रहे हैं। हम बस उनके काम को जनता के लिए जल्दी से सुलभ बनाना चाहते हैं ... मुफ़्त में। (ठीक है, हमारा मानना है कि अधिकांश प्रतिभाशाली लोग चाहते हैं कि उनका काम यथासंभव तेज़/बड़े सकारात्मक प्रभाव को उत्पन्न करे) पाइपलाइन नीचे दिए गए आरेख जैसी कुछ होनी चाहिए। ग्रे स्लॉट्स परिवर्तनशील हल्के नीले मॉड्यूल के लिए प्लेसहोल्डर हैं।
यह प्रोजेक्ट कई पेपरों और ओपन-सोर्स रिपॉज़िटरीज़ के शोध और कोड पर आधारित है।
सभी डीप लर्निंग निष्पादन Pytorch पर आधारित है। ❤️
डिटेक्शन निष्पादन इस आधिकारिक रिपॉज़िटरी और उनके पेपर से CRAFT एल्गोरिदम का उपयोग करता है (@clovaai से @YoungminBaek को धन्यवाद)। हम उनके प्रीट्रेन्ड मॉडल का भी उपयोग करते हैं। ट्रेनिंग स्क्रिप्ट @gmuffiness द्वारा प्रदान की गई है।
रिकग्निशन मॉडल एक CRNN (पेपर) है। यह 3 मुख्य घटकों से बना है: फीचर एक्सट्रैक्शन (हम वर्तमान में Resnet और VGG का उपयोग कर रहे हैं), सीक्वेंस लेबलिंग (LSTM) और डिकोडिंग (CTC)। रिकग्निशन निष्पादन के लिए ट्रेनिंग पाइपलाइन deep-text-recognition-benchmark फ्रेमवर्क का एक संशोधित संस्करण है। (@clovaai से @ku21fan को धन्यवाद) यह रिपॉज़िटरी एक रत्न है जो अधिक मान्यता की हकदार है।
बीम सर्च कोड इस रिपॉज़िटरी और उनके ब्लॉग पर आधारित है। (@githubharald को धन्यवाद)

