 hahwul/urx
OSINT संग्रह से सुरक्षा अंतर्दृष्टि के लिए URLs निकालता है

सुरक्षा अंतर्दृष्टि के लिए OSINT अभिलेखागार से URL निकालता है।




Urx एक कमांड-लाइन टूल है जिसे OSINT अभिलेखागार, जैसे Wayback Machine और Common Crawl, से URL एकत्र करने के लिए डिज़ाइन किया गया है। दक्षता के लिए Rust के साथ बनाया गया, यह कई डेटा स्रोतों को तेज़ी से क्वेरी करने के लिए असिंक्रोनस प्रोसेसिंग का लाभ उठाता है। यह टूल किसी निर्दिष्ट डोमेन के लिए URL जानकारी एकत्र करने की प्रक्रिया को सरल बनाता है, जो एक व्यापक डेटासेट प्रदान करता है जिसका उपयोग विभिन्न उद्देश्यों के लिए किया जा सकता है, जिसमें सुरक्षा परीक्षण और विश्लेषण शामिल है।
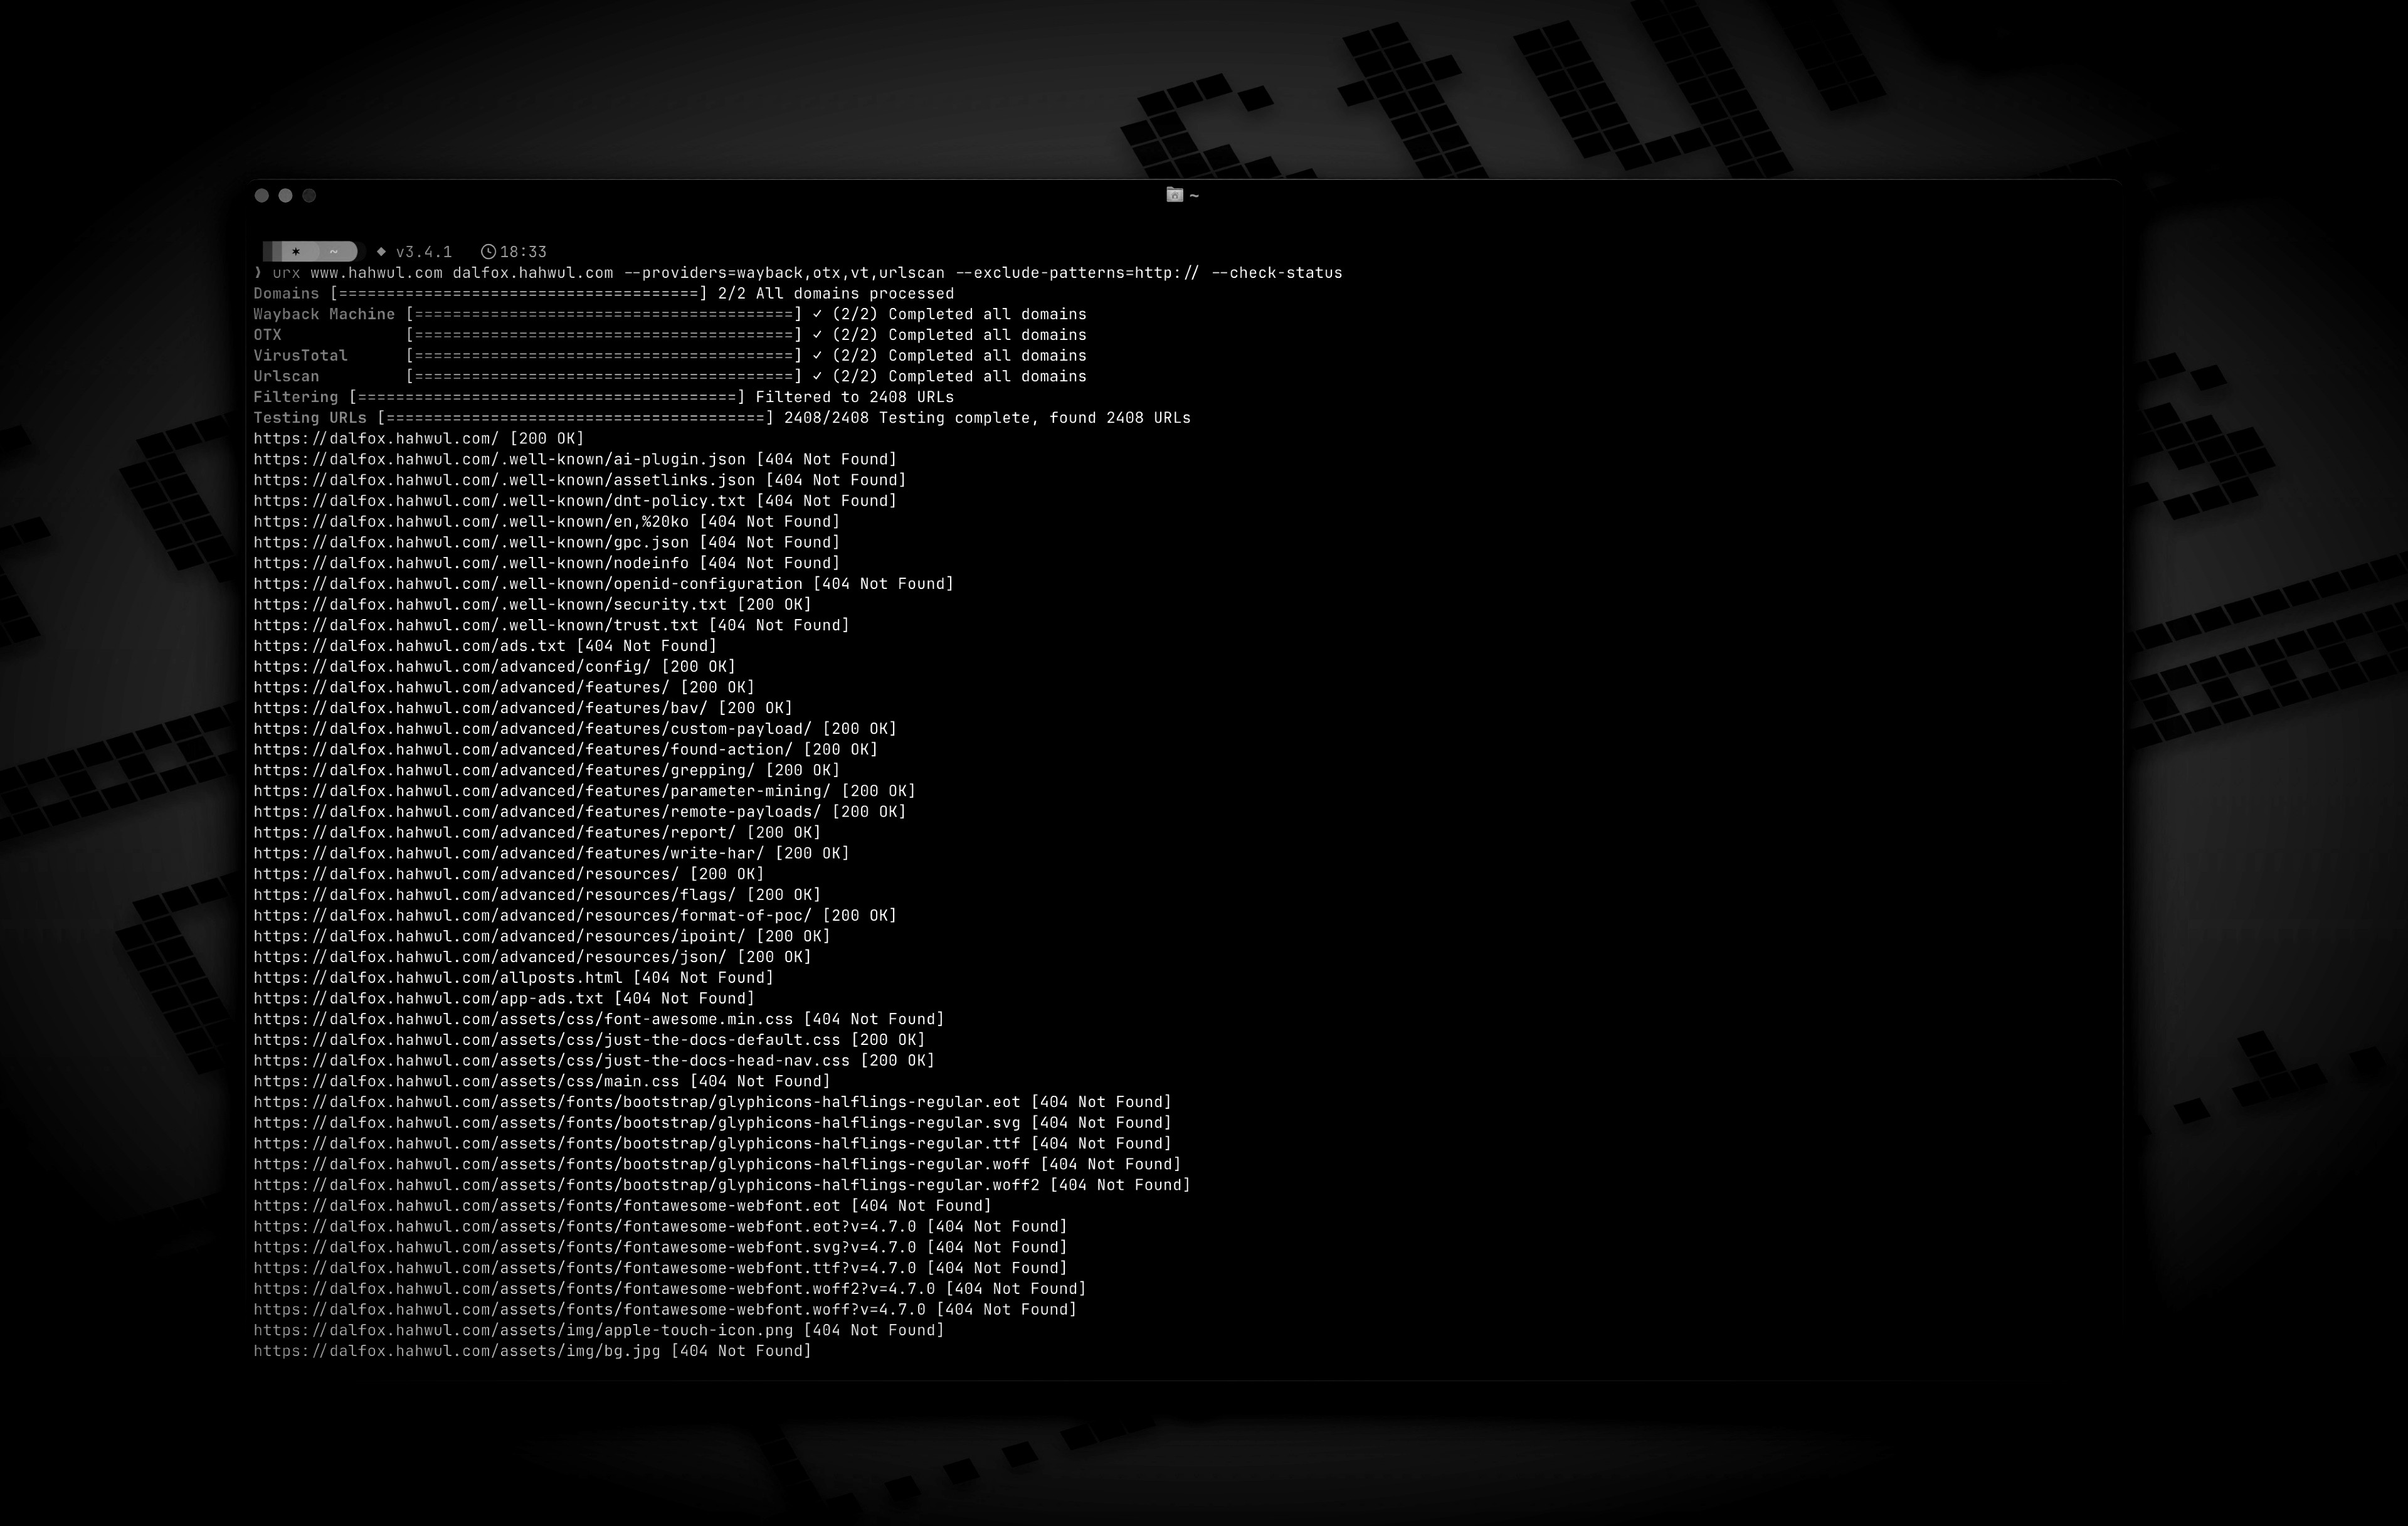
--cdx-endpoint URL के साथ, किसी कोड परिवर्तन की आवश्यकता नहीं-H, --cookie और --user-agent urx द्वारा लक्ष्य को की जाने वाली प्रत्येक अनुरोध पर लागू होते हैं (--check-status, --extract-links, --extract-js-endpoints, --expand-specs) और जानबूझकर कभी किसी अभिलेखागार को नहीं भेजे जाते--match-regex / --filter-regex) द्वारा परिणाम फ़िल्टर करें--meta-*): संग्रह के बाद, प्रत्येक प्रदाता में समान रूप से पहली/अंतिम कैप्चर तिथि, रिकॉर्ड किए गए MIME प्रकार और रिकॉर्ड किए गए स्थिति पर फ़िल्टर करेंurx example.com/shop स्कोप को CDX क्वेरी में ही पुश करता है (url=example.com/shop*), इसलिए एक बड़ी साइट के सबट्री की लागत पूरे इंडेक्स का एक अंश होती है, बजाय क्लाइंट-पक्ष पर फ़िल्टर किए जाने के--scope-file): एक प्रोग्राम की अपनी *.example.com / !admin.example.com सूची का शब्दशः उपयोग, दोहराने योग्य और संयुक्त, बहिष्करण हमेशा जीतते हैं--dedup-similar)wordlist — वे पथ खंड और पैरामीटर नाम जिनसे लक्ष्य बना है, ids, hashes और तारीखों को छोड़कर--params (पूरे लक्ष्य की पैरामीटर सूची), --params-by-endpoint (कौन सा एंडपॉइंट क्या लेता है), और --fuzz-placeholder FUZZ (प्रति पैरामीटर हस्ताक्षर एक टेम्पलेटेड URL, ffuf या dalfox के लिए तैयार)first_seen, last_seen, mime, archive_status, और digest प्रत्येक URL के साथ वापस आते हैं जिसकी CDX अभिलेखागार ने रिपोर्ट की, बिना किसी अतिरिक्त नेटवर्क लागत के--stream): URL तब लिखे जाते हैं जब प्रत्येक प्रदाता उन्हें रिपोर्ट करता है, इसलिए एक पाइपलाइन तुरंत काम करना शुरू कर देती है, सबसे धीमे अभिलेखागार की प्रतीक्षा करने के बजाय--archive-body), ताकि ऐसे पृष्ठ जो अब मौजूद नहीं हैं, फिर भी उनमें मौजूद लिंक छोड़ दें — प्रति विशिष्ट निकाय एक अनुरोध, CDX digest डुप्लिकेट हटाने के कारण--extract-js-endpoints के साथ, संग्रहीत JavaScript का भी खनन करें: बिल्ड हैश द्वारा नामित एक बंडल साइट के पुनः परिनियोजन के क्षण 404 हो जाता है, और अभिलेखागार ही एकमात्र स्थान है जहाँ इसका API सतह अभी भी मौजूद है--archive-body-dir) को एक कोर्पस के रूप में रखें ताकि उन चीज़ों के लिए grep किया जा सके जिन्हें कोई लिंक एक्सट्रैक्टर नहीं ढूंढता — डेवलपर टिप्पणियाँ, इनलाइन क्रेडेंशियल, आंतरिक होस्टनाम — बिना किसी अतिरिक्त अनुरोध के--expand-specs): OpenAPI 3.x, Swagger 2.0 और GraphQL introspection दस्तावेज़, JSON या YAML, उनके द्वारा वर्णित प्रत्येक रूट में बदल दिए जाते हैं — एक अनुरोध पूरी प्रलेखित सतह खरीदता है--check-status Location, Content-Length और Content-Type भी रिकॉर्ड करता है, और --check-title HTML जोड़ता है--archived-discovery): Wayback Machine के पास मौजूद प्रत्येक विशिष्ट संस्करण, इसलिए 2015 का Disallow: अभी भी उन पथों का नाम लेता है जिनका उल्लेख साइट ने तब से बंद कर दिया हैurx cache सबकमांड: stats, list, prune, drop <domain>, clear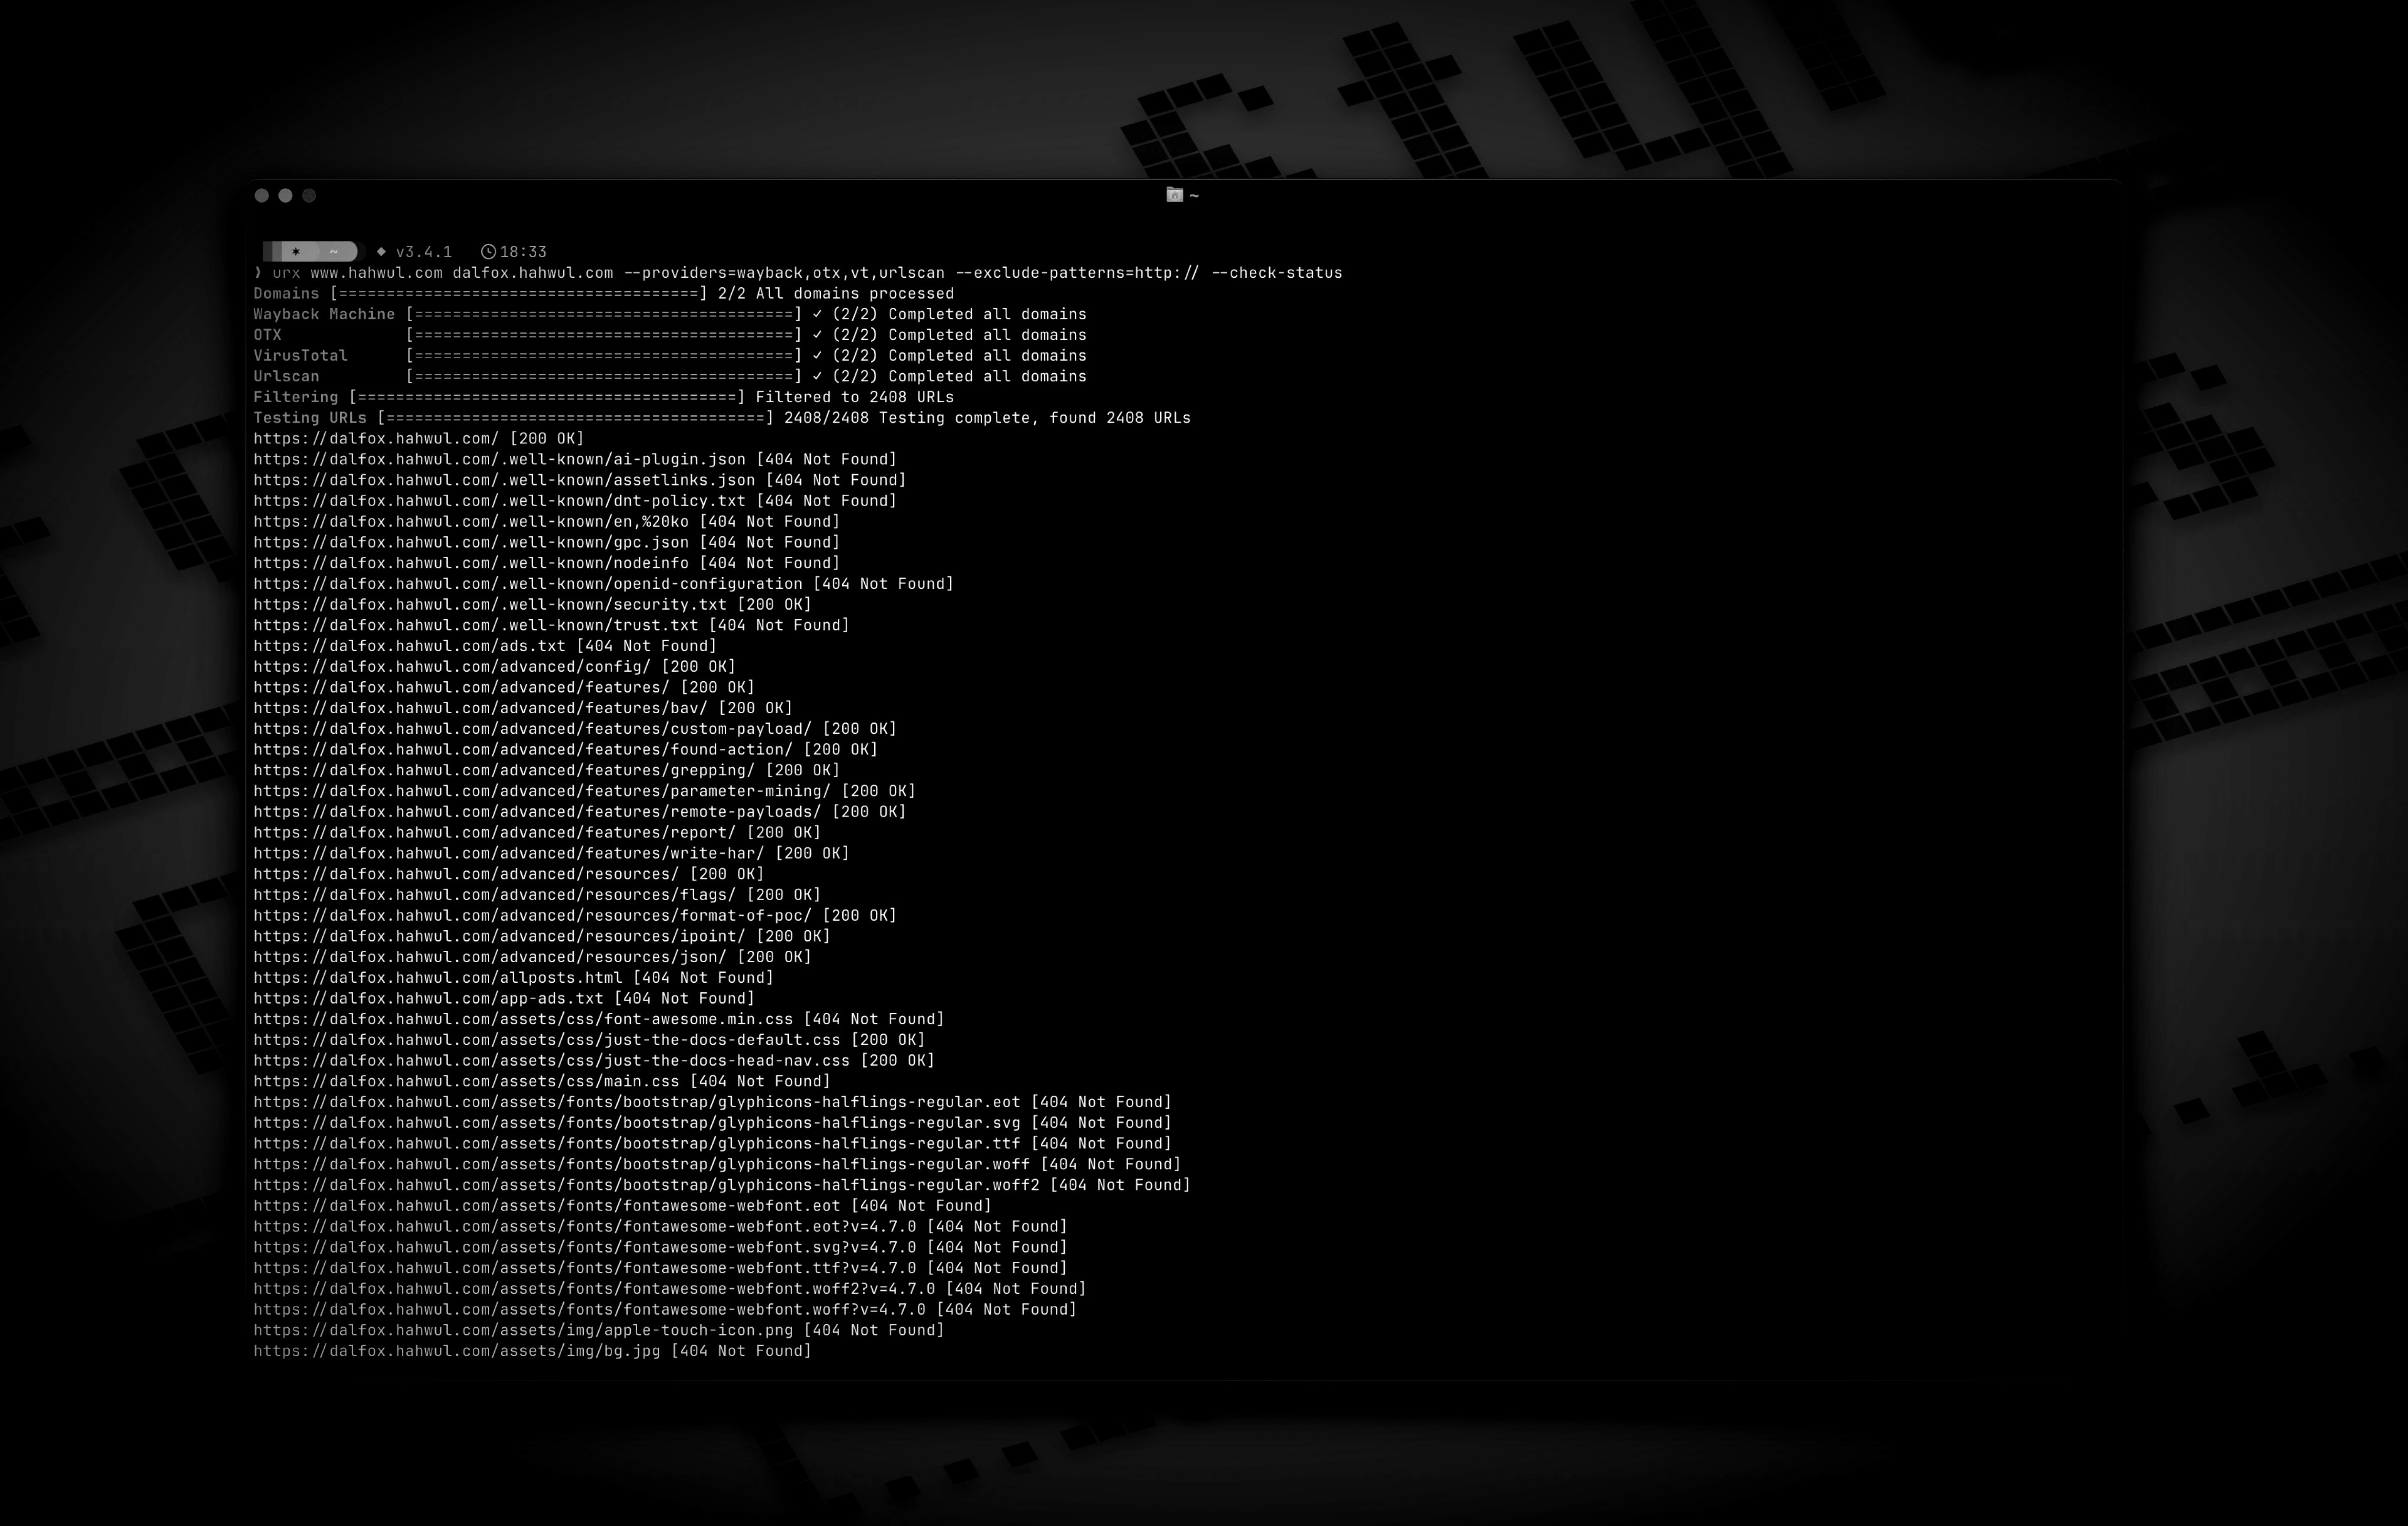
cargo install urx
### Homebrew से```bash
# https://formulae.brew.sh/formula/urx
brew install urx
git clone https://github.com/hahwul/urx.git cd urx cargo build --release
The compiled binary will be available at `target/release/urx`.

### From Docker

[ghcr.io/hahwul/urx](https://github.com/hahwul/urx/pkgs/container/urx)

### Shell Completions

`urx` generates its own completion script, so it always matches the flags of
the binary you actually have installed.```bash
# zsh — any directory on your $fpath works
urx --completions zsh > ~/.zfunc/_urx
# (make sure ~/.zfunc is on the fpath, then `compinit`)

# bash
urx --completions bash > ~/.local/share/bash-completion/completions/urx

# fish
urx --completions fish > ~/.config/fish/completions/urx.fish
powershell और elvish भी समर्थित हैं। फ़्लैग को किसी लक्ष्य डोमेन की आवश्यकता नहीं है।
urx --manpage > ~/.local/share/man/man1/urx.1 man urx
## उपयोग

### बुनियादी उपयोग```bash
# Scan a single domain
urx example.com

# Scan multiple domains
urx example.com example.org

# Scan domains from a file
cat domains.txt | urx
Usage: urx [OPTIONS] [DOMAINS]... [COMMAND]
Commands: cache Inspect and maintain the URL cache: stats, list, prune, drop ..., clear
Arguments: [DOMAINS]... Domains to fetch URLs for
Options: -c, --config Config file to load --provider-config Separate provider config file holding only API keys (default: $XDG_CONFIG_HOME/urx/provider-config.toml). CLI/env > provider-config > main config. --completions Print a shell completion script (bash, zsh, fish, powershell, elvish) to stdout and exit --manpage Print the roff man page to stdout and exit -h, --help Print help -V, --version Print version
Input Options:
--files ... Read URLs directly from files (supports WARC, URLTeam compressed, and text files)
--domain-list File of newline-separated domains to scan (repeatable; merged with positional DOMAINS and stdin; # comments allowed)
Output Options:
-o, --output Output file to write results
--output-dir Write one file per domain into this directory (extension matches --format). Coexists with --output / stdout.
-f, --format Output format: "plain", "json" (one array), "jsonl" (one JSON object per line), "csv", "wordlist" (path segments and parameter names, deduplicated and sorted) [default: plain]
--stream Write URLs as each provider reports them instead of once at the end (unsorted; bypasses cache; rejects options needing the full result set)
--merge-endpoint Merge endpoints with the same path and merge URL parameters
--normalize-url Normalize URLs for better deduplication (sorts query parameters, removes trailing slashes)
--dedup-similar Collapse URLs that differ only in variable data (numeric ids, UUIDs, hashes, dates, query values)
--params Replace the URL list with every query parameter name the run saw, once each
--params-by-endpoint
One line per endpoint: the endpoint and the comma-separated union of the parameter names seen on it (id-looking path segments collapse to {id})
--fuzz-placeholder
Replace every query parameter value with VALUE, keeping one URL per parameter signature — output you can feed straight to ffuf or dalfox
Provider Options:
--providers
Providers to use (comma-separated, e.g., "wayback,cc,otx,arquivo,vt,urlscan") [default: wayback,cc,otx]
--exclude-providers <EXCLUDE_PROVIDERS>
Providers to exclude (comma-separated). Wins on conflict with --providers / --all-providers.
--all-providers
Enable every supported provider. API-keyed providers only activate when a key is available.
--list-providers
List every supported provider then exit.
--subs
Include subdomains when searching
--cc-index <CC_INDEX>
Common Crawl index to use; accepts comma-separated list to query multiple indexes in parallel (e.g. CC-MAIN-2026-17,CC-MAIN-2025-51). latest (the default) resolves the newest via collinfo.json. [default: latest]
--cdx-endpoint
Query an additional CDX index server (any pywb, OutbackCDX, or classic Internet-Archive-style CDX API) by its full API URL, e.g. https://vefsafn.is/cdx. Repeatable. Each endpoint becomes a provider with id cdx:<host> and honours --subs, --from/--to and the --archive-* filters. See "Custom CDX Endpoints" below
--cdx-dialect
Which CDX dialect the --cdx-endpoint servers speak: pywb or classic. Unset: urx probes each endpoint once and falls back to pywb when the answer is ambiguous
--from
Restrict every CDX-backed provider (wayback, cc, arquivo, --cdx-endpoint) to captures at or after DATE (YYYY/YYYYMM/YYYYMMDD/YYYYMMDDhhmmss). Alias: --wayback-from
--to
Restrict every CDX-backed provider to captures at or before DATE (same format as --from). Alias: --wayback-to
--archive-status
Keep only captures the archive recorded with this HTTP status code (e.g. "200"). Applied by the CDX index itself, so unlike --include-status it costs no extra requests. A multi-value list works on wayback only — see "Archive-side Filtering" below
--archive-exclude-status
Drop captures the archive recorded with these HTTP status codes (comma-separated, e.g. "404,500"). Multi-value works on every CDX provider
--archive-mime
Keep only captures with this recorded MIME type (e.g. "application/json"). Catches endpoints with no file extension, which -e/--extensions cannot
--archive-exclude-mime
Drop captures with these recorded MIME types (comma-separated, e.g. "text/html,image/png")
--vt-api-key <VT_API_KEY>
API key for VirusTotal (can be used multiple times for rotation, can also use URX_VT_API_KEY environment variable with comma-separated keys)
--urlscan-api-key <URLSCAN_API_KEY>
Optional API key for Urlscan; the provider also works anonymously (rate-limited ~30 req/min per IP). Can be used multiple times for rotation, or via URX_URLSCAN_API_KEY (comma-separated keys)
--github-api-key <GITHUB_API_KEY>
Personal access token for the GitHub Code Search provider (also reads URX_GITHUB_API_KEY, comma-separated for rotation)
--bevigil-api-key <BEVIGIL_API_KEY>
API key for BeVigil, which returns URLs extracted from unpacked Android apps (also reads URX_BEVIGIL_API_KEY, comma-separated for rotation). Required for the  provider
<title>bevigilDiscovery Options: --exclude-robots Exclude robots.txt discovery --exclude-sitemap Exclude sitemap.xml discovery --archived-discovery Also read every distinct archived version of robots.txt and sitemap.xml the Wayback Machine holds --archived-discovery-limit Maximum archived documents fetched per domain by each archived provider (nested sitemaps count) [default: 50]
Display Options: -v, --verbose Show verbose output --silent Silent mode (no output) --no-progress No progress bar --no-color Disable ANSI color in the progress UI and output (NO_COLOR is also honored) --show-sources Annotate output URLs with the providers that returned them --show-meta Annotate plain-text URLs with the archive capture metadata --stats Print a per-provider summary to stderr at end of run
Filter Options:
-p, --preset
Filter Presets (e.g., "no-resources,no-images,no-audio,only-js,only-style,only-secrets,only-backup,only-config,only-api")
-e, --extensions
Filter URLs to only include those with specific extensions (comma-separated, e.g., "js,php,aspx")
--exclude-extensions <EXCLUDE_EXTENSIONS>
Filter URLs to exclude those with specific extensions (comma-separated, e.g., "html,txt")
--patterns
Filter URLs to only include those containing specific patterns (comma-separated)
--exclude-patterns <EXCLUDE_PATTERNS>
Filter URLs to exclude those containing specific patterns (comma-separated)
--match-regex
Keep only URLs matching this regular expression (repeatable, ORed; case-sensitive; never comma-split)
--filter-regex
Drop URLs matching this regular expression (repeatable; one match is enough)
--show-only-host
Only show the host part of the URLs
--show-only-path
Only show the path part of the URLs
--show-only-param
Only show the parameters part of the URLs
--min-length <MIN_LENGTH>
Minimum URL length to include
--max-length <MAX_LENGTH>
Maximum URL length to include
--strict
Enforce exact host validation (default)
--no-strict
Disable host validation (keep URLs on any host a provider returns). Wins over --strict. A target's path scope still applies: only the host check is waived
--scope-file
Bug-bounty scope file: one host pattern per line, ! to exclude, *.example.com for a wildcard (which covers the apex too), # for a comment. Repeatable and unioned; exclusions always win. See "Scope Files" below
--meta-first-seen-after
Keep URLs whose oldest archived capture is on or after DATE (YYYY/YYYYMM/YYYYMMDD/YYYYMMDDhhmmss)
--meta-first-seen-before
Keep URLs whose oldest archived capture is on or before DATE
--meta-last-seen-after
Keep URLs whose newest archived capture is on or after DATE — "still alive as of"
--meta-last-seen-before
Keep URLs whose newest archived capture is on or before DATE — "dead since"
--meta-mime
Keep only URLs whose archived MIME type is one of these (comma-separated; image/* matches any subtype)
--meta-exclude-mime
Drop URLs whose archived MIME type is one of these
--meta-status
Keep only URLs whose archived status code matches (comma-separated; 20x / 5xx patterns)
--meta-exclude-status
Drop URLs whose archived status code matches
Network Options:
--network-scope <NETWORK_SCOPE> Control which components network settings apply to (all, providers, testers, or providers,testers) [default: all]
--proxy Use proxy for HTTP requests (format: http://proxy.example.com:8080)
--proxy-auth <PROXY_AUTH> Proxy authentication credentials (format: username:password)
--insecure Skip SSL certificate verification (accept self-signed certs)
--random-agent Use a random User-Agent for HTTP requests
-H, --header <NAME: VALUE> Extra request header, repeatable; sent only on requests urx makes to the target, never to an archive
--cookie Cookie header for requests to the target; shorthand for -H "Cookie: ..."
--user-agent User-Agent for requests to the target, overriding the default and --random-agent
--timeout Request timeout in seconds [default: 120]
--retries Number of retries for failed requests [default: 2]
--parallel Maximum domains fetched concurrently per provider (and concurrent URL tests); a provider's --rate-limit is shared across them [default: 5]
--rate-limit <RATE_LIMIT> Rate limit (requests per second)
--rate-limit-by Per-provider rate overrides (e.g. vt=1,wayback=10); falls back to --rate-limit for unlisted providers
--max-time <MAX_TIME> Global ceiling on provider enumeration time in seconds (0 = unlimited) [default: 0]
Testing Options:
--check-status
Check HTTP status code of collected URLs [aliases: ----cs]
--check-title
Also record each response's HTML while checking statuses; implies --check-status
--include-status <INCLUDE_STATUS>
Include URLs with specific HTTP status codes or patterns (e.g., --is=200,30x) [aliases: ----is]
--exclude-status <EXCLUDE_STATUS>
Exclude URLs with specific HTTP status codes or patterns (e.g., --es=404,50x,5xx) [aliases: ----es]
--extract-links
Extract additional links from collected URLs (requires HTTP requests)
--extract-js-endpoints
Fetch collected JavaScript files and extract the endpoint paths and URLs found in their string literals (requires HTTP requests); with --archive-body this also mines the archived copy of each script
--max-js-files
Maximum number of files --extract-js-endpoints will fetch (0 = unlimited) [default: 500]
--archive-body
Fetch the archived body of each collected URL from the Wayback Machine and extract the links inside it (works for pages that no longer exist)
--archive-body-limit
Maximum number of archived bodies --archive-body fetches per run; bounds distinct bodies, not URLs [default: 500]
--archive-body-dir
Keep every body --archive-body replays in DIR, with an index.jsonl mapping each file back to its URL, capture and content type
--expand-specs
Fetch the API specification documents among the collected URLs (OpenAPI, Swagger, GraphQL introspection; JSON or YAML) and expand every route they document into a URL. See "Expanding API Specifications" below
--max-spec-files
Maximum number of specification documents --expand-specs will fetch (0 = unlimited) [default: 50]
Cache Options:
--incremental Enable incremental scanning mode (only return new URLs compared to previous scans)
--cache-type Cache backend: sqlite or redis [default: sqlite]
--cache-path Path for the SQLite cache database
--redis-url Redis connection URL for remote caching
--cache-ttl Cache time-to-live in seconds [default: 86400]
--no-cache Disable caching entirely
Notification Options:
--notify POST a run summary to this webhook when the run ends (repeatable; also URX_NOTIFY_URL, provider-config notify_url, or [notify].url)
--notify-on <NOTIFY_ON> When to send: new (only if URLs were emitted), always, or never [default: new]
--notify-format <NOTIFY_FORMAT> Payload shape: json (urx summary), slack ({"text"}), or discord ({"content"}) [default: json]
`--extract-links` हर URL-युक्त टैग को पढ़ता है, केवल anchors को नहीं: `<a href>`,
`<script src>`, `<link href>`, `<form action>`, ``, ``,
`<source src>`, `<object data>`, `<embed src>`, और `<meta http-equiv="refresh">`
targets। सापेक्ष URLs पृष्ठ के सापेक्ष resolve होते हैं (`<base href>` का पालन करते हुए),
डुप्लिकेट collapse हो जाते हैं, और खोजे गए लिंक बाकी run की तरह ही समान filters
और host validation से गुज़रते हैं। पूरी तालिका के लिए
[docs/content/guide/cli-options.md](https://github.com/hahwul/urx/blob/main/docs/content/guide/cli-options.md) देखें।
`--extract-js-endpoints` एक कदम आगे जाता है और JavaScript को ही पढ़ता है:
script जैसा दिखने वाला हर एकत्रित URL fetch किया जाता है और उसके
string literals से उन paths और URLs को खनन किया जाता है जिन्हें ऐप कॉल करता है —
`fetch("/api/v2/users")`, `axios.post("/graphql")`, `` `/api/orders/${id}` `` का static prefix।
ये वे endpoints हैं जो कभी HTML में नहीं दिखते।
Output को आक्रामक रूप से de-noise किया जाता है (MIME types, module specifiers, base64,
CSS values, regex fragments और बहुत कुछ हटा दिए जाते हैं), प्रत्येक body 10 MiB पर capped होता है,
fetch की गई फ़ाइलों की संख्या `--max-js-files` द्वारा सीमित होती है, और
खोजे गए endpoints बाकी सब चीज़ों की तरह ही समान filters और host validation से गुज़रते हैं। पूरी extraction और noise-suppression नीति
[docs/content/guide/cli-options.md](https://github.com/hahwul/urx/blob/main/docs/content/guide/cli-options.md#javascript-endpoint-extraction) में है।
`--archive-body` वही extraction उन bodies पर करता है जिन्हें Wayback Machine ने
*संग्रहीत* किया था, न कि live site पर, इसलिए वर्षों पहले हटाया गया पृष्ठ भी
अपने अंदर मौजूद लिंक प्रदान करता है। देखें
[Mining Archived Response Bodies](#mining-archived-response-bodies)।
### उदाहरण```bash
# Save results to a file
urx example.com -o results.txt
# Output in JSON format
urx example.com -f json -o results.json
# Filter for JavaScript files only
urx example.com -e js
# Exclude HTML and text files
urx example.com --exclude-extensions html,txt
# Filter for API endpoints
urx example.com --patterns api,v1,graphql
# Exclude specific patterns
urx example.com --exclude-patterns static,images
# Use Fileter Preset (similar to --exclude-extensions=png,jpg,.....)
urx example.com -p no-images
# Use specific providers
urx example.com --providers wayback,otx
# Add the keyless Arquivo.pt (Portuguese web archive) provider
urx example.com --providers wayback,cc,otx,arquivo
# Query another CDX index server alongside the defaults (id: cdx:vefsafn.is)
urx example.is --cdx-endpoint https://vefsafn.is/cdx
# ...or on its own, rate-limited, with the archive-side filters it shares with wayback/cc
urx example.is --cdx-endpoint https://vefsafn.is/cdx --providers cdx:vefsafn.is \
--rate-limit-by cdx:vefsafn.is=1 --from 2020 --archive-status 200
# URLScan works without a key (anonymous, rate-limited); a key just raises limits
urx example.com --providers urlscan
# BeVigil: endpoints pulled out of unpacked Android apps (key required; auto-enables the provider)
URX_BEVIGIL_API_KEY=*** urx example.com
# Using VirusTotal and URLScan providers
# 1. Explicitly add to providers (with API keys via command line)
urx example.com --providers=vt,urlscan --vt-api-key=*** --urlscan-api-key=***
# 2. Using environment variables for API keys
URX_VT_API_KEY=*** URX_URLSCAN_API_KEY=*** urx example.com --providers=vt,urlscan
# 3. Auto-enabling: providers are automatically added when API keys are provided
urx example.com --vt-api-key=*** --urlscan-api-key=*** # No need to specify in --providers
# 4. Multiple API key rotation (to mitigate rate limits)
# Using repeated flags for multiple keys
urx example.com --vt-api-key=key1 --vt-api-key=key2 --vt-api-key=key3
# Using environment variables with comma-separated keys
URX_VT_API_KEY=key1,key2,key3 URX_URLSCAN_API_KEY=ukey1,ukey2 urx example.com
# Combining CLI flags and environment variables (CLI keys are used first)
URX_VT_API_KEY=env_key1,env_key2 urx example.com --vt-api-key=cli_key1 --vt-api-key=cli_key2
# URLs from robots.txt and sitemap.xml are included by default
# Exclude URLs from robots.txt files
urx example.com --exclude-robots
# Exclude URLs from sitemap
urx example.com --exclude-sitemap
# Also read every archived version of robots.txt and sitemap.xml, so paths the
# site once listed and has since removed come back
urx example.com --archived-discovery
# Only the versions captured in a given era
urx example.com --archived-discovery --from 2014 --to 2016 --exclude-sitemap
# Include subdomains
urx example.com --subs
# Check status of collected URLs
urx example.com --check-status
# Read URLs directly from a text file
urx --files urls.txt
# Combine file input with filtering
urx --files urls.txt --patterns api,admin -f json
# Extract additional links from collected URLs
# (anchors, scripts, stylesheets, form actions, iframes, images, media
# sources, objects, embeds, and meta-refresh targets)
urx example.com --extract-links
# Discovered links go through the same filters as everything else, so this
# keeps only the JavaScript the pages reference
urx example.com --extract-links -e js
# Read the collected JavaScript and pull out the API paths it calls
urx example.com --extract-js-endpoints --patterns api
# Chain them: collect the site's bundles, then mine those for endpoints
urx example.com --extract-links --extract-js-endpoints --max-js-files 100
# Mine the links inside the *archived* bodies instead — dead pages included.
# One request per distinct body; the limit bounds bodies, not URLs
urx example.com --archive-body --archive-body-limit 200 --rate-limit 5
# Network configuration
urx example.com --proxy http://localhost:8080 --timeout 60 --parallel 10 --insecure
# Advanced filtering
urx example.com -e js,php --patterns admin,login --exclude-patterns logout,static --min-length 20
# HTTP Status code based filtering (live requests: urx re-fetches each URL)
urx example.com --include-status 200,30x,405 --exclude-status 20x
# Archive-side filtering (free: the CDX index already knows these)
# Skip everything the archive recorded as a 404 — no extra requests
urx example.com --archive-exclude-status 404
# Only captures the archive served as JSON — finds extensionless API endpoints
urx example.com --archive-mime application/json
# Drop HTML to leave assets and endpoints behind
urx example.com --archive-exclude-mime text/html
# Restrict the crawl window across wayback, cc, arquivo, and any --cdx-endpoint alike
urx example.com --from 2023 --to 2024
# Disable host validation
urx example.com --strict false
# URL normalization and deduplication
# Normalize URLs by sorting query parameters and removing trailing slashes
urx example.com --normalize-url
# Combine normalization with endpoint merging for comprehensive deduplication
urx example.com --normalize-url --merge-endpoint
# URL normalization with file input
urx --files urls.txt --normalize-url
# Collapse /post/1, /post/2, /post/99999 ... into a single representative line
urx example.com --dedup-similar
# Regular-expression filtering (repeat either flag; they are never comma-split)
urx example.com --match-regex '/api/v[0-9]+/'
urx example.com --match-regex '\.php$' --match-regex '\.aspx$'
urx example.com --filter-regex '/(assets|static)/'
# Regexes are case-sensitive; ask for insensitivity explicitly
urx example.com --match-regex '(?i)admin'
# Security presets: match by path shape as well as by extension
urx example.com -p only-secrets # /.env, /.git/config, id_rsa, *.pem
urx example.com -p only-backup # *.bak, *.sql, /backup/, index.php~
urx example.com -p only-config # *.yaml, web.config, .htaccess, Dockerfile
urx example.com -p only-api # /api/, /v1/, /graphql, /swagger, *.wsdl
# Scope files: a bug bounty program's own host list, used verbatim
urx example.com --subs --scope-file scope.txt
# Metadata filters, applied after collection so every provider is covered
urx example.com --providers wayback --meta-last-seen-after 2024 --meta-exclude-mime 'image/*'
urx example.com --providers wayback --meta-mime application/json --meta-status 200
# What parameters does this target take, and where?
urx example.com --params
urx example.com --params-by-endpoint
# One templated URL per parameter signature, straight into a fuzzer
urx example.com --fuzz-placeholder FUZZ | ffuf -w - -u FUZZ
# A target-specific wordlist instead of a URL list
urx example.com --subs -f wordlist -o words.txt
# Open the API specifications the sweep found and expand every route in them
urx example.com -p only-api --expand-specs
# Status checks also keep the response head; --check-title adds the <title>
urx example.com --check-status -f jsonl
urx example.com --check-title --show-meta
# Inspect and maintain the cache
urx cache stats
urx cache drop example.com
रन को एक पथ तक सीमित करना
एक लक्ष्य एक पथ का नाम दे सकता है, और इसका अर्थ वही होता है जो यह कहता है: urx example.com/shop
/shop के अंतर्गत साइट के भाग को एकत्र करता है।```bash
urx example.com/shop
urx https://example.com/api/v2 # a pasted URL works too
यह बाद में लागू किया गया फ़िल्टर नहीं है। एक CDX इंडेक्स प्रीफ़िक्स क्वेरीज़ का मूल रूप से उत्तर देता है, इसलिए urx `url=example.com/shop*` भेजता है और आर्काइव बाकी साइट को नेटवर्क पर कभी नहीं भेजता — एक बड़े लक्ष्य पर यह कुछ सौ पंक्तियों और कुछ सौ हज़ार के बीच का अंतर है। जो प्रोवाइडर अपनी क्वेरी में पथ व्यक्त नहीं कर सकते (OTX, VirusTotal, urlscan, GitHub, BeVigil, ZoomEye) उनसे होस्ट के बारे में पूछा जाता है और उनके उत्तर बाद में संकीर्ण कर दिए जाते हैं, जैसा कि `--subs` रन के परिणामों के साथ होता है, जहाँ `*.host` रूप और एक पथ प्रीफ़िक्स को एक CDX क्वेरी में संयोजित नहीं किया जा सकता।
स्कोप का अर्थ है पथ पर या उसके नीचे: `/shop` और `/shop/cart` अंदर हैं, `/shopping` नहीं है। केस को अनदेखा किया जाता है, क्योंकि एक CDX सर्वर अपनी इंडेक्स कुंजी बनाते समय पूरे URL को लोअर-केस कर देता है — `example.com/Shop*` और `example.com/shop*` समान पंक्तियाँ लौटाते हैं, सभी लोअर केस में लिखी हुई, इसलिए केस-सेंसिटिव जाँच आर्काइव द्वारा अभी-अभी लौटाई गई हर चीज़ को फेंक देगी। लक्ष्य में एक क्वेरी स्ट्रिंग या फ्रैगमेंट हटा दिया जाता है — वे एक अनुरोध को संकीर्ण करते हैं, स्कोप को नहीं।
> नोट: urx पहले एक लक्ष्य से पथ को हटा देता था, इसलिए
> `urx https://example.com/shop` पूरे `example.com` को स्कैन करता था। अब यह
> `/shop` को स्कैन करता है। पुराने व्यवहार के लिए केवल होस्ट पास करें; जिस रन के लक्ष्य में
> पथ होता है वह stderr पर ऐसा बताता है।
### रेगुलर-एक्सप्रेशन फ़िल्टरिंग
`--patterns` / `--exclude-patterns` सादे सबस्ट्रिंग परीक्षण हैं: दोनों पक्षों को
लोअर-केस किया जाता है, और हर मेटाकैरेक्टर एक लिटरल है। `--match-regex` /
`--filter-regex` रेगेक्स समकक्ष हैं, और वे तीन तरीकों से भिन्न हैं जो याद रखने योग्य हैं:
| | `--patterns` | `--match-regex` |
|---|---|---|
| मिलान | सबस्ट्रिंग | पूर्ण [रेगेक्स सिंटैक्स](https://docs.rs/regex/latest/regex/#syntax) |
| केस | असंवेदनशील (दोनों पक्ष लोअर-केस) | **संवेदनशील** — ऑप्ट आउट करने के लिए `(?i)` का उपयोग करें |
| एकाधिक मान | एक कॉमा-सेपरेटेड फ़्लैग | फ़्लैग दोहराएँ; कॉमा कभी विभाजित नहीं होते |
दोनों रेगेक्स फ़्लैग **पूरे URL स्ट्रिंग** के विरुद्ध मूल्यांकित किए जाते हैं जैसा कि एकत्र किया गया है
(स्कीम, होस्ट, पथ, और क्वेरी), इसलिए `^https://` और `\.js$` दोनों काम करते हैं।
बहिष्करण जीतता है: `--filter-regex` से मेल खाने वाला URL हटा दिया जाता है भले ही
`--match-regex` भी उससे मेल खाया हो। एक विकृत एक्सप्रेशन स्टार्टअप पर रन को विफल कर देता है, किसी भी आर्काइव के क्वेरी किए जाने से पहले।
### स्कोप फ़ाइलें
एक बग बाउंटी प्रोग्राम का स्कोप होस्ट की एक सूची है, और हर प्लेटफ़ॉर्म इसे
एक ही तरह से लिखता है। `--scope-file` उस सूची को शब्दशः लेता है बजाय आपको
इसे एंकर्ड रेगेक्स वैकल्पिकताओं में हाथ से अनुवाद करने के लिए मजबूर करने के — जहाँ एंकरिंग
गलत होने पर चुपचाप स्कोप को *चौड़ा* कर देती है बजाय विफल होने के।```text
# scope.txt — in scope
*.example.com
api.example.org
# out of scope, even though the wildcard above covers them
!admin.example.com
!*.internal.example.com
| -s | --server | Server mode (default) |
| -c | --client | Client mode |
| -p | --port | Port to listen on or connect to |
| -h | --host | Host to connect to (client mode) |
| -v | --verbose | Enable verbose output |
| -d | --debug | Enable debug output |
| -V | --version | Show version information |
| -h | --help | Show help message |
उदाहरण
सर्वर मोड
डिफ़ॉल्ट पोर्ट (8080) पर सर्वर प्रारंभ करें:
./tool -s
कस्टम पोर्ट पर सर्वर प्रारंभ करें:
./tool -s -p 9090
क्लाइंट मोड
डिफ़ॉल्ट पोर्ट पर स्थानीय सर्वर से कनेक्ट करें:
./tool -c
किसी विशिष्ट होस्ट और पोर्ट से कनेक्ट करें:
./tool -c -h 192.168.1.100 -p 9090
वर्बोज़ और डीबग मोड
वर्बोज़ आउटपुट सक्षम करें:
./tool -s -v
डीबग आउटपुट सक्षम करें:
./tool -s -d
कॉन्फ़िगरेशन
टूल को कॉन्फ़िगरेशन फ़ाइल का उपयोग करके कॉन्फ़िगर किया जा सकता है। डिफ़ॉल्ट रूप से, यह वर्तमान निर्देशिका में config.yaml फ़ाइल की तलाश करता है।
कॉन्फ़िगरेशन फ़ाइल प्रारूप
# सर्वर कॉन्फ़िगरेशन
server:
host: "0.0.0.0"
port: 8080
max_connections: 100
timeout: 30
# क्लाइंट कॉन्फ़िगरेशन
client:
host: "127.0.0.1"
port: 8080
retry_attempts: 3
retry_delay: 5
# लॉगिंग कॉन्फ़िगरेशन
logging:
level: "info"
file: "tool.log"
max_size: 10
max_backups: 5
max_age: 30
कॉन्फ़िगरेशन विकल्प
विकल्प प्रकार डिफ़ॉल्ट विवरण server.hoststring "0.0.0.0"सर्वर को बाइंड करने के लिए होस्ट server.portint 8080सर्वर द्वारा सुने जाने वाला पोर्ट server.max_connectionsint 100अधिकतम समवर्ती कनेक्शन server.timeoutint 30कनेक्शन टाइमआउट सेकंड में client.hoststring "127.0.0.1"कनेक्ट करने के लिए होस्ट client.portint 8080कनेक्ट करने के लिए पोर्ट client.retry_attemptsint 3पुनः प्रयास प्रयासों की संख्या client.retry_delayint 5पुनः प्रयासों के बीच विलंब सेकंड में logging.levelstring "info"लॉग स्तर (debug, info, warn, error) logging.filestring "tool.log"लॉग फ़ाइल का पथ logging.max_sizeint 10लॉग फ़ाइल का अधिकतम आकार MB में logging.max_backupsint 5रखने के लिए अधिकतम बैकअप logging.max_ageint 30लॉग रखने के लिए अधिकतम दिन
सुरक्षा
प्रमाणीकरण
टूल क्लाइंट प्रमाणीकरण के लिए टोकन-आधारित प्रमाणीकरण का समर्थन करता है। प्रमाणीकरण सक्षम करने के लिए, कॉन्फ़िगरेशन फ़ाइल में एक टोकन निर्दिष्ट करें:
auth:
enabled: true
token: "your-secret-token-here"
एन्क्रिप्शन
सभी संचार TLS का उपयोग करके एन्क्रिप्ट किया जा सकता है। TLS सक्षम करने के लिए, कॉन्फ़िगरेशन फ़ाइल में प्रमाणपत्र और कुंजी फ़ाइलें निर्दिष्ट करें:
tls:
enabled: true
cert_file: "server.crt"
key_file: "server.key"
ca_file: "ca.crt"
सर्वोत्तम प्रथाएं
- मजबूत टोकन का उपयोग करें: सुनिश्चित करें कि प्रमाणीकरण टोकन लंबे और यादृच्छिक हैं।
- TLS सक्षम करें: उत्पादन में हमेशा TLS का उपयोग करें।
- पहुंच को सीमित करें: केवल आवश्यक होस्ट और पोर्ट को उजागर करें।
- नियमित रूप से अपडेट करें: टूल को नवीनतम संस्करण में अपडेट रखें।
- लॉग की निगरानी करें: संदिग्ध गतिविधि के लिए लॉग की नियमित रूप से समीक्षा करें।
समस्या निवारण
सामान्य समस्याएं
पोर्ट पहले से ही उपयोग में है
यदि आपको "पोर्ट पहले से ही उपयोग में है" त्रुटि मिलती है, तो इसका मतलब है कि कोई अन्य प्रक्रिया उस पोर्ट का उपयोग कर रही है। आप या तो उस प्रक्रिया को रोक सकते हैं या एक अलग पोर्ट निर्दिष्ट कर सकते हैं:
./tool -s -p 9090
कनेक्शन अस्वीकृत
यदि आपको "कनेक्शन अस्वीकृत" त्रुटि मिलती है, तो इसका मतलब है कि सर्वर चल नहीं रहा है या फ़ायरवॉल कनेक्शन को अवरुद्ध कर रहा है। सुनिश्चित करें कि सर्वर चल रहा है और फ़ायरवॉल कनेक्शन की अनुमति दे रहा है।
अनुमति अस्वीकृत
यदि आपको "अनुमति अस्वीकृत" त्रुटि मिलती है, तो इसका मतलब है कि आपके पास आवश्यक फ़ाइलों या पोर्ट तक पहुंचने के लिए आवश्यक अनुमतियां नहीं हैं। सुनिश्चित करें कि आपके पास उचित अनुमतियां हैं या उच्च विशेषाधिकारों के साथ टूल चलाएं।
डीबग मोड
यदि आपको समस्याओं का सामना करना पड़ रहा है, तो आप अधिक जानकारी प्राप्त करने के लिए डीबग मोड सक्षम कर सकते हैं:
./tool -s -d
यह विस्तृत डीबग जानकारी आउटपुट करेगा जो आपको समस्या का निदान करने में मदद कर सकता है।
योगदान
योगदान का स्वागत है! कृपया सुनिश्चित करें कि आप इन दिशानिर्देशों का पालन करते हैं:
- रिपॉजिटरी को फोर्क करें: रिपॉजिटरी को अपने GitHub खाते में फोर्क करें।
- एक शाखा बनाएं: अपने परिवर्तनों के लिए एक नई शाखा बनाएं।
- परिवर्तन करें: अपने परिवर्तन करें और उन्हें स्पष्ट संदेशों के साथ कमिट करें।
- परीक्षण करें: सुनिश्चित करें कि सभी परीक्षण पास होते हैं।
- पुल अनुरोध सबमिट करें: अपने परिवर्तनों के साथ एक पुल अनुरोध सबमिट करें।
कोड शैली
- Go मानक स्वरूपण का पालन करें (
gofmt)।
- सार्वजनिक कार्यों और प्रकारों के लिए दस्तावेज़ टिप्पणियां लिखें।
- नए सुविधाओं के लिए परीक्षण शामिल करें।
- सुनिश्चित करें कि सभी परीक्षण पास होते हैं।
परीक्षण
परीक्षण चलाने के लिए:
go test ./...
कवरेज के साथ परीक्षण चलाने के लिए:
go test -cover ./...
लाइसेंस
यह परियोजना MIT लाइसेंस के तहत लाइसेंस प्राप्त है। विवरण के लिए LICENSE फ़ाइल देखें।
आभार
- इस परियोजना में योगदान देने वाले सभी को धन्यवाद।
- ओपन सोर्स समुदाय को धन्यवाद जिनके उपकरण और पुस्तकालयों ने इस परियोजना को संभव बनाया।
संपर्क
- लेखक: आपका नाम
- ईमेल: [email protected]
- GitHub: https://github.com/yourusername/tool
अस्वीकरण
यह टूल केवल शैक्षिक और अनुसंधान उद्देश्यों के लिए है। इस टूल का उपयोग किसी भी सिस्टम के खिलाफ अनधिकृत पहुंच या गतिविधि के लिए न करें। इस टूल का उपयोग करते समय आप सभी लागू कानूनों और विनियमों का पालन करने के लिए जिम्मेदार हैं। लेखक इस टूल के किसी भी दुरुपयोग के लिए कोई जिम्मेदारी नहीं लेते हैं।```bash
urx example.com --subs --scope-file scope.txt
urx --domain-list targets.txt --subs --scope-file scope-a.txt --scope-file scope-b.txt
`*.example.com` apex के साथ-साथ उसके अंतर्गत आने वाली हर चीज़ से मेल खाता है (bug-bounty की समझ, जिसका मतलब है किसी प्लेटफ़ॉर्म की scope तालिका); एक बिना वाइल्डकार्ड वाला host ठीक उसी host से मेल खाता है; अकेला `*` फ़ाइल को शुद्ध deny-list बना देता है; exclusions हमेशा जीतती हैं; `#` एक टिप्पणी शुरू करता है। जो कुछ भी urx नहीं निभा सकता — कोई port, कोई path, बीच में कोई wildcard — वह चुपचाप व्यापक scope होने के बजाय फ़ाइल और पंक्ति का नाम लेते हुए एक startup error है। यह फ़िल्टर हर provider पर और निकाले गए links पर लागू होता है, और यह `--strict` को बदलने के बजाय उसके साथ मिल जाता है, इसलिए `*.example.com` scope पंक्ति को अभी भी `--subs` की आवश्यकता होती है।
### Archive Metadata Filters
`--from`/`--to` और `--archive-*` predicates को archive की अपनी query में push किया जाता है, जो उन्हें मुफ़्त बनाता है और साथ ही उन्हें CDX-backed providers तक सीमित करता है — और दोनों CDX dialects इतनी बुरी तरह असहमत होते हैं कि एक positive multi-value सूची (`--archive-status 200,301`) pywb servers पर असंतोषजनक होती है। आठ `--meta-*` फ़िल्टर इसके बजाय collection के *बाद* चलते हैं, प्रति URL capture metadata के एक merged सेट पर, इसलिए वे हर provider पर समान रूप से लागू होते हैं।```bash
# Endpoints still being captured recently, with HTML and images out of the way
urx example.com --providers wayback --meta-last-seen-after 2024 --meta-exclude-mime 'text/html,image/*'
# Pages that died: nothing captured since 2019
urx example.com --providers wayback --meta-last-seen-before 2019
# JSON the archive served successfully
urx example.com --providers wayback --meta-mime application/json --meta-status 200
# First archived during 2020 (partial dates pad to the start / end of the period)
urx example.com --providers wayback --meta-first-seen-after 2020 --meta-first-seen-before 2020
जिन URLs में कोई मेटाडेटा नहीं होता — non-CDX providers, --files input, cache hits — उन्हें predicate की दिशा से विभाजित किया जाता है: एक positive predicate किसी अनुपस्थित value से संतुष्ट नहीं हो सकता, इसलिए URL हटा दिया जाता है; एक exclusion केवल उसी को हटाता है जो positively मेल खाता है, इसलिए वह बच जाता है। --verbose इस विभाजन की रिपोर्ट करता है, और जब missing metadata पूरे result set का कारण होता है तो urx यह बताता है, भले ही -v न हो, क्योंकि अन्यथा एक cache hit एक खाली run को ऐसा target दिखा देता है जिसमें खोजने के लिए कुछ नहीं है।
Near-duplicates को Collapse करना
एक archive खुशी-खुशी /post/1 से /post/99999 तक लौटा देगा। ये एक ही endpoint हैं, और --dedup-similar इनके लिए एक पंक्ति प्रिंट करता है। एक path segment को data माना जाता है — route का हिस्सा नहीं — जब वह पूरी तरह से इनमें से एक हो:
- digits की एक श्रृंखला (
/post/1, /page/42)
- एक UUID (
/u/550e8400-e29b-41d4-a716-446655440000)
- एक 32/40/64-character hex digest (md5, sha1, sha256)
- एक separated date (
/blog/2024-01-02/)
- digits सहित एक लंबा mixed-case token (session ids, signed blobs)
जो segments केवल digits रखते हैं वे अपनी जगह रहते हैं, इसलिए /api/v1/ और /api/v2/ अभी भी दो endpoints हैं, और एक lower-case slug prose है, token नहीं। Query strings को केवल parameter names से grouped किया जाता है: ?q=cats&page=1 और ?q=dogs&page=7 collapse हो जाते हैं, जबकि अकेला ?q=cats नहीं होता — एक parameter हटाना request को बदल देता है।
प्रत्येक group का survivor उसका lexicographically सबसे छोटा URL होता है, इसलिए एक ही data पर दो runs एक ही चीज़ प्रिंट करते हैं। --verbose बताता है कि कितने URLs collapse किए गए। यह option --normalize-url और --merge-endpoint से स्वतंत्र है और किसी के साथ भी combine होता है; तीनों को पूरा result set चाहिए, इसलिए इनमें से कोई भी --stream के साथ काम नहीं करता।
Parameter और Fuzz Views
--show-only-param केवल प्रत्येक URL से query string काट देता है, जो उस पहले सवाल का जवाब नहीं दे सकता जो एक tester पूछता है: यह target कौन से parameters लेता है? तीन views इसका जवाब देते हैं, जो उसी grouping पर बने हैं जो --dedup-similar उपयोग करता है।```console
$ urx example.com --params
page
q
ref
sort
utm_source
$ urx example.com --params-by-endpoint
https://example.com/post/{id} ref,utm_source
https://example.com/search page,q,sort
$ urx example.com --fuzz-placeholder FUZZ
https://example.com/post/1?ref=FUZZ
https://example.com/post/2?utm_source=FUZZ
https://example.com/search?q=FUZZ&page=FUZZ
https://example.com/search?q=FUZZ&sort=FUZZ
`--params-by-endpoint` id जैसे दिखने वाले path segments को ठीक वैसे ही `{id}` में बदल देता है जैसे
`--dedup-similar` करता है, और endpoint को पूरा लिखता है क्योंकि urx आमतौर पर एक ही run में कई hosts को scan करता है। `--fuzz-placeholder` प्रत्येक parameter signature के लिए एक URL रखता है और उसका वास्तविक path बनाए रखता है — एक `{id}` route नहीं करेगा — इसलिए output सीधे एक fuzzer में जाता है:```bash
urx example.com --fuzz-placeholder FUZZ | ffuf -w - -u FUZZ
urx example.com --fuzz-placeholder FUZZ | dalfox pipe
तीनों को पूरा परिणाम सेट चाहिए, इसलिए वे केवल-बैच हैं और एक-दूसरे के साथ तथा --show-only-* दृश्यों के साथ परस्पर अनन्य हैं।
वर्डलिस्ट आउटपुट
-f wordlist एक रन को लक्ष्य-विशिष्ट वर्डलिस्ट में बदल देता है: हर पथ खंड
और क्वेरी पैरामीटर नाम जो उसने देखा, पूरे रन में डुप्लिकेट हटाकर और क्रमबद्ध,
प्रति पंक्ति एक शब्द।```bash
urx example.com --subs -f wordlist -o words.txt
ffuf -w words.txt -u https://example.com/FUZZ
जो सेगमेंट रूट नामों की तरह नहीं बल्कि डेटा की तरह दिखते हैं, उन्हें छोड़ दिया जाता है, और `--dedup-similar` समूहों को फिर से उपयोग करते हुए — `4711`, UUIDs, तारीखों और सेशन टोकनों से भरी वर्डलिस्ट, बिना वर्डलिस्ट के भी बदतर है, क्योंकि उनमें से हर शब्द ठीक एक ही टारगेट पर मौजूद होता है। जिस सेगमेंट का स्टेम एक आइडेंटिफायर हो, वह भी छोड़ दिया जाता है (`article-1234.html`)। केस संरक्षित रहता है: अधिकांश ओरिजिन पर पाथ सेगमेंट केस-सेंसिटिव होते हैं, इसलिए `WebResource.axd` को लोअर-केस करने पर ऐसा शब्द बनेगा जो जहाँ भी आज़माया जाएगा वहाँ 404 देगा। यूनियन पूरे सेट पर लेनी होती है, इसलिए फ़ॉर्मेट बैच-ओनली है।
### स्ट्रीमिंग आउटपुट
डिफ़ॉल्ट रूप से urx सब कुछ इकट्ठा करता है, फिर फ़िल्टर करता है, सॉर्ट करता है, और एक बार प्रिंट करता है। किसी बड़े टारगेट पर इसका मतलब है कि सबसे धीमे आर्काइव के पूरा होने तक कोई आउटपुट नहीं मिलेगा। `--stream` हर URL को उसी क्षण लिख देता है जब उसे रिपोर्ट करने वाला प्रोवाइडर वापस आता है:```bash
# Matches start appearing immediately instead of after the slowest provider
urx big-target.com --stream | grep admin
# Line-delimited JSON stays valid while it is still being written
urx big-target.com --stream -f jsonl | jq -r 'select(.url | test("/api/")) | .url'
स्ट्रीम किए गए URL बैच रन के समान ही फ़िल्टर से गुज़रते हैं और अभी भी
डुप्लिकेट हटाए जाते हैं। दो चीज़ें भिन्न हैं:
- क्रम। परिणाम प्रदाता-पूर्णता क्रम में आते हैं, इसलिए आउटपुट
अक्रमित होता है। यदि आपको क्रम चाहिए तो
sort के माध्यम से पाइप करें।
- दायरा। जिन विकल्पों को पूर्ण परिणाम सेट की आवश्यकता होती है, उन्हें
शुरुआत में ही अस्वीकार कर दिया जाता है (प्रत्येक का नाम लेते हुए संदेश के साथ):
--merge-endpoint, --dedup-similar,
--check-status /
--include-status / --exclude-status, --extract-links,
--extract-js-endpoints, --archive-body, --expand-specs,
--incremental, --show-sources, --show-meta, --meta-* फ़िल्टर,
--params, --params-by-endpoint, --fuzz-placeholder, --output-dir, और
--files। कैशिंग को बायपास किया जाता है;
--format json को jsonl के पक्ष में अस्वीकार कर दिया जाता है क्योंकि एक JSON ऐरे को
यह जानना होता है कि कौन सी प्रविष्टि अंतिम है, और --format wordlist को क्योंकि कोई भी शब्द
तब तक नया नहीं माना जा सकता जब तक हर URL न आ जाए।
चूँकि इस मोड में बैच परिणाम मैप कभी भरा नहीं जाता, एक स्ट्रीम किया गया रन
मेमोरी में भी बहुत कम रखता है — केवल पहले से लिखे गए URL का डीडुप सेट।
आर्काइव कैप्चर मेटाडेटा
एक CDX इंडेक्स URL से अधिक रिकॉर्ड करता है: प्रत्येक कैप्चर में एक टाइमस्टैम्प, आर्काइव द्वारा देखा गया
MIME प्रकार और HTTP स्थिति, और बॉडी का एक डाइजेस्ट होता है। urx यह सब रखता है, इसलिए CDX-समर्थित प्रदाता — wayback, cc, arquivo, और कोई भी
--cdx-endpoint — प्रत्येक URL को इनके साथ रिपोर्ट करते हैं:
फ़ील्ड अर्थ first_seenसबसे पुराना कैप्चर टाइमस्टैम्प, 14-अंकीय CDX रूप (YYYYMMDDhhmmss) last_seenसबसे नया कैप्चर टाइमस्टैम्प mimeसबसे हाल के कैप्चर का MIME प्रकार जिसने इसे रिकॉर्ड किया archive_statusकैप्चर के समय आर्काइव द्वारा रिकॉर्ड की गई HTTP स्थिति digestकैप्चर के दौरान एक प्रतिनिधि सामग्री डाइजेस्ट
archive_status status नहीं है: status केवल --check-status के अंतर्गत प्रकट होता है,
जो URL को अभी लाइव पुनः-अनुरोध करता है, जबकि archive_status वह है जो क्रॉलर को
पृष्ठ कैप्चर करते समय मिला था। एक URL पूरी तरह से archive_status
200 हो सकता है और आज मृत हो सकता है।
जहाँ एक ही URL कई कैप्चर या कई आर्काइव से आता है, वहाँ मान
मर्ज किए जाते हैं: first_seen सबसे पुराना टाइमस्टैम्प है जो किसी ने रिपोर्ट किया, last_seen
सबसे नया, और mime/archive_status सबसे हाल के कैप्चर से आते हैं जिसमें वे थे। बिना कैप्चर इंडेक्स वाले प्रदाता (otx, vt, urlscan, zoomeye,
github, bevigil, robots, sitemap, और --files इनपुट) केवल URL
रिपोर्ट करते हैं — उनके लिए कोई मान नहीं गढ़े जाते।
मेटाडेटा कैसे प्रकट होता है यह प्रारूप पर निर्भर करता है:
json / jsonl — प्रत्येक फ़ील्ड एक कुंजी के रूप में प्रकट होता है जब उसका मान होता है और
पूरी तरह से छोड़ दिया जाता है जब नहीं होता, बिल्कुल sources की तरह।csv — एक कॉलम केवल तब जोड़ा जाता है जब कम से कम एक पंक्ति में उसका मान हो,
इसलिए बिना मेटाडेटा वाला रन अभी भी एकल url कॉलम उत्पन्न करता है।- सादा पाठ — डिफ़ॉल्ट रूप से अपरिवर्तित, प्रति पंक्ति एक नंगा URL, इसलिए मौजूदा
पाइपलाइनें काम करती रहती हैं। फ़ील्ड जोड़ने के लिए
--show-meta पास करें।```bash
Rich records: when the URL was alive, and what it served
urx example.com --providers wayback -f jsonl
{"url":"https://example.com/old.php","first_seen":"20040112093000",
"last_seen":"20180722140311","mime":"text/html","archive_status":"200",
"digest":"HT2DYGA5UKZCPBSFVCV3JOBXGW2G5UUA"}
Triage by age: everything last captured before 2010
urx example.com -f jsonl | jq -r 'select(.last_seen < "20100101000000") | .url'
Opt plain output into the metadata
urx example.com --providers wayback --show-meta
स्ट्रीमिंग (`--stream`) केवल URLs रिपोर्ट करता है। एक URL पहली बार देखे जाने पर प्रिंट होता है, उन कैप्चरों के आने से पहले जो उसकी `first_seen`/`last_seen` रेंज को विस्तृत करते, इसलिए `--show-meta` वहाँ उसी कारण अस्वीकार किया जाता है जिस कारण `--show-sources`।
एक कैश हिट में भी कोई मेटाडेटा नहीं होता: कैश URLs संग्रहीत करता है, इसलिए कैश से सर्व किया गया डोमेन अपने URLs को कैप्चर फ़ील्ड के बिना रिपोर्ट करता है। उन्हें पुनः भरने वाले रन के लिए `--no-cache` का उपयोग करें (या TTL की प्रतीक्षा करें)।
### लाइव रिस्पॉन्स मेटाडेटा
`--check-status` पहले से ही एक अनुरोध भेजता है और रिस्पॉन्स हेड की प्रतीक्षा करता है, इसलिए वह हेड जो कुछ भी ले जाता है वह मुफ़्त में आता है: `Location`, `Content-Length` और `Content-Type` स्टेटस कोड के साथ रिकॉर्ड किए जाते हैं। रीडायरेक्ट्स अभी भी कभी फॉलो नहीं किए जाते, इसलिए रिपोर्ट किया गया स्टेटस हमेशा उस URL से संबंधित होता है जो माँगा गया था और `location` बस बताता है कि 3xx कहाँ इंगित करता था।
`--check-title` HTML `<title>` जोड़ता है। यह एकमात्र फ़ील्ड है जो मुफ़्त नहीं है — एक टाइटल के लिए रिस्पॉन्स बॉडी चाहिए — इसलिए यह अपने स्वयं के फ़्लैग के पीछे बैठता है। रीड दो बार सीमित है (अधिकतम 64 KiB, और यह क्लोज़िंग टैग पर रुक जाता है) और उस बॉडी के लिए पूरी तरह छोड़ दिया जाता है जिसे सर्वर ने गैर-HTML घोषित किया है, इसलिए एक JSON API या एक इमेज की कोई लागत नहीं होती। टाइटल को व्हाइटस्पेस-कोलैप्स्ड, एंटिटी-डिकोडेड और 200 अक्षरों तक काटा जाता है। `--check-title` का अर्थ `--check-status` भी है।```bash
urx example.com --check-status -f jsonl
urx example.com --check-title --show-meta
urx example.com --check-status --is 30x -f jsonl | jq -r '.url + " -> " + .location'
Exposure उस नियम का पालन करता है जो archive metadata पहले से तय करता है: json/jsonl/csv
हमेशा फ़ील्ड्स ले जाते हैं (अनुपस्थित keys छोड़ दी जाती हैं, और CSV कॉलम मौजूदा
कॉलम के बाद जोड़े जाते हैं), जबकि plain text प्रति पंक्ति एक बेयर URL रहता है
जब तक --show-meta अन्यथा न कहे। Plain output में title quoted होता है, क्योंकि
यह एकमात्र ऐसा मान है जिसमें आमतौर पर spaces होते हैं।
Authenticated और Custom Requests
--check-status, --extract-links, --extract-js-endpoints और
--expand-specs सभी एकत्र किए गए URLs को target से ही दोबारा request करते हैं। -H
उन requests को वे सभी headers देता है जिनकी उन्हें आवश्यकता होती है:```bash
urx example.com --check-status -H "Authorization: Bearer $TOKEN"
urx example.com --extract-links --cookie "session=abc; role=admin"
urx example.com --check-status --user-agent "acme-security-scan/1.0"
`-H` दोहराया जा सकता है, `Name: value` लेता है, और एक विकृत हेडर रन को रोक देता है
बजाय इसके कि वह बिना ध्यान दिए चला जाए — एक तर्क जो चुपचाप छोड़ दिया जाता है, एक
अनाम स्कैन को प्रमाणित स्कैन के रूप में पढ़ा जाने देता है। `--cookie` और
`--user-agent` संबंधित हेडर के लिए शॉर्टहैंड हैं।
**ये हेडर कभी किसी आर्काइव तक नहीं पहुँचते।** ये केवल उन घटकों द्वारा भेजे जाते हैं
जो लक्ष्य से बात करते हैं: ऊपर दिए गए चार टेस्टर, साथ ही `robots` और
`sitemap` प्रोवाइडर, जो लक्ष्य से भी फ़ेच करते हैं। हर अन्य प्रोवाइडर
web.archive.org, index.commoncrawl.org या किसी तृतीय-पक्ष API को क्वेरी करता है, और
`--archive-body` भी ऐसा ही करता है जब यह किसी कैप्चर को रीप्ले करता है; उन्हें लक्ष्य का
सेशन कुकी सौंपना एक क्रेडेंशियल को ऐसी सेवा को मेल करना होगा जो जो प्राप्त करती है उसे रख लेती है,
बिना किसी लाभ के। आर्काइव क्वेरी urx का अपना User-Agent रखती हैं, जिसे
`--random-agent` अभी भी रोटेट करता है।
### आर्काइव किए गए रिस्पॉन्स बॉडीज़ की माइनिंग
`--extract-links` लाइव साइट से हर एकत्रित URL को फ़ेच करता है, जो उन पेजों को खोजने के लिए
बिल्कुल गलत जगह है जिनकी OSINT स्वीप को सबसे अधिक परवाह होती है:
वे जो अब मौजूद नहीं हैं। `--archive-body` इसके बजाय वे बॉडीज़ फ़ेच करता है जो Wayback
Machine ने संग्रहीत की थीं। हर एकत्रित URL के लिए जो कैप्चर टाइमस्टैम्प रखता है, urx
उस कैप्चर को उसके कच्चे रूप में रीप्ले करता है
(`https://web.archive.org/web/<timestamp>id_/<url>` — `id_` फ़्लैग Wayback
टूलबार और लिंक रीराइटिंग को बंद कर देता है, इसलिए बॉडी मूल बाइट्स है) और
उस पर वही लिंक एक्सट्रैक्शन चलाता है जो `--extract-links` उपयोग करता है।```bash
# Links from the archived bodies of everything the CDX providers found
urx example.com --archive-body
# Bound the run and pace it; the archive is one host no matter how many URLs
urx example.com --archive-body --archive-body-limit 200 --rate-limit 5
# Only the JavaScript those pages referenced back then
urx example.com --archive-body -e js
यह waymore की तुलना में बहुत कम अनुरोधों की आवश्यकता क्यों रखता है। प्रत्येक CDX पंक्ति एक
content digest ले जाती है, और समान digest वाले दो कैप्चर byte-for-byte
समान बॉडी होते हैं। अभिलेखागार इनसे भरे हुए हैं: किसी पृष्ठ का प्रत्येक ?utm_source= प्रकार, उसके / के बगल में प्रत्येक /index.html, प्रत्येक tracking-parameter क्रमचय
समान बाइट्स परोसता है, इसलिए दसियों हज़ार URLs की सूची नियमित रूप से
कुछ हज़ार भिन्न बॉडीज़ में सिमट जाती है। waymore को इसका कोई बोध नहीं है — यह
प्रति URL एक प्रतिक्रिया डाउनलोड करता है और मात्रा को एक कुंद
-l 5000 कैप के माध्यम से संभालता है, जो अभिलेखागार पर दबाव डालता है और कवरेज को काट देता है। urx
प्रत्येक digest को पहली बार देखे जाने पर दावा करता है और प्रत्येक बाद वाले URL को छोड़ देता है जो
समान बाइट्स को दोहराएगा, इसलिए समान कवरेज की लागत प्रति भिन्न बॉडी एक अनुरोध है। --archive-body-limit (डिफ़ॉल्ट 500) भिन्न बॉडीज़ को सीमित करता है,
URLs को नहीं; डुप्लिकेट कभी भी इसके विरुद्ध नहीं गिने जाते, और --verbose बताता है कि कितने
छोड़े गए।
संग्रहीत JavaScript की खनन। एक आधुनिक ऐप की API सतह उसके बंडलों में
स्ट्रिंग लिटरल के रूप में रहती है, और --extract-js-endpoints उन्हें लाइव
साइट से प्राप्त करता है — जहाँ वे अक्सर चले जाते हैं। बंडलों का नाम बिल्ड हैश द्वारा रखा जाता है, इसलिए
app.a3f9c2.js साइट के पुनः परिनियोजन के क्षण 404 हो जाता है, और उसके द्वारा नामित एंडपॉइंट्स
उसके साथ चले जाते हैं। दोनों फ्लैग्स को एक साथ चलाएँ और urx इसके बजाय संग्रहीत प्रति की खनन करता है, और एक संग्रहीत पृष्ठ के इनलाइन <script> ब्लॉक्स को उसके लिंक्स के साथ:```bash
urx example.com --archive-body --extract-js-endpoints
**बॉडीज़ को रखना।** अनुरोध पहले से ही किए जा रहे हैं, इसलिए बॉडीज़ को डिस्क पर लिखने में कोई अतिरिक्त लागत नहीं आती और उन सवालों के जवाब मिलते हैं जो कोई भी लिंक एक्सट्रैक्टर नहीं पूछता: `<!-- staging.internal -->` कमेंट, वह टोकन जिसे 2019 के बिल्ड ने इनलाइन किया था, फ्रेमवर्क वर्ज़न का नाम बताने वाला स्टैक ट्रेस।```bash
urx example.com --archive-body --archive-body-dir ./corpus
grep -ri "api[_-]key" ./corpus
प्रत्येक फ़ाइल का नाम उसके URL और उसके हैश के आधार पर रखा जाता है, और corpus/index.jsonl
प्रत्येक फ़ाइल को उसके URL, कैप्चर टाइमस्टैम्प, डाइजेस्ट और कंटेंट टाइप से मैप करता है।
केवल टेक्स्ट-जैसे बॉडीज़ संग्रहीत किए जाते हैं — HTML, स्क्रिप्ट, JSON, XML, CSS, सादा टेक्स्ट —
ताकि डायरेक्टरी साइट की इमेज और फ़ॉन्ट्स से न भर जाए। चूँकि
फ़ेच को डाइजेस्ट द्वारा डीडुप्लिकेट किया जाता है, कॉर्पस प्रति
अनुरोध लक्ष्य के कहीं अधिक हिस्से को कवर करता है, बजाय प्रति URL एक प्रतिक्रिया के।
जानने योग्य विवरण:
- केवल कैप्चर टाइमस्टैम्प वाले URL ही योग्य हैं। CDX प्रोवाइडर (
wayback,
cc, arquivo) एक प्रदान करते हैं; --files इनपुट, गैर-CDX प्रोवाइडर, और कैश्ड
परिणाम (कैश केवल URL संग्रहीत करता है) में कोई नहीं होता। urx यह बताता है जब रीप्ले करने के लिए
कुछ नहीं होता — ताज़ा कैप्चर पाने के लिए --no-cache पास करें।
- प्रत्येक URL का नवीनतम कैप्चर रीप्ले किया जाता है। किसी अन्य
आर्काइव द्वारा रिपोर्ट किया गया टाइमस्टैम्प निकटतम Wayback कैप्चर पर पड़ता है; जिस URL को Wayback Machine ने कभी
नहीं देखा वह 404 उत्तर देता है और छोड़ दिया जाता है। आर्काइव द्वारा त्रुटियों के रूप में दर्ज किए गए कैप्चर
माइन नहीं किए जाते, ठीक वैसे ही जैसे
--extract-links लाइव त्रुटि पृष्ठों को अनदेखा करता है।
- खोजे गए लिंक उन्हीं फ़िल्टर, होस्ट वैलिडेशन, और आउटपुट
ट्रांसफ़ॉर्म से गुज़रते हैं जैसे बाकी सब कुछ, और प्रत्येक बॉडी 10 MiB पर सीमित होती है।
--rate-limit, --rate-limit-by wayback=N, --parallel, --proxy,
--timeout, और --retries सभी रीप्ले अनुरोधों पर लागू होते हैं।--stream के साथ असंगत, जैसे कि संग्रह के बाद चलने वाला प्रत्येक विकल्प।
API स्पेसिफिकेशन्स का विस्तार
एक -p only-api स्वीप /swagger.json, /openapi.yaml और /v3/api-docs ढूँढता है
और फिर उन्हें कभी नहीं खोलता: --extract-links HTML पार्स करता है, --extract-js-endpoints
application/json बॉडीज़ को छोड़ देता है, और --archive-body आर्काइव जो भी लौटाता है उस पर HTML पार्सर चलाता है। --expand-specs उन्हें पढ़ता है और उनके द्वारा वर्णित प्रत्येक रूट को
परिणाम सेट में विस्तारित करता है — एक अनुरोध पूरी प्रलेखित
सतह खरीद लेता है, सटीक और पहले से पैरामीटरयुक्त।```bash
urx example.com -p only-api --expand-specs
urx example.com --expand-specs --max-spec-files 10 --rate-limit 2
Recover an API the live host no longer serves: read the archived document
urx example.com --archive-body --expand-specs
क्या विस्तारित होता है:
* **OpenAPI 3.x** — `servers[].url` (निरपेक्ष, दस्तावेज़-सापेक्ष, और टेम्पलेटेड,
`{var}` के साथ `variables[var].default` या पहले `enum` मान से हल किया गया)
हर `paths` कुंजी के साथ मिलाया गया; एक path item का अपना `servers` दस्तावेज़ के
`servers` को ओवरराइड करता है।
* **Swagger 2.0** — `schemes` × `host` + `basePath`, प्रत्येक भाग दस्तावेज़ के अपने URL के
संगत भाग पर वापस आ जाता है। `ws`/`wss` हटा दिए जाते हैं।
* **GraphQL introspection** — प्रत्येक query, mutation और subscription
फ़ील्ड के लिए एक URL, endpoint के साथ `?query=…` के रूप में लिखा गया। एक फ़ाइल के रूप में सहेजी गई schema
अपने endpoint पर हल होती है (`/graphql/schema.json` → `/graphql`)।
JSON और YAML दोनों पढ़े जाते हैं। लक्ष्य पहले नाम से और मुफ़्त में चुने जाते हैं (एक
spec-marker substring — `swagger`, `openapi`, `api-docs`, `graphql`,
`introspection` — साथ ही एक `json`/`yaml`/`yml` एक्सटेंशन जब कोई हो, इसलिए
`swagger-ui.html` कोई अनुरोध खर्च नहीं करता), फिर प्रतिक्रिया के `Content-Type` से। Path
टेम्पलेट वैसे ही उत्सर्जित होते हैं जैसे दस्तावेज़ उन्हें लिखता है (`/users/{id}`, न कि
`/users/%7Bid%7D`)। Bodies 10 MiB पर सीमित हैं, और 32 से अधिक alias संदर्भों वाला एक YAML दस्तावेज़
पार्सिंग से पहले अस्वीकार कर दिया जाता है ताकि expansion bombs को रोका जा सके।
`--max-spec-files` (डिफ़ॉल्ट 50) प्राप्त किए गए दस्तावेज़ों को सीमित करता है। साथ में
`--archive-body` भी चालू होने पर, एक संग्रहीत specification बिना किसी अतिरिक्त
अनुरोध लागत के एक के रूप में पढ़ी जाती है — body पहले से ही प्राप्त की जा रही थी।
### संग्रहीत robots.txt और sitemap.xml
`robots` और `sitemap` प्रदाता *लाइव* फ़ाइलें पढ़ते हैं, जो केवल बताती हैं कि कोई
साइट आज क्या छिपाती है या सूचीबद्ध करती है। `--archived-discovery` उन फ़ाइलों के प्रत्येक भिन्न
संस्करण को भी पढ़ता है जो Wayback Machine ने संग्रहीत किए हैं। 2015 का एक `Disallow:` उन paths के नाम देता है जिनका उल्लेख साइट ने तब से बंद कर दिया है — अक्सर इसलिए कि उन्हें भुला दिया जाना था, न कि इसलिए कि वे चले गए हैं — और एक पुराना sitemap वह सब कुछ सूचीबद्ध करता है जिसे साइट कभी crawl कराना चाहती थी।```bash
# Every archived version of robots.txt and sitemap.xml, alongside the live ones
urx example.com --archived-discovery
# Bound it and pace it; both archived providers answer to --rate-limit-by
urx example.com --archived-discovery --archived-discovery-limit 20 --rate-limit-by robots=2,sitemap=2
# Only the versions captured in a given era
urx example.com --archived-discovery --from 2014 --to 2016
यह कैसे काम करता है, और यह सस्ता क्यों है:
- किसी दस्तावेज़ के संस्करणों को प्रति फ़ाइल एक CDX क्वेरी के साथ सूचीबद्ध किया जाता है
(
robots.txt, sitemap.xml, sitemap_index.xml, sitemap.txt), collapse=digest का उपयोग करते हुए
ताकि एक ही बाइट्स परोसने वाले लगातार कैप्चर एक पंक्ति में मिल जाएँ। केवल उन पंक्तियों को माँगा जाता है जो
सफलता के रूप में दर्ज हैं: इंडेक्स www. और apex को एक लिस्टिंग में मिला देता है, और उनकी
इंटरलीव्ड 301/200 पंक्तियाँ अन्यथा collapse को विफल कर देती हैं — github.com/robots.txt के लिए यह
फ़िल्टर के बिना 325k पंक्तियाँ हैं और इसके साथ 14k, उन्हीं 107 विशिष्ट संस्करणों के लिए।
- प्रत्येक विशिष्ट संस्करण को कच्चे रूप में रीप्ले किया जाता है (
/web/<timestamp>id_/…) और
लाइव फ़ाइल के समान पार्सर को सौंपा जाता है। कोई दूसरा पार्सर नहीं: 2015 का robots.txt उन्हीं
नियमों द्वारा पढ़ा जाता है जिनसे वर्तमान वाला, जिसमें absolute-path और pattern-skipping गार्ड भी शामिल हैं।
एक संग्रहीत <sitemapindex> को उसी क्षण के अनुसार उसके चिल्ड्रन में फ़ॉलो किया जाता है।
- संग्रह द्वारा त्रुटियों के रूप में दर्ज कैप्चर (github.com का robots.txt 2007 के एक हिस्से के लिए 401 था)
बिना किसी अनुरोध के छोड़ दिए जाते हैं और केवल
--verbose के अंतर्गत रिपोर्ट किए जाते हैं।
--archived-discovery-limit (डिफ़ॉल्ट 50) प्रत्येक संग्रहीत प्रदाता द्वारा प्रति डोमेन लाए गए दस्तावेज़ों को
सीमित करता है, नवीनतम संस्करण पहले; नेस्टेड साइटमैप भी गिने जाते हैं। --verbose बताता है कि कब
सीमा ने सूची को छोटा कर दिया।- संग्रहीत वेरिएंट अपने स्वयं के प्रदाता इंस्टेंस के रूप में चलते हैं —
--stats और --show-sources में
"Robots.txt (archived)" और "Sitemap (archived)" — लेकिन मौजूदा robots / sitemap आईडी के अंतर्गत,
इसलिए --exclude-robots, --exclude-sitemap, और --rate-limit-by robots=N लाइव और संग्रहीत दोनों
रीड्स को नियंत्रित करते हैं। --from / --to यह सीमित करते हैं कि कौन से संस्करण विचारित किए जाएँ।
--stream के साथ काम करता है; यह किसी भी अन्य की तरह एक प्रदाता है।
Archive-side Filtering
--archive-status, --archive-mime, --from, और --to का मूल्यांकन urx के बजाय
संग्रह के CDX इंडेक्स द्वारा किया जाता है। दो परिणाम जानने योग्य हैं:
- वे केवल CDX-समर्थित प्रदाताओं पर लागू होते हैं —
wayback, cc, arquivo, और
कोई भी --cdx-endpoint। अन्य प्रदाता उन्हें अनदेखा करते हैं; जब कोई भी सक्षम न हो तो urx चेतावनी देता है।
- संग्रह एक ही फ़िल्टर डायलेक्ट साझा नहीं करते। Wayback Machine (और कोई भी
--cdx-dialect classic एंडपॉइंट) मानों को रेगुलर एक्सप्रेशन के रूप में मानता है, इसलिए
--archive-status "30." किसी भी 3xx से मेल खाता है। Common Crawl, Arquivo.pt और pywb
एंडपॉइंट बिल्कुल मेल खाते हैं, और उनका इंडेक्स दोहराए गए फ़िल्टर को AND करता है —
इसलिए --archive-status 200,301 जैसी मल्टी-वैल्यू पॉज़िटिव सूची वहाँ असंतोषजनक है। urx उन प्रदाताओं के लिए
उस फ़िल्टर को छोड़ देता है (चेतावनी के साथ) बजाय ऐसी क्वेरी भेजने के जो खाली लौटेगी। मल्टी-वैल्यू
exclusions का अर्थ है "यह नहीं और वह नहीं" और यह हर जगह काम करता है।
--archive-status का उपयोग तब करें जब आप चाहते हैं कि संग्रह ने क्रॉल के समय क्या दर्ज किया और
--check-status / --include-status तब जब आप लक्ष्य की स्थिति अभी चाहते हैं;
बाद वाला हर URL को फिर से अनुरोध करता है।
Custom CDX Endpoints
pywb, OutbackCDX, या Internet Archive के CDX सर्वर पर बनाया गया प्रत्येक वेब संग्रह
समान क्वेरी API उजागर करता है। प्रति संग्रह एक प्रदाता को हार्डकोड करने के बजाय,
--cdx-endpoint URL किसी भी ऐसे सर्वर को मौके पर ही प्रदाता बना देता है:```bash
The Icelandic web archive, alongside the default providers
urx example.is --cdx-endpoint https://vefsafn.is/cdx
Several at once; each gets its own progress line, stats row and rate limit
urx example.com --cdx-endpoint https://vefsafn.is/cdx --cdx-endpoint http://localhost:8080/cdx
--rate-limit-by cdx:vefsafn.is=1
* प्रोवाइडर आईडी `cdx:<host>` (`cdx:vefsafn.is`) है, जिसका उपयोग
`--exclude-providers`, `--rate-limit-by`, `--stats` और `--show-sources` करते हैं।
किसी एंडपॉइंट का नाम देने से वह सक्षम हो जाता है; किसी `--providers` प्रविष्टि की आवश्यकता नहीं होती, और
`--providers cdx:vefsafn.is` इसे अकेले चलाता है। `--list-providers` उसी कमांड लाइन पर
नामित एंडपॉइंट्स को उन आईडी के साथ दिखाता है जिनसे वे चलेंगे।
* बिल्ट-इन CDX प्रोवाइडर जो कुछ भी मानते हैं, वह सब यहाँ भी लागू होता है: `--subs`,
`--from`/`--to`, `--archive-*` फ़िल्टर, पेजिनेशन, `--rate-limit`, और
ऊपर वर्णित कैप्चर मेटाडेटा।
* `--cdx-dialect classic|pywb` सर्वर की डायलेक्ट का नाम देता है (फ़ील्ड नाम, फ़िल्टर
सेमांटिक्स, रो फ़ॉर्मेट और पेजिनेशन स्कीम सभी इसी से तय होते हैं — देखें
"Archive-side Filtering")। अनसेट छोड़ने पर, urx प्रति रन एक बार एंडपॉइंट की जाँच करता है
और `pywb` पर वापस आ जाता है, जो अधिक सामान्य डायलेक्ट है; जब प्रोब बता न सके (उदाहरण के लिए,
किसी अज्ञात डोमेन के लिए खाली उत्तर) तो इसे स्पष्ट रूप से सेट करें।
* कॉन्फ़िग फ़ाइल में भी सेट किया जा सकता है (`cdx_endpoint = [...]`, `cdx_dialect`)।
**सत्यापित एंडपॉइंट्स।** इस लेखन के समय, एंड-टू-एंड काम करने के लिए पुष्टि किया गया एकमात्र सार्वजनिक एंडपॉइंट
`https://vefsafn.is/cdx` है (Landsbókasafn का आइसलैंडिक वेब आर्काइव, pywb डायलेक्ट)। इसके बारे में दो बातें जानने योग्य हैं: यह `limit`, `page`
और `showNumPages` को अनदेखा करता है और हर क्वेरी के लिए पूरा परिणाम सेट लौटाता है, जिसे
urx संभालता है; और कुछ अनुरोधों के बाद यह Anubis-शैली के बॉट-प्रोटेक्शन पेज ("Session Verification") के साथ उत्तर देना शुरू कर सकता है। urx CDX पंक्तियों के स्थान पर HTML उत्तर का पता लगाता है
और इसे एंडपॉइंट का नाम लेते हुए प्रोवाइडर त्रुटि के रूप में रिपोर्ट करता है — इसे कभी "no URLs" के रूप में नहीं गिना जाता। यदि आप इससे टकराते हैं, तो
`--rate-limit-by cdx:vefsafn.is=1` के साथ धीमा करें या बाद में पुनः प्रयास करें।
**ज्ञात है कि काम नहीं करते।** UK Web Archive (`webarchive.org.uk`), Library of
Congress web archive (`webarchive.loc.gov`), Bibliotheca Alexandrina, और
National Library of Australia (`web.archive.org.au`) सभी बॉट
प्रोटेक्शन या रीडायरेक्ट के पीछे हैं जो कमांड-लाइन क्लाइंट से उनके CDX API को ब्लॉक करते हैं।
urx इसके आसपास काम करने का प्रयास नहीं करता, इसलिए `--cdx-endpoint` को उन पर इंगित करने से
ऊपर वाली HTML-उत्तर त्रुटि मिलती है।
### कैशिंग और इंक्रीमेंटल स्कैनिंग
Urx बार-बार किए जाने वाले स्कैन के लिए प्रदर्शन सुधारने हेतु कैशिंग और केवल नए URL खोजने के लिए इंक्रीमेंटल स्कैनिंग का समर्थन करता है।```bash
# Enable caching with SQLite (default)
urx example.com --cache-type sqlite --cache-path ~/.urx/cache.db
# Use Redis for distributed caching
urx example.com --cache-type redis --redis-url redis://localhost:6379
# Incremental scanning - only show new URLs since last scan
urx example.com --incremental
# Set cache TTL (time-to-live) to 12 hours
urx example.com --cache-ttl 43200
# Disable caching entirely
urx example.com --no-cache
# Combine incremental scanning with filters
urx example.com --incremental -e js,php --patterns api
# Configuration file with caching settings
urx -c example/config.toml example.com
कैश का प्रबंधन
urx cache डेटाबेस को मैन्युअल रूप से छुए बिना कैश का निरीक्षण और रखरखाव करता है। प्रत्येक सबकमांड वही --cache-type, --cache-path, --redis-url और --cache-ttl का पालन करता है जो एक स्कैन करता है, और सभी पाँचों दोनों बैकएंड्स पर काम करते हैं।```bash
urx cache stats # entries, domains, URLs, age span, size, expired count
urx cache list # per-domain counts, last scan, TTL remaining
urx cache list --domain '*.example.com'
urx cache prune # delete only what --cache-ttl has expired
urx cache drop example.com # rescan one target without clearing the rest
urx cache clear --yes # delete everything
machine-readable
urx cache stats -f json | jq '.expired_entries'
डोमेन मिलान केस-असंवेदनशील और **सटीक** होता है जब तक कि पैटर्न में
`*` न हो — एक सबस्ट्रिंग डिफ़ॉल्ट की वजह से `drop example.com` `notexample.com` को भी हटा देता। `clear` हटाने से पहले पूछता है और उत्तर मान लेने के बजाय गैर-इंटरैक्टिव stdin से इनकार कर देता है, `drop` किसी भी ऐसे पैटर्न का नाम बताता है जो किसी से मेल नहीं खाया, कैश को देखने से कभी कैश नहीं बनता, और Redis को ब्लॉकिंग `KEYS` के बजाय `SCAN` से साफ़ किया जाता है (`--redis-url` में कोई भी पासवर्ड प्रिंट होने से पहले रिडैक्ट कर दिया जाता है)।
#### कैशिंग उपयोग के मामले```bash
# Daily monitoring - only alert on new URLs (built-in webhook, see below)
urx target.com --incremental --silent --notify https://hooks.slack.com/services/... --notify-format slack
# ...or hand the new URLs to an external notifier
urx target.com --incremental --silent | notify-tool
# Efficient domain lists processing
cat domains.txt | urx --incremental --cache-ttl 3600 > new_urls.txt
# Distributed team scanning with Redis
urx example.com --cache-type redis --redis-url redis://shared-cache:6379
# Fast re-scans during development
urx test-domain.com --cache-ttl 300 # 5-minute cache for rapid iterations
Webhook सूचनाएँ
--notify <URL> रन समाप्त होने पर रन का सारांश एक webhook पर POST करता है,
जो --incremental को एक मॉनिटर में बदल देता है: इसे cron में डालें और webhook
केवल तब सक्रिय होगा जब कुछ नया दिखाई देगा।```bash
Slack incoming webhook, only when the run finds new URLs (the default)
urx target.com --incremental --silent
--notify https://hooks.slack.com/services/T000/B000/XXXX --notify-format slack
Discord, and send even when nothing is new
urx target.com --incremental --notify "$DISCORD_HOOK" --notify-format discord --notify-on always
Several receivers, urx's own JSON schema (the default format)
urx target.com --incremental --notify https://n8n.example/hook --notify https://ntfy.example/urx
Keep the webhook out of the shell history
export URX_NOTIFY_URL=https://hooks.slack.com/services/...
urx target.com --incremental --notify-format slack
- `--notify-on` डिफ़ॉल्ट रूप से `new` होता है: जब रन शून्य URL उत्सर्जित करता है तो कुछ भी नहीं भेजा जाता, इसलिए एक शांत cron रन शांत रहता है। `always` बिना किसी शर्त के भेजता है; `never` कॉन्फ़िगरेशन को बनाए रखता है लेकिन भेजना अक्षम कर देता है।
- `--notify-format json` (डिफ़ॉल्ट) urx का स्कीमा भेजता है: `domains`, `incremental`, `url_count`, `new_url_count`, `elapsed_ms`, एक प्रति-प्रदाता `providers` सूची (वही संख्याएँ जो `--stats` प्रिंट करता है), और अधिकतम 20 उत्सर्जित URL का एक `sample` जिसमें अधिक मिलने पर `sample_truncated` सेट होता है। `slack` `{"text": ...}` भेजता है और `discord` `{"content": ...}` एक छोटे मानव-पठनीय संदेश के साथ भेजता है; सेवा द्वारा अनुमत से लंबे संदेशों को एक पंक्ति सीमा पर काट दिया जाता है और `[truncated: N lines cut ...]` के साथ समाप्त होते हैं।
- डिलीवरी कभी भी exit कोड नहीं बदलती। वेबहुक कॉल होने तक URL पहले से ही stdout पर या `--output` में होते हैं, इसलिए एक मृत वेबहुक stderr पर एक चेतावनी है और रन अभी भी 0 पर exit करता है। `--verbose` प्रतिक्रिया स्थिति दिखाता है।
- वेबहुक URL एक क्रेडेंशियल है। urx कभी भी इसके स्कीम और होस्ट से अधिक नहीं प्रिंट करता — न `--verbose` में, न चेतावनियों में, न `--stats` में। इसे चेक-इन किए गए कॉन्फ़िग से बाहर रखने के लिए, इसे `URX_NOTIFY_URL` में या प्रदाता-कॉन्फ़िग फ़ाइल में `notify_url` के रूप में रखें; मुख्य कॉन्फ़िग में `[notify].url` भी काम करता है। प्राथमिकता CLI/env > provider-config > main config है।
- अनुरोध `--proxy`, `--proxy-auth`, `--timeout` और `--insecure` का पालन करता है। `--network-scope` लागू नहीं होता: यह लक्ष्य और अभिलेखागारों की ओर निर्देशित ट्रैफ़िक को विभाजित करता है, और वेबहुक आपका स्वयं का एंडपॉइंट है।
- `--silent` अभी भी भेजता है (यही मुख्य उपयोग मामला है); यह केवल डायग्नोस्टिक्स छिपाता है।
## अन्य टूल्स के साथ एकीकरण
Urx अन्य सुरक्षा और रेकॉनिसेंस टूल्स के साथ पाइपलाइनों में अच्छी तरह काम करता है:```bash
# Find domains, then discover URLs
echo "example.com" | urx | grep "login" > potential_targets.txt
# Combine with other tools
cat domains.txt | urx --patterns api | other-tool
प्रेरणा
Urx gau (GetAllUrls) से प्रेरित था, जो AlienVault के Open Threat Exchange, Wayback Machine, और Common Crawl से ज्ञात URLs प्राप्त करने वाला एक टूल है। समान मूल कार्यक्षमता साझा करते हुए, Urx को Rust में शुरू से बनाया गया था, जिसमें प्रदर्शन, समवर्तीता (concurrency), और विस्तारित फ़िल्टरिंग क्षमताओं पर ध्यान केंद्रित किया गया था।
योगदान करें
Urx एक ओपन-सोर्स प्रोजेक्ट है और इसे ❤️ के साथ बनाया गया है
यदि आप इस प्रोजेक्ट में योगदान देना चाहते हैं, तो कृपया CONTRIBUTING.md देखें और अपनी शानदार सामग्री के साथ Pull-Request करें।

