 edoardottt/cariddi
डोमेन की एक सूची लें, urls क्रॉल करें और endpoints, secrets, api keys, file extensions, tokens और अधिक के लिए स्कैन करें

डोमेन की एक सूची लें, URL क्रॉल करें और एंडपॉइंट, सीक्रेट, API कुंजियाँ, फ़ाइल एक्सटेंशन, टोकन और बहुत कुछ के लिए स्कैन करें

edoardottt द्वारा 💙 के साथ कोडित
Share on Twitter!
Install • Usage • Get Started • Changelog • Contributing • License
brew install cariddi
sudo snap install cariddi
go install -v github.com/edoardottt/cariddi/cmd/cariddi@latest
pacman -Syu cariddi
nix-shell -p cariddi
आपको Go (>=1.24.0) की आवश्यकता होगी
git clone https://github.com/edoardottt/cariddi.git
cd cariddi
go get ./...
make linux # (to install)
make unlinux # (to uninstall)
वन-लाइनर: git clone https://github.com/edoardottt/cariddi.git && cd cariddi && go get ./... && make linux
ध्यान दें कि executable केवल cariddi फ़ोल्डर में ही काम करता है।
git clone https://github.com/edoardottt/cariddi.git
cd cariddi
go get ./...
.\make.bat windows # (to install)
.\make.bat unwindows # (to uninstall)
यदि आप केवल एक ही लक्ष्य को स्कैन करना चाहते हैं तो आप उपयोग कर सकते हैं
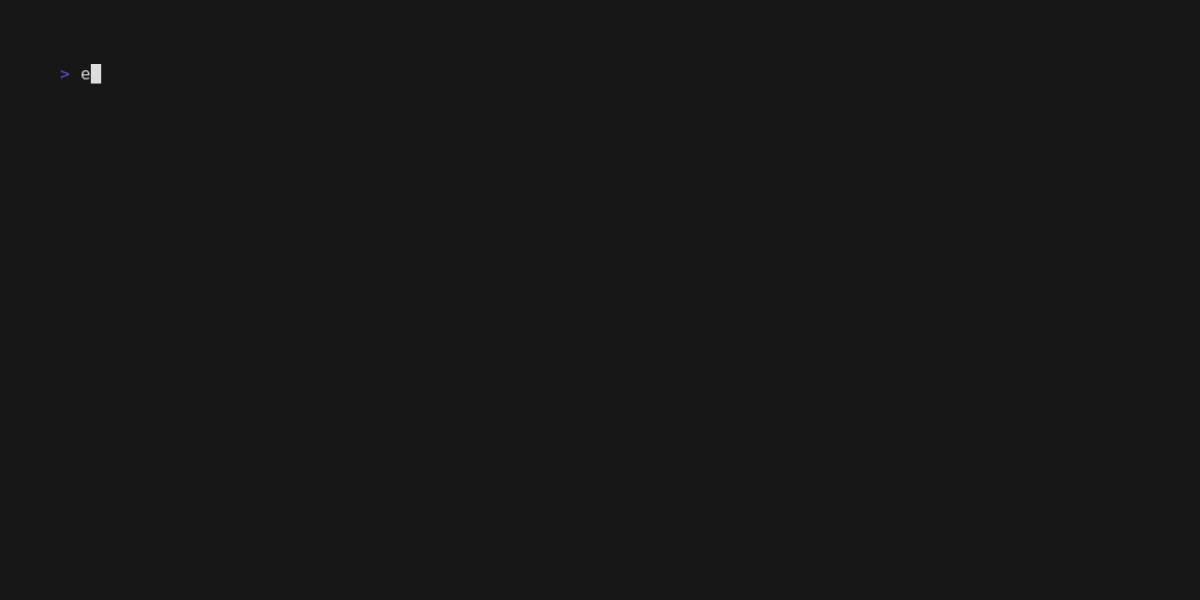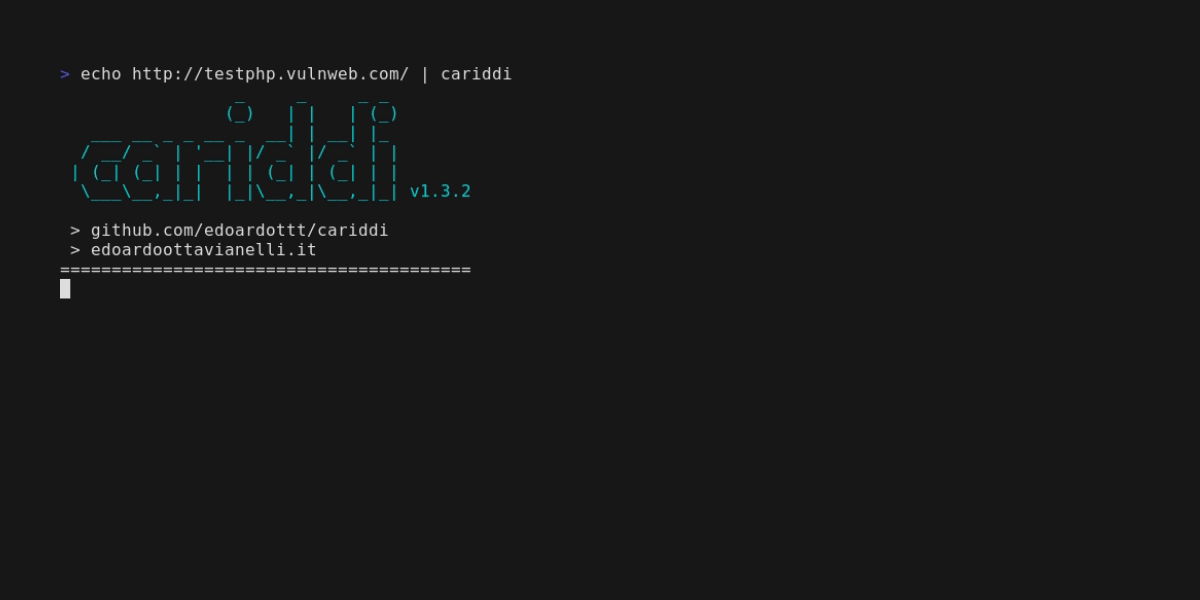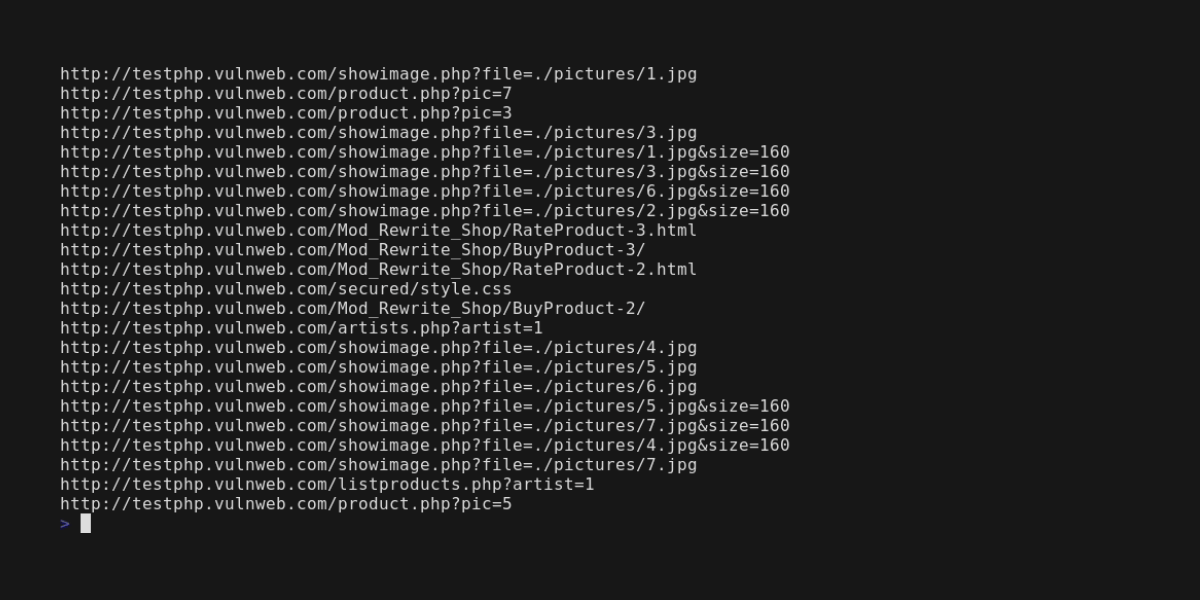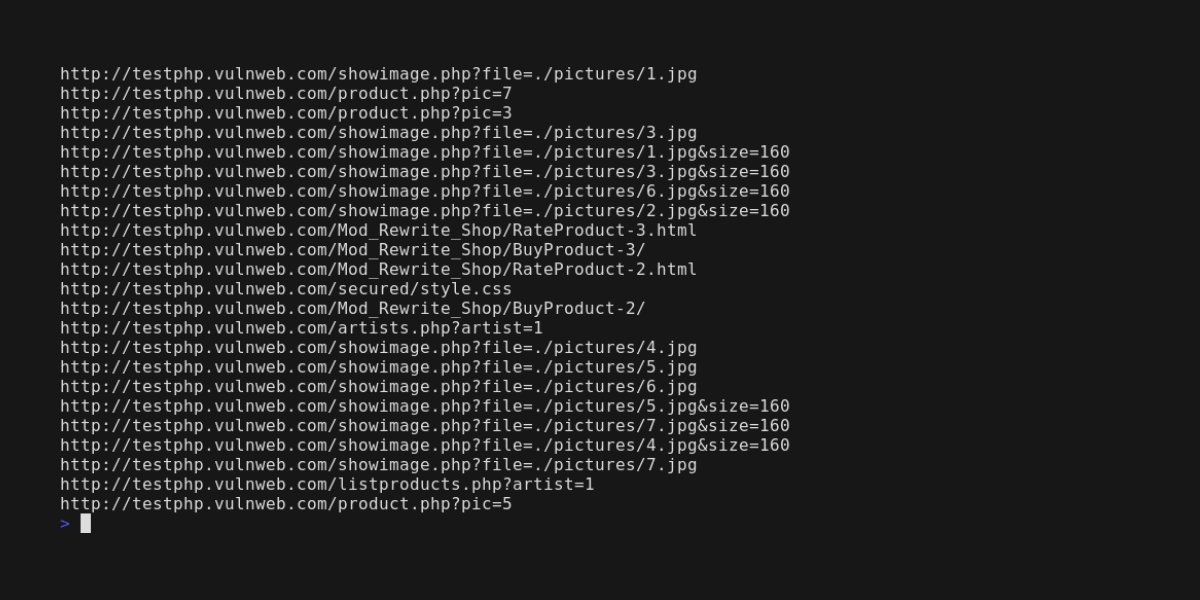
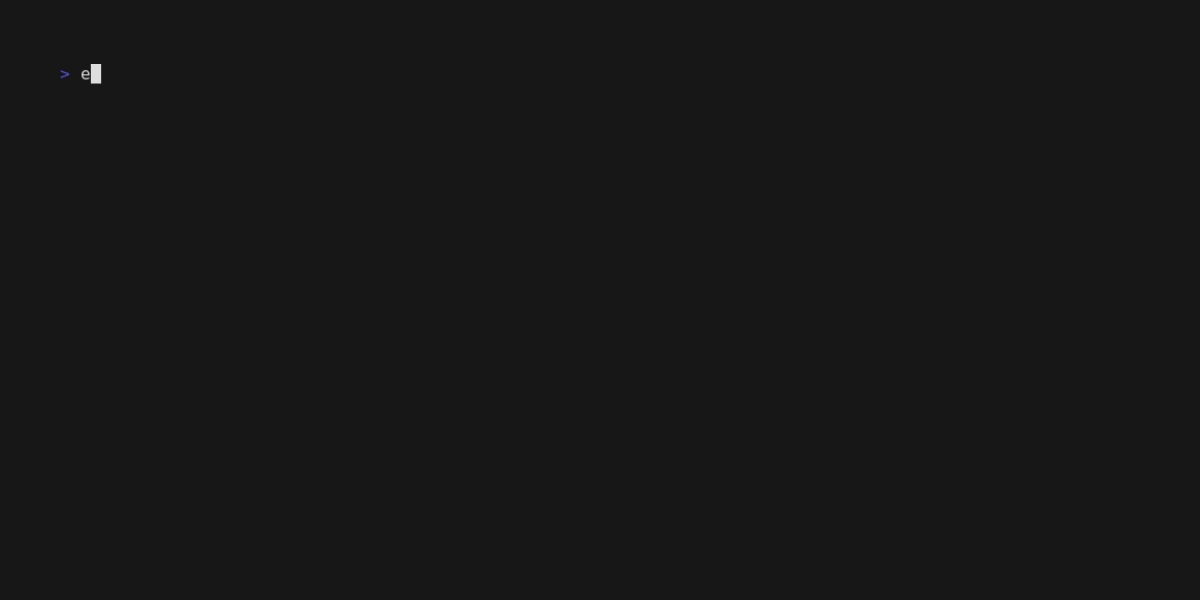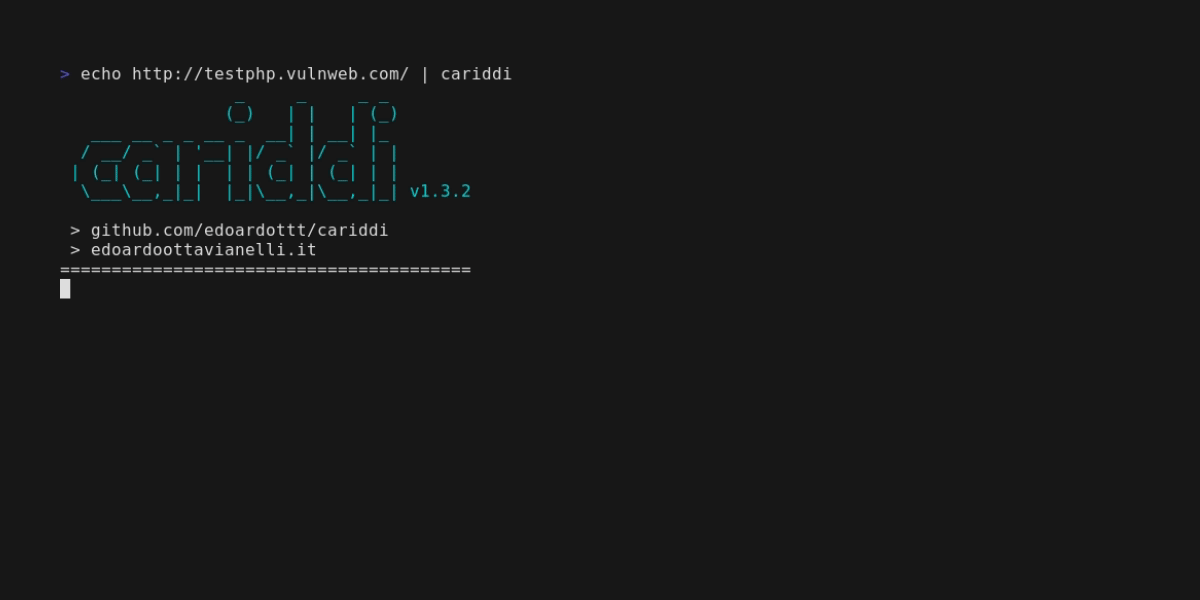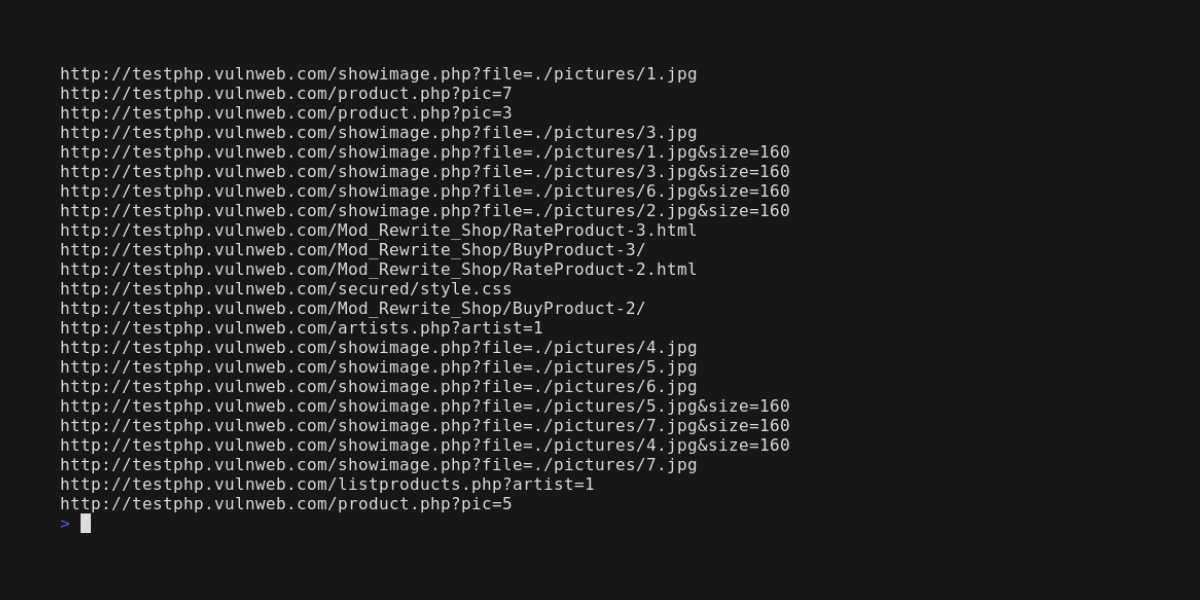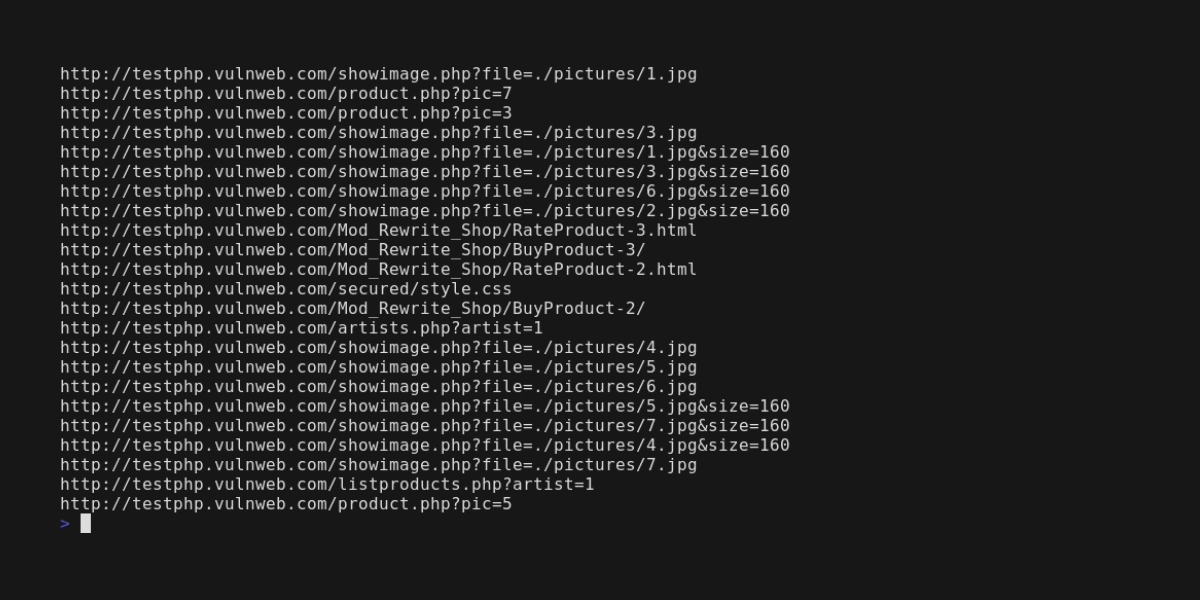
echo https://edoardottt.com/ | cariddi
कई लक्ष्यों के लिए आप इसके बजाय एक फ़ाइल का उपयोग कर सकते हैं, जैसे urls.txt जिसमें हो:
https://edoardottt.com/
http://testphp.vulnweb.com/
Windows के लिए:
powershell.exe -Command "cat urls.txt | .\cariddi.exe" का उपयोग करेंcat urls.txt | cariddi.execariddi -version (संस्करण प्रिंट करें)cariddi -h (सहायता प्रिंट करें)cariddi -examples (उदाहरण प्रिंट करें)cat urls.txt | cariddi -intensive (सबडोमेन सहित खोजते हुए क्रॉल करें, *.target.com के समान)cat urls.txt | cariddi -s (सीक्रेट की तलाश करें)cat urls.txt | cariddi -err (वेबसाइटों में त्रुटियों की तलाश करें)cat urls.txt | cariddi -e (रसीले एंडपॉइंट की तलाश करें)cat urls.txt | cariddi -info (वेबसाइटों में उपयोगी जानकारी की तलाश करें)cat urls.txt | cariddi -ext 2 (रसीले (7 में से स्तर 2) फ़ाइलों की तलाश करें)cat urls.txt | cariddi -e -ef endpoints_file (कस्टम एंडपॉइंट की तलाश करें)cat urls.txt | cariddi -s -sf secrets_file (कस्टम सीक्रेट की तलाश करें)cat urls.txt | cariddi -ie pdf,png,jpg (स्कैन करते समय इन एक्सटेंशन को अनदेखा करें)डिफ़ॉल्ट: सीक्रेट, जानकारी और त्रुटियों के लिए स्कैन करते समय png, svg, jpg, jpeg, bmp, jfif, gif, webp, woff, woff2, ttf, tiff, tif, mp4, webm, mkv, avi, mov, flv, wmv, mp3, wav, flac, ogg, m4a, aac, ico, cur, eot, otf को अनदेखा किया जाता है।
cat urls.txt | cariddi -proxy http://127.0.0.1:8080 (एक प्रॉक्सी सेट करें, http और socks5 समर्थित)cat urls.txt | cariddi -d 2 (एक पेज क्रॉल होने और दूसरे के बीच 2 सेकंड)cat urls.txt | cariddi -c 200 (कंकरेंसी स्तर 200 पर सेट करें)cat urls.txt | cariddi -i forum,blog,community,open (इन शब्दों वाले URL को अनदेखा करें)cat urls.txt | cariddi -it ignore_file (इनपुट फ़ाइल में कम से कम एक पंक्ति वाले URL को अनदेखा करें)cat urls.txt | cariddi -cache (.cariddi_cache फ़ोल्डर को कैश के रूप में उपयोग करें)cat urls.txt | cariddi -t 5 (अनुरोधों के लिए टाइमआउट सेट करें)cat urls.txt | cariddi -headers "Cookie: auth=admin;type=2;; X-Custom: customHeader"cat urls.txt | cariddi -headersfile headers.txt (बाहरी फ़ाइल से कस्टम हेडर पढ़ें)cat urls.txt | cariddi -ua "Custom User Agent" (कस्टम User Agent का उपयोग करें)cat urls.txt | cariddi -rua (प्रत्येक अनुरोध पर एक रैंडम ब्राउज़र user agent का उपयोग करें)cat urls.txt | cariddi -plain (केवल परिणाम प्रिंट करें)cat urls.txt | cariddi -ot target_name (परिणाम txt फ़ाइल में)cat urls.txt | cariddi -oh target_name (परिणाम html फ़ाइल में)cat urls.txt | cariddi -json (आउटपुट को stdout में JSON के रूप में प्रिंट करें)cat urls.txt | cariddi -sr (HTTP प्रतिक्रियाएँ संग्रहीत करें)cat urls.txt | cariddi -debug (क्रॉल करते समय डिबग जानकारी प्रिंट करें)cat urls.txt | cariddi -md 3 (अधिकतम 3 गहराई स्तर)cariddi -h सहायता प्रिंट करता है।
Usage of cariddi:
  -c int
     Concurrency level. (default 20)
  -cache
     Use the .cariddi_cache folder as cache.
  -d int
     Delay between a page crawled and another.
  -debug
     Print debug information while crawling.
  -e Hunt for juicy endpoints.
  -ef string
     Use an external file (txt, one per line) to use custom parameters for endpoints hunting.
  -err
     Hunt for errors in websites.
  -examples
     Print the examples.
  -ext int
     Hunt for juicy file extensions. Integer from 1(juicy) to 7(not juicy).
  -h Print the help.
  -headers string
     Use custom headers for each request E.g. -headers "Cookie: auth=yes;;Client: type=2".
  -headersfile string
     Read from an external file custom headers (same format of headers flag).
  -json
     Print the output as JSON in stdout.
  -md
     Maximum depth level the crawler will follow from the initial target URL.
  -i string
     Ignore the URL containing at least one of the elements of this array.
  -ie value
     Comma-separated list of extensions to ignore while scanning.
  -info
     Hunt for useful informations in websites.
  -intensive
     Crawl searching for resources matching 2nd level domain.
  -it string
     Ignore the URL containing at least one of the lines of this file.
  -oh string
     Write the output into an HTML file.
  -ot string
     Write the output into a TXT file.
  -plain
     Print only the results.
  -proxy string
     Set a Proxy to be used (http and socks5 supported).
  -rua
     Use a random browser user agent on every request.
  -s Hunt for secrets.
  -sf string
     Use an external file (txt, one per line) to use custom regexes for secrets hunting.
  -sr
     Store HTTP responses.
  -t int
     Set timeout for the requests. (default 10)
  -ua string
     Use a custom User Agent.
  -version
     Print the version.
सामान्यतः आप Burpsuite का उपयोग अपने ब्राउज़र के भीतर करते हैं, इसलिए आपको बस ब्राउज़र में burpsuite का प्रमाणपत्र ट्रस्ट करना होता है और आपका काम हो जाता है।
cariddi को BurpSuite प्रॉक्सी के साथ उपयोग करने के लिए आपको कुछ और कदम उठाने होंगे।
यदि आप -proxy http://127.0.0.1:8080 विकल्प के साथ cariddi का उपयोग करने का प्रयास करते हैं तो आपको burpsuite error log अनुभाग में यह त्रुटि मिलेगी:
Received fatal alert: bad_certificate (or something similar related to the certificate).
