 data-privacy-stack/presidio
संवेदनशील डेटा (PII) का पता लगाने, संपादित करने, मास्क करने और गुमनाम करने के लिए एक ओपन-सोर्स फ्रेमवर्क, जो टेक्स्ट, छवियों और संरचित डेटा पर काम करता है। NLP, पैटर्न मिलान, और अनुकूलन योग्य पाइपलाइनों का समर्थन करता है।

पाठ और छवियों के लिए संदर्भ-जागरूक, प्लग करने योग्य और अनुकूलन योग्य PII डी-पहचान सेवा।


| घटक | डाउनलोड | कवरेज |
|---|---|---|
| Presidio Analyzer |  |  |
| Presidio Anonymizer |  |  |
| Presidio Image-Redactor |  |  |
| Presidio Structured |  |  |
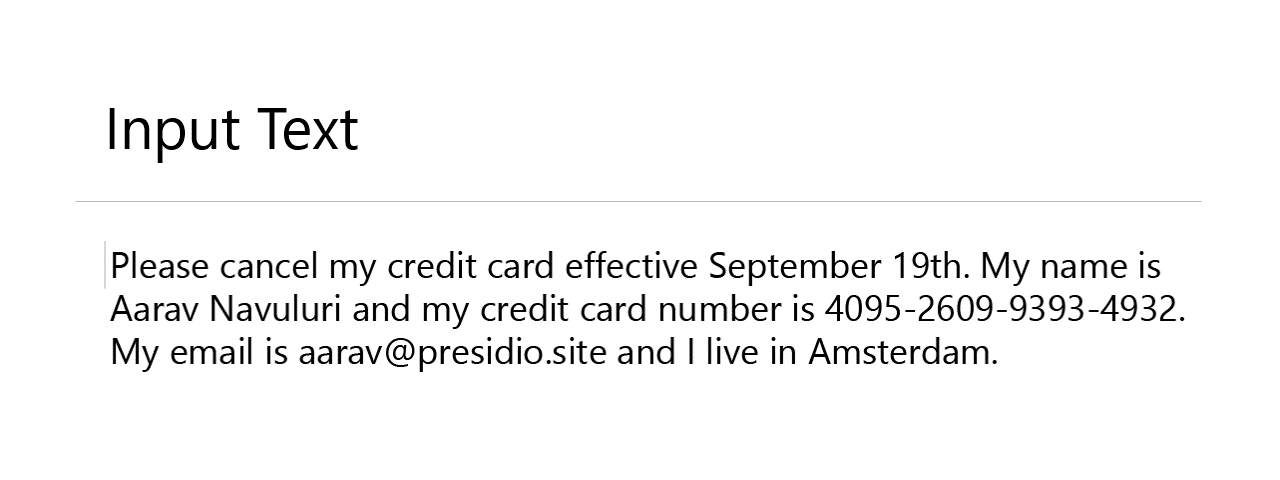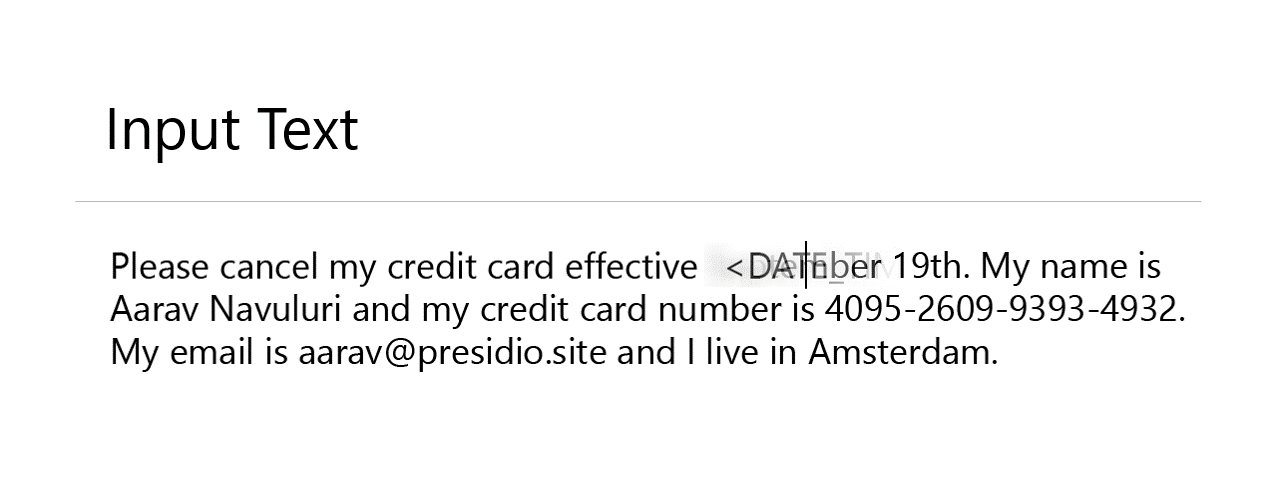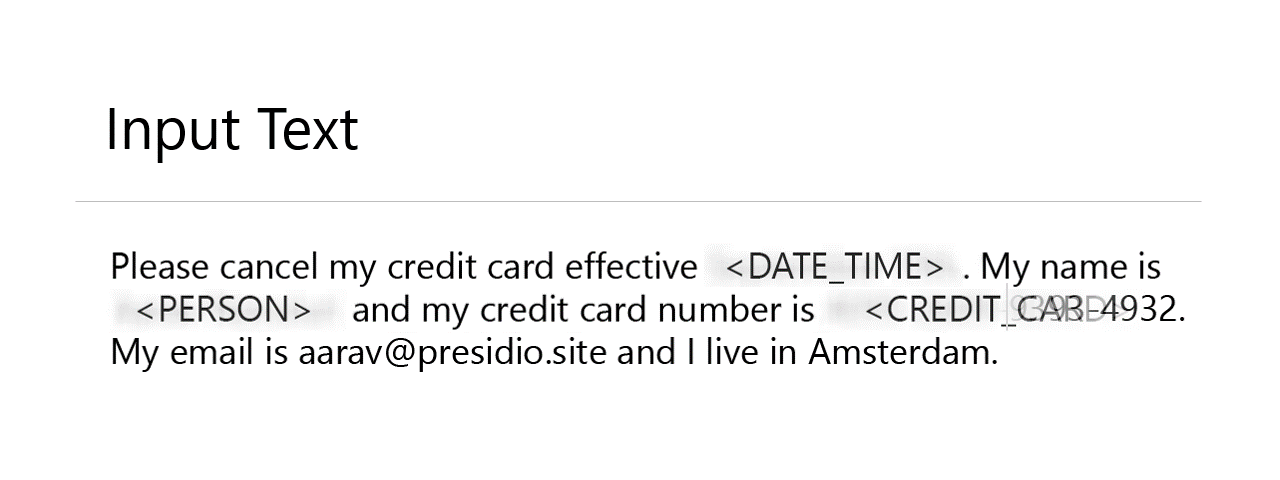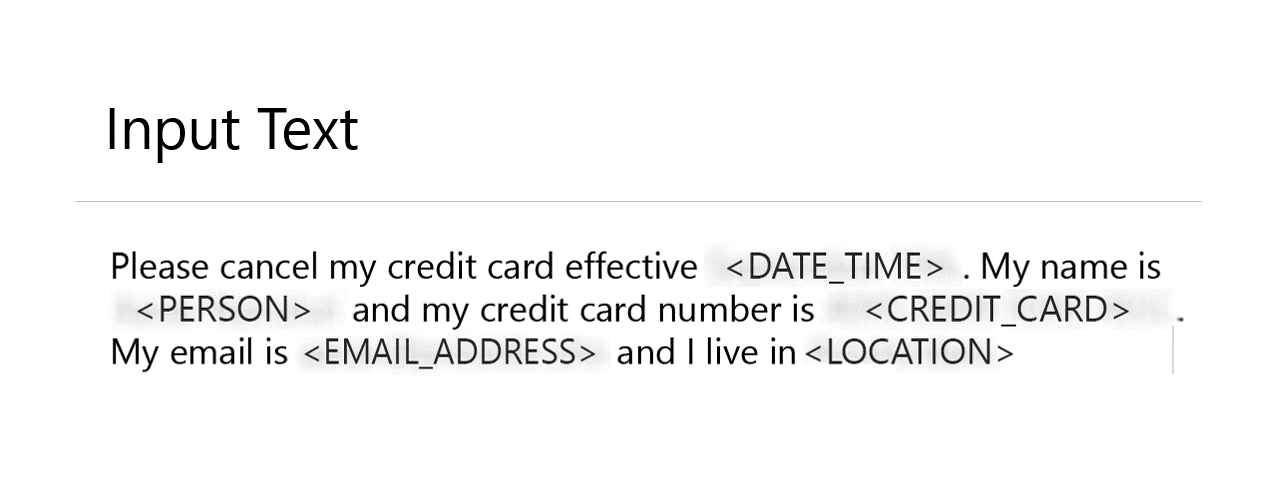
Presidio (लैटिन praesidium ‘संरक्षण, गैरीसन’ से उत्पत्ति) यह सुनिश्चित करने में मदद करता है कि संवेदनशील डेटा का उचित प्रबंधन और शासन हो। यह पाठ में निजी संस्थाओं जैसे क्रेडिट कार्ड नंबर, नाम, स्थान, सामाजिक सुरक्षा संख्या, बिटकॉइन वॉलेट, अमेरिकी फोन नंबर, वित्तीय डेटा और अधिक के लिए तेज़ पहचान और अनामीकरण मॉड्यूल प्रदान करता है।
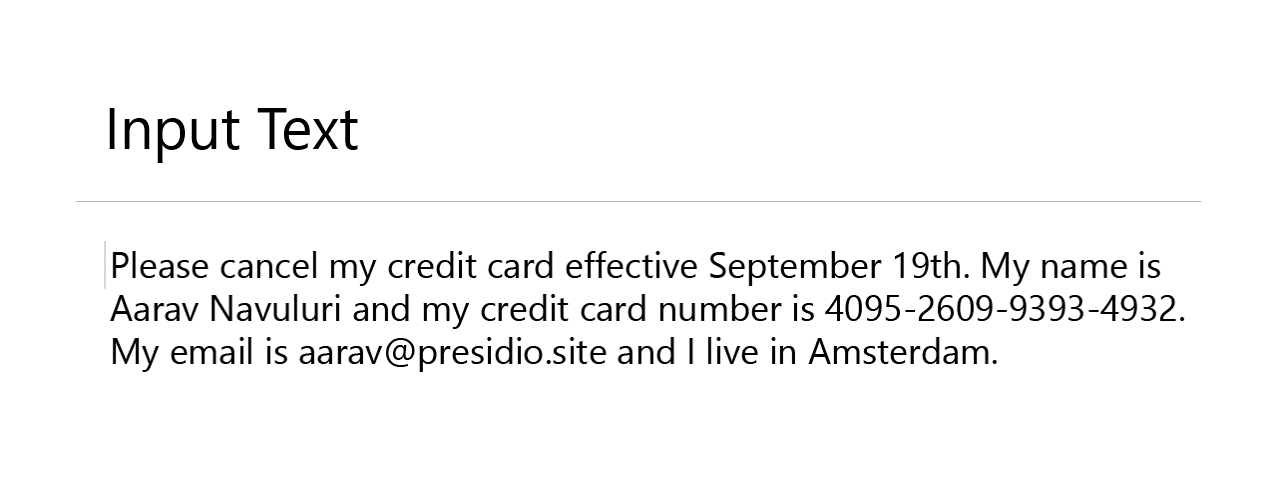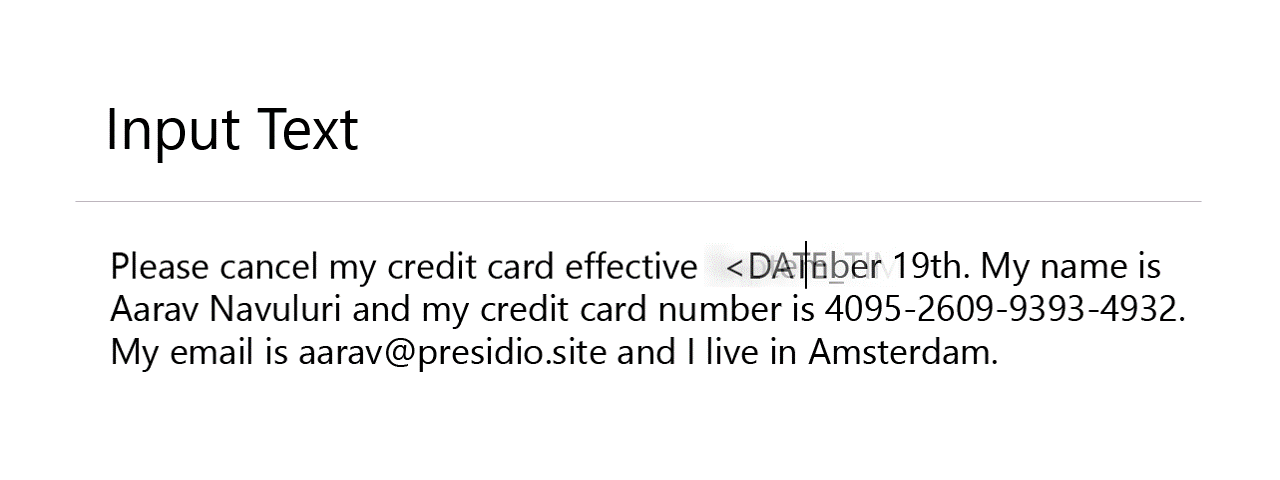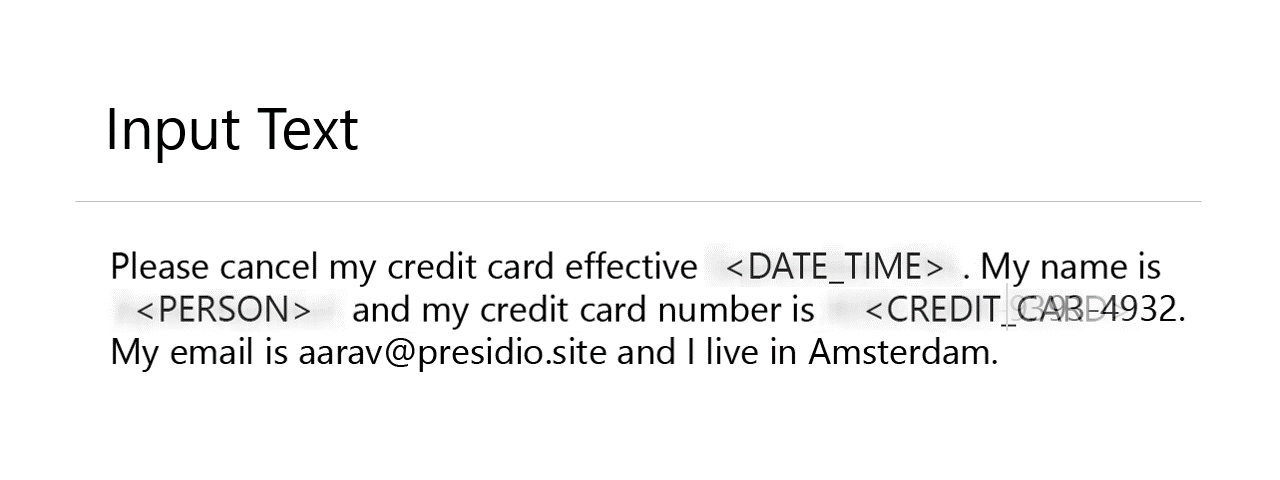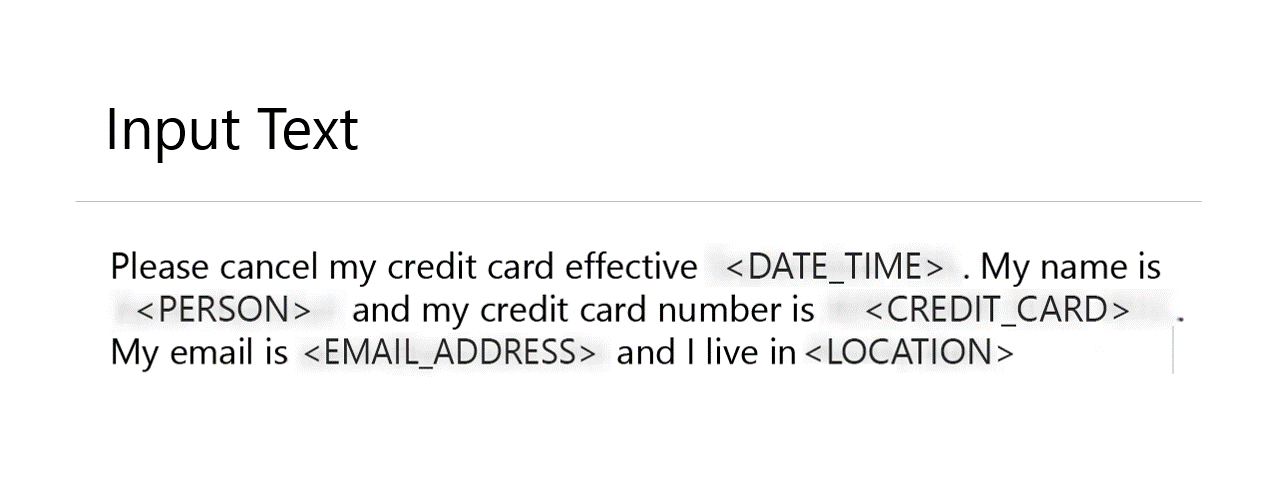
⚠️ Presidio असंरचित/संरचित पाठ में संवेदनशील/PII डेटा की पहचान करने में मदद कर सकता है। हालांकि, चूंकि यह स्वचालित पहचान तंत्र का उपयोग कर रहा है, इसलिए कोई गारंटी नहीं है कि Presidio सभी संवेदनशील जानकारी ढूंढ लेगा। परिणामस्वरूप, अतिरिक्त प्रणालियों और सुरक्षा उपायों को नियोजित किया जाना चाहिए।
इस रिपॉजिटरी में योगदान देने के विवरण के लिए, योगदान गाइड देखें।
इस परियोजना ने Contributor Covenant आचार संहिता को अपनाया है।