 d4vinci/cwff
फ़ज़िंग के लिए अपनी कस्टम वर्डलिस्ट बनाएं

CWFF एक उपकरण है जो समवर्तीता का उपयोग करके उच्चतम गति पर आपके लिए एक विशेष उच्च गुणवत्ता वाली फ़ज़िंग/सामग्री खोज शब्दसूची बनाता है और यह @tomnomnom के Who, What, Where, When, Wordlist #NahamCon2020 से काफी प्रेरित है।
CWFF [-h] [--threads] [--github] [--subdomains] [--recursive] [--js-libraries] [--connected-websites] [--juicy-files] [--use-filter-model] [-o] domain

positional arguments:
  domain                Target website(ofc)

optional arguments:
  -h, --help            Show this help message and exit
  --threads             The number of maximum concurrent threads to use (Default:1000)
  --github              Collect endpoints from a given github repo (ex:https://github.com/google/flax)
  --subdomains          Extract endpoints from subdomains also while search in the wayback machine!
  --recursive           Work on extracted endpoints recursively (Adds more endpoints but less accurate sometimes)!
  --js-libraries        Extract endpoints from JS libraries also, not just the JS written by them!
  --connected-websites  Include endpoints extracted from connected websites
  --juicy-files         Include endpoints extracted from juicy files like sitemap.xml and robots.txt
  --use-filter-model    Filter result endpoints with filter_model file
  -o                    The output directory for the endpoints and parameters. (Default: website name)
तो यह मूल रूप से लक्ष्य और उसके उपडोमेन के एंडपॉइंट और पैरामीटर कई स्रोतों का उपयोग करके एकत्र करता है, जिनके बारे में हम अब बात करेंगे:
बहुत सारे उपकरण समय बचाने के लिए wayback के केवल शीर्ष पृष्ठ से गुज़रते हैं, लेकिन यहाँ हम कम समय में सभी रिकॉर्ड से गुज़रते हैं, लेकिन यह भी बहुत समय लेता है जब आप --subdomains फ़्लैग का उपयोग करते हैं।
<script> टैग के लिए पार्स करके एकत्र की गईंCWFF JS पुस्तकालयों को वास्तव में वेबसाइट डेवलपर्स द्वारा लिखी गई JS फ़ाइलों से अलग करने का प्रयास करता है और यह JS फ़ाइल नामों को देखकर करता है।
डिफ़ॉल्ट रूप से, CWFF केवल डेवलपर्स द्वारा लिखी गई JS फ़ाइलों से एंडपॉइंट निकालता है, JS पुस्तकालयों (अधिकतर सहायक नहीं) का उपयोग करने के लिए --js-libraries फ़्लैग सक्रिय करें।
--juicy-files फ़्लैग दिया, तो यह Sitemap.xml और robots.txt जैसी फ़ाइलों से भी एंडपॉइंट निकालेगा (भविष्य में और जोड़े जा सकते हैं)--github फ़्लैग का उपयोग करके एक github रिपॉजिटरी दी, तो यह Github API का उपयोग करके उस रिपॉजिटरी से पथ निकालेगा (कोई API कुंजी की आवश्यकता नहीं)।बस इसे स्पष्ट करने के लिए, CWFF केवल फ़ाइलों और निर्देशिकाओं के पथों का उपयोग करेगा, इसलिए यह फ़ाइलों के अंदर से एंडपॉइंट नहीं निकालेगा!
--connected-websites फ़्लैग का उपयोग करने पर, CWFF builtwith वेबसाइट API (कुंजी आवश्यक है लेकिन यह मुफ़्त है) का उपयोग करके संबंध प्रोफ़ाइल से लक्ष्य से जुड़ी वेबसाइटों को निकालेगा, फिर इन वेबसाइटों के स्रोत से एंडपॉइंट निकालेगा।नोट: आप अपनी API कुंजी इस पृष्ठ से प्राप्त कर सकते हैं और
API_keys.pyफ़ाइल में वेरिएबल सेट कर सकते हैं।
इन सभी एंडपॉइंट से एंडपॉइंट एकत्र करने के बाद यदि आपने --recursive फ़्लैग का उपयोग किया, तो CWFF एकत्रित एंडपॉइंट से पुनरावर्ती रूप से भाग निकालेगा।
parseq/javadoc/1.1.0/com ये सभी एंडपॉइंट बन जाएगा:
parseq/javadoc/1.1.0/com
parseq/javadoc/1.1.0/
parseq/javadoc/
parseq/
javadoc/
1.1.0/
com
नोट: एकत्र किए गए सभी एंडपॉइंट/पैरामीटर को साफ और क्रमबद्ध किया जाता है, बिना किसी डुप्लिकेट के, एक अद्वितीय परिणाम प्राप्त करने के लिए।
बेशक इन सभी स्रोतों और इस काम के बाद, महत्वपूर्ण एंडपॉइंट के बीच बहुत सारे अवांछित/बेकार एंडपॉइंट होंगे और यहाँ फ़िल्टरिंग समय और संसाधनों को बचाने के लिए काम में आती है।
CWFF में आप तीन विधियों का उपयोग करके अवांछित एंडपॉइंट का पता लगा सकते हैं और हटा सकते हैं:
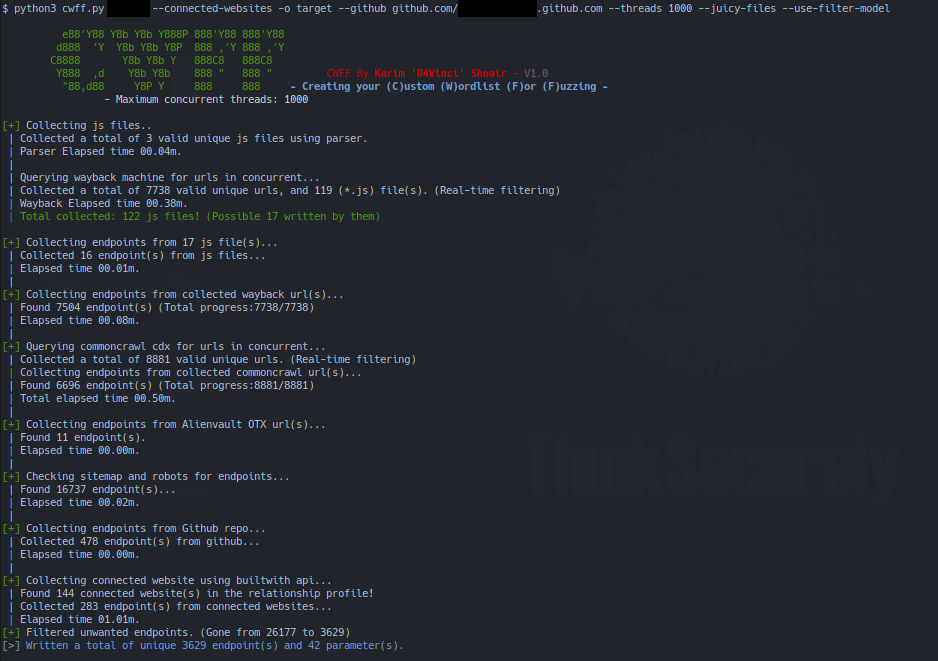
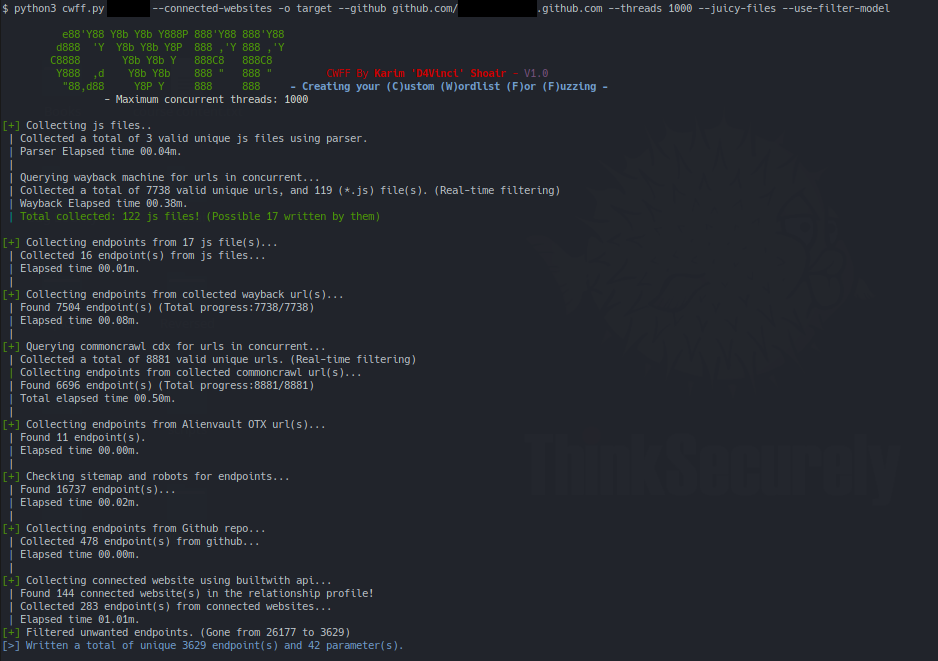
ये सभी फ़िल्टर विकल्प filter_model.py फ़ाइल में वेरिएबल सेट करके दिए जा सकते हैं, फिर CWFF शुरू करते समय --use-filter-model फ़्लैग का उपयोग करें। यदि आपको यह वेरिएबल सेट करने का कोई विचार नहीं है, तो फ़ाइल में मेरे द्वारा छोड़ी गई टिप्पणियाँ देखें, यह वही है जो मैं ज्यादातर उपयोग करता हूँ और स्क्रीनशॉट में इसने एकत्रित एंडपॉइंट की संख्या 26,177 से घटाकर 3629 कर दी।
यदि आप CWFF चलाते समय फ़िल्टरिंग का उपयोग करना भूल गए, तो चिंता न करें, मैंने आपको कवर कर लिया है 😄
आप स्क्रिप्ट filter.py का उपयोग निम्नलिखित तरीके से अपने पास मौजूद एंडपॉइंट को फ़िल्टर करने के लिए कर सकते हैं और यह CWFF को पुनः चलाए बिना स्वचालित रूप से filter_model.py फ़ाइल लोड करेगा:
python filter.py wordlist.txt output.txt
python3 -m pip install -r requirements.txt
python3 cwff.py --help
यदि मेरा काम आपके लिए उपयोगी रहा है, तो मुझे एक कॉफी खरीदकर धन्यवाद देने में संकोच न करें।
CWFF पेनिट्रेशन टेस्टिंग में मदद के लिए बनाया गया है और यह किसी भी दुरुपयोग या अवैध उद्देश्यों के लिए जिम्मेदार नहीं है।
इस उपकरण से कोड कॉपी करना या इसे किसी अन्य उपकरण में उपयोग करना स्वीकार्य है, बशर्ते आप स्रोत का उल्लेख करें :smile
