 biniamf/ai-reverse-engineering
Ghidra के साथ AI-सहायता प्राप्त रिवर्स इंजीनियरिंग

# Rev·Deck — Ghidra के साथ AI-सहायता प्राप्त रिवर्स इंजीनियरिंग

Rev·Deck एक स्थानीय, एकल-उपयोगकर्ता स्थैतिक-विश्लेषण वर्कस्टेशन है। यह एक हेडलेस Ghidra सेवा द्वारा विश्लेषित बाइनरी पर साक्ष्य-प्रथम वेब UI को LLM कॉपायलट के साथ जोड़ता है: नियतिवादी साक्ष्य (फ़ंक्शन, स्ट्रिंग्स, इम्पोर्ट्स, क्रॉस-रेफ़रेंस, एक सीमित कॉल ग्राफ़) को सीधे ब्राउज़ करें, या सहायक से ऐसे सीमित प्रश्न पूछें जिनके तथ्यात्मक दावों को निरीक्षणीय साक्ष्य उद्धृत करना अनिवार्य है।

विश्लेषित बाइनरी कभी निष्पादित नहीं की जातीं। ब्राउज़र केवल इस Flask ऐप से संवाद करता है; ऐप सत्यापित, टाइप किए गए अनुरोधों को Ghidra सेवा तक प्रॉक्सी करता है।

## डेमो

https://github.com/user-attachments/assets/fba14dc5-7ad5-4137-9349-ed824da64fbe

## त्वरित आरंभ (Docker)

```bash
cp .env.example .env      # set API_BASE and MODEL_NAME; set API_KEY if required
docker compose up --build
```

Docker Compose इंटरपोलेशन के लिए `.env` को स्वचालित रूप से पढ़ता है। यदि `API_BASE` या `MODEL_NAME` अनुपस्थित हो तो यह आरंभ होने से पहले विफल हो जाता है; `API_KEY=not-used` स्थानीय/कीलेस प्रदाताओं के लिए मान्य रहता है। स्टैक दोनों सेवाएँ आरंभ करता है। http://127.0.0.1:5000 खोलें।

केवल Ghidra सेवा चलाने के लिए:

```bash
docker pull biniamfd/ghidra-headless-rest:latest   # ensure the newest image

docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:latest
```

प्रतिलिपि-योग्य पिन के लिए, `latest` के बजाय परीक्षित रिलीज़ डाइजेस्ट का उपयोग करें:

```bash
docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3a8448d8ed969079b452306e806f36079c3ddd298f4a618d6e2f1442d
```

## पूर्वापेक्षाएँ

- Docker और Docker Compose (त्वरित आरंभ मार्ग के लिए), या Python 3.10+ और Node.js 18+ (स्रोत से चलाने के लिए)।
- एक OpenAI-संगत LLM एंडपॉइंट (स्थानीय या होस्टेड) और मॉडल नाम।
- सार्वजनिक Ghidra इमेज: `biniamfd/ghidra-headless-rest:latest`।

## आवश्यक पर्यावरण चर

`.env.example` को `.env` में कॉपी करें और इन्हें भरें; पूरी सूची और डिफ़ॉल्ट के लिए वह फ़ाइल देखें।

| चर | डिफ़ॉल्ट | अर्थ |
| --- | --- | --- |
| `API_BASE` | required | OpenAI-संगत बेस URL (http/https)। अनुपस्थित होने पर Compose जल्दी विफल हो जाता है। |
| `API_KEY` | `not-used` | प्रदाता कुंजी। कभी लॉग या ब्राउज़र को नहीं भेजी जाती; `not-used` कीलेस स्थानीय प्रदाताओं के लिए मान्य है। |
| `MODEL_NAME` | required | कॉन्फ़िगर किए गए एंडपॉइंट द्वारा अपेक्षित मॉडल id। अनुपस्थित होने पर Compose जल्दी विफल हो जाता है। |
| `LLM_STREAM` | `auto` | स्ट्रीमिंग ट्रांसपोर्ट: `auto` (स्ट्रीम करें, आउटपुट-पूर्व संगतता त्रुटि पर एक बार ब्लॉकिंग पर वापस जाएँ), `true` (हमेशा स्ट्रीम करें), `false` (हमेशा ब्लॉकिंग)। |
| `GHIDRA_API_BASE` | `http://127.0.0.1:9090` | Ghidra सेवा बेस URL। |
| `GHIDRA_IMAGE` | `biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3...` | अपरिवर्तनीय डाइजेस्ट द्वारा पिन किया गया परीक्षित रिलीज़। `:latest` भी इसी डाइजेस्ट पर हल होता है; भिन्न रिलीज़ पिन करने के लिए ओवरराइड करें। |
| `HOST` / `PORT` | `127.0.0.1` / `5000` | डेव-सर्वर बाइंड। |
| `MAX_UPLOAD_BYTES` | `104857600` | अपलोड आकार सीमा। |
| `CHATS_DIR` | `webui/chats` | चैट इतिहास निर्देशिका। |

## LLM प्रदाता

Rev·Deck OpenAI SDK के माध्यम से **किसी भी OpenAI-संगत Chat Completions एंडपॉइंट** से बात करता है, जो पूरी तरह से `API_BASE` / `API_KEY` / `MODEL_NAME` द्वारा कॉन्फ़िगर किया जाता है। कोई प्रदाता-विशिष्ट हेडर, पैरामीटर या मॉडल तर्क नहीं है: एक स्थानीय [Ollama](https://ollama.com) सर्वर (`API_BASE=http://127.0.0.1:11434/v1`), एक सेल्फ-होस्टेड vLLM/llama.cpp/LM Studio एंडपॉइंट, स्वयं OpenAI, या OpenRouter जैसा गेटवे — सभी एक ही तरह काम करते हैं।

उदाहरण `.env` प्रदाता सेटिंग्स (प्लेसहोल्डर का उपयोग करें, वास्तविक कुंजियाँ कभी कमिट न करें):

```dotenv
# Ollama
API_BASE=http://127.0.0.1:11434/v1
API_KEY=not-used
MODEL_NAME=qwen3:8b
```

```dotenv
# OpenRouter
API_BASE=https://openrouter.ai/api/v1
API_KEY=replace-with-your-key
MODEL_NAME=anthropic/claude-opus-4.8
```

```dotenv
# OpenAI
API_BASE=https://api.openai.com/v1
API_KEY=replace-with-your-key
MODEL_NAME=replace-with-a-supported-model-id
```

```dotenv
# LM Studio, vLLM, or llama.cpp (adjust port/model to the server)
API_BASE=http://127.0.0.1:1234/v1
API_KEY=not-used
MODEL_NAME=replace-with-the-served-model-id
```

डिफ़ॉल्ट रूप से (`LLM_STREAM=auto`) सहायक एक **स्ट्रीम किया गया** प्रतिसाद अनुरोधित करता है और टोकन आते ही उन्हें ब्राउज़र तक पहुँचाता है। स्ट्रीमिंग एक मज़बूत रद्दीकरण गारंटी भी देती है: जब आप प्रतिसाद रोकते हैं (या टैब बंद करते हैं), Rev·Deck तुरंत अंतर्निहित प्रदाता स्ट्रीम बंद कर देता है और कोई और टूल या मॉडल दौर नहीं चलाता, जिससे अपस्ट्रीम जनरेशन समाप्त कर दी जाती है बजाय पृष्ठभूमि में पूर्णता तक चलते रहने के।

सावधानियाँ:

- **बिलिंग।** रद्द करने पर हमारी ओर से स्ट्रीम तुरंत बंद हो जाती है, लेकिन कुछ होस्टेड प्रदाता क्लाइंट के जल्दी डिस्कनेक्ट होने के बावजूद उन टोकनों के लिए बिल करते हैं जो वे पहले ही उत्पन्न कर चुके होते हैं (या पूरी कंप्लीशन के लिए)। गारंटी *अधिक कार्य न करने* के बारे में है, प्रदाता की बिलिंग नीति के बारे में नहीं।
- **संगतता।** हर OpenAI-संगत एंडपॉइंट टूल्स के साथ स्ट्रीमिंग स्वीकार नहीं करता। `auto` के अंतर्गत, यदि प्रदाता स्ट्रीम किए गए अनुरोध को संगतता त्रुटि (HTTP 400/404/405/422) के साथ *किसी भी* सामग्री या टूल-कॉल आउटपुट से पहले अस्वीकार करता है, तो Rev·Deck एक बार एकल ब्लॉकिंग कॉल पर वापस आ जाता है और प्रक्रिया के शेष भाग के लिए इसे याद रखता है। प्रमाणीकरण (401/403), दर-सीमा (429), और सर्वर (5xx) त्रुटियों को संगतता समस्याएँ **नहीं** माना जाता और चुपचाप पुनः प्रयास करने के बजाय उन्हें त्रुटियों के रूप में दर्शाया जाता है। स्ट्रीमिंग को पूरी तरह छोड़ने के लिए `LLM_STREAM=false` सेट करें, या इसे आवश्यक करने के लिए `LLM_STREAM=true` (कोई फ़ॉलबैक नहीं)।

## उपयोग कैसे करें

ऐप खोलें और विश्लेषण कार्य आरंभ करने के लिए एक बाइनरी अपलोड करें। स्पष्ट सादा-पाठ सामग्री Ghidra को भेजे जाने से पहले पुष्टि माँगती है; स्पष्ट रॉ-बाइनरी ओवरराइड का उपयोग केवल तभी करें जब सामग्री जानबूझकर फ़र्मवेयर/डेटा हो न कि एक निष्पादन योग्य प्रारूप। विश्लेषण पूर्ण होने पर, दो वर्कस्पेस टैब के बीच स्विच करें:

- **विश्लेषण** — नियतिवादी साक्ष्य दृश्य: सारांश, फ़ंक्शन (फ़िल्टर/पेजिनेट), इम्पोर्ट्स, स्ट्रिंग्स, एक क्वेरी दृश्य, एक फ़ंक्शन इंस्पेक्टर (स्यूडोकोड, क्रॉस-रेफ़रेंस, सीमित कॉल ग्राफ़, हेक्सडंप), और — जब कनेक्टेड Ghidra सेवा उनका समर्थन करती है — टाइप्स, ग्लोबल्स, साइडकार एनोटेशन, आर्काइव निर्यात, और व्याख्या योग्य सकारात्मक/शमन संकेतों और साक्ष्य कवरेज के साथ एक नियतिवादी Attack Surface रैंकिंग।
- **चैट** — सहायक, दो मोडों में से एक में:
  - **कॉपायलट** (डिफ़ॉल्ट): प्रति संदेश एक सीमित चरण/टूल कॉल, तदर्थ प्रश्नों के लिए।
  - **स्वायत्त**: एक नामित, बजट-युक्त वर्कफ़्लो आरंभ करें जो अपने आप कई सीमित चरण चलाता है और कार्य करते समय एक लाइव गतिविधि टाइमलाइन दिखाता है।

दोनों मोड एक प्रति-कार्य **चरण बजट** और एक **कोई चरण सीमा नहीं** विकल्प लेते हैं जो कार्य समाप्त होने तक चलता है (फिर भी `MAX_STEP_BUDGET` द्वारा सीमित ताकि एक लूपिंग मॉडल भाग न सके)। यदि कोई रन अपने बजट तक पहुँचता है, तो वह आंशिक परिणाम रिपोर्ट करता है और **जारी रखें** प्रदान करता है — जो पहले से प्राप्त साक्ष्य का उपयोग करके उसी वार्तालाप को फिर से शुरू करता है, बिना पूर्ण किए गए टूल कॉलों को दोहराए। लागत टूल/मॉडल कॉलों की संख्या के साथ बढ़ती है, इसलिए उच्च बजट अधिक खर्चीले होते हैं।

उपलब्ध वर्कफ़्लो:

| वर्कफ़्लो | उद्देश्य | लक्ष्य फ़ंक्शन पता आवश्यक है |
| --- | --- | --- |
| `program_triage` | मेटाडेटा, इम्पोर्ट्स, स्ट्रिंग्स और फ़ंक्शनों से प्रोग्राम के संभावित उद्देश्य का सारांश दें। | नहीं |
| `suspicious_behavior` | पहले नियतिवादी संकेतक उजागर करें, फिर सीमित, स्पष्ट-लेबल वाली परिकल्पनाएँ। | नहीं |
| `selected_function` | एक फ़ंक्शन को डीकंपाइल करें और उसके कॉलर्स/कैलीज़ के साथ समझाएँ। | हाँ |
| `call_chain` | एक आरंभिक फ़ंक्शन से एक सीमित नेटिव/संश्लेषित कॉल-ग्राफ़ पड़ोस का अन्वेषण करें। | हाँ |
| `attack_surface_triage` | नियतिवादी स्कोर कवरेज/top-K पढ़ें, फिर अधिकतम तीन उम्मीदवारों का गहराई से निरीक्षण करें; स्कोर प्राथमिकताएँ हैं, निर्णय नहीं। | नहीं |
| `vulnerability_hypothesis` | एक सीमित उम्मीदवार चुनें और साक्ष्य, प्रति-साक्ष्य और खुले प्रश्न प्रस्तुत करें; कभी स्वतः-पुष्टि नहीं करता। | नहीं |

### केंद्रित उप-जाँच

प्रत्येक विश्लेषण कार्य में एक **मुख्य** चैट और वैकल्पिक केंद्रित उप-सूत्र होते हैं। **नई उप-जाँच** चुनें, एक-पंक्ति का ब्रीफिंग दर्ज करें, और उसी बाइनरी और उसी केवल-पठन टूलों पर एक नए वार्तालाप संदर्भ के साथ कार्य करें। सूत्र इतिहास अलग-थलग रहते हैं, और एक समय में केवल एक सूत्र स्ट्रीम करता है।

जब केंद्रित कार्य तैयार हो, तो **मूल सूत्र को निष्कर्ष लौटाएँ** चुनें। Rev·Deck केवल उस उप-सूत्र पर एक सीमित मॉडल कॉल करता है, उसके साक्ष्य उद्धरणों को सत्यापित करता है, और मूल सूत्र में एक उत्पत्ति-चिह्नित निष्कर्ष कार्ड जोड़ता है। पूर्ण शाखा फिर से खोलने योग्य रहती है, जबकि मूल सूत्र संदर्भ केवल संक्षिप्त निष्कर्ष प्राप्त करता है—शाखा प्रतिलेख नहीं। बिना सत्यापित उद्धरणों वाला लौटाया गया कार्ड स्पष्ट रूप से असत्यापित चिह्नित होता है।

सहायक उत्तर साक्ष्य को इनलाइन `[function:0xADDR]`, `[string:0xADDR]`, या `[import:name]` के रूप में उद्धृत करते हैं। उद्धरणों की जाँच उसके विरुद्ध की जाती है जो वास्तव में उस दौर के दौरान प्राप्त किया गया था; जो उद्धरण मेल नहीं खाता उसे "(unverified)" चिह्नित किया जाता है और उसे एक अपुष्ट दावे के रूप में माना जाना चाहिए, तथ्य के रूप में नहीं।

सहायक आउटपुट में Mermaid आरेख (जैसे कॉल-ग्राफ़ स्केच) बाहरी नेटवर्क पहुँच के बिना एक सैंडबॉक्स्ड फ्रेम में रेंडर होते हैं।

## आर्किटेक्चर

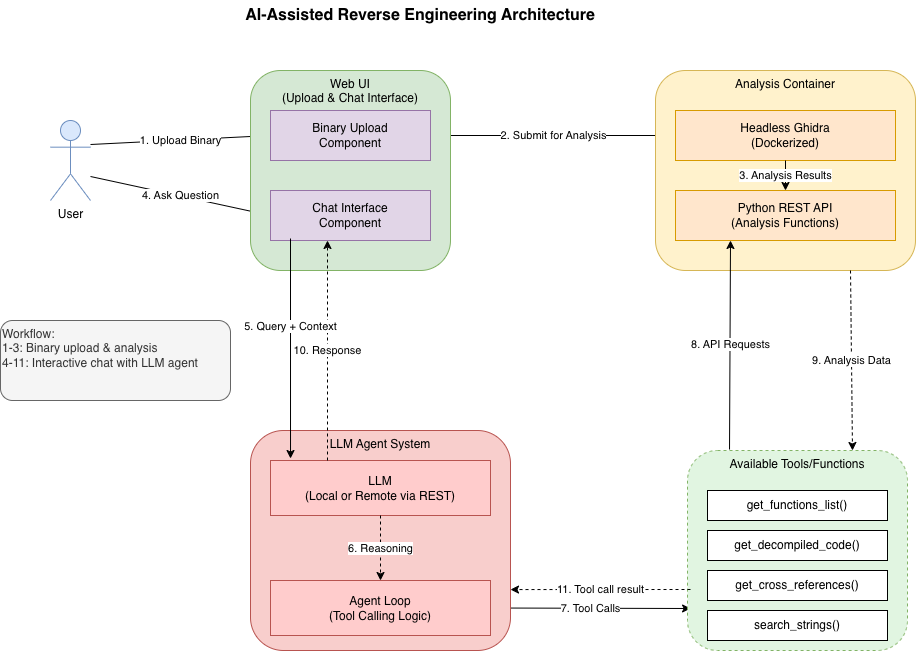
ब्राउज़र केवल Rev·Deck वेब एप्लिकेशन से संवाद करता है। Rev·Deck कॉन्फ़िगर किए गए LLM और हेडलेस Ghidra सेवा का समन्वय करता है, फिर परिणामी साक्ष्य और एजेंट गतिविधि को एक वर्कस्पेस में प्रस्तुत करता है।

<img width="916" height="651" alt="Rev·Deck आर्किटेक्चर" src="https://assets.kitploit.com/production/public/readmes/9561/40809484745cf03bf42790c8abff0146755ebb953a3774c8fac17fbc3c0552de.png" />

## स्रोत से चलाना

```bash
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
npm ci && npm run vendor        # one-time: vendors the pinned Mermaid runtime

cp .env.example .env            # edit API_BASE / MODEL_NAME / API_KEY
set -a; source .env; set +a     # plain Python does not load .env automatically

# Start the separate Ghidra service, then:
python webui/app.py
```

http://127.0.0.1:5000 खोलें। Docker Compose `.env` को स्वचालित रूप से पढ़ता है; स्रोत निष्पादन के लिए इसे ऊपर दिखाए अनुसार निर्यात करना आवश्यक है। Flask डेवलपमेंट सर्वर स्थानीय उपयोग के लिए उपयुक्त है; Docker इमेज Gunicorn चलाती है।

## सुरक्षा / केवल-स्थानीय सीमा

यह एक विश्वसनीय विश्लेषक के लिए उनकी अपनी मशीन पर डिज़ाइन किया गया है — बहु-उपयोगकर्ता या सार्वजनिक होस्टिंग के लिए नहीं। डिफ़ॉल्ट रूप से ऐप और Ghidra सेवा केवल `127.0.0.1` से बंधते हैं, डीबग मोड बंद है, अपलोड की गई बाइनरी कभी निष्पादित नहीं होतीं, और LLM प्रदाता कुंजी सर्वर-पक्ष पर ही रहती है।

## परीक्षण

```bash
pip install -r requirements.txt -r requirements-dev.txt
python -m pytest
node --test "webui/static/js/tests/**/*.test.mjs"
npm ci && npm run vendor:verify   # verifies the vendored Mermaid bundle's integrity
```

## समस्या निवारण

- **"Service offline" / `/readyz` 503 लौटाता है** — Ghidra सेवा `GHIDRA_API_BASE` पर अप्राप्य है, या `API_BASE`/`MODEL_NAME` सेट नहीं है।
- **Types/Globals/Annotations "requires v1" दिखाते हैं** — कनेक्टेड Ghidra सेवा उस क्षमता की घोषणा नहीं करती; पुरानी सेवाओं पर यह अपेक्षित है।
- **चैट तुरंत त्रुटि देता है** — `API_BASE`/`API_KEY`/`MODEL_NAME` सत्यापित करें और यह भी कि प्रदाता `LLM_TIMEOUT` के भीतर पहुँच योग्य है।
- **अपलोड बहुत बड़ा होने पर अस्वीकृत** — `MAX_UPLOAD_BYTES` बढ़ाएँ।
- **अपलोड सादा पाठ जैसा दिखता है** — Rev·Deck इसे Ghidra को भेजने से पहले पूछता है; केवल जानबूझकर होने पर ही रॉ बाइनरी के रूप में जारी रखें।
- **बड़ा विश्लेषण टाइमआउट** — Ghidra कंटेनर का `ANALYSIS_TIMEOUT` बढ़ाएँ (उदाहरण के लिए 10k+ फ़ंक्शन वाली C++/Android बाइनरी के लिए `5400`) और पुनः अपलोड करें। `LLM_TIMEOUT` असंबंधित है।
- **एक उद्धरण "(unverified)" दिखाता है** — मॉडल ने ऐसे साक्ष्य उद्धृत किए जो उसने वास्तव में कभी प्राप्त नहीं किए; उस दावे को एक अपुष्ट परिकल्पना मानें।
