 biniamf/ai-reverse-engineering
Ghidra के साथ AI-सहायता प्राप्त रिवर्स इंजीनियरिंग

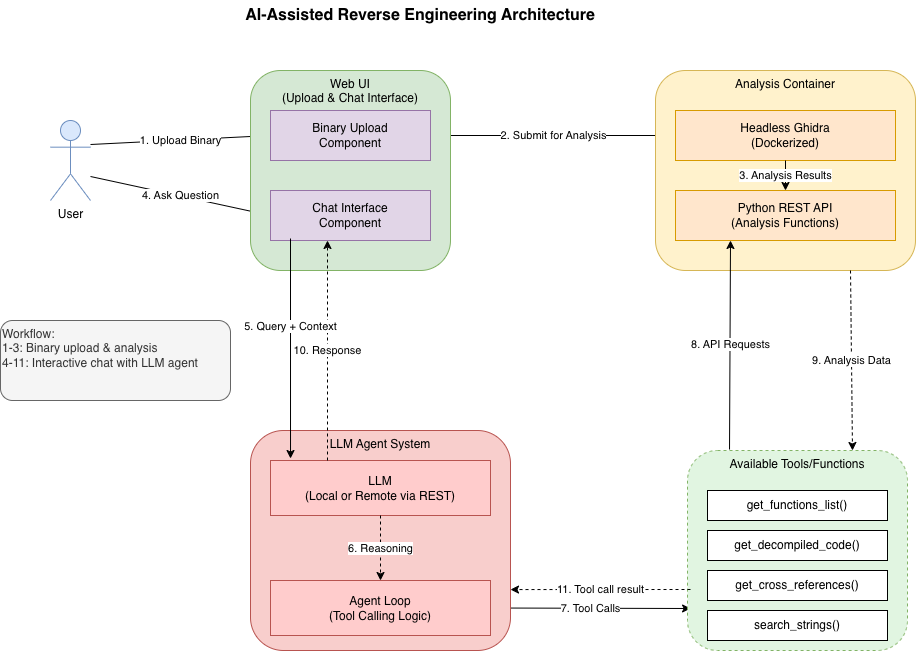
Rev·Deck एक स्थानीय, एकल-उपयोगकर्ता स्थैतिक-विश्लेषण वर्कस्टेशन है। यह एक हेडलेस Ghidra सेवा द्वारा विश्लेषित बाइनरी पर साक्ष्य-प्रथम वेब UI को LLM कॉपायलट के साथ जोड़ता है: नियतिवादी साक्ष्य (फ़ंक्शन, स्ट्रिंग्स, इम्पोर्ट्स, क्रॉस-रेफ़रेंस, एक सीमित कॉल ग्राफ़) को सीधे ब्राउज़ करें, या सहायक से ऐसे सीमित प्रश्न पूछें जिनके तथ्यात्मक दावों को निरीक्षणीय साक्ष्य उद्धृत करना अनिवार्य है।
विश्लेषित बाइनरी कभी निष्पादित नहीं की जातीं। ब्राउज़र केवल इस Flask ऐप से संवाद करता है; ऐप सत्यापित, टाइप किए गए अनुरोधों को Ghidra सेवा तक प्रॉक्सी करता है।
https://github.com/user-attachments/assets/fba14dc5-7ad5-4137-9349-ed824da64fbe
cp .env.example .env      # set API_BASE and MODEL_NAME; set API_KEY if required
docker compose up --build
Docker Compose इंटरपोलेशन के लिए .env को स्वचालित रूप से पढ़ता है। यदि API_BASE या MODEL_NAME अनुपस्थित हो तो यह आरंभ होने से पहले विफल हो जाता है; API_KEY=not-used स्थानीय/कीलेस प्रदाताओं के लिए मान्य रहता है। स्टैक दोनों सेवाएँ आरंभ करता है। http://127.0.0.1:5000 खोलें।
केवल Ghidra सेवा चलाने के लिए:
docker pull biniamfd/ghidra-headless-rest:latest   # ensure the newest image

docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:latest
प्रतिलिपि-योग्य पिन के लिए, latest के बजाय परीक्षित रिलीज़ डाइजेस्ट का उपयोग करें:
docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3a8448d8ed969079b452306e806f36079c3ddd298f4a618d6e2f1442d
biniamfd/ghidra-headless-rest:latest।.env.example को .env में कॉपी करें और इन्हें भरें; पूरी सूची और डिफ़ॉल्ट के लिए वह फ़ाइल देखें।
| चर | डिफ़ॉल्ट | अर्थ |
|---|---|---|
API_BASE | required | OpenAI-संगत बेस URL (http/https)। अनुपस्थित होने पर Compose जल्दी विफल हो जाता है। |
API_KEY | not-used | प्रदाता कुंजी। कभी लॉग या ब्राउज़र को नहीं भेजी जाती; not-used कीलेस स्थानीय प्रदाताओं के लिए मान्य है। |
MODEL_NAME | required | कॉन्फ़िगर किए गए एंडपॉइंट द्वारा अपेक्षित मॉडल id। अनुपस्थित होने पर Compose जल्दी विफल हो जाता है। |
LLM_STREAM | auto | स्ट्रीमिंग ट्रांसपोर्ट: auto (स्ट्रीम करें, आउटपुट-पूर्व संगतता त्रुटि पर एक बार ब्लॉकिंग पर वापस जाएँ), true (हमेशा स्ट्रीम करें), false (हमेशा ब्लॉकिंग)। |
GHIDRA_API_BASE | http://127.0.0.1:9090 | Ghidra सेवा बेस URL। |
GHIDRA_IMAGE | biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3... | अपरिवर्तनीय डाइजेस्ट द्वारा पिन किया गया परीक्षित रिलीज़। :latest भी इसी डाइजेस्ट पर हल होता है; भिन्न रिलीज़ पिन करने के लिए ओवरराइड करें। |
HOST / PORT | 127.0.0.1 / 5000 | डेव-सर्वर बाइंड। |
MAX_UPLOAD_BYTES | 104857600 | अपलोड आकार सीमा। |
CHATS_DIR | webui/chats | चैट इतिहास निर्देशिका। |
Rev·Deck OpenAI SDK के माध्यम से किसी भी OpenAI-संगत Chat Completions एंडपॉइंट से बात करता है, जो पूरी तरह से API_BASE / API_KEY / MODEL_NAME द्वारा कॉन्फ़िगर किया जाता है। कोई प्रदाता-विशिष्ट हेडर, पैरामीटर या मॉडल तर्क नहीं है: एक स्थानीय Ollama सर्वर (API_BASE=http://127.0.0.1:11434/v1), एक सेल्फ-होस्टेड vLLM/llama.cpp/LM Studio एंडपॉइंट, स्वयं OpenAI, या OpenRouter जैसा गेटवे — सभी एक ही तरह काम करते हैं।
उदाहरण .env प्रदाता सेटिंग्स (प्लेसहोल्डर का उपयोग करें, वास्तविक कुंजियाँ कभी कमिट न करें):
# Ollama
API_BASE=http://127.0.0.1:11434/v1
API_KEY=not-used
MODEL_NAME=qwen3:8b
# OpenRouter
API_BASE=https://openrouter.ai/api/v1
API_KEY=replace-with-your-key
MODEL_NAME=anthropic/claude-opus-4.8
# OpenAI
API_BASE=https://api.openai.com/v1
API_KEY=replace-with-your-key
MODEL_NAME=replace-with-a-supported-model-id
# LM Studio, vLLM, or llama.cpp (adjust port/model to the server)
API_BASE=http://127.0.0.1:1234/v1
API_KEY=not-used
MODEL_NAME=replace-with-the-served-model-id
डिफ़ॉल्ट रूप से (LLM_STREAM=auto) सहायक एक स्ट्रीम किया गया प्रतिसाद अनुरोधित करता है और टोकन आते ही उन्हें ब्राउज़र तक पहुँचाता है। स्ट्रीमिंग एक मज़बूत रद्दीकरण गारंटी भी देती है: जब आप प्रतिसाद रोकते हैं (या टैब बंद करते हैं), Rev·Deck तुरंत अंतर्निहित प्रदाता स्ट्रीम बंद कर देता है और कोई और टूल या मॉडल दौर नहीं चलाता, जिससे अपस्ट्रीम जनरेशन समाप्त कर दी जाती है बजाय पृष्ठभूमि में पूर्णता तक चलते रहने के।
सावधानियाँ:
auto के अंतर्गत, यदि प्रदाता स्ट्रीम किए गए अनुरोध को संगतता त्रुटि (HTTP 400/404/405/422) के साथ किसी भी सामग्री या टूल-कॉल आउटपुट से पहले अस्वीकार करता है, तो Rev·Deck एक बार एकल ब्लॉकिंग कॉल पर वापस आ जाता है और प्रक्रिया के शेष भाग के लिए इसे याद रखता है। प्रमाणीकरण (401/403), दर-सीमा (429), और सर्वर (5xx) त्रुटियों को संगतता समस्याएँ नहीं माना जाता और चुपचाप पुनः प्रयास करने के बजाय उन्हें त्रुटियों के रूप में दर्शाया जाता है। स्ट्रीमिंग को पूरी तरह छोड़ने के लिए LLM_STREAM=false सेट करें, या इसे आवश्यक करने के लिए LLM_STREAM=true (कोई फ़ॉलबैक नहीं)।ऐप खोलें और विश्लेषण कार्य आरंभ करने के लिए एक बाइनरी अपलोड करें। स्पष्ट सादा-पाठ सामग्री Ghidra को भेजे जाने से पहले पुष्टि माँगती है; स्पष्ट रॉ-बाइनरी ओवरराइड का उपयोग केवल तभी करें जब सामग्री जानबूझकर फ़र्मवेयर/डेटा हो न कि एक निष्पादन योग्य प्रारूप। विश्लेषण पूर्ण होने पर, दो वर्कस्पेस टैब के बीच स्विच करें:
दोनों मोड एक प्रति-कार्य चरण बजट और एक कोई चरण सीमा नहीं विकल्प लेते हैं जो कार्य समाप्त होने तक चलता है (फिर भी MAX_STEP_BUDGET द्वारा सीमित ताकि एक लूपिंग मॉडल भाग न सके)। यदि कोई रन अपने बजट तक पहुँचता है, तो वह आंशिक परिणाम रिपोर्ट करता है और जारी रखें प्रदान करता है — जो पहले से प्राप्त साक्ष्य का उपयोग करके उसी वार्तालाप को फिर से शुरू करता है, बिना पूर्ण किए गए टूल कॉलों को दोहराए। लागत टूल/मॉडल कॉलों की संख्या के साथ बढ़ती है, इसलिए उच्च बजट अधिक खर्चीले होते हैं।
उपलब्ध वर्कफ़्लो:
