रिवर्स इंजीनियरिंग: बड़े भाषा मॉडल के साथ बाइनरी कोड को डीकंपाइल करना
अपडेट
[2025-10-04]: SK²Decompile जारी: स्केलेटन से स्किन तक LLM-आधारित दो-चरणीय बाइनरी डीकंपिलेशन। चरण 1 संरचना पुनर्प्राप्ति (स्केलेटन): बाइनरी/स्यूडो-कोड को अस्पष्ट मध्यवर्ती निरूपण में बदलें 🤗 HF लिंक। चरण 2 पहचानकर्ता नामकरण (स्किन): सार्थक पहचानकर्ताओं के साथ मानव-पठनीय स्रोत कोड उत्पन्न करें 🤗 HF लिंक।
[2025-05-20]: decompile-bench जारी, इसमें प्रशिक्षण के लिए दो मिलियन बाइनरी-स्रोत फ़ंक्शन जोड़े और मूल्यांकन के लिए 70K फ़ंक्शन जोड़े शामिल हैं। विवरण के लिए कृपया decompile-bench फ़ोल्डर देखें।
[2024-10-17]: decompile-ghidra-100k जारी, यह 100k प्रशिक्षण नमूनों (प्रति अनुकूलन स्तर 25k) का एक उपसमूह है। हम एक प्रशिक्षण स्क्रिप्ट प्रदान करते हैं जो एकल A100 40G GPU पर लगभग 3.5 घंटे में चलती है। यह 0.26 की पुनः-निष्पादन क्षमता दर प्राप्त करती है, जिसकी कुल लागत LLM4Decompile के त्वरित प्रतिकृति के लिए $20 से कम है।
[2024-09-26]: LLM4Decompile मॉडल के उपयोग को प्रदर्शित करने के लिए एक Colab नोटबुक अपडेट किया, जिसमें LLM4Decompile-End और LLM4Decompile-Ref मॉडल के उदाहरण शामिल हैं।
[2024-09-23]: LLM4Decompile-9B-v2 जारी, जो Yi-Coder-9B पर आधारित फाइन-ट्यून है, Decompile बेंचमार्क पर 0.6494 की पुनः-निष्पादन क्षमता दर हासिल की।
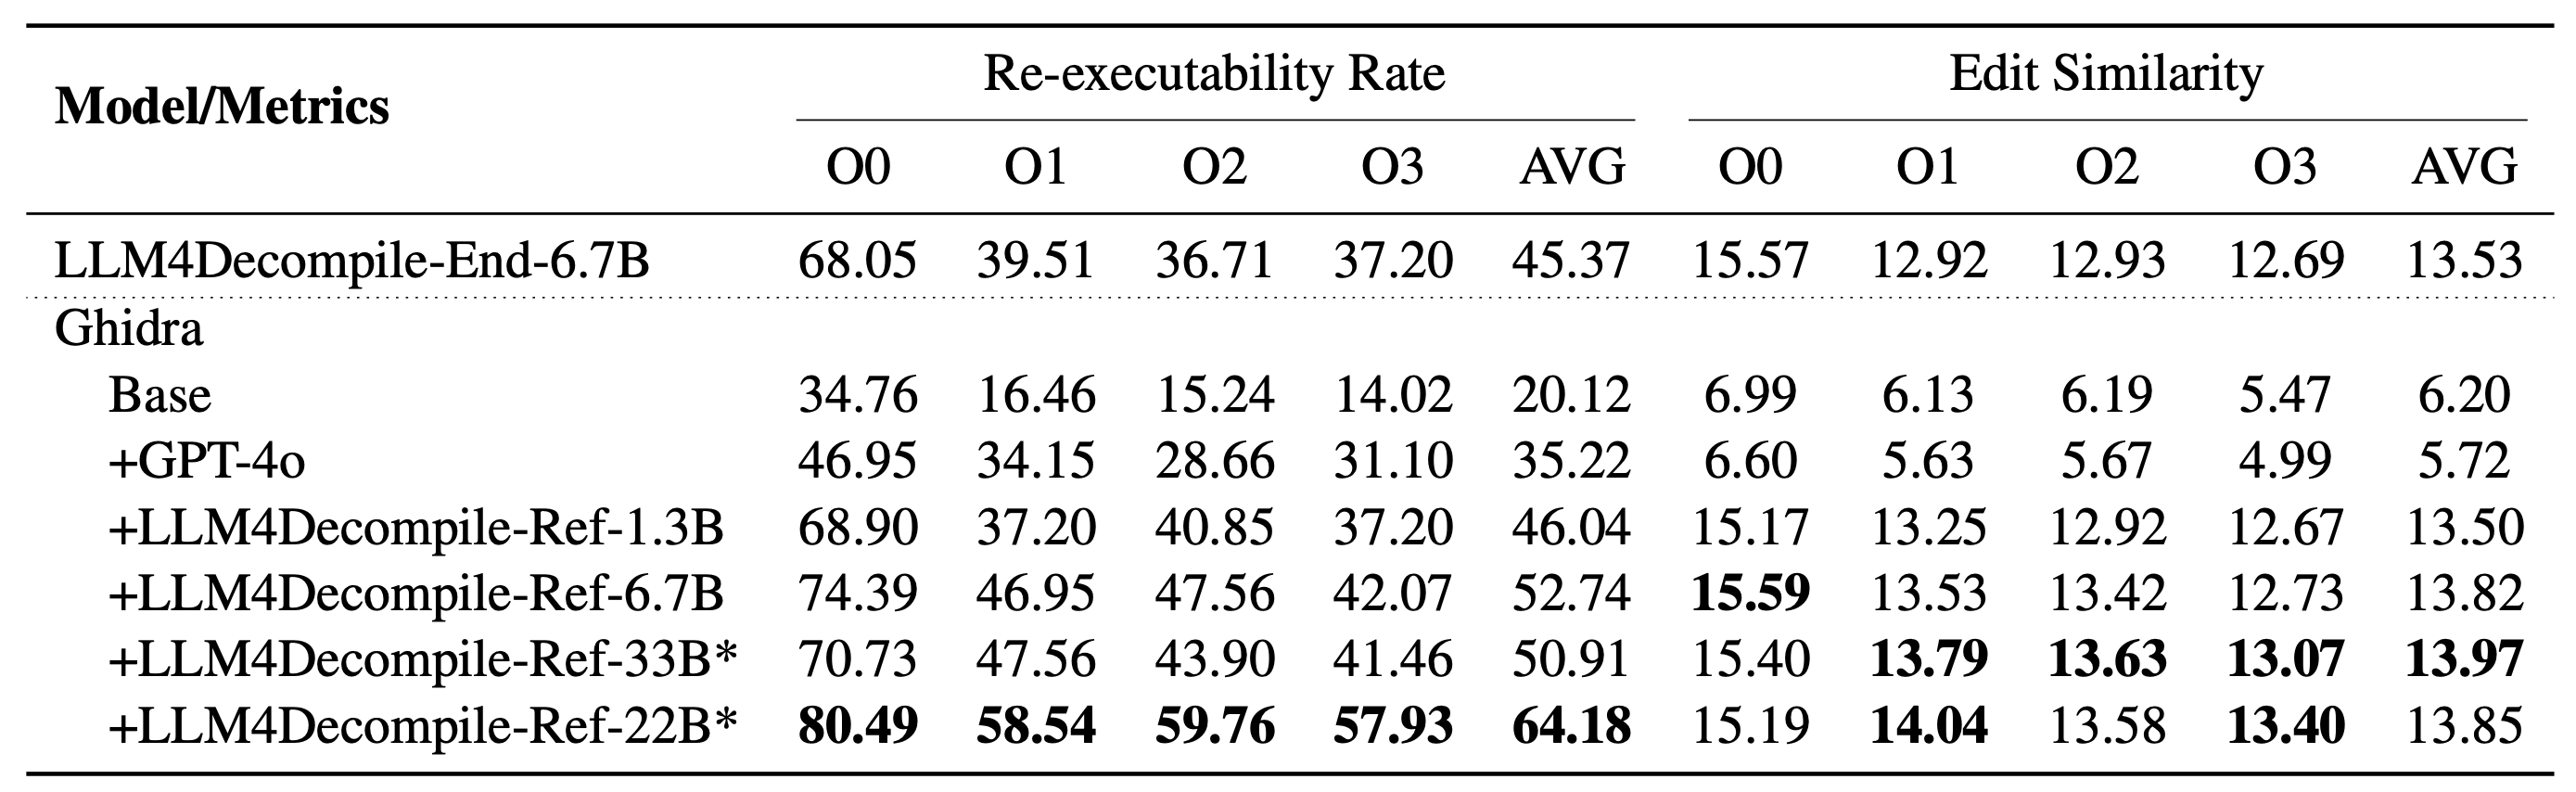
[2024-06-19]: V2 श्रृंखला (LLM4Decompile-Ref) जारी। V2 (1.3B-22B), Ghidra पर आधारित, Ghidra से डीकंपाइल किए गए स्यूडो-कोड को परिष्कृत करने के लिए 2 बिलियन टोकन पर प्रशिक्षित हैं। 22B-V2 संस्करण 6.7B-V1.5 से अतिरिक्त 40.1% बेहतर प्रदर्शन करता है। विवरण के लिए कृपया ghidra फ़ोल्डर देखें।
[2024-05-13]: V1.5 श्रृंखला (LLM4Decompile-End, सीधे LLM का उपयोग करके बाइनरी डीकंपाइल करें) जारी। V1.5 को बड़े डेटासेट (15B टोकन) और अधिकतम टोकन लंबाई 4,096 के साथ प्रशिक्षित किया गया है, जिसमें पिछले मॉडल की तुलना में उल्लेखनीय प्रदर्शन (100% से अधिक सुधार) है।
[2024-03-16]: llm4decompile-6.7b-uo मॉडल जोड़ा गया जो अनुकूलन स्तरों (O0~O3) के पूर्व ज्ञान के बिना प्रशिक्षित है, औसत पुनः-निष्पादन क्षमता लगभग 0.219 है, जो हमारे मॉडलों में सर्वश्रेष्ठ प्रदर्शन करता है।
परिचय
LLM4Decompile डीकंपिलेशन के लिए समर्पित अग्रणी ओपन-सोर्स बड़ा भाषा मॉडल है। इसका वर्तमान संस्करण Linux x86_64 बाइनरी को, GCC के O0 से O3 अनुकूलन स्तरों तक, मानव-पठनीय C स्रोत कोड में डीकंपाइल करने का समर्थन करता है। हमारी टीम इस टूल की क्षमताओं का विस्तार करने के लिए प्रतिबद्ध है, जिसमें आर्किटेक्चर और कॉन्फ़िगरेशन की एक व्यापक श्रृंखला को शामिल करने के निरंतर प्रयास शामिल हैं।
LLM4Decompile-End बाइनरी को सीधे डीकंपाइल करने पर केंद्रित है। LLM4Decompile-Ref Ghidra द्वारा डीकंपाइल किए गए स्यूडो-कोड को परिष्कृत करता है।
मूल्यांकन
ढांचा
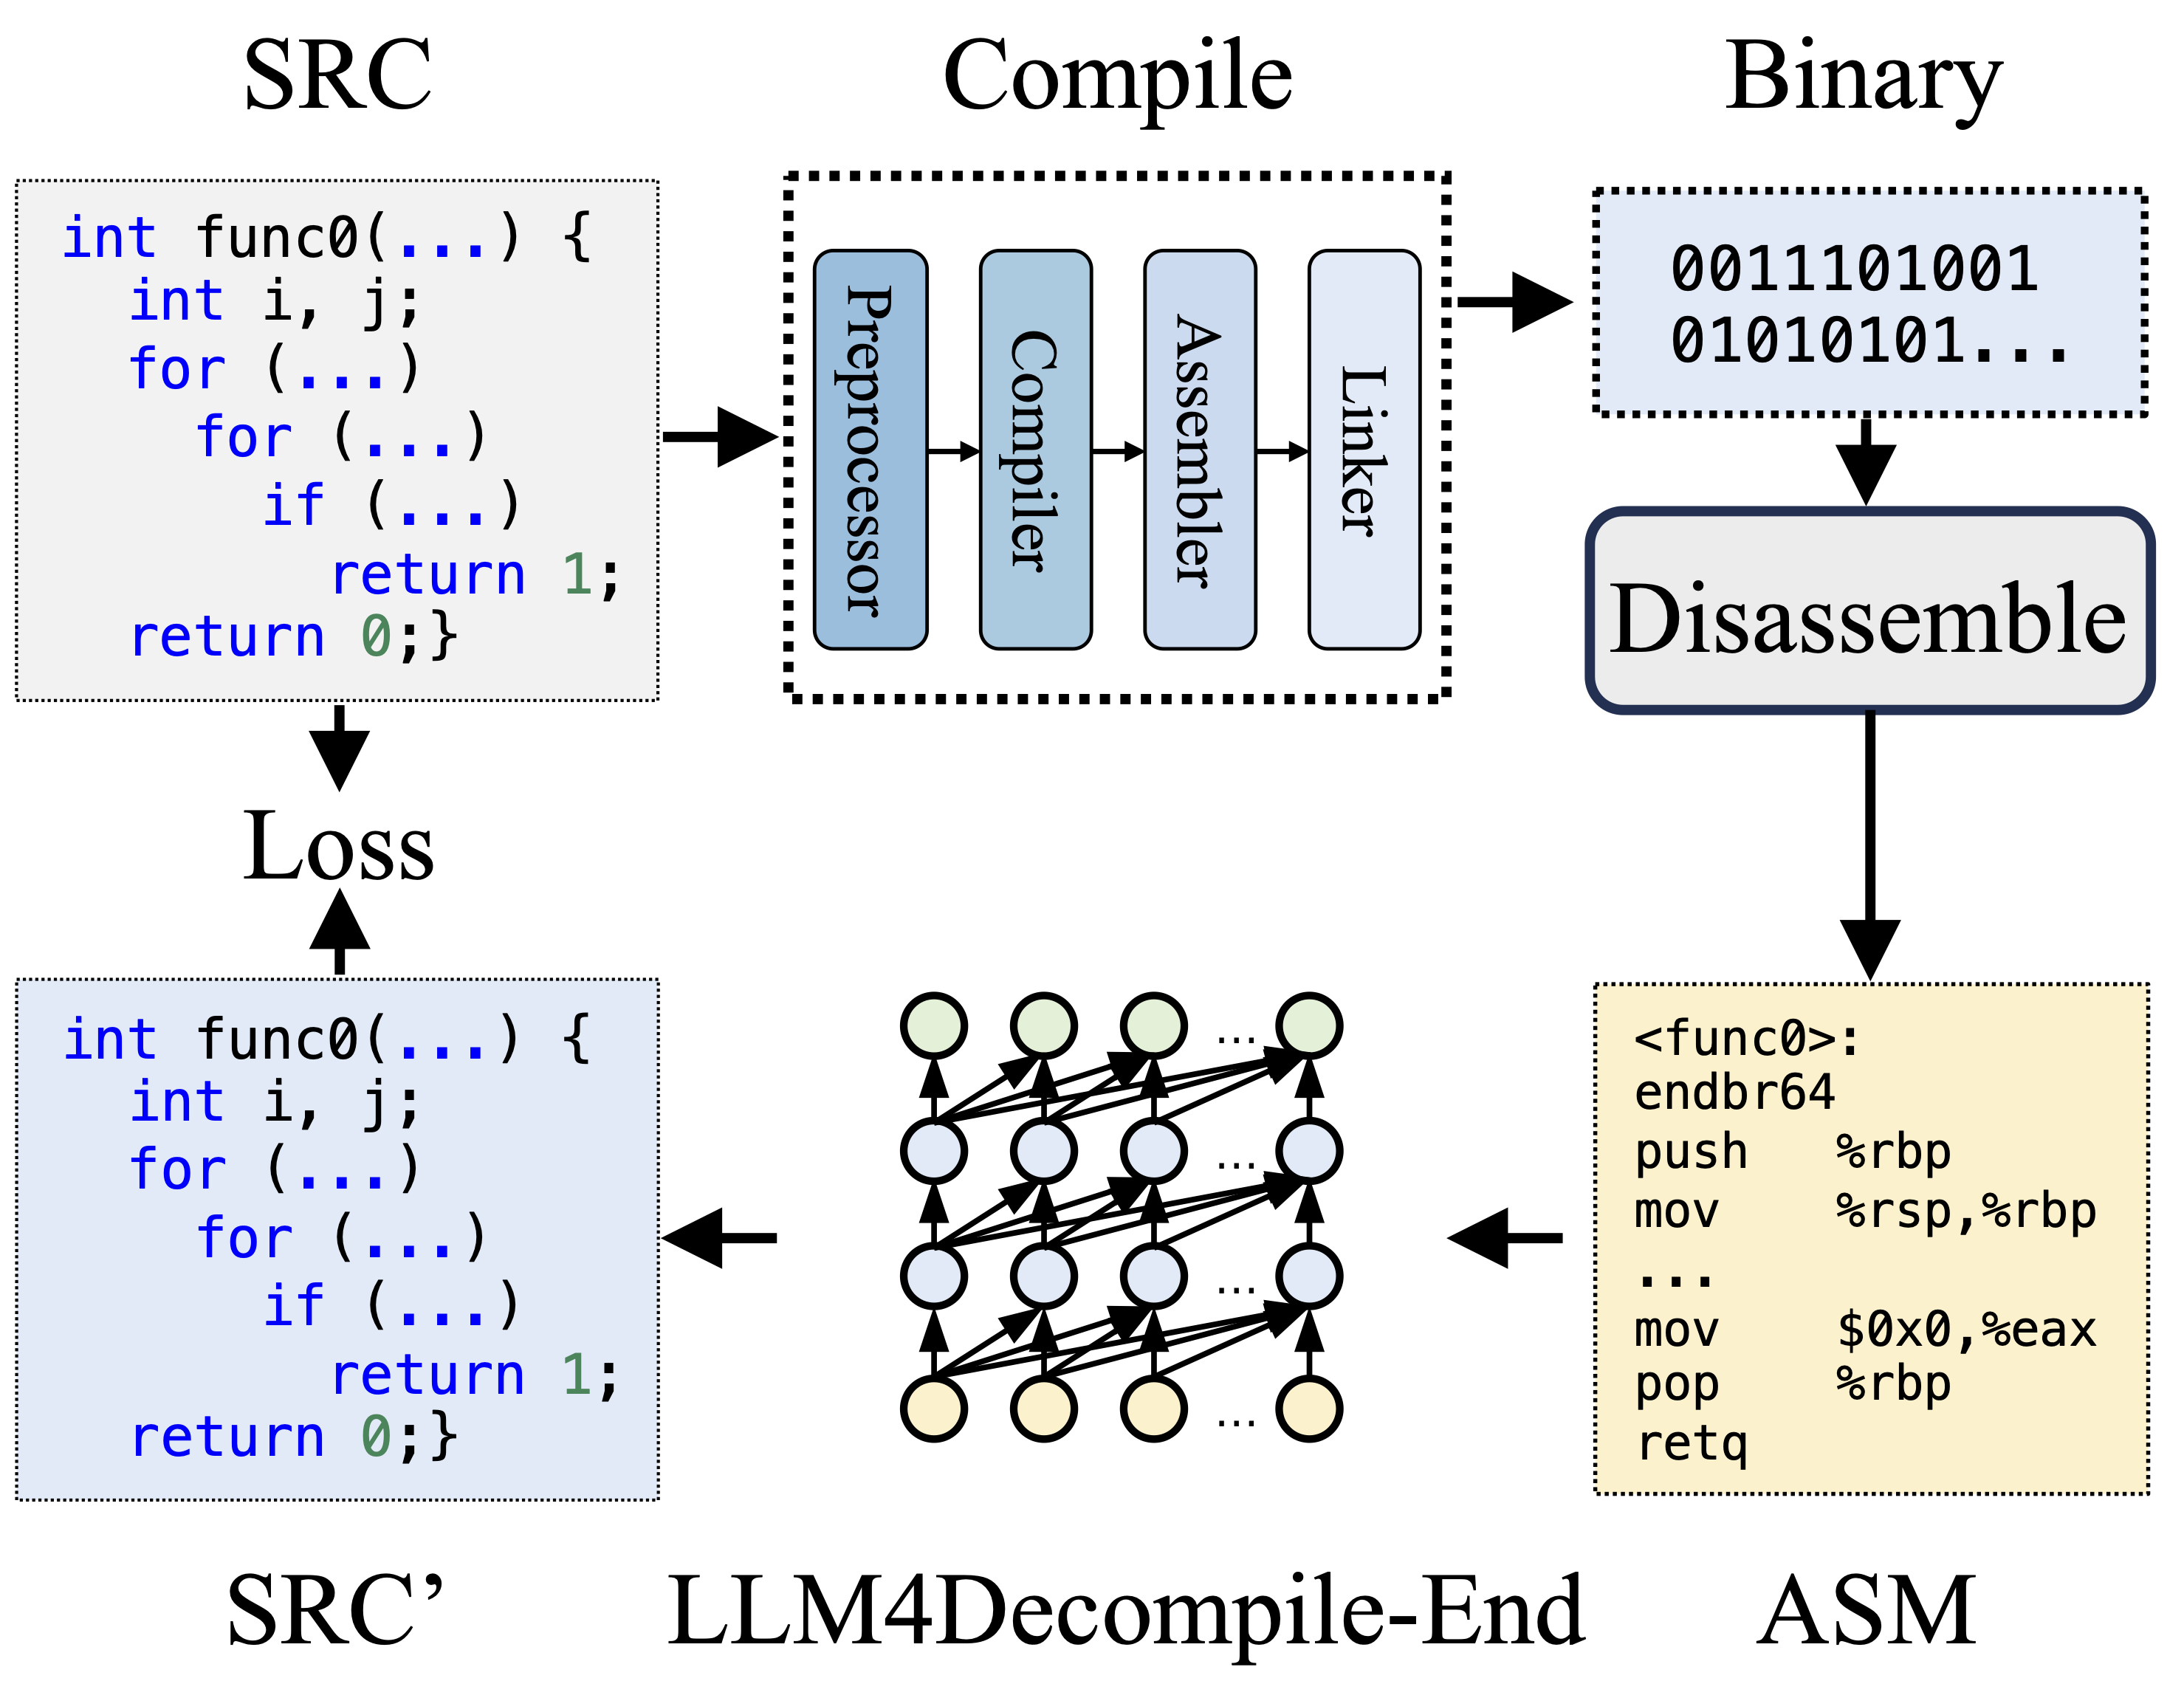
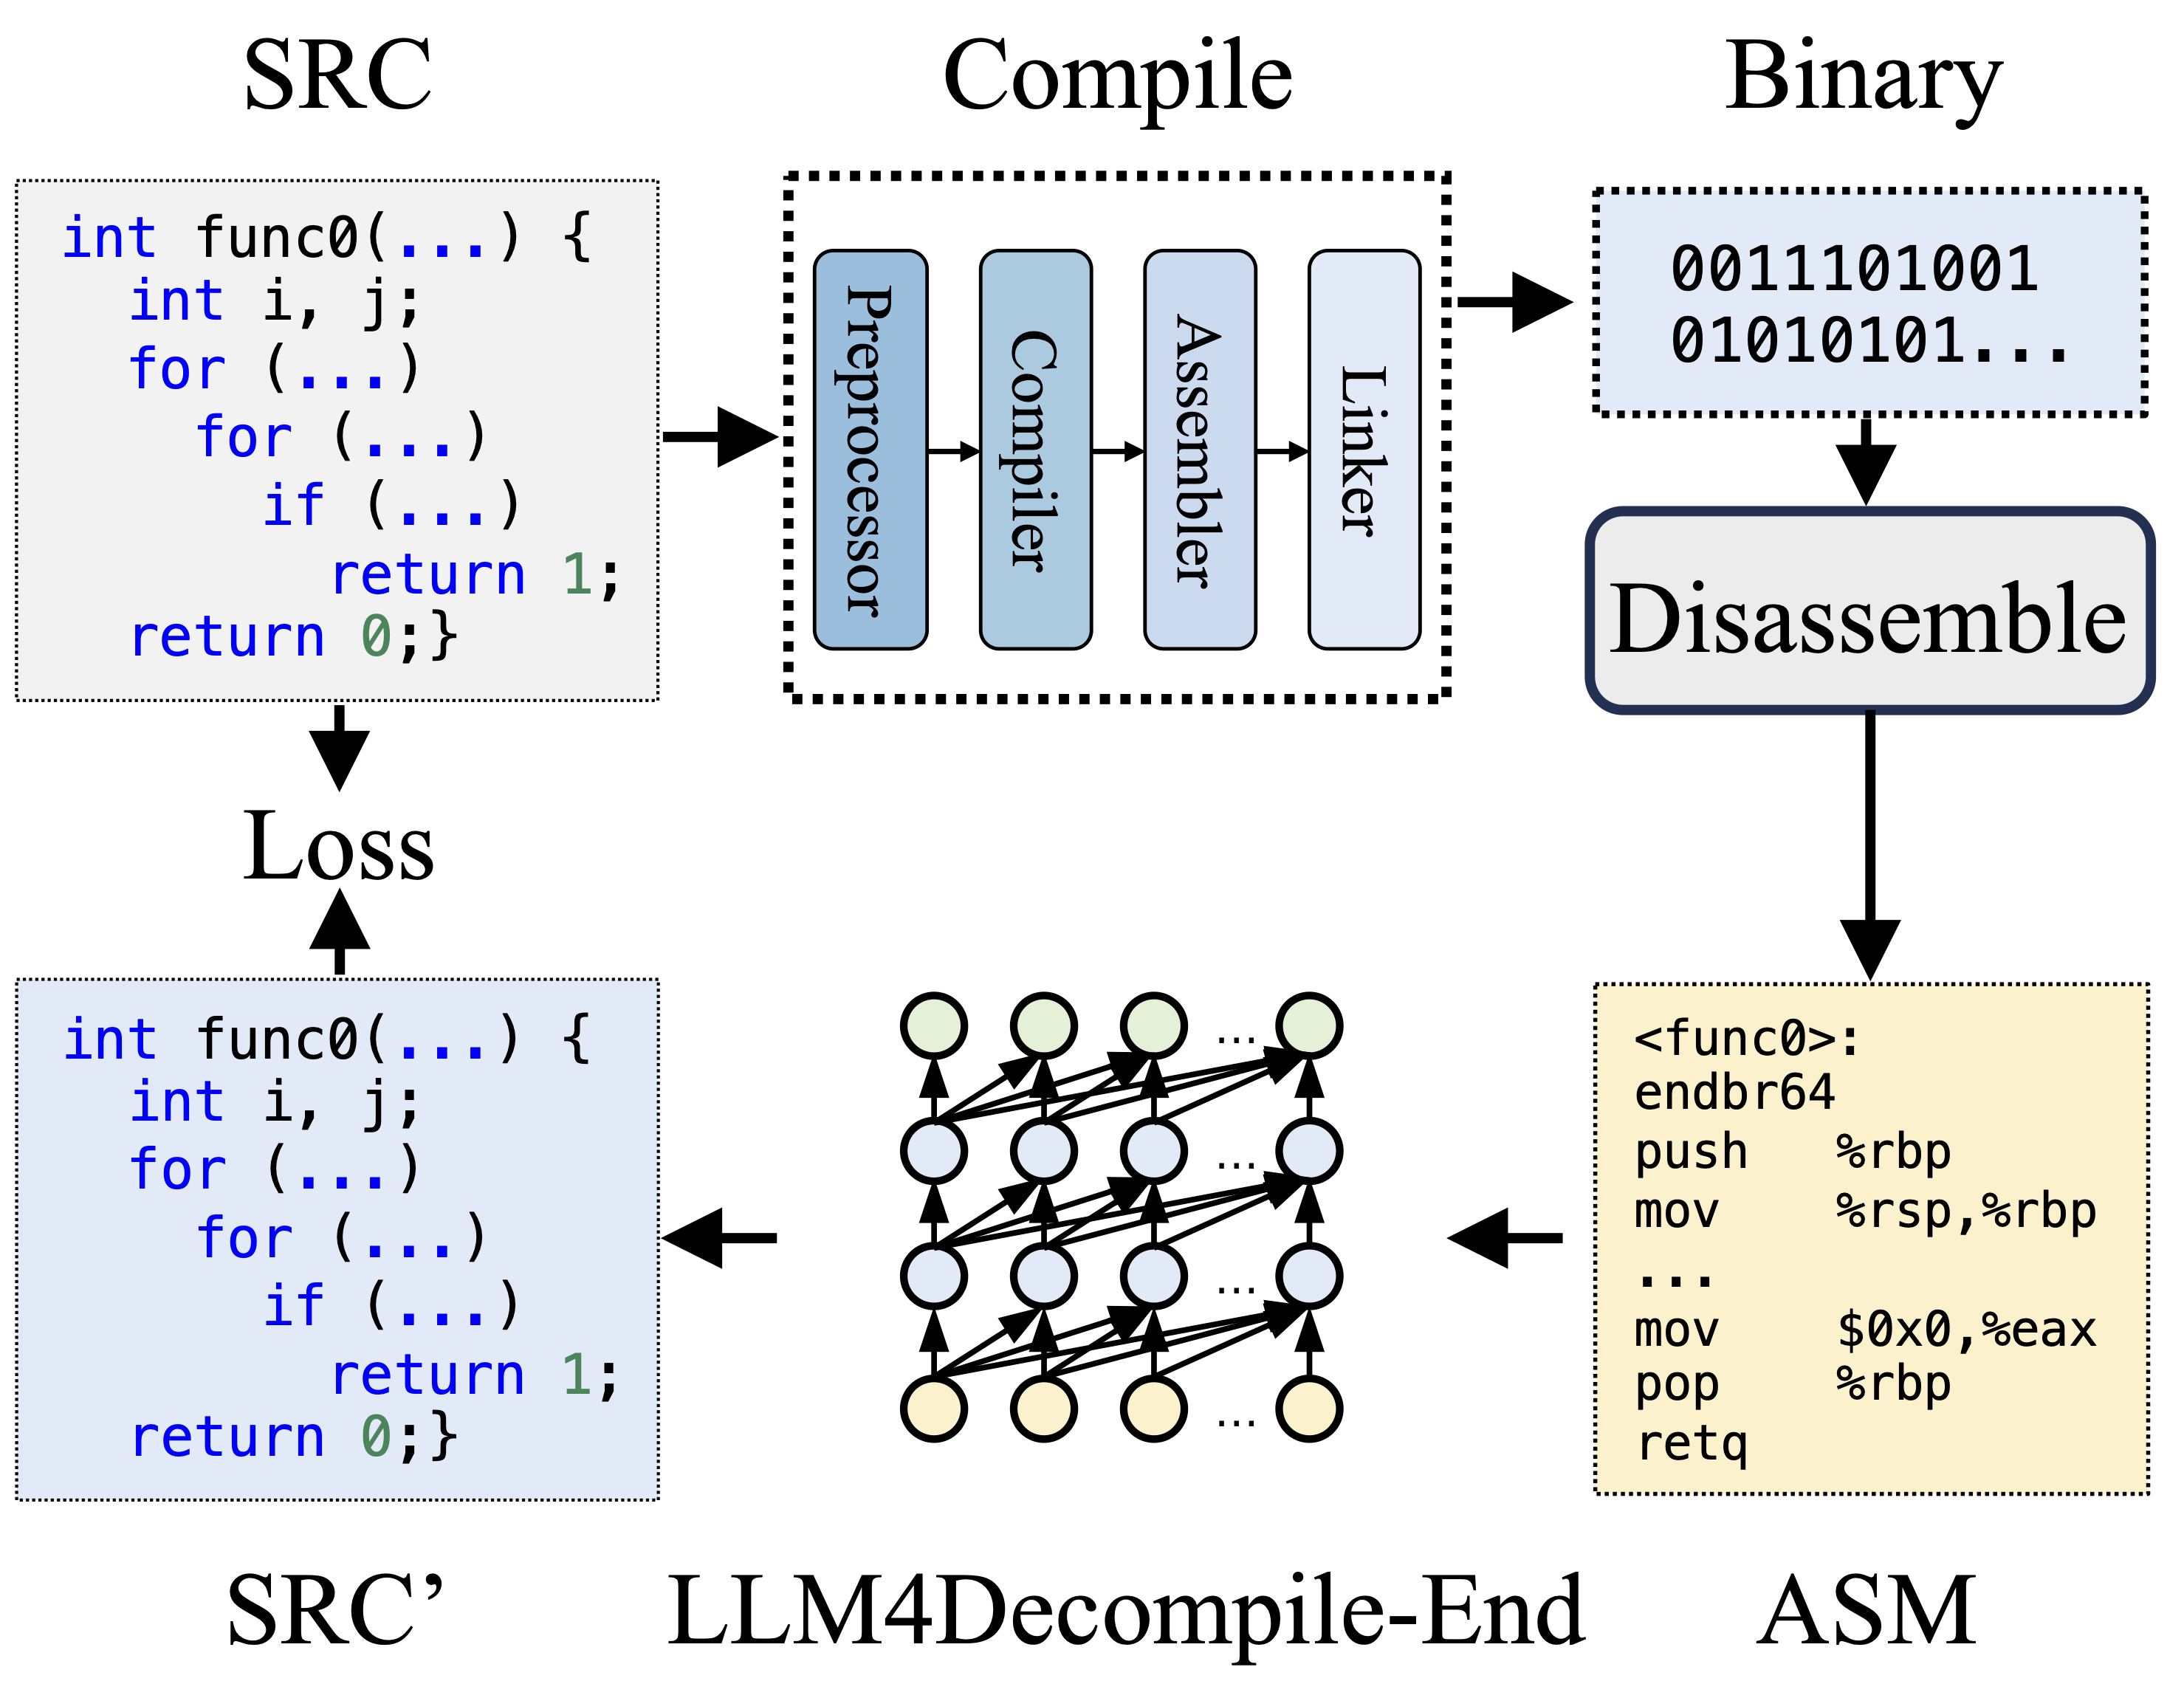
संकलन के दौरान, प्रीप्रोसेसर टिप्पणियों को हटाने और मैक्रोज़ या इन्क्लूड्स का विस्तार करने के लिए स्रोत कोड (SRC) को संसाधित करता है। साफ़ किया गया कोड फिर कंपाइलर को भेजा जाता है, जो इसे असेंबली कोड (ASM) में परिवर्तित करता है। इस ASM को असेंबलर द्वारा बाइनरी कोड (0 और 1) में बदल दिया जाता है। लिंकर फ़ंक्शन कॉल्स को लिंक करके एक निष्पादन योग्य फ़ाइल बनाकर प्रक्रिया को अंतिम रूप देता है। दूसरी ओर, डीकंपिलेशन में बाइनरी कोड को वापस स्रोत फ़ाइल में परिवर्तित करना शामिल है। LLM, पाठ पर प्रशिक्षित होने के कारण, बाइनरी डेटा को सीधे संसाधित करने की क्षमता नहीं रखते हैं। इसलिए, बाइनरी को पहले Objdump द्वारा असेंबली भाषा (ASM) में डिसअसेंबल किया जाना चाहिए। यह ध्यान दिया जाना चाहिए कि बाइनरी और डिसअसेंबल किया गया ASM समतुल्य हैं, उन्हें परस्पर परिवर्तित किया जा सकता है, और इस प्रकार हम उन्हें एक दूसरे के स्थान पर संदर्भित करते हैं। अंत में, डीकंपाइल किए गए कोड और स्रोत कोड के बीच हानि की गणना की जाती है ताकि प्रशिक्षण को निर्देशित किया जा सके। डीकंपाइल किए गए कोड (SRC') की गुणवत्ता का आकलन करने के लिए, इसे परीक्षण अभिकथनों (पुनः-निष्पादन क्षमता) के माध्यम से इसकी कार्यक्षमता के लिए परीक्षण किया जाता है।
मेट्रिक्स
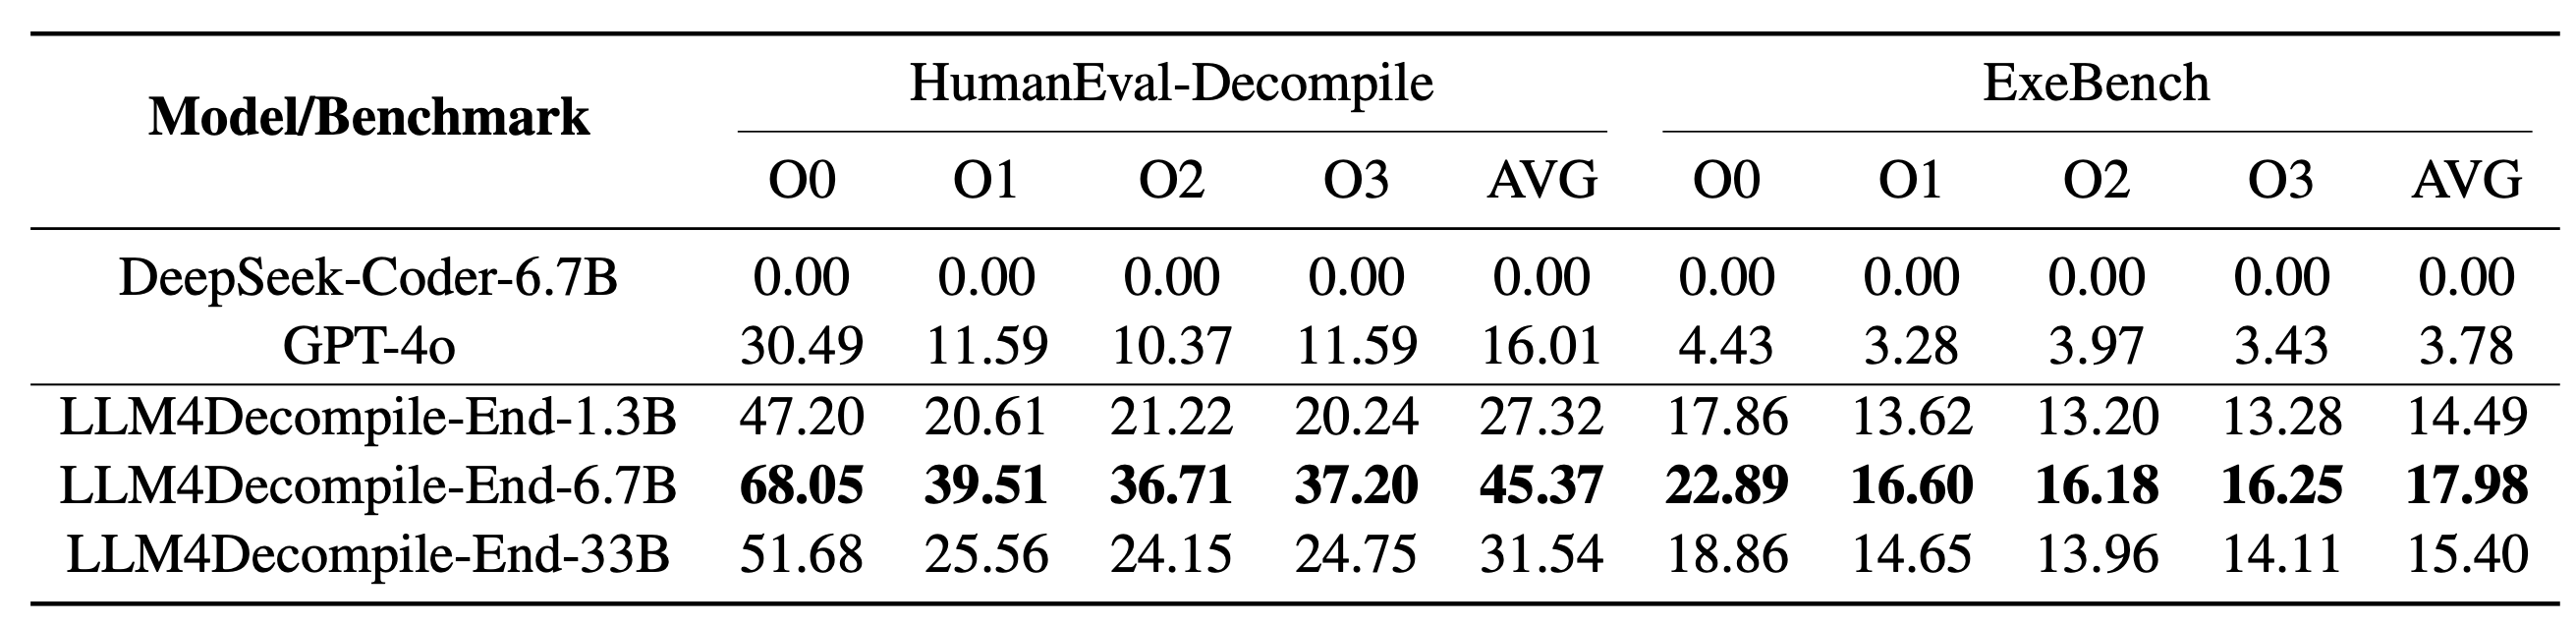
पुनः-निष्पादन क्षमता यह मूल्यांकन करती है कि क्या डीकंपाइल किया गया कोड ठीक से निष्पादित हो सकता है और सभी पूर्वनिर्धारित परीक्षण मामलों को पास कर सकता है।
बेंचमार्क
HumanEval-Decompile 164 C फ़ंक्शनों का संग्रह जो विशेष रूप से मानक C लाइब्रेरीज़ पर निर्भर करते हैं।
ExeBenchवास्तविक परियोजनाओं से लिए गए 2,621 फ़ंक्शनों का संग्रह, जिनमें से प्रत्येक उपयोगकर्ता-परिभाषित फ़ंक्शन, संरचनाएं और मैक्रोज़ का उपयोग करता है।
परिणाम
मॉडल
हमारे LLM4Decompile में 1.3 बिलियन से 33 बिलियन पैरामीटर के बीच आकार वाले मॉडल शामिल हैं, और हमने इन मॉडलों को Hugging Face पर उपलब्ध कराया है।
नोट 3: V1.5 श्रृंखला को बड़े डेटासेट (15B टोकन) और अधिकतम टोकन आकार 4,096 के साथ प्रशिक्षित किया गया है, जिसमें पिछले मॉडल की तुलना में उल्लेखनीय प्रदर्शन (100% से अधिक सुधार) है।
 albertan017/llm4decompile