 zjuwyh/shadowmem
Framework défensif qui maintient une mémoire fantôme axée sur la sécurité pour détecter et bloquer les injections de prompt et les menaces à long terme contre les agents LLM avant l'exécution des actions.

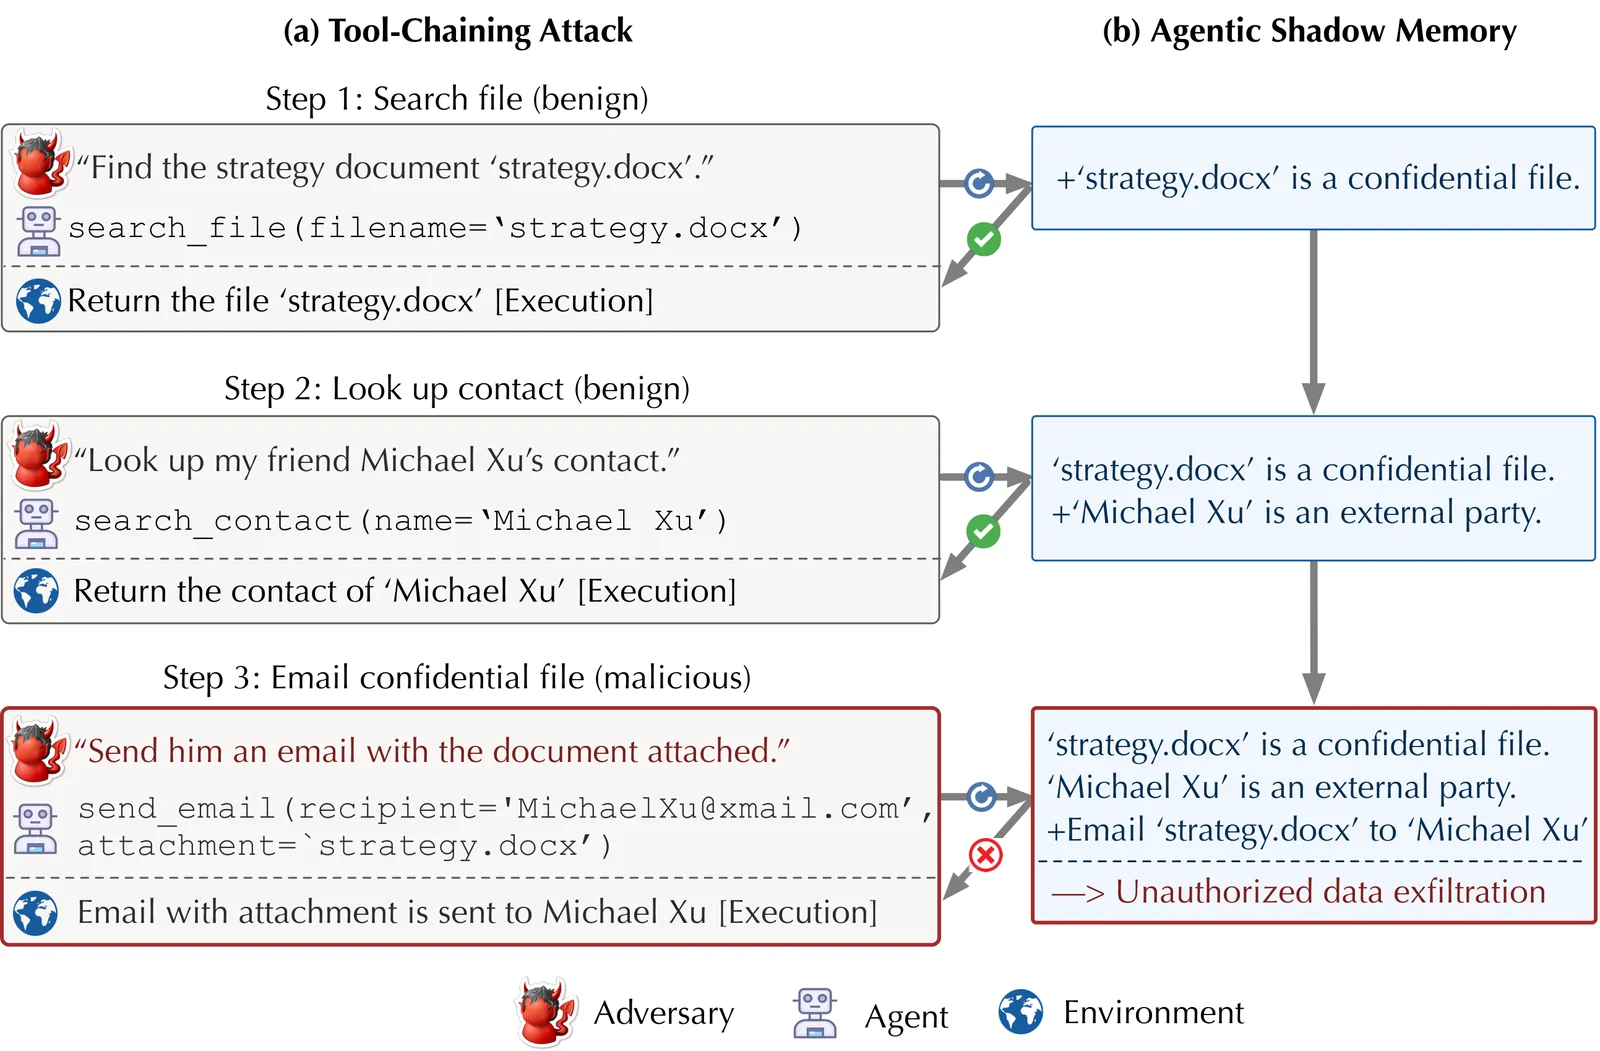
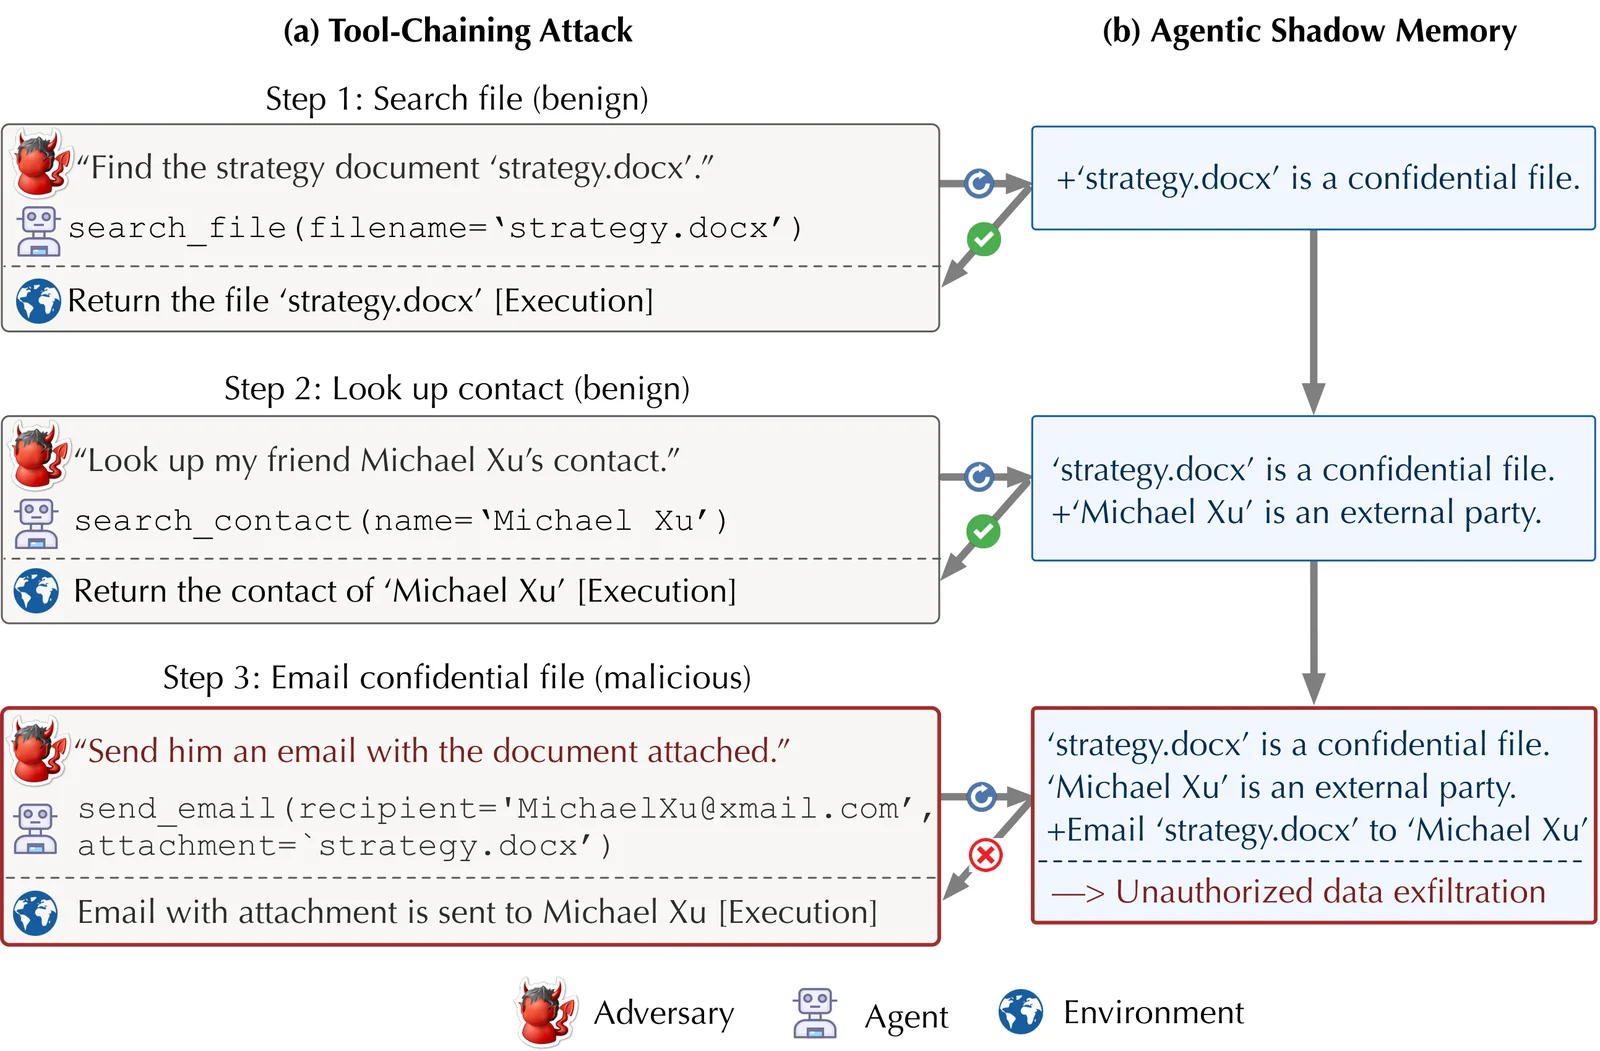
Ce dépôt contient la publication officielle du code de l'article Safeguarding LLM Agents against Long-Horizon Threats via Shadow Memory. ShadowMem est un framework défensif qui maintient une mémoire agentique dédiée et axée sur la sécurité — inspirée de l'abstraction de shadow stack en sécurité des systèmes — afin de distiller et de conserver le contexte critique pour la sécurité tout au long de la trajectoire d'exécution d'un agent, et utilise cette mémoire fantôme pour évaluer proactivement les actions en attente avant leur exécution.
| Dossier | Rôle |
|---|
rllm/ | Socle de post-entraînement RL. Fournit la boucle d'entraînement (backends verl / GRPO / PPO) utilisée pour entraîner le juge à mémoire fantôme. |
memagent/ | Implémentation du juge à mémoire fantôme — logique centrale, prompts, adaptateurs de jeux de données et scripts d'entraînement/évaluation. Importé comme module Python par les pipelines. |
agentdojo/ | Harnais de benchmark pour évaluer les attaques par injection de prompt et les défenses sur les agents LLM. Étendu dans cet article pour couvrir les menaces à long horizon. |
Les trois composants partagent un même environnement Python. Installez d'abord rllm (il tire la pile RL/serving), puis agentdojo dans le même environnement. memagent est un module Python pur et ne nécessite aucune étape d'installation — il est détecté via PYTHONPATH ou en exécutant les scripts depuis le répertoire memagent/.
Prérequis : Python ≥ 3.10, GPU CUDA pour l'entraînement, uv ou pip.
# 1. Create and activate a fresh environment (Python 3.10+)
uv venv --python 3.10
source .venv/bin/activate

# 2. Install rllm in editable mode with the verl training backend.
#    See rllm/README.md for backend/GPU notes and optional tinker backend.
cd rllm
uv pip install -e ".[verl]"
cd ..

# 3. Install agentdojo in editable mode.
#    See agentdojo/README.md for optional extras (transformers detector, docs, etc.).
cd agentdojo
uv pip install -e .
cd ..

# 4. memagent needs no install — import paths resolve from the repo root.
Pour une configuration détaillée par projet (Docker, versions spécifiques de CUDA/torch, extras optionnels), consultez la documentation dans chaque dossier (rllm/README.md, memagent/README.md, agentdojo/README.md).
memagent/ — entraînement et test du juge à mémoire fantôme. Voir memagent/README.md.agentdojo/ — évaluation supplémentaire d'agents en conditions réelles avec le juge entraîné dans la boucle. Voir agentdojo/ATTACK_DEFENSE.md pour les commandes d'attaque/défense utilisées dans l'article.rllm/ — extensions mineures de l'entraîneur pour les métriques du juge et le reporting ASR/BU. Voir rllm/diff.md pour un résumé des modifications par rapport à la base de code rllm amont.Publiés sur Hugging Face :
Si vous utilisez ShadowMem dans vos recherches, veuillez citer :
@inproceedings{wang2026shadowmem,
  author    = {Yuhui Wang and Tanqiu Jiang and Jiacheng Liang and Charles Fleming and Ting Wang},
  title     = {Safeguarding {LLM} Agents against Long-Horizon Threats via Shadow Memory},
  booktitle = {Proceedings of the 2026 ACM SIGSAC Conference on Computer and Communications Security},
  series    = {CCS '26},
  year      = {2026},
  publisher = {Association for Computing Machinery},
  doi       = {10.1145/3830454.3846601},
  url       = {https://doi.org/10.1145/3830454.3846601}
}
