 zju-llm-safety/darwin
Framework évolutionniste de jailbreak et de garde-fous pour LLM qui développe un pool de stratégies réutilisables via mutation génétique, sélection de Markov et entraînement adversarial en ligne pour l'évaluation de la sécurité.

Un framework évolutionnaire d'attaque-défense qui couple
DARWIN-Attack avec DARWIN-Guard via un entraînement adversarial en ligne.
Article · Checkpoint du garde-fou · Installation · Utiliser DARWIN-Attack · Utiliser DARWIN-Guard · Entraînement · Citation
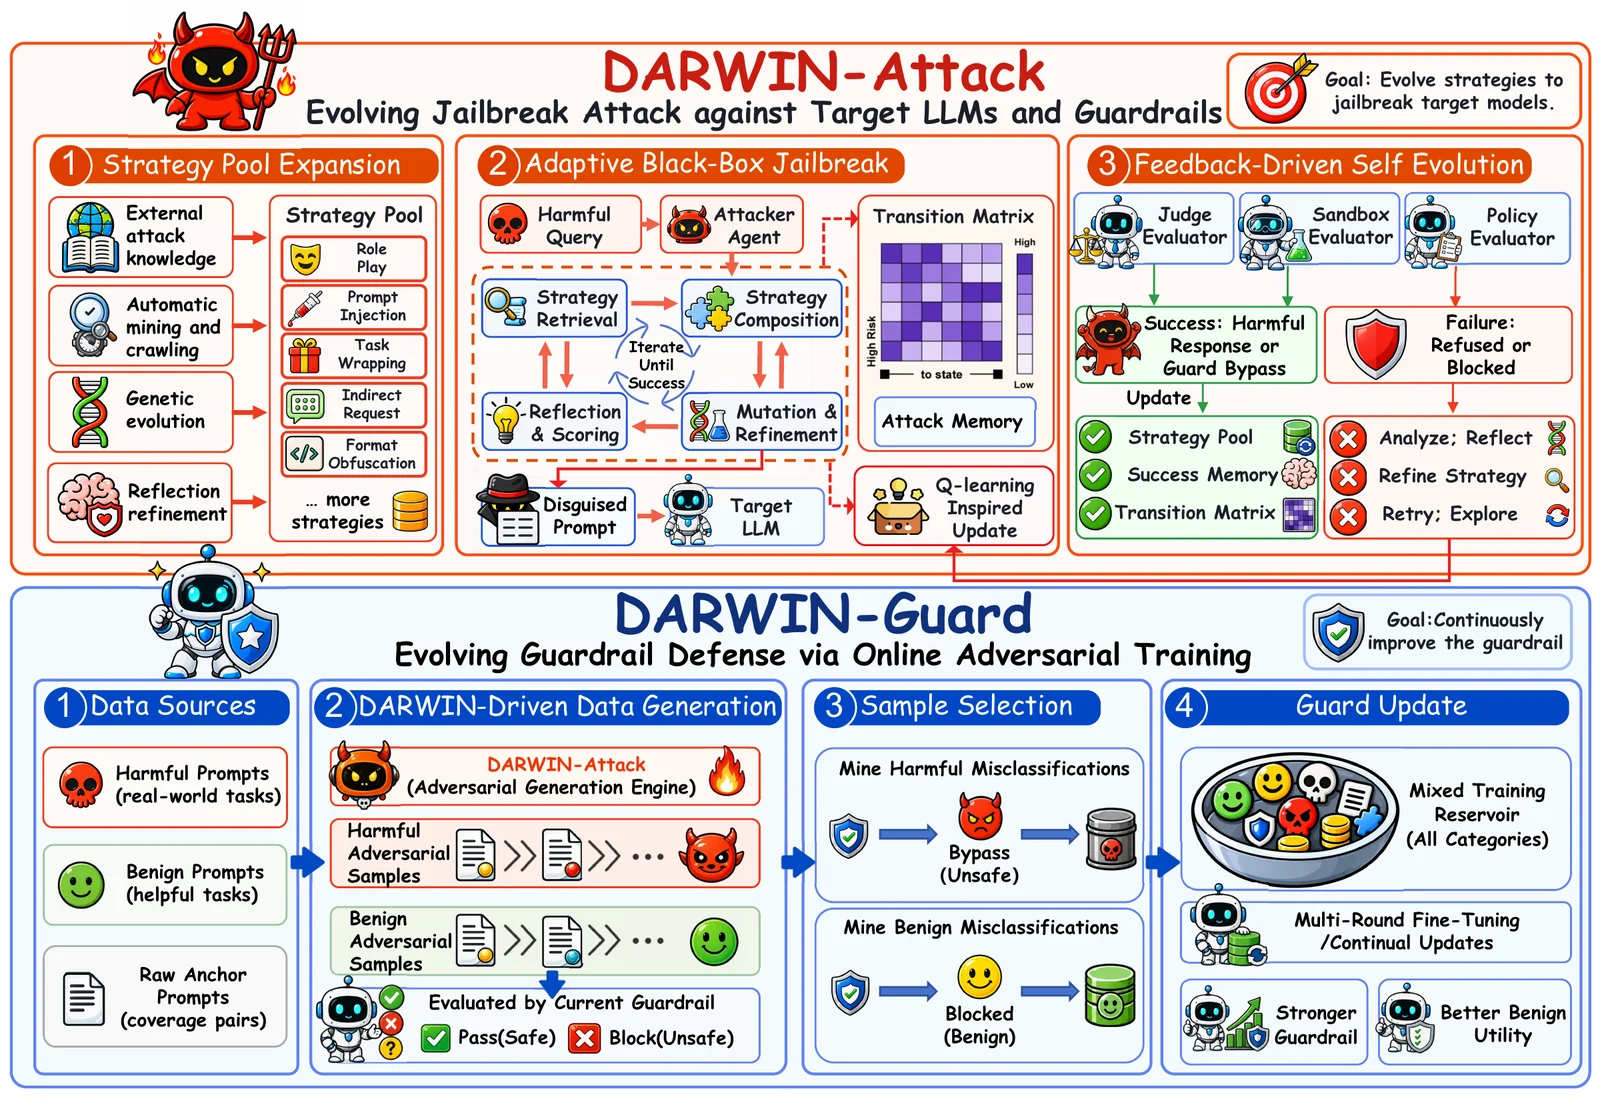
DARWIN formule le jailbreaking comme un processus évolutionnaire continu et met à jour en continu les garde-fous via une boucle attaque-défense. DARWIN-Attack étend un pool explicite de stratégies par la découverte, la mutation et la sélection de stratégies, et compose de manière adaptative les stratégies en utilisant le retour de la cible. DARWIN-Guard apprend à partir des échantillons adversariaux émergents, en s'entraînant conjointement sur des requêtes nuisibles et bénignes déguisées afin de reconnaître l'intention sous-jacente plutôt que les schémas d'attaque superficiels.
| Ce que DARWIN fournit | |
|---|---|
| Un adversaire évolutif | Un pool de stratégies explicite et réutilisable qui s'enrichit par l'acquisition de connaissances externes, l'évolution génétique et la réflexion sur les échecs, sans fine-tuning d'un LLM attaquant. |
| Composition adaptative des stratégies | Initialisation informée par l'historique et transitions de stratégies de Markov avec des mises à jour inspirées du Q-learning, prenant en charge l'évaluation des LLM et des garde-fous de sécurité. |
| Expansion validée des stratégies | Déduplication sémantique suivie d'une validation en sandbox contre un LLM aligné avant que les stratégies candidates n'entrent dans le pool. |
| Entraînement en ligne d'un garde-fou adversarial | Entraînement itératif contre l'adversaire évolutif, chaque cycle étant initialisé à partir du checkpoint de garde-fou précédent. |
| Classification de sécurité sensible à l'intention | Des prompts nuisibles et bénins déguisés appariés à leurs homologues bruts, avec les étiquettes de source préservées pour améliorer la robustesse tout en atténuant le refus excessif. |
DARWIN-Attack atteint le taux de réussite d'attaque (ASR) le plus élevé sur les six cibles évaluées et sur les deux benchmarks, comparé à six baselines de jailbreak.
| Cible | ASR HarmBench | ASR AdvBench |
|---|---|---|
| DeepSeek-V4-Pro | 99,7 % | 97,6 % |
| GPT-5.5 | 93,7 % | 90,7 % |
| Gemini-3.5-Flash | 93,0 % | 90,9 % |
| Claude Sonnet 4.6 | 78,2 % | 68,2 % |
| Qwen3Guard | 99,7 % | 98,8 % |
| YuFeng-XGuard | 99,2 % | 96,7 % |
DARWIN-Guard atteint 95,0 % de rappel moyen sur les prompts non sûrs à travers neuf benchmarks de prompts nuisibles, un taux de passage bénin moyen de près de 100 % sur six benchmarks bénins standards, et des taux de passage bénin de 97,6 % sur XSTest et 80,0 % sur JBB-Benign.
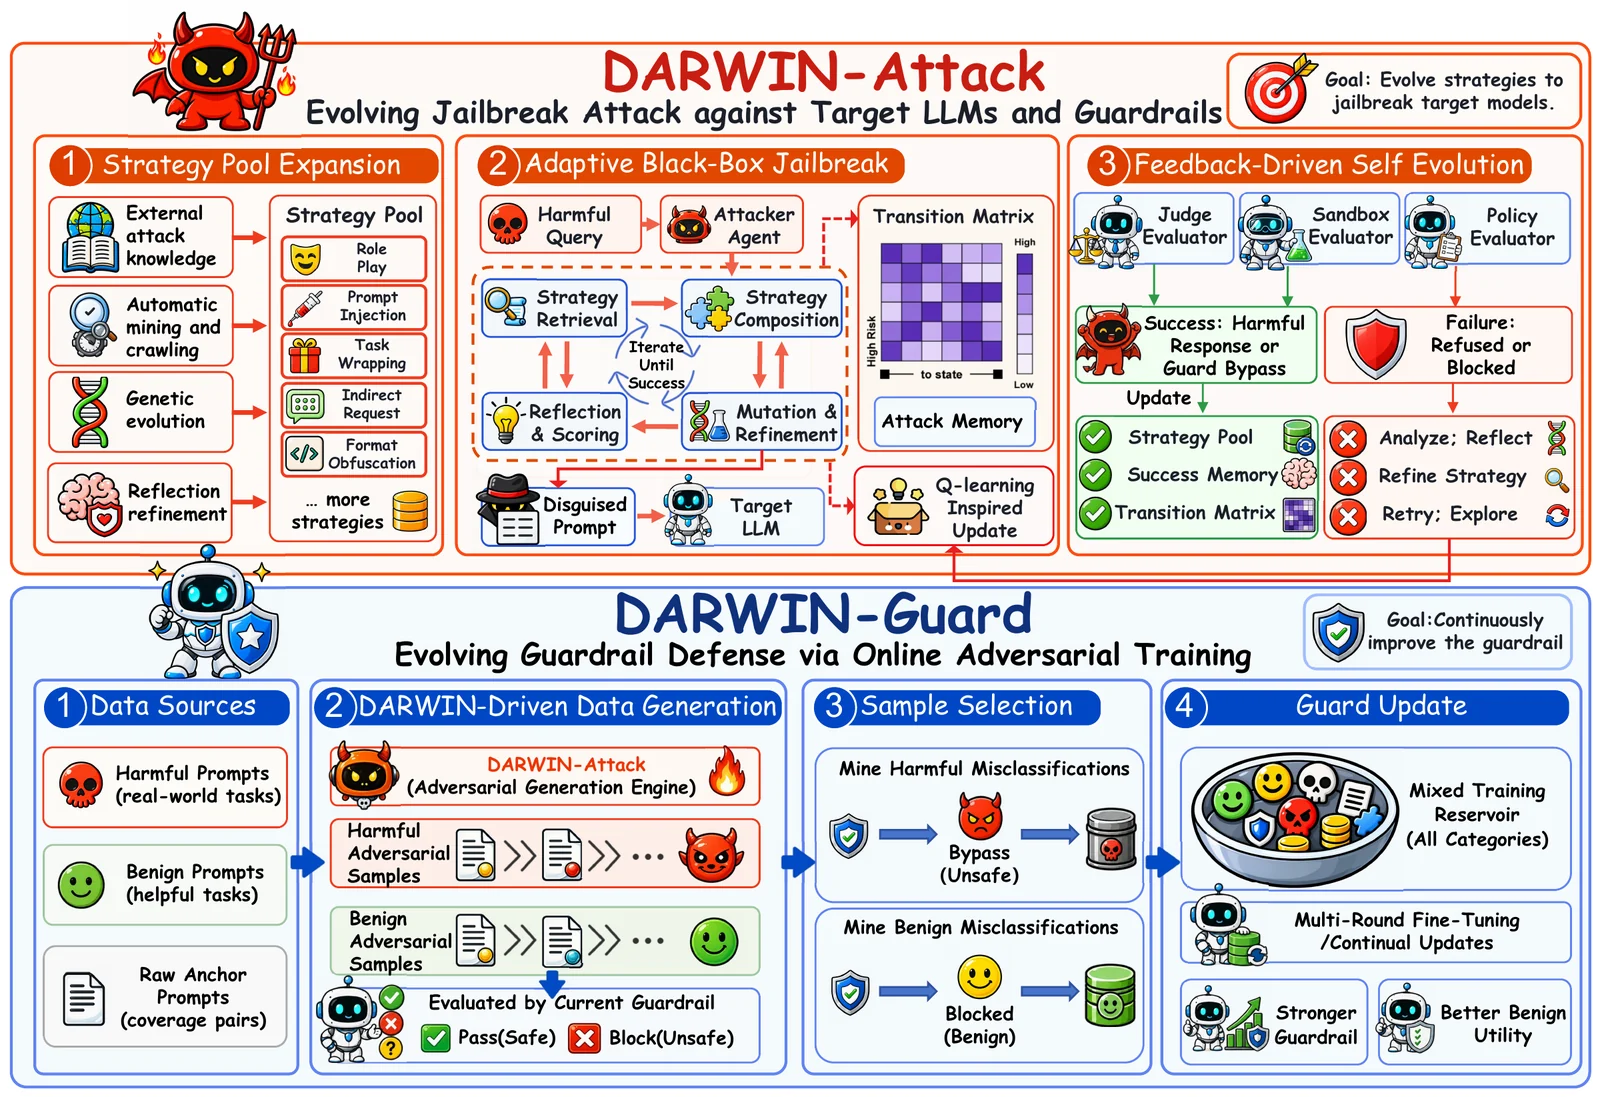
DARWIN-Attack fait évoluer les adversaires de jailbreak par l'évolution du pool de stratégies, la sélection adaptative des stratégies et l'affinement guidé par le retour. DARWIN-Guard s'améliore continuellement grâce à un entraînement adversarial en ligne avec des échantillons générés par DARWIN-Attack.
DARWIN/
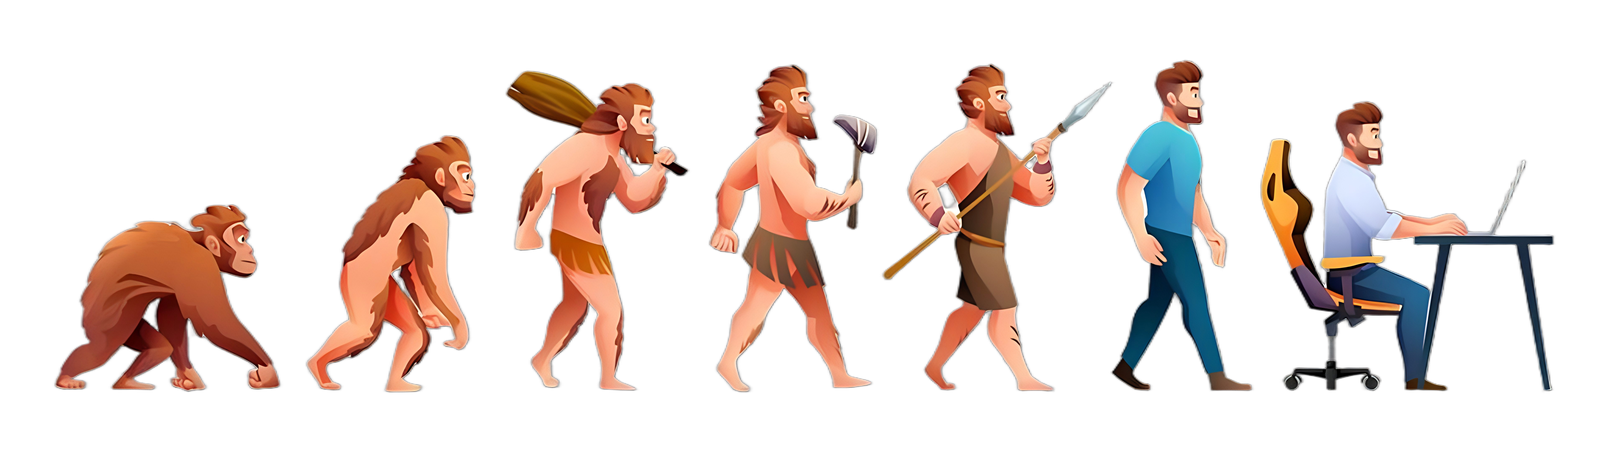
├── assets/                         # Evolution illustration and framework diagram
├── configs/
│   ├── darwin_attack.example.yaml  # Attack, evolution, and evaluation settings
│   └── darwin_guard.example.yaml   # Online adversarial training and guard evaluation
├── src/
│   ├── darwin_attack/              # Strategy pool, evolution, composition, and evaluation
│   └── darwin_guard/               # Data preparation, attack bridge, training, and inference
├── strategies/
│   ├── final_strategy_pool.jsonl   # Released pool of 200 strategies
│   └── mutation_operators.jsonl    # 15 operators across five dimensions
├── schemas/
│   ├── attack/                     # Dataset, strategy, and mutation-operator formats
│   └── guard/                      # Source, paired-training, and evaluation formats
├── tests/
│   ├── attack/
│   └── guard/
├── NOTICE                          # Third-party attribution
└── pyproject.toml                  # Package dependencies and CLI entry points
Utilisez Python 3.10+. L'inférence et l'entraînement locaux nécessitent PyTorch compatible avec votre matériel ; la configuration d'entraînement utilise CUDA et BF16. Les dépendances pour modèles locaux incluent Transformers >=5.10.1,<6, y compris la prise en charge du filtre Gemma utilisé pendant l'entraînement.
git clone https://github.com/ZJU-LLM-Safety/DARWIN.git
cd DARWIN

python -m venv .venv
source .venv/bin/activate
python -m pip install -e '.[api,local,training]'
Pour l'inférence du garde-fou uniquement, python -m pip install -e '.[local]' suffit. Exécutez les commandes ci-dessous depuis la racine du dépôt.
| Mécanisme | Rôle |
|---|---|
| Évolution par connaissances externes | Convertit du matériel fourni de l'extérieur en stratégies candidates réutilisables. |
| Évolution génétique des stratégies | Génère des candidates par croisement et mutation des stratégies existantes. |
| Évolution guidée par la réflexion | Analyse le retour de rejet et affine les stratégies infructueuses. |
| Évolution guidée par le retour | Utilise les résultats d'attaque en temps réel pour adapter la sélection et la composition ultérieures des stratégies. |
Les opérateurs sont organisés en cinq dimensions, avec trois opérateurs par dimension. Leurs définitions sont fournies dans mutation_operators.jsonl.

