 zju-llm-safety/ascent
Framework de fine-tuning qui applique un calibrage de sécurité optimal de premier ordre et un recalibrage périodique aux LLMs, préservant les mises à jour compatibles avec la sécurité tout en améliorant l'utilité des tâches en aval.

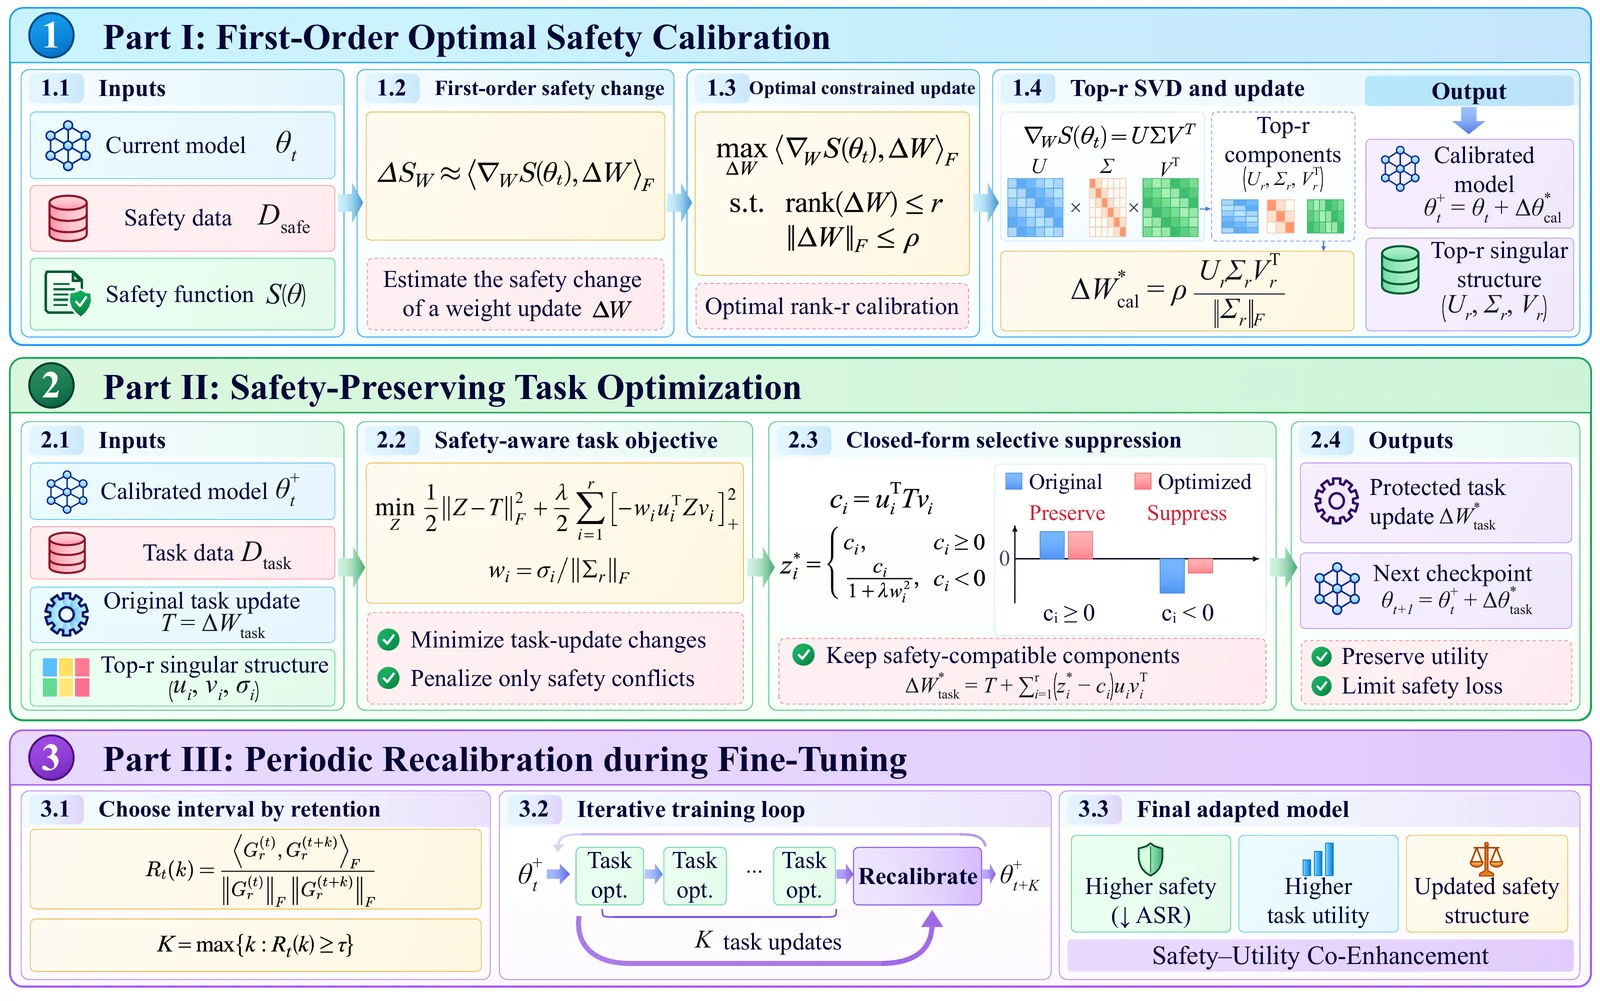
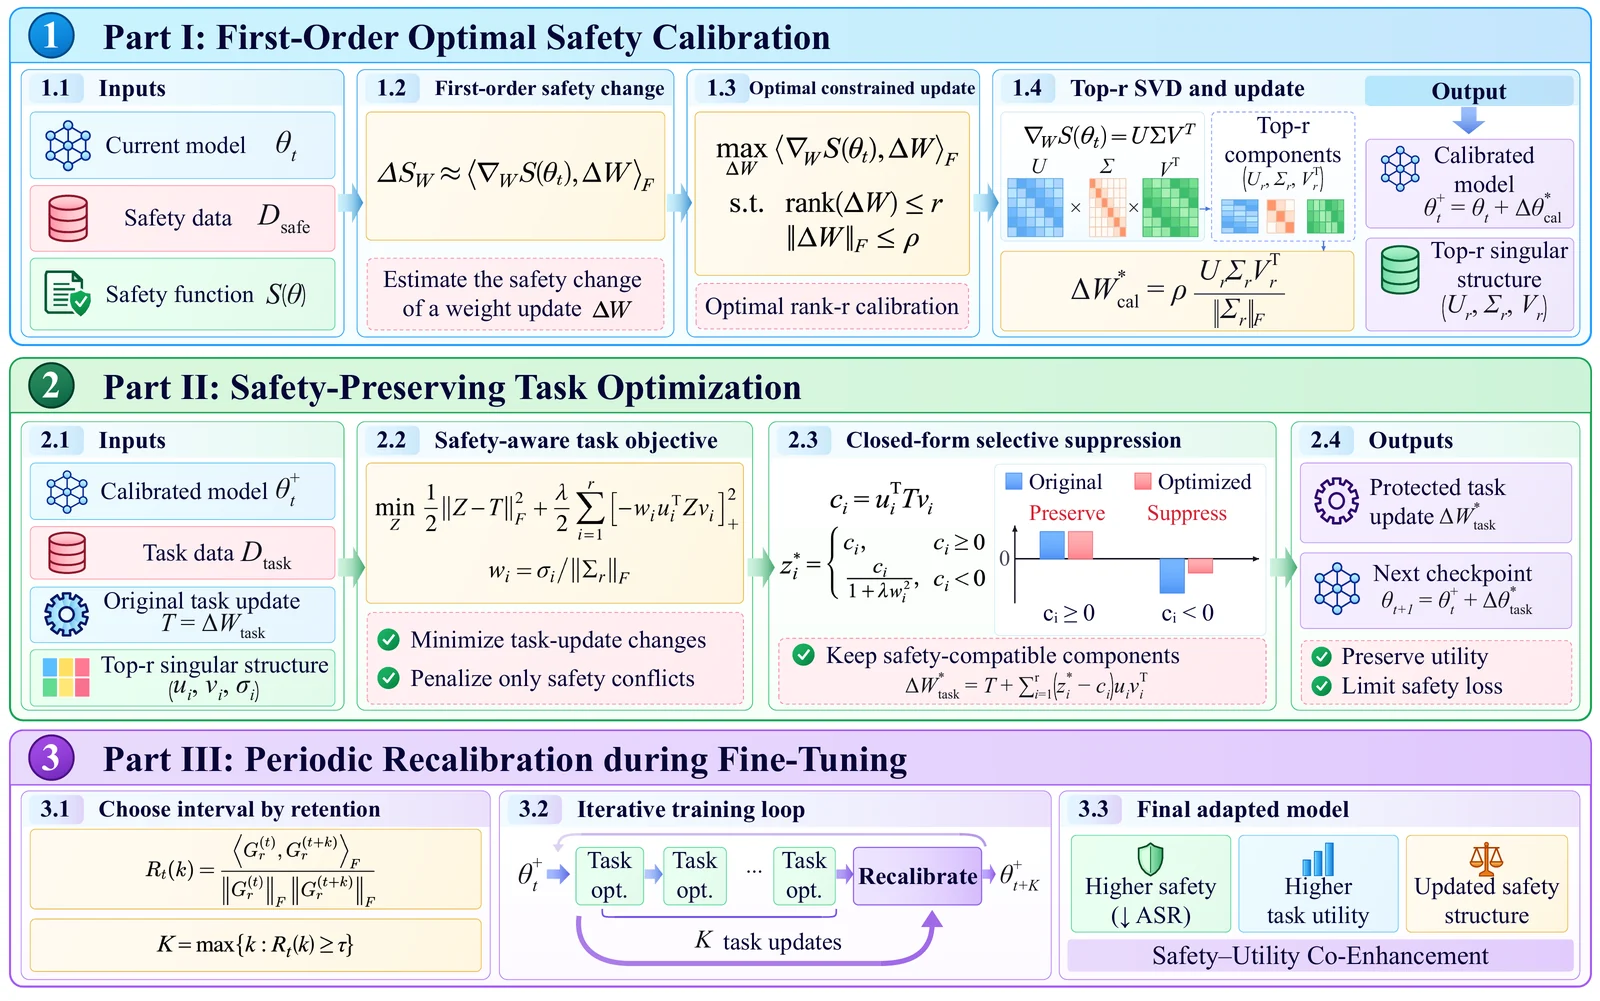
First-Order Optimal Fine-Tuning with Recalibration for Safety–Utility Co-Enhancement
ASCENT dérive une mise à jour de calibration de sûreté optimale au premier ordre et la structure liée à la sûreté correspondante, optimise les mises à jour des tâches en aval pour préserver les composantes compatibles avec la sûreté tout en supprimant celles qui la dégradent, et recalibre périodiquement cette structure pendant le fine-tuning afin d'améliorer conjointement la sûreté et l'utilité en aval.
Méthode · Démarrage rapide · Données · Configuration · Évaluation
config.toml.Prérequis : Python 3.12 et des checkpoints de modèle locaux. L'entraînement utilise deux GPU CUDA, un pour le modèle cible et un pour Llama Guard ; chaque modèle doit tenir sur son GPU.
pip install -r requirements.txt
cp config.example.toml config.toml
Remplissez les valeurs vides dans config.toml, en suivant ses commentaires
en ligne, puis exécutez :
python run.py \
  --config config.toml \
  --model-path /path/to/target-model \
  --guard-model-path /path/to/Llama-Guard-3-8B \
  --data-root data \
  --output-dir /path/to/new-run \
  --target-gpu 0 --guard-gpu 1
Ajoutez
--executepour entraîner, générer des réponses ou sauvegarder les résultats d'évaluation.
Choisissez un nouveau répertoire de sortie en dehors du dépôt avec de l'espace pour les checkpoints. L'entraînement affiche le chemin du modèle fusionné final lorsqu'il se termine.
Fournissez des tableaux JSON avec les nombres d'enregistrements configurés :
<data-root>/calibration/prompts.json<data-root>/<task>/{train,test}.json, avec des entrées d'entraînement/test disjointes.| Jeu de données | Champs requis |
|---|---|
| SAMSum | dialogue, summary |
| AGNews | text, label_name : World, Sports, Business, ou Sci/Tech |
| GSM8K | question, answer avec une réponse finale #### |
| OpenBookQA | question_stem, choice_labels : ["A","B","C","D"], quatre choice_texts, answer_key : A–D |
| HarmBench | goal uniquement ; id, source facultatifs ; aucune réponse stockée |
Définissez votre modèle, tâche et hyperparamètres dans config.toml. Le chargement
du modèle et la sélection de matrice suivent model.key.
Utilisez evaluate.py pour les deux modes ; la génération nécessite un modèle local
entièrement fusionné. Fournissez vos propres données et scores de sûreté externes.
Aucun jeu de données, juge en ligne ou configuration d'API n'est inclus.
python evaluate.py utility --task gsm8k --data /path/to/test.json \
  --model-path /path/to/merged-model --output-dir /path/to/task-evaluation --execute
Tâches : samsum, agnews, gsm8k, openbookqa. Les métriques sont ROUGE-L pour
SAMSum et la précision/exact match pour les autres, rapportées en pourcentages. Pour
évaluer des réponses sauvegardées, remplacez --model-path par --responses /path/to/responses.json.
Fournissez des prompts fixes sous forme d'enregistrements avec id, goal, et
prompt facultatif (par défaut goal). Gardez l'objectif nuisible original séparé
du prompt d'attaque.
Générer les réponses :
python evaluate.py safety --data /path/to/prompts.json \
  --model-path /path/to/merged-model --output-dir /path/to/safety-responses --execute
Agréger les scores externes :
python evaluate.py safety \
  --responses /path/to/safety-responses/responses.json --judgments /path/to/scores.json \
  --output-dir /path/to/safety-metrics --execute
Les scores sont des enregistrements JSON { "id": "...", "score": 1 }, utilisant les
ID de réponse et des scores de 1 à 5 (null pour les jugements échoués). Les scores
4–5 comptent comme des attaques réussies ; utilisez --success-threshold 5 pour ne
compter que 5. Les jugements manquants ou échoués ne produisent pas d'ASR final.
Pour l'un ou l'autre mode, les entrées dépassant --max-input-tokens après le
formatage du chat sont rejetées, non tronquées. Définissez la limite dans la capacité
de contexte du modèle, en laissant de la place pour les tokens générés.
